
Anthropic 价格公告中,真正需要关注的不只是50%的降幅,而是智能体原有账单中,究竟有多少来自缓存读取。将一个组成部分减半,可能显著改善长时间工作流,也可能几乎不影响短对话或输出占比高的任务。
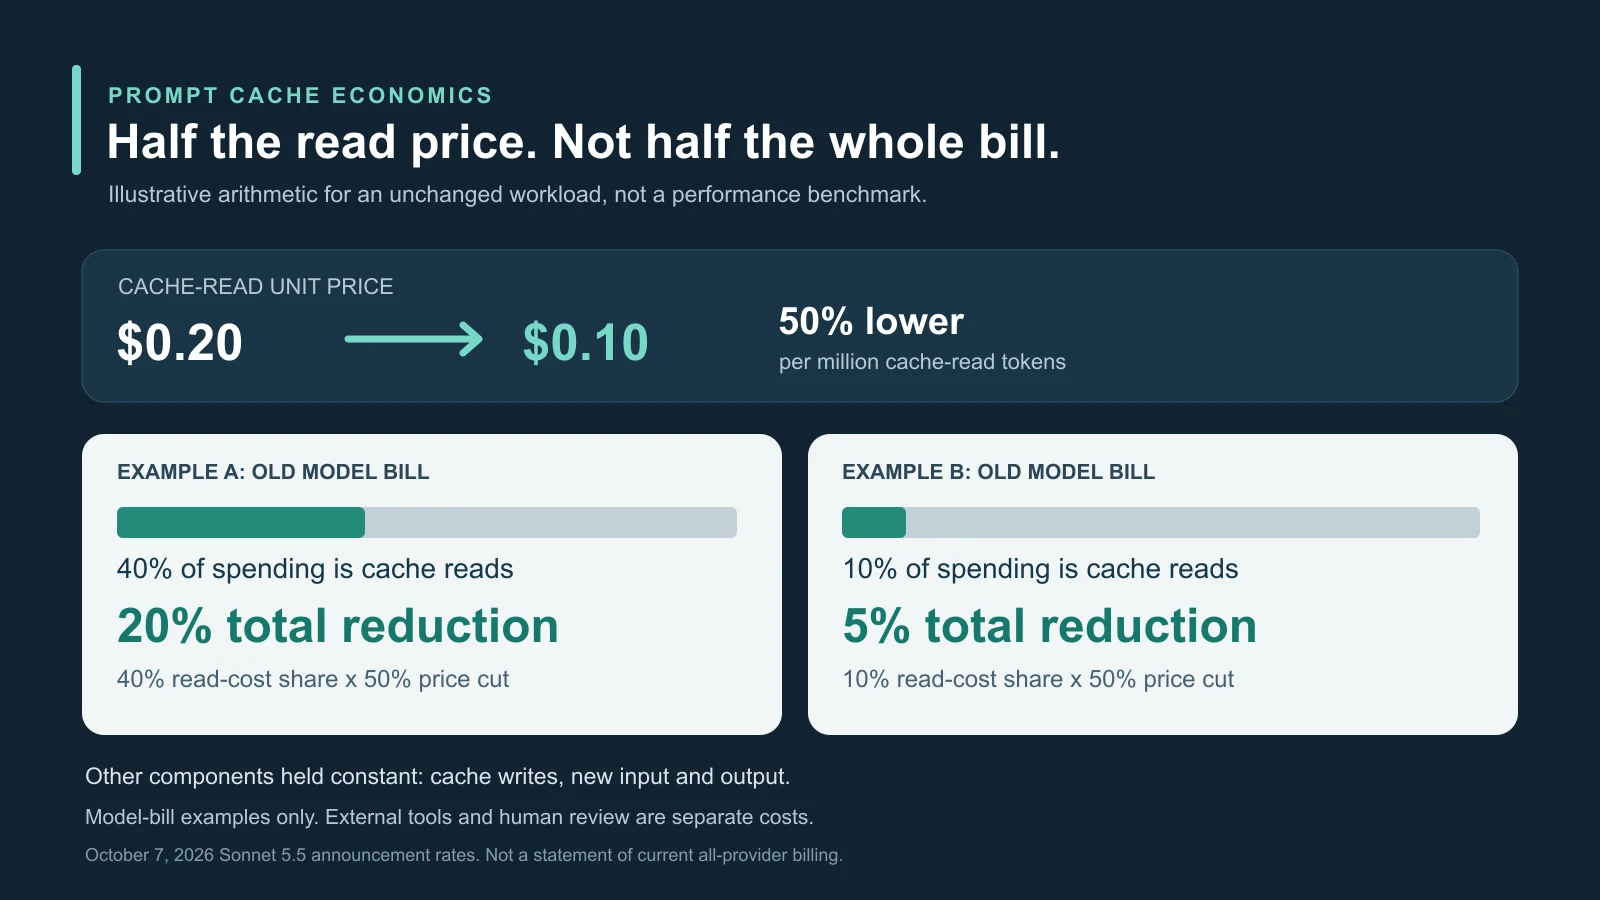
2026年10月7日,Anthropic 在发布 Claude Haiku 5.5 的同时,将 Sonnet 5.5 缓存读取从每百万 token 0.20美元降至0.10美元,并称大多数智能体工作的成本约降20%。标准输入与输出价格未变。明确的单价调整,与依赖工作负载的估算,必须分开理解。
价格表究竟变了什么
公告所列 Sonnet 5.5 标准输入为每百万 token 2美元,输出10美元。因此缓存命中的单价从普通输入的10%降至5%。生成输出的单位价格,仍是新缓存读取价格的100倍。
创建缓存是另一笔费用。Anthropic 列出五分钟缓存写入为每百万 token 2.50美元,一小时写入4美元。可复用内容需要先存储,因此都比普通输入更贵。只有后续请求复用足够多次,较低读取费才能体现价值。
编程智能体可能反复携带代码库指令、工具模式、编码规范和选定文件。研究流程可以复用政策手册或文档包,客服代理可保留产品目录和升级处理规则。最新消息与工作状态变化,不必意味着整个稳定前缀都被替换。
以原报道的简化示例看,100次请求各发送100,000个稳定 token,无缓存时就是1,000万普通输入 token。有效复用时,首个请求写入前缀,后续请求从缓存读取其中大部分。新价格减半的是这些读取费用,而不是写入、新输入、输出及其余流程成本。
这次调整距离 Sonnet 5.5 于9月28日发布不足两周。发布时缓存读取为0.20美元,Anthropic 已强调较 Sonnet 5 使用更少 token、每项任务成本最高降低30%、输出生成速度快30%以上。这些是公司在特定工作和配置下的说法,不是所有请求的保证折扣。
因此,降价强化的是任务层面的论点:持续运行的智能体反复为操作上下文付费,而不是只生成孤立的聊天回复。至于这种重复本身是否高效,仍是另一回事。
约20%节省背后的计算
假设缓存读取原本占某工作负载模型账单的40%,将这一部分减半,总额就降20%。若只占10%,相同降价让模型总支出降5%。这是说明关系的例子,不是任何特定客户的实测。
Anthropic 没有公布“大多数智能体工作”背后的详细客户分布。编程、研究、浏览器操作和客服具有不同 token 结构。因此,约20%应理解为公司建模或观察到的组合,而不是总运营成本自动下降的幅度。
缓存命中要求内容在规定有效期内匹配并符合资格,不是模型的永久记忆。相似文字不一定是相同的可复用前缀;修改靠前指令、时间戳、工具定义或检索文档顺序,都可能破坏复用。
提示词组织因此很重要。Anthropic 建议把静态指令和工具放在前面,频繁变化内容放后面。稳定前缀若复用数百次,就能消化写入溢价;只用一次,则没有后续读取节省。
过期带来另一种取舍。五分钟缓存可能适合密集循环,却会在漫长审批暂停时失效。若能避免足够多的重复写入,更贵的一小时写入反而可能降低总支出。不能只看其单位价格判断哪条路径更便宜。
将创建与读取计数分开,有助于解释效果不佳的原因。较低读写比可能来自有效期过短、前缀变化、模型路由或请求根本不再使用已存材料。不看计数、只优化理论提示长度,会把潜在复用误当成已计费的真实复用。
上下文筛选也有独立价值。可搜索的工程知识库与智能体,都需要相关且有组织的信息。缓存无关内容,只会降低重复传输成本,不会使信息更有用;歧义仍会引出额外输出与修正。
相同标价不代表相同任务成本
原报道在公告时点的比较中,将 Sonnet 5.5 与 OpenAI GPT-6.1 Sol 的普通输入、缓存输入、输出,分别列为每百万 token 2美元、0.10美元和10美元。此前缓存输入两倍的可见差异消失了。
原比较还为两者列出2.50美元的基础时长缓存写入数字。这是该报道呈现的价格表,不是两家缓存创建计费或实现完全相同的证据。不能仅凭数字并列,就推定具体端点如何收取写入费用、哪些内容符合资格。
原报道描述 GPT-6.1 Sol 文档列有105万 token 上下文窗口和多种推理强度,也讨论显式或隐式缓存断点、最低提示长度和用量报告。Anthropic 则有自己的控制、时长、断点和计数。读取价格相同,不保证迁移后的命中率相同。
一个任务可能由某模型调用8次完成,另一模型需要15次。后者可能生成更多推理输出、调用额外工具或重复失败补丁。这是说明同价产生不同账单的例子,不是已报告的模型对照测量。
Anthropic 报告 Sonnet 5.5 在多步骤命令行专业任务基准 Terminal-Bench 4.0 上得分70.6%,并称较 Sonnet 5 用更少 token、运行速度快30%以上。推理强度、代理框架、提示词与工具都影响结果,生产任务分布可能不同。
OpenAI 发布公告也提出效率说法,称 GPT-6.1 Sol 以更低标准 token 价格接近 GPT-6 Astra 能力。其研究评估环境,不保证等同 API 行为。两家的测试套件都没有确立普适赢家。
更少连续步骤还可能缩短等待、释放计算容量,对交互产品的价值可能超过小幅 token 单价差异。但若廉价首轮之后,需要人工找错、恢复受损工作并重跑,就未必经济。真正有意义的单位是被验收的结果。
未改变的费用可能盖过折扣
新输入、输出和缓存写入,不在此次读取降价范围内。长推理过程、冗长解释及反复修正,可能主导模型支出,因为输出远比缓存上下文昂贵。
编排账单范围更广:搜索、浏览器、数据库、代码执行和第三方 API 各有费用。人工审核也是成本,尤其是软件变更、受监管工作和客户数据操作。降低模型中的一个组成部分,不会降低这些费用或消除错误后果。
路由还可能浪费成本。Anthropic 表示,Opus 5.5 在需要持续判断的复杂开放任务上仍更强。把常规、界限清晰的工作交给 Sonnet,较难任务交给大模型,可能有效;但升级前的多轮失败 Sonnet 尝试,也可能超过缓存节省。
因此,应计算失败尝试和升级调用在内的完整路径,而非只看最终成功响应。每次请求看起来便宜的路由器,每项验收任务可能很贵。
分发方式也不支持统一账单结论。Sonnet 可通过 Anthropic 与伙伴平台使用,而价格、地区和功能时间可能不同。0.10美元公告价格是否生效,要看实际生产端点;不能假设云市场的全部区域服务同时改变。
更便宜的缓存也不意味着每次迁移都值得。不同提供商的前缀结构、时效、资格和报告,可能要求先改应用,才能比较命中率。基准质量与可移植性仍属于采购决策。
从更便宜的组成部分,到更便宜的已完成工作
有用证据应将数周用量与结果连接起来:读取 token、创建频率、未缓存输入、输出、工具调用、延迟、重试和升级,以及完成与人工验收。模型费、外部服务费和人工成本仍应区分。
具有代表性的比较,需要同一内部任务集、上下文包、工具、推理设置、重试策略和验收条件。为某模型增加能力或放宽预算,就无法可靠比较经济性。独立评估应披露这些条件,而非把 token 单价当成任务成本。
下一阶段要看实际端点账单、伙伴采用和独立任务级结果。其他厂商继续降价,可能让廉价复用成为基线;没有回应,也可能意味着以质量、基础设施或缓存设计差异化。这些都是可能性,并非本次公告已确立的结果。
Anthropic 降低了一项对长稳定前缀智能体很重要的持续费用,但更广泛的节省仍有条件。若缓存支出下降,而每项验收结果成本没有下降,昂贵部分可能是输出、反复失败、外部工具或人工修正,而不是刚刚变便宜的上下文。
来源与相关阅读
Claude 原始公告;Haiku 发布与缓存价格公告;Sonnet 5.5 发布;可搜索工程知识库相关阅读;Anthropic 提示缓存;GPT-6.1 Sol 模型文档;OpenAI 发布说明;OpenAI 缓存指南。