
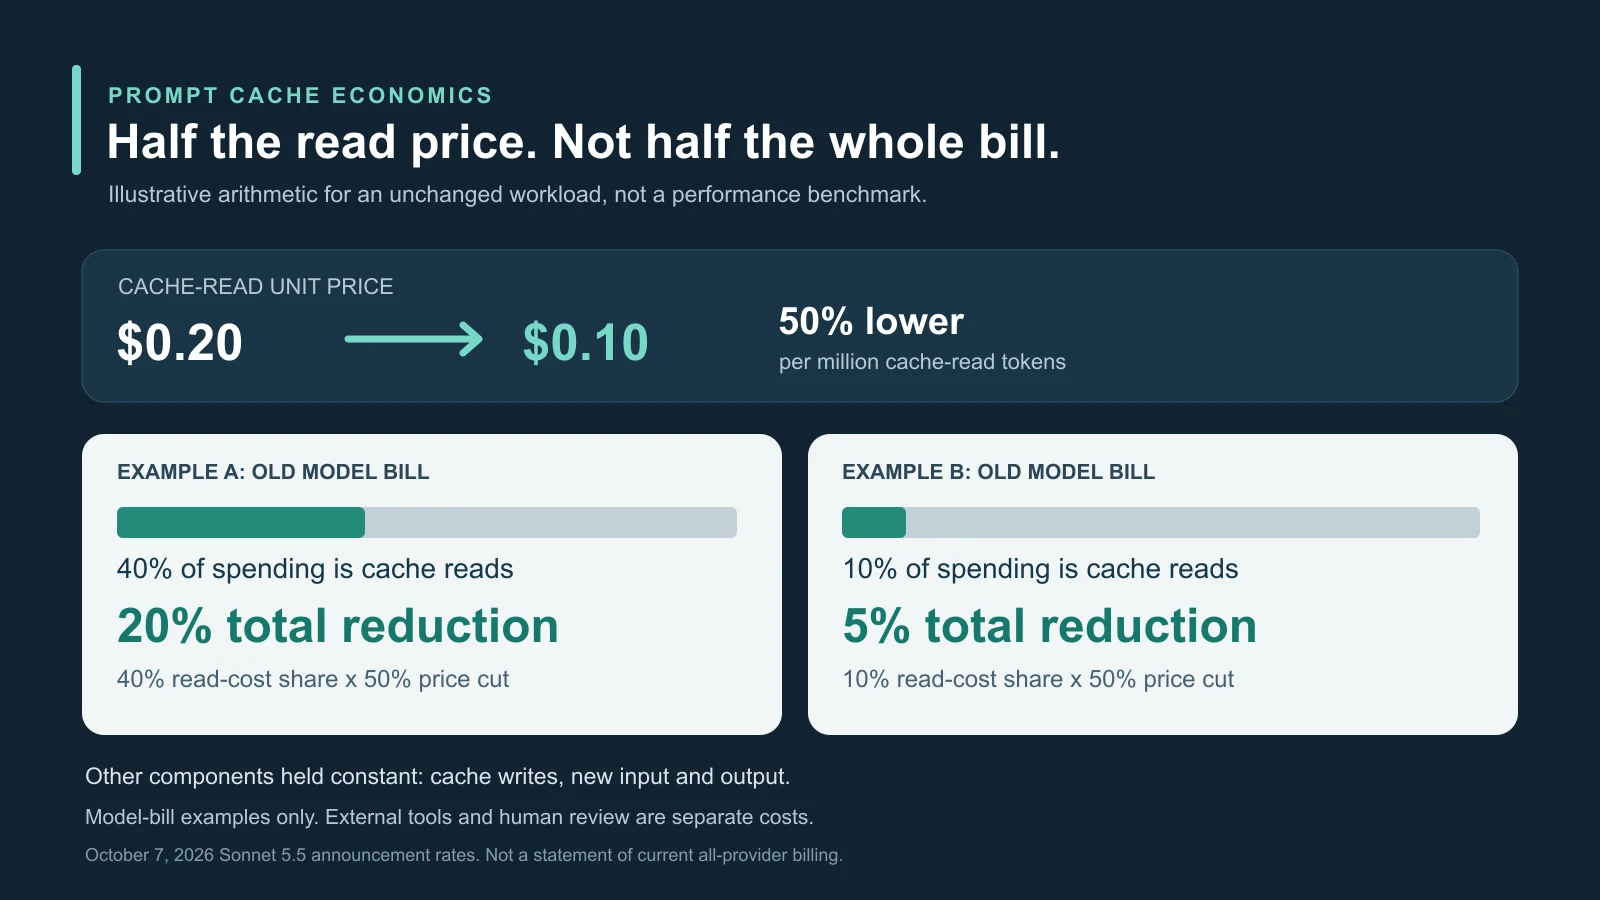
Le chiffre déterminant de l’annonce d’Anthropic n’est pas seulement la baisse de 50 %. C’est la part des lectures de cache dans l’ancienne facture de l’agent. Diviser une composante par deux peut améliorer les longs processus, sans presque changer une conversation courte ou une tâche dominée par les sorties.
Le 7 octobre 2026, avec la sortie de Claude Haiku 5.5, Anthropic a ramené les lectures du cache Sonnet 5.5 de 0,20 à 0,10 dollar par million de tokens. L’entreprise décrit la plupart des travaux agentiques comme environ 20 % moins chers. Entrées ordinaires et sorties n’ont pas changé. Une baisse concrète de prix unitaire diffère d’une estimation dépendant de la charge.
Ce qui change dans les tarifs
Le tarif Sonnet décrit à l’annonce est de 2 dollars par million de tokens d’entrée standard et 10 dollars de sortie. Un accès au cache coûte donc 5 % de l’entrée ordinaire au lieu de 10 %. La sortie reste cent fois plus chère par token que la nouvelle lecture.
La création du cache est facturée séparément. Anthropic indique 2,50 dollars par million pour cinq minutes et 4 dollars pour une heure. Les deux dépassent l’entrée normale, car le contenu réutilisable doit d’abord être stocké. Des lectures moins chères ne paient qu’avec assez de réutilisations.
Un agent de programmation peut répéter instructions de dépôt, schémas d’outils, règles de codage et fichiers choisis. La recherche peut réutiliser manuels et dossiers ; l’assistance, catalogues et règles d’escalade. Changer messages et état ne nécessite pas de remplacer tout le préfixe stable.
Dans l’exemple simplifié d’origine, 100 000 tokens stables sur 100 requêtes représentent dix millions de tokens ordinaires sans cache. Avec une réutilisation efficace, la première requête écrit et les suivantes lisent l’essentiel. Le nouveau prix divise ces lectures par deux, pas l’écriture, l’entrée nouvelle, la sortie ou les autres étapes.
Le changement suit de moins de deux semaines le lancement Sonnet 5.5 du 28 septembre. La lecture coûtait alors 0,20 dollar et Anthropic annonçait déjà moins de tokens que Sonnet 5, jusqu’à 30 % de coût en moins par tâche et une génération plus de 30 % plus rapide. Ce sont des déclarations d’entreprise sur certaines tâches et configurations, pas des réductions garanties pour chaque requête.
La décision renforce une lecture par tâche : les agents persistants paient plusieurs fois leur contexte opérationnel, plutôt qu’une seule réponse de chatbot. L’efficacité de cette répétition reste une autre question.
Le calcul derrière environ 20 %
Si les lectures représentaient 40 % de l’ancienne facture du modèle, les diviser par deux réduit le total de 20 %. Si elles ne représentaient que 10 %, le total baisse de 5 %. Ce sont des relations illustratives, non des mesures chez un client.
Anthropic n’a pas publié la distribution détaillée des clients derrière « la plupart des travaux agentiques ». Programmation, recherche, navigation et assistance ont des profils différents. Les quelque 20 % représentent donc un mix modélisé ou observé par l’entreprise, pas une réduction automatique de tous les coûts opérationnels.
Un accès au cache nécessite un contenu admissible correspondant pendant une durée définie. Ce n’est pas une mémoire permanente du modèle. Du texte similaire n’est pas nécessairement le même préfixe : instruction initiale, horodatage, définition d’outil ou ordre des documents peuvent rompre la réutilisation.
L’organisation du prompt importe donc. Anthropic recommande instructions et outils statiques au début, contenu changeant ensuite. Un préfixe réutilisé des centaines de fois amortit le supplément d’écriture ; utilisé une fois, il ne génère aucune lecture ultérieure économisée.
L’expiration ajoute un compromis. Cinq minutes conviennent aux boucles serrées, mais peuvent s’écouler pendant une longue approbation. L’écriture d’une heure, plus chère, peut réduire le total en évitant assez de réécritures. Son seul prix unitaire ne décide pas du parcours économique.
Séparer compteurs de création et lecture explique les mauvais résultats. Un faible ratio peut indiquer durée courte, préfixes instables, routage ou matériel jamais réutilisé. Optimiser seulement la taille théorique confond réutilisation possible et réellement facturée.
La sélection du contexte importe indépendamment. Une base technique consultable et un agent ont besoin d’informations pertinentes et organisées. Mettre l’inutile en cache ne fait que rendre sa répétition moins chère, pas plus utile. L’ambiguïté peut toujours ajouter sorties et corrections.
Des tarifs égaux ne créent pas des tâches égales
La comparaison d’origine au moment de l’annonce place Sonnet 5.5 et OpenAI GPT-6.1 Sol aux mêmes 2 dollars d’entrée ordinaire, 0,10 de cache et 10 de sortie par million. L’écart visible du simple au double sur le cache disparaît.
Le texte initial présente aussi 2,50 dollars d’écriture de durée de base pour les deux. C’est la présentation de cette grille, non une preuve de facturation de création ou d’implémentation identique. Les règles d’écriture et d’admissibilité propres aux points de terminaison ne se déduisent pas de nombres côte à côte.
La source décrit la documentation GPT-6.1 Sol avec 1,05 million de tokens de contexte et plusieurs niveaux de raisonnement, ainsi que limites de cache explicites ou implicites, longueurs minimales et rapports. Anthropic possède ses propres contrôles, durées, limites et compteurs. Des lectures égales ne garantissent pas les mêmes taux après migration.
Une tâche peut demander huit appels à un modèle et 15 à l’autre. Davantage de sortie de raisonnement, d’outils ou de correctifs ratés répétés modifient la facture. Ce sont des exemples, pas des mesures comparatives rapportées.
Anthropic rapporte 70,6 % à Terminal-Bench 4.0 pour des tâches professionnelles multietapes en ligne de commande, et moins de tokens ainsi qu’une vitesse supérieure de plus de 30 % à Sonnet 5. Réglages, harness, prompts et outils comptent ; la distribution en production peut différer.
L’annonce OpenAI avance sa propre efficacité : GPT-6.1 Sol se rapproche de GPT-6 Astra avec des tarifs ordinaires inférieurs. L’environnement de recherche ne promet pas le même comportement API. Aucune suite n’établit un vainqueur universel.
Moins d’étapes séquentielles réduisent l’attente et libèrent du calcul, parfois plus précieux qu’un faible écart de prix pour un produit interactif. Mais un premier essai bon marché n’est pas économique si une personne doit trouver les erreurs, restaurer le travail et relancer. L’unité pertinente est le résultat accepté.
Les dépenses inchangées peuvent dominer la remise
Entrée nouvelle, sortie et écritures ne font pas partie de cette baisse. Long raisonnement, explications verbeuses et corrections répétées peuvent dominer la dépense, car la sortie coûte bien plus que le contexte en cache.
L’orchestration comprend aussi recherche, navigateur, bases, exécution de code et API externes aux tarifs propres. La revue humaine compte particulièrement en logiciel, processus réglementé et données clients. Une composante réduite ne baisse pas ces frais ni les conséquences des erreurs.
Le routage crée un autre gaspillage. Selon Anthropic, Opus 5.5 reste supérieur pour des tâches complexes ouvertes exigeant un jugement soutenu. Réserver la routine bornée à Sonnet et les décisions difficiles au grand modèle peut aider, mais les échecs répétés avant escalade peuvent dépasser les économies du cache.
Le parcours complet inclut donc tentatives échouées et appels d’escalade, pas seulement la dernière réponse réussie. Un routeur peu cher par requête peut être coûteux par tâche acceptée.
La distribution empêche aussi une conclusion universelle. Sonnet est proposé par Anthropic et partenaires, avec prix, régions et calendrier potentiellement différents. Les 0,10 dollar doivent apparaître sur le point de terminaison de production ; on ne suppose pas une mise à jour simultanée de tous les services régionaux.
Un cache moins cher ne rend pas toute migration utile. Structure, durée, admissibilité et rapports propres aux fournisseurs peuvent exiger des changements avant de comparer les taux. Qualité et portabilité restent des critères d’achat.
D’un composant moins cher à un travail réussi moins cher
Des preuves utiles relient plusieurs semaines de tokens lus, fréquence de création, entrée sans cache, sortie, outils, latence, reprises et escalades à la réussite et à l’acceptation humaine. Coûts du modèle, services externes et travail doivent rester distincts.
Une comparaison représentative exige mêmes tâches internes, contexte, outils, réglages, nouvelles tentatives et critères de réception. Donner plus de capacités ou un budget plus généreux à l’un fausse l’économie. Les évaluations indépendantes doivent exposer les conditions, pas présenter le prix du token comme coût de tâche.
Les prochains signaux sont les factures réelles, l’adoption des partenaires et les résultats indépendants par tâche. D’autres baisses pourraient normaliser la réutilisation économique ; aucune réponse pourrait signaler une différenciation par qualité, infrastructure ou cache. Ce sont des possibilités, pas des conséquences établies.
Anthropic réduit une dépense récurrente importante pour les agents aux longs préfixes stables. Le gain global reste conditionnel. Si le cache baisse mais pas le coût par résultat accepté, la partie chère peut être la sortie, les échecs répétés, les outils externes ou la correction humaine, non le contexte qui vient de baisser.
Sources et lectures connexes
Annonce originale Claude; sortie Haiku et annonce du prix; lancement Sonnet 5.5; lecture sur les bases techniques consultables; cache des prompts Anthropic; documentation GPT-6.1 Sol; annonce OpenAI; guide cache OpenAI.