
O número relevante no anúncio da Anthropic não é apenas a redução de 50%. É a parcela da conta anterior do agente que vinha de leituras de cache. Cortar um componente pela metade pode melhorar fluxos longos e quase não afetar uma conversa curta ou uma tarefa dominada por saída.
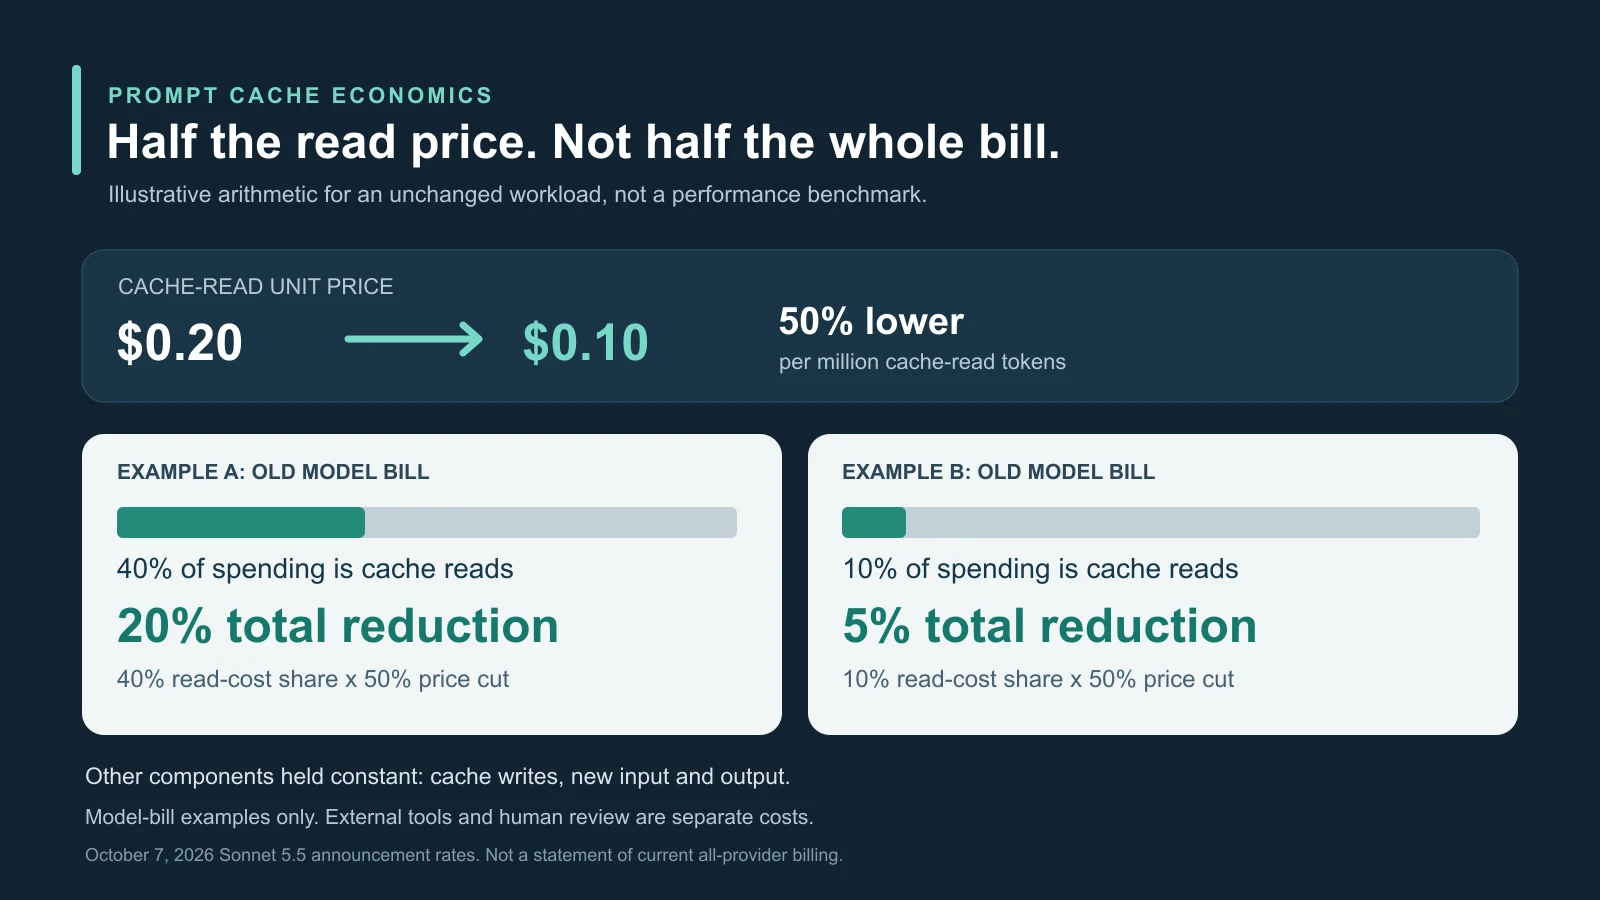
Em 7 de outubro de 2026, junto ao lançamento do Claude Haiku 5.5, a Anthropic baixou leituras de cache do Sonnet 5.5 de US$ 0,20 para US$ 0,10 por milhão de tokens. Disse que a maioria dos trabalhos com agentes ficaria cerca de 20% mais barata. Entrada comum e saída não mudaram. Uma alteração concreta de unidade e uma estimativa dependente do trabalho são coisas diferentes.
O que mudou na tabela
O preço do Sonnet descrito no anúncio é US$ 2 por milhão de tokens de entrada padrão e US$ 10 de saída. Um acerto de cache passa de 10% para 5% da entrada comum. A saída gerada continua cem vezes mais cara por token que a nova leitura.
Criar cache tem cobrança separada. A Anthropic lista gravações de cinco minutos a US$ 2,50 por milhão e de uma hora a US$ 4. Ambas superam a entrada comum porque o conteúdo reutilizável precisa primeiro ser armazenado. Leituras menores compensam somente com reutilização suficiente.
Um agente de programação pode repetir instruções do repositório, esquemas de ferramentas, padrões e arquivos selecionados. Pesquisa pode reutilizar manuais e documentos; suporte, catálogos e regras de escalonamento. Mudanças de mensagem e estado não precisam substituir o prefixo estável inteiro.
No exemplo simplificado original, 100 mil tokens estáveis em 100 solicitações representam dez milhões de tokens comuns sem cache. Com reutilização efetiva, a primeira solicitação grava e as demais leem a maior parte. A nova tarifa reduz essas leituras pela metade, não gravação, entrada nova, saída ou outras etapas.
A mudança veio menos de duas semanas após o lançamento do Sonnet 5.5 em 28 de setembro. Na estreia, a leitura custava US$ 0,20, e a Anthropic já alegava menos tokens que Sonnet 5, até 30% menos custo por tarefa e saída mais de 30% mais rápida. São declarações para trabalhos e configurações específicos, não descontos garantidos em qualquer solicitação.
O movimento reforça uma visão por tarefa: agentes persistentes pagam repetidamente pelo contexto operacional, não apenas por uma resposta isolada. Se essa repetição é eficiente continua sendo outra questão.
A conta por trás dos cerca de 20%
Se leituras eram 40% da conta anterior do modelo, cortá-las pela metade reduz o total em 20%. Se eram 10%, a redução total é 5%. São relações ilustrativas, não medições de um cliente específico.
A Anthropic não publicou uma distribuição detalhada dos clientes por trás de “maioria do trabalho com agentes”. Programação, pesquisa, navegação e suporte têm perfis distintos. Os cerca de 20% devem ser entendidos como mistura modelada ou observada pela empresa, não redução automática de toda despesa operacional.
Um acerto exige conteúdo elegível correspondente dentro da validade. Não é memória permanente do modelo. Texto parecido não é necessariamente o mesmo prefixo: instrução inicial, horário, definição de ferramenta ou ordem dos documentos podem romper a reutilização.
A organização do prompt importa. A Anthropic recomenda instruções e ferramentas estáticas no início e conteúdo variável depois. Um prefixo reutilizado centenas de vezes pode recuperar o adicional de gravação; um usado uma vez não produz economias de leitura posteriores.
A validade cria outro compromisso. Cinco minutos podem servir a ciclos densos e expirar numa longa espera de aprovação. Uma gravação de uma hora, embora mais cara, pode reduzir o total ao evitar repetições suficientes. O preço unitário sozinho não escolhe a rota mais barata.
Separar contadores de criação e leitura explica resultados fracos. Baixa proporção entre leituras e gravações pode indicar validade curta, prefixo variável, roteamento de modelos ou material nunca reutilizado. Otimizar apenas tamanho teórico confunde potencial de reutilização com reutilização realmente cobrada.
A seleção de contexto importa por si. Uma base de engenharia pesquisável e um agente precisam de informação relevante e organizada. Armazenar irrelevância só barateia repetir; não torna útil. Ambiguidades ainda podem provocar saída e correções extras.
Tarifas iguais não criam tarefas iguais
A comparação original no momento do anúncio lista Sonnet 5.5 e OpenAI GPT-6.1 Sol com US$ 2 de entrada comum, US$ 0,10 em cache e US$ 10 de saída por milhão. Desaparece a diferença visível de duas vezes na entrada em cache.
O texto original também apresenta US$ 2,50 de gravação de duração básica para ambos. É a apresentação daquele comparativo, não prova de cobrança de criação ou implementação idêntica. Regras de gravação e elegibilidade de cada endpoint não devem ser inferidas apenas por números lado a lado.
A fonte descreve a documentação GPT-6.1 Sol com 1,05 milhão de tokens de contexto e vários níveis de raciocínio, além de pontos de cache explícitos ou implícitos, comprimentos mínimos e relatórios. A Anthropic tem controles, durações, pontos e contadores próprios. Leituras iguais não garantem taxas iguais de acerto após migração.
Uma tarefa pode exigir oito chamadas num modelo e 15 em outro. Mais saída de raciocínio, ferramentas adicionais ou repetição de patch malsucedido mudam a conta. São exemplos, não medições diretas reportadas.
A Anthropic reporta 70,6% no Terminal-Bench 4.0, de tarefas profissionais multietapas na linha de comando, e diz usar menos tokens e superar Sonnet 5 em velocidade por mais de 30%. Esforço, harness, prompts e ferramentas afetam o resultado; a distribuição produtiva pode ser diferente.
O lançamento da OpenAI também traz uma alegação de eficiência: GPT-6.1 Sol se aproxima de GPT-6 Astra com menores preços padrão. O ambiente de pesquisa não garante comportamento idêntico na API. Nenhuma suíte estabelece um vencedor universal.
Menos etapas sequenciais encurtam a espera e liberam computação, algo que pode superar uma pequena diferença de preço num produto interativo. Mas uma primeira tentativa barata não é econômica se alguém precisa encontrar erros, restaurar trabalho e reexecutar. A unidade relevante é um resultado aceito.
Custos inalterados podem dominar o desconto
Entrada nova, saída e gravações não fazem parte desta redução de leitura. Raciocínio longo, explicações excessivas e correções repetidas podem dominar a despesa porque a saída é muito mais cara que contexto em cache.
Orquestração inclui busca, navegadores, bancos, execução de código e APIs externas com tarifas próprias. Revisão humana também custa, especialmente em software, processos regulados e dados de clientes. Um componente menor não baixa essas tarifas nem remove consequências de erros.
Roteamento cria outro desperdício. Segundo a Anthropic, Opus 5.5 continua mais forte em tarefas complexas abertas com julgamento sustentado. Usar Sonnet na rotina delimitada e um modelo maior em decisões difíceis pode ajudar, mas repetidas falhas antes da escalada podem superar a economia de cache.
A rota completa deve incluir tentativas falhas e chamadas de escalonamento, não apenas a resposta final bem-sucedida. Um roteador barato por solicitação pode ser caro por tarefa aceita.
A distribuição também impede conclusão universal. Sonnet existe na Anthropic e em parceiros, com preços, regiões e momentos de recursos potencialmente distintos. Os US$ 0,10 precisam aparecer no endpoint produtivo real; não se deve supor atualização simultânea de todo serviço regional de marketplace.
Cache barato não torna qualquer migração valiosa. Estrutura, duração, elegibilidade e relatórios específicos podem exigir mudanças antes de comparar acertos. Qualidade e portabilidade continuam na decisão de compra.
De componente mais barato a trabalho concluído mais barato
Evidências úteis ligam semanas de tokens lidos, frequência de criação, entrada sem cache, saída, ferramentas, latência, tentativas e escaladas à conclusão e aceitação humana. Gastos de modelo, externos e de trabalho devem permanecer distintos.
Uma comparação representativa exige os mesmos trabalhos internos, contexto, ferramentas, esforço, repetição e critérios de aceitação. Dar capacidades extras ou orçamento mais livre a um modelo prejudica a comparação. Avaliações independentes precisam divulgar condições em vez de chamar preço de token de custo da tarefa.
Os próximos sinais são contas reais dos endpoints, adoção pelos parceiros e resultados independentes por tarefa. Novos cortes poderiam tornar reutilização barata uma base; ausência de reação poderia indicar diferenciação por qualidade, infraestrutura ou design de cache. São possibilidades, não resultados estabelecidos.
A Anthropic reduziu uma cobrança recorrente importante para agentes com prefixos longos e estáveis. A economia mais ampla continua condicional. Se o cache cai e o custo por resultado aceito não, o caro pode ser saída, falha repetida, ferramentas externas ou correção humana, não o contexto recém-barateado.
Fontes e leitura relacionada
Anúncio original Claude; lançamento Haiku e preço de cache; lançamento Sonnet 5.5; leitura sobre bases de engenharia pesquisáveis; cache de prompts Anthropic; documentação GPT-6.1 Sol; lançamento OpenAI; guia de cache OpenAI.