
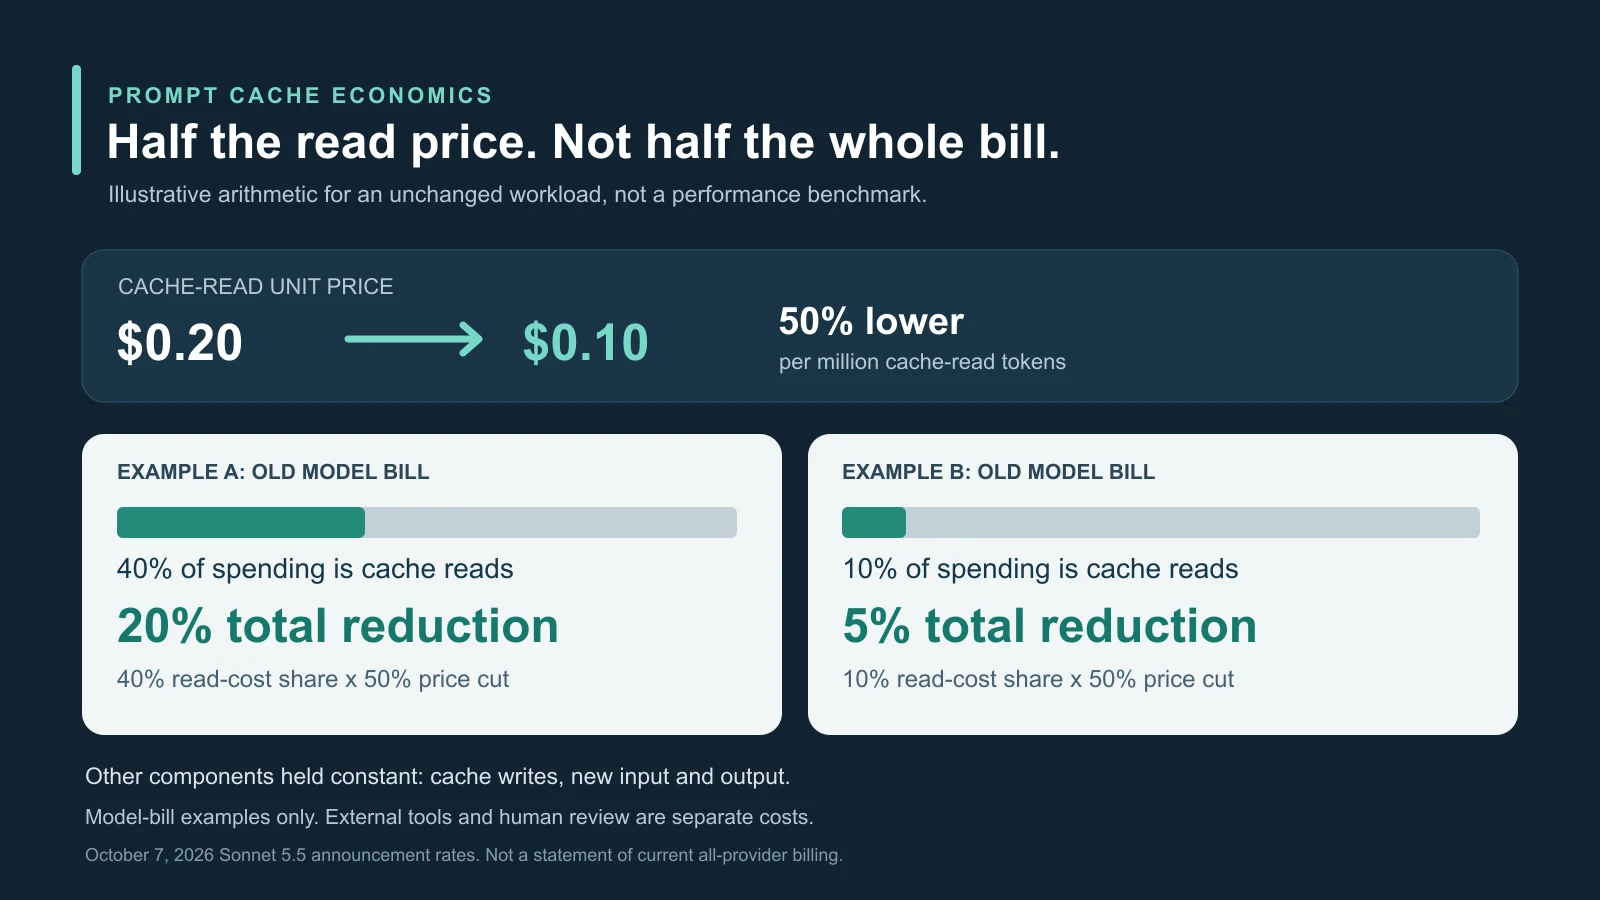
Najważniejszą liczbą w ogłoszeniu Anthropic nie jest samo 50% obniżki. Jest nią udział odczytów cache w dotychczasowym rachunku agenta. Zmniejszenie jednego składnika o połowę może poprawić długie procesy, a niemal nie zmienić krótkiej rozmowy lub zadania zdominowanego przez wyjście.
7 października 2026 r., wraz z premierą Claude Haiku 5.5, Anthropic obniżył odczyt cache Sonnet 5.5 z 0,20 do 0,10 USD za milion tokenów. Według firmy większość pracy agentowej staje się około 20% tańsza. Standardowe wejście i wyjście nie zmieniły cen. Konkretną zmianę jednostkową trzeba oddzielić od szacunku zależnego od obciążenia.
Co zmieniło się w cenniku
Cennik Sonnet 5.5 opisywany przy ogłoszeniu podaje 2 USD za milion zwykłych tokenów wejściowych i 10 USD za wyjściowe. Trafienie cache kosztuje więc 5% zwykłego wejścia zamiast 10%. Jednostkowe wyjście nadal jest sto razy droższe od nowego odczytu.
Tworzenie cache ma inną opłatę. Anthropic podaje 2,50 USD za milion tokenów przy pięciu minutach i 4 USD przy godzinie. Obie stawki przewyższają zwykłe wejście, bo materiał trzeba najpierw zapisać. Tanie odczyty opłacają się po dostatecznej liczbie ponownych użyć.
Agent programistyczny może powtarzać instrukcje repozytorium, schematy narzędzi, standardy kodu i wybrane pliki. Badania mogą używać podręcznika polityk lub pakietu dokumentów, a obsługa klienta katalogu i zasad eskalacji. Nowe wiadomości i stan pracy nie muszą zmieniać całego stabilnego prefiksu.
Uproszczony przykład źródła to 100 000 stałych tokenów w 100 żądaniach: bez cache dziesięć milionów zwykłych tokenów wejścia. Przy skutecznym użyciu pierwsze żądanie zapisuje prefiks, a kolejne odczytują większość. Nowa cena dzieli przez dwa te odczyty, nie zapis, świeże wejście, wyjście czy resztę procesu.
Zmiana nastąpiła niecałe dwa tygodnie po premierze Sonnet 5.5 z 28 września. Wtedy odczyt kosztował 0,20 USD, a Anthropic już podkreślał mniej tokenów niż Sonnet 5, do 30% niższy koszt zadania i ponad 30% szybsze generowanie. To deklaracje firmy dla określonych prac i konfiguracji, nie gwarantowane rabaty każdego żądania.
Ruch wzmacnia więc argument zadaniowy: trwałe agenty wielokrotnie płacą za kontekst działania zamiast pojedynczej odpowiedzi chatbota. Czy samo powtarzanie jest wydajne, to odrębne pytanie.
Matematyka około 20% oszczędności
Jeśli odczyty cache stanowiły 40% wcześniejszego rachunku modelowego, obniżenie tego składnika o połowę daje 20% mniej całości. Jeśli stanowiły 10%, całkowite wydatki modelowe spadają o 5%. To ilustracje zależności, nie pomiary konkretnego klienta.
Anthropic nie opublikował szczegółowej struktury obciążeń klientów za określeniem „większość pracy agentowej”. Kodowanie, badania, przeglądarka i obsługa mają różne profile tokenów. Około 20% należy więc czytać jako modelowaną lub obserwowaną mieszankę firmy, nie automatyczny spadek kosztów operacyjnych.
Trafienie wymaga zgodnej, kwalifikującej się treści w określonym czasie życia. Nie oznacza trwałej pamięci modelu. Podobny tekst nie musi być identycznym prefiksem; zmiana wczesnej instrukcji, daty, definicji narzędzia lub kolejności dokumentów może przerwać ponowne użycie.
Układ promptu ma zatem znaczenie. Anthropic zaleca statyczne instrukcje i narzędzia z przodu, a zmienną treść później. Prefiks używany setki razy może pokryć dopłatę za zapis, użyty raz nie daje późniejszych oszczędności odczytu.
Wygaśnięcie tworzy kolejny kompromis. Pięć minut pasuje do intensywnych pętli, ale może minąć w długiej przerwie na zatwierdzenie. Droższy zapis godzinny bywa tańszy łącznie, jeśli zapobiega wielu ponownym zapisom. Sama cena jednostkowa nie rozstrzyga.
Oddzielne liczniki tworzenia i czytania pomagają wyjaśnić słabe wyniki. Niski stosunek odczytów do zapisów może oznaczać krótki czas życia, zmienne prefiksy, routing modeli lub materiał nigdy nieużywany ponownie. Optymalizacja tylko teoretycznego rozmiaru myli możliwe użycie z faktycznie rozliczonym.
Dobór kontekstu pozostaje ważny niezależnie. Przeszukiwalna baza wiedzy inżynierskiej i agent potrzebują uporządkowanych, istotnych informacji. Cache nieistotnej treści jedynie obniża koszt powtórzeń, nie poprawia jej wartości. Niejasności wciąż mogą powodować dodatkowe wyjście i poprawki.
Takie same stawki nie oznaczają takich samych zadań
Źródłowe porównanie w momencie ogłoszenia podaje dla Sonnet 5.5 i OpenAI GPT-6.1 Sol 2 USD zwykłego wejścia, 0,10 USD cache i 10 USD wyjścia za milion tokenów. Znika wcześniejsza widoczna dwukrotna różnica w cache.
Pierwotne porównanie podaje także 2,50 USD zapisu podstawowej długości dla obu. To prezentacja cennika w źródle, nie dowód identycznego rozliczania tworzenia cache i implementacji. Szczegółowych zasad zapisu i kwalifikacji endpointów nie wolno wywodzić z samego sąsiedztwa liczb.
Źródło opisuje dokumentację GPT-6.1 Sol jako wskazującą 1,05 miliona tokenów kontekstu i kilka ustawień rozumowania, a także jawne lub niejawne granice cache, minimalne długości i raportowanie. Anthropic ma własne kontrole, czasy, granice i liczniki. Równe ceny odczytu nie gwarantują równego trafiania po migracji.
Zadanie może wymagać ośmiu wywołań jednego modelu i 15 drugiego. Więcej tokenów rozumowania, dodatkowe narzędzia lub ponowienie błędnej poprawki zmienia rachunek. To przykłady, nie zgłoszone bezpośrednie pomiary.
Anthropic raportuje 70,6% w Terminal-Bench 4.0, dotyczącym wieloetapowych zawodowych zadań w terminalu, oraz mniej tokenów i ponad 30% wyższą szybkość od Sonnet 5. Ustawienia, środowisko agenta, prompty i narzędzia mają znaczenie; produkcyjny rozkład zadań może działać inaczej.
Ogłoszenie OpenAI również przedstawia efektywność, opisując zbliżenie GPT-6.1 Sol do możliwości GPT-6 Astra przy niższych stawkach zwykłych. Środowisko badawcze nie gwarantuje identycznego zachowania API. Żaden zestaw benchmarków nie wyznacza uniwersalnego zwycięzcy.
Mniej kroków sekwencyjnych skraca oczekiwanie i zwalnia moc obliczeniową, co w produkcie interaktywnym bywa ważniejsze niż drobna różnica cen. Tania pierwsza próba nie jest jednak ekonomiczna, gdy człowiek musi znaleźć błąd, odtworzyć uszkodzoną pracę i uruchomić ją ponownie. Istotny jest zaakceptowany wynik.
Niezmienione koszty mogą przewyższyć rabat
Świeże wejście, wyjście i zapis nie podlegają tej obniżce. Długie rozumowanie, rozwlekłe wyjaśnienia i ponowne poprawki mogą dominować w kosztach modelu, bo wyjście jest znacznie droższe niż cache.
Orkiestracja obejmuje też wyszukiwarki, przeglądarki, bazy, wykonanie kodu i zewnętrzne API z własnymi opłatami. Weryfikacja człowieka kosztuje szczególnie przy zmianach oprogramowania, procesach regulowanych i danych klientów. Tańszy składnik modelu nie zmniejsza tych opłat ani skutków błędów.
Routing także może marnować pieniądze. Anthropic wskazuje, że Opus 5.5 pozostaje mocniejszy w złożonych otwartych zadaniach wymagających trwałego osądu. Rutynę można dać Sonnet, trudne decyzje większemu modelowi, ale seria porażek przed eskalacją może pochłonąć więcej niż oszczędność cache.
Cały przebieg musi więc obejmować nieudane próby i wywołania eskalacji, nie tylko końcową odpowiedź. Router tani na żądanie może być drogi na zaakceptowane zadanie.
Dystrybucja także wyklucza jednolity rachunek. Sonnet jest dostępny przez Anthropic i partnerów, z możliwie różnymi cenami, regionami i terminami funkcji. Stawkę 0,10 USD trzeba potwierdzić na używanym endpointcie; nie zakładać jednoczesnej zmiany wszystkich regionalnych usług marketplace.
Tańszy cache nie uzasadnia też każdej migracji. Struktura promptu, długość życia, kwalifikacja i raporty zależą od dostawcy i mogą wymagać zmian aplikacji przed porównaniem trafień. Jakość i przenośność nadal należą do decyzji zakupowej.
Od tańszego składnika do tańszej zakończonej pracy
Przydatne dowody łączą kilka tygodni odczytanych tokenów, częstotliwości tworzenia, wejścia bez cache, wyjścia, narzędzi, opóźnień, ponowień i eskalacji z ukończeniem oraz akceptacją człowieka. Koszty modelu trzeba oddzielić od usług zewnętrznych i pracy.
Reprezentatywny test wymaga tych samych zadań wewnętrznych, kontekstu, narzędzi, ustawień rozumowania, polityki ponowień i kryteriów odbioru. Dodatkowe funkcje lub luźniejszy budżet jednego modelu uniemożliwiają wiarygodne porównanie. Niezależne testy powinny ujawniać warunki, nie podawać ceny tokena jako kosztu zadania.
Kolejne sygnały to faktyczne rachunki endpointów, przyjęcie przez partnerów i niezależne wyniki zadań. Dalsze obniżki mogą uczynić tanie użycie standardem, brak reakcji sugerować różnicowanie jakością, infrastrukturą lub projektem cache. To możliwości, nie ustalone skutki ogłoszenia.
Anthropic obniżył konkretną opłatę powtarzalną ważną dla agentów z długim stabilnym prefiksem. Szersza oszczędność jest warunkowa. Gdy koszt cache spada, a koszt zaakceptowanego wyniku nie, drogim elementem może być wyjście, powtarzana porażka, zewnętrzne narzędzia lub poprawki człowieka, nie właśnie przeceniony kontekst.
Źródła i materiały powiązane
Pierwotne ogłoszenie Claude; premiera Haiku i ogłoszenie ceny; premiera Sonnet 5.5; materiał o bazach wiedzy inżynierskiej; cache promptów Anthropic; dokumentacja GPT-6.1 Sol; ogłoszenie OpenAI; przewodnik cache OpenAI.