
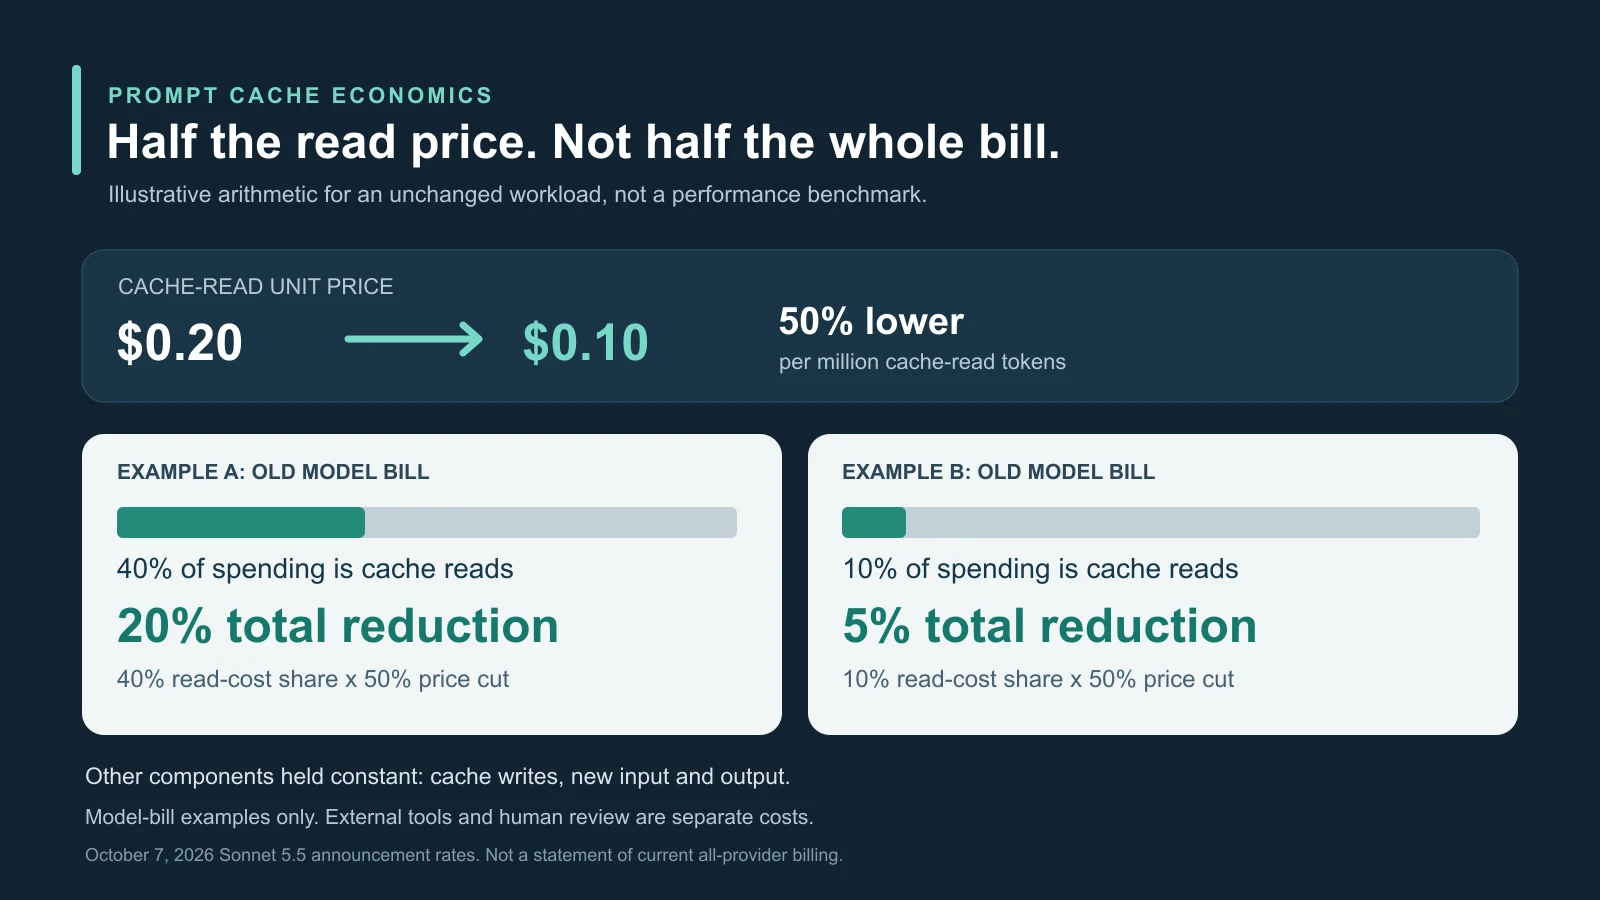
El número decisivo del anuncio de Anthropic no es solo la reducción del 50%. Es la proporción de la factura anterior del agente que correspondía a lecturas de caché. Dividir un componente por dos puede mejorar procesos largos y apenas cambiar una conversación corta o una tarea dominada por la salida.
El 7 de octubre de 2026, junto al lanzamiento de Claude Haiku 5.5, Anthropic redujo las lecturas de Sonnet 5.5 de 0,20 a 0,10 dólares por millón de tokens. Describió la mayoría del trabajo agéntico como alrededor de un 20% más barato. Entrada ordinaria y salida no cambiaron. Una reducción concreta de unidad es distinta de una estimación dependiente del trabajo.
Qué cambió en la tarifa
El precio Sonnet descrito en el anuncio es de 2 dólares por millón de tokens de entrada estándar y 10 de salida. Un acierto de caché pasa del 10% al 5% de la entrada normal. La salida generada sigue siendo cien veces más cara por token que la nueva lectura.
Crear caché se cobra aparte. Anthropic indica 2,50 dólares por millón para cinco minutos y 4 para una hora. Ambos superan la entrada normal porque el contenido reutilizable debe guardarse primero. Lecturas baratas compensan solo con suficientes reutilizaciones posteriores.
Un agente de programación repite instrucciones de repositorio, esquemas de herramientas, normas y archivos elegidos. La investigación puede reutilizar manuales y documentos; el soporte, catálogos y reglas de escalado. Cambiar mensajes y estado no requiere sustituir todo el prefijo estable.
En el ejemplo simplificado original, 100.000 tokens estables en 100 solicitudes representan diez millones de tokens normales sin caché. Con reutilización efectiva, la primera solicitud escribe y las siguientes leen la mayor parte. El nuevo precio divide esas lecturas por dos, no escritura, entrada nueva, salida ni otras etapas.
El cambio llegó menos de dos semanas después del lanzamiento Sonnet 5.5 del 28 de septiembre. La lectura costaba entonces 0,20 dólares y Anthropic ya afirmaba usar menos tokens que Sonnet 5, hasta un 30% menos coste por tarea y salida más de un 30% más rápida. Son declaraciones para trabajos y configuraciones concretos, no descuentos garantizados para toda solicitud.
La medida refuerza una visión por tarea: agentes persistentes pagan repetidamente el contexto operativo, no una sola respuesta de chatbot. Si esa repetición es eficiente sigue siendo otra cuestión.
La cuenta detrás de alrededor del 20%
Si las lecturas eran el 40% de la factura anterior del modelo, dividirlas por dos reduce el total un 20%. Si eran solo el 10%, el total baja un 5%. Son relaciones ilustrativas, no mediciones de un cliente particular.
Anthropic no publicó la distribución detallada de clientes detrás de «la mayoría del trabajo agéntico». Programación, investigación, navegación y soporte tienen perfiles distintos. Alrededor del 20% representa una mezcla modelada u observada por la empresa, no una caída automática de todos los costes operativos.
Un acierto requiere contenido elegible coincidente dentro de una duración definida. No es memoria permanente del modelo. Texto similar no equivale al mismo prefijo: instrucciones iniciales, fechas, definiciones de herramientas u orden de documentos pueden romper la reutilización.
La organización importa. Anthropic recomienda instrucciones y herramientas estáticas al principio y contenido variable después. Un prefijo reutilizado cientos de veces absorbe el sobrecoste de escritura; uno usado una sola vez no genera ahorros posteriores de lectura.
La caducidad añade otra disyuntiva. Cinco minutos sirven para bucles intensivos, pero pueden agotarse en una larga espera de aprobación. La escritura de una hora, más cara, puede reducir el total evitando suficientes reescrituras. El precio unitario no decide por sí solo la ruta económica.
Separar contadores de creación y lectura explica resultados débiles. Una baja proporción puede indicar duración corta, prefijos cambiantes, enrutamiento o material nunca reutilizado. Optimizar solo el tamaño teórico confunde reutilización posible con la realmente facturada.
La selección de contexto importa por separado. Una base técnica con búsqueda y un agente necesitan información pertinente y organizada. Guardar irrelevancia solo abarata repetirla, no la hace útil. La ambigüedad aún puede añadir salida y correcciones.
Tarifas iguales no crean tareas iguales
La comparación original en el momento del anuncio sitúa Sonnet 5.5 y OpenAI GPT-6.1 Sol en 2 dólares de entrada normal, 0,10 de caché y 10 de salida por millón. Desaparece la diferencia visible de dos veces en entrada almacenada.
El texto original también presenta 2,50 dólares de escritura básica para ambos. Es la presentación de aquella tabla, no prueba de que creación, facturación o implementación sean idénticas. Las reglas de escritura y elegibilidad de cada endpoint no se deducen de números contiguos.
La fuente describe documentación GPT-6.1 Sol con 1,05 millones de tokens de contexto y varios esfuerzos de razonamiento, además de límites de caché explícitos o implícitos, longitudes mínimas e informes. Anthropic tiene controles, duraciones, límites y contadores propios. Lecturas al mismo precio no garantizan los mismos aciertos tras migrar.
Una tarea puede necesitar ocho llamadas en un modelo y 15 en otro. Más salida de razonamiento, herramientas extra o repetición de parches fallidos cambian la factura. Son ejemplos, no mediciones directas comunicadas.
Anthropic reporta 70,6% en Terminal-Bench 4.0 para tareas profesionales multietapa en terminal, y menos tokens y más de un 30% de velocidad frente a Sonnet 5. Ajustes, entorno del agente, prompts y herramientas importan; la distribución productiva puede diferir.
El lanzamiento OpenAI formula su propia eficiencia: GPT-6.1 Sol se aproxima a GPT-6 Astra con tarifas estándar inferiores. El entorno de investigación no promete el mismo comportamiento API. Ninguna suite establece un ganador universal.
Menos pasos secuenciales reducen espera y liberan cómputo, algo a veces más valioso que pequeñas diferencias de precio en productos interactivos. Pero un primer intento barato no es económico si alguien debe encontrar errores, restaurar trabajo y repetirlo. La unidad pertinente es un resultado aceptado.
Los costes sin cambios pueden dominar el descuento
Entrada nueva, salida y escrituras quedan fuera de esta reducción. Razonamientos largos, explicaciones extensas y correcciones repetidas pueden dominar el gasto porque la salida es mucho más cara que el contexto en caché.
La orquestación también incluye búsqueda, navegadores, bases, ejecución de código y API externas con tarifas propias. Revisión humana cuenta especialmente en software, procesos regulados y datos de clientes. Un componente menor no baja esas tarifas ni elimina las consecuencias de errores.
El enrutamiento añade desperdicio. Anthropic dice que Opus 5.5 sigue siendo más fuerte en tareas complejas abiertas con juicio sostenido. Dar rutina delimitada a Sonnet y decisiones difíciles al modelo grande puede ayudar, pero fallos repetidos antes de escalar pueden superar el ahorro.
La ruta completa incluye intentos fallidos y llamadas de escalado, no solo la última respuesta exitosa. Un enrutador barato por solicitud puede ser caro por tarea aceptada.
La distribución también impide una conclusión universal. Sonnet se ofrece mediante Anthropic y socios con precios, regiones y tiempos potencialmente distintos. Los 0,10 dólares deben aparecer en el endpoint productivo real; no se presupone actualización simultánea de todo servicio regional.
Caché barata tampoco hace valiosa toda migración. Estructura, duración, elegibilidad e informes del proveedor pueden exigir cambios antes de comparar aciertos. Calidad y portabilidad siguen en la decisión de compra.
De componente barato a trabajo terminado barato
Pruebas útiles conectan semanas de tokens leídos, frecuencia de creación, entrada sin caché, salida, herramientas, latencia, reintentos y escalados con finalización y aceptación humana. Gastos de modelo, servicios externos y trabajo deben permanecer separados.
Una comparación representativa necesita las mismas tareas internas, contexto, herramientas, ajustes de razonamiento, política de reintentos y criterios de aceptación. Dar funciones extra o un presupuesto más generoso a uno impide una comparación económica fiable. Evaluaciones independientes deben revelar condiciones, no presentar precio de token como coste de tarea.
Las próximas señales son facturas reales, adopción de socios y resultados independientes por tarea. Nuevas rebajas podrían convertir reutilización barata en base; ninguna respuesta podría señalar diferenciación por calidad, infraestructura o diseño. Son posibilidades, no consecuencias establecidas.
Anthropic redujo una tarifa recurrente importante para agentes con prefijos largos y estables. El ahorro general sigue siendo condicional. Si el gasto de caché cae y el coste por resultado aceptado no, lo caro puede ser salida, fallos repetidos, herramientas externas o corrección humana, no el contexto recién abaratado.
Fuentes y lecturas relacionadas
Anuncio original Claude; lanzamiento Haiku y precio de caché; lanzamiento Sonnet 5.5; lectura sobre bases técnicas con búsqueda; caché de prompts Anthropic; documentación GPT-6.1 Sol; lanzamiento OpenAI; guía caché OpenAI.