
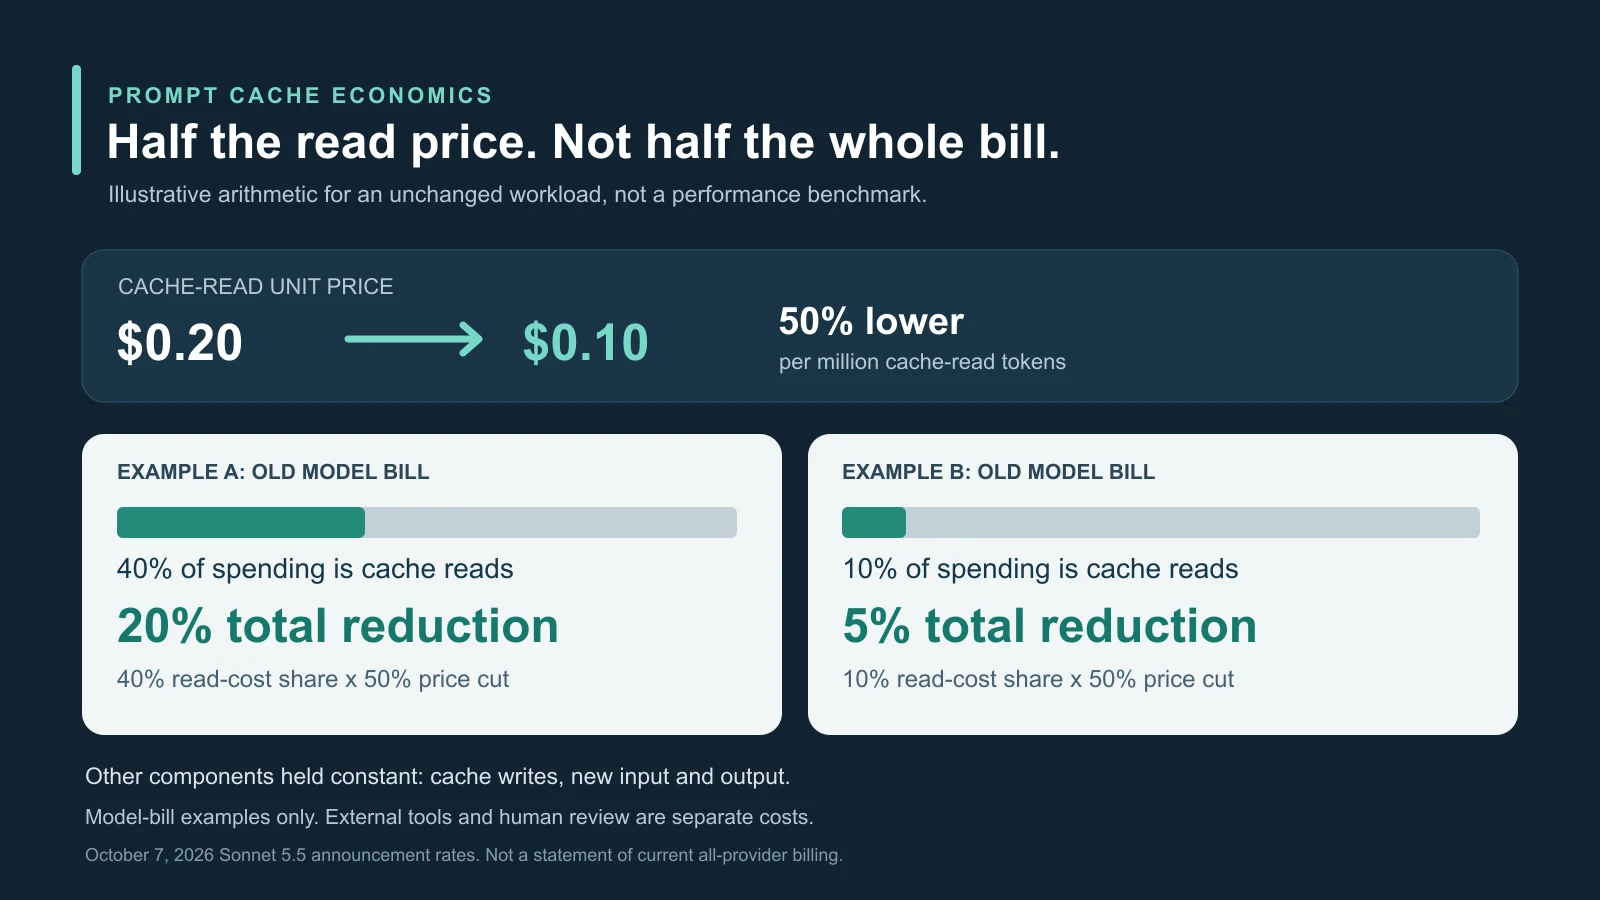
Il numero decisivo nell’annuncio di Anthropic non è soltanto la riduzione del 50%. È la quota della precedente fattura dell’agente dovuta alle letture della cache. Dimezzare una componente può migliorare processi lunghi, cambiando poco una conversazione breve o un’attività dominata dall’output.
Il 7 ottobre 2026, insieme a Claude Haiku 5.5, Anthropic ha ridotto le letture della cache Sonnet 5.5 da 0,20 a 0,10 dollari per milione di token. Ha descritto la maggior parte del lavoro agentico come circa il 20% meno costoso. Input ordinario e output non sono cambiati. Una variazione concreta della tariffa è diversa da una stima dipendente dal lavoro.
Che cosa cambia nel listino
I prezzi Sonnet descritti all’annuncio sono 2 dollari per milione di token in input standard e 10 in output. Un accesso alla cache costa quindi il 5% dell’input ordinario, anziché il 10%. L’output generato resta cento volte più caro per token della nuova lettura.
La creazione della cache si paga separatamente. Anthropic indica 2,50 dollari per milione per cinque minuti e 4 dollari per un’ora. Entrambi superano l’input normale, perché il contenuto riutilizzabile va prima salvato. Letture economiche compensano solo dopo abbastanza riutilizzi.
Un agente di programmazione ripete istruzioni del repository, schemi degli strumenti, standard e file selezionati. La ricerca può riusare manuali e documenti, il supporto cataloghi e regole di escalation. Messaggi e stato aggiornati non devono sostituire l’intero prefisso stabile.
Nell’esempio semplificato della fonte, 100.000 token stabili su 100 richieste corrispondono a dieci milioni di token ordinari senza cache. Con riuso efficace la prima richiesta scrive, le successive leggono gran parte del prefisso. Il nuovo prezzo dimezza queste letture, non scrittura, nuovo input, output o altre fasi.
Il cambiamento è arrivato meno di due settimane dopo il lancio Sonnet 5.5 del 28 settembre. Allora la lettura costava 0,20 dollari e Anthropic già dichiarava meno token di Sonnet 5, costo per attività fino al 30% inferiore e output oltre il 30% più rapido. Sono affermazioni aziendali per lavori e configurazioni particolari, non sconti garantiti su ogni richiesta.
La mossa rafforza quindi una lettura per attività: gli agenti persistenti pagano ripetutamente il contesto operativo, anziché una sola risposta di chatbot. Se quella ripetizione sia efficiente resta una questione distinta.
Il calcolo dietro circa il 20%
Se le letture erano il 40% della precedente fattura del modello, dimezzarle riduce il totale del 20%. Se erano il 10%, il totale scende del 5%. Sono relazioni illustrative, non misure di un cliente specifico.
Anthropic non ha pubblicato una distribuzione dettagliata dei clienti dietro “la maggior parte del lavoro agentico”. Coding, ricerca, navigazione e supporto hanno profili diversi. Il circa 20% va letto come mix modellato o osservato dall’azienda, non calo automatico dei costi operativi.
Un cache hit richiede contenuto idoneo corrispondente entro una durata stabilita. Non è memoria permanente del modello. Testo simile non significa lo stesso prefisso: modificare istruzioni iniziali, timestamp, definizioni di strumenti o ordine dei documenti può rompere il riuso.
Conta dunque l’organizzazione del prompt. Anthropic raccomanda istruzioni e strumenti statici all’inizio, contenuti variabili dopo. Un prefisso usato centinaia di volte assorbe il sovrapprezzo di scrittura; usato una volta non genera risparmi successivi.
La scadenza crea un altro compromesso. Cinque minuti possono adattarsi a cicli densi ma esaurirsi durante una lunga approvazione. La scrittura di un’ora, più cara, può ridurre il totale evitando abbastanza riscritture. Il prezzo unitario da solo non decide il percorso meno costoso.
Contatori separati per creazione e lettura spiegano risultati scarsi. Un basso rapporto può indicare durata breve, prefissi mutevoli, routing o materiale mai riutilizzato. Ottimizzare soltanto la dimensione teorica confonde riuso possibile e riuso effettivamente fatturato.
La selezione del contesto conta indipendentemente. Una base tecnica ricercabile e un agente necessitano di informazioni rilevanti e ordinate. Salvare irrilevanza rende economico ripeterla, non utile. L’ambiguità può ancora produrre output e correzioni aggiuntivi.
Tariffe uguali non creano attività uguali
Il confronto originale al momento dell’annuncio colloca Sonnet 5.5 e OpenAI GPT-6.1 Sol agli stessi 2 dollari di input, 0,10 di cache e 10 di output per milione. Scompare la precedente differenza visibile del doppio sull’input memorizzato.
Il testo originale presenta anche 2,50 dollari di scrittura di durata base per entrambi. È il listino così esposto nella fonte, non prova di fatturazione della creazione o implementazione identica. Trattamento delle scritture e requisiti dei singoli endpoint non si deducono da numeri affiancati.
La fonte descrive la documentazione GPT-6.1 Sol con 1,05 milioni di token di contesto e diversi sforzi di ragionamento, oltre a limiti cache espliciti o impliciti, lunghezze minime e report. Anthropic ha controlli, durate, punti e contatori propri. Letture allo stesso prezzo non garantiscono gli stessi hit dopo la migrazione.
Un’attività può richiedere otto chiamate su un modello e 15 su un altro. Più output di ragionamento, strumenti aggiuntivi o patch fallite ripetute cambiano il conto. Sono esempi, non misure dirette riportate.
Anthropic segnala il 70,6% in Terminal-Bench 4.0 per attività professionali multistep da terminale, e meno token e oltre il 30% di velocità rispetto a Sonnet 5. Impostazioni, harness, prompt e strumenti influenzano il risultato; la distribuzione produttiva può differire.
Il lancio OpenAI formula una propria tesi di efficienza: GPT-6.1 Sol si avvicina a GPT-6 Astra con tariffe standard inferiori. L’ambiente di ricerca non promette identico comportamento API. Nessuna suite determina un vincitore universale.
Meno passaggi sequenziali riducono attesa e liberano calcolo, talvolta più importante di piccole differenze di prezzo nei prodotti interattivi. Ma un primo tentativo economico non conviene se una persona deve trovare errori, ripristinare lavoro danneggiato e ripartire. L’unità rilevante è un risultato accettato.
Le spese invariate possono dominare lo sconto
Nuovo input, output e scritture non rientrano in questa riduzione. Ragionamenti lunghi, spiegazioni prolisse e correzioni ripetute possono dominare il modello perché l’output costa molto più del contesto in cache.
L’orchestrazione include ricerca, browser, database, esecuzione del codice e API esterne con prezzi propri. La revisione umana pesa soprattutto in software, attività regolamentate e dati dei clienti. Una componente più bassa non riduce queste tariffe né elimina le conseguenze degli errori.
Anche il routing spreca risorse. Secondo Anthropic Opus 5.5 resta più forte su attività complesse aperte con giudizio sostenuto. Dare routine circoscritta a Sonnet e decisioni difficili a un modello maggiore può aiutare, ma ripetuti fallimenti prima dell’escalation possono superare il risparmio cache.
Il percorso completo include quindi tentativi falliti e chiamate di escalation, non solo l’ultima risposta riuscita. Un router economico per richiesta può essere caro per attività accettata.
La distribuzione impedisce una conclusione universale. Sonnet è disponibile attraverso Anthropic e partner, con prezzi, regioni e tempi delle funzionalità potenzialmente diversi. I 0,10 dollari devono comparire nell’endpoint produttivo effettivo; non si presume un aggiornamento contemporaneo di ogni servizio regionale marketplace.
Una cache economica non rende conveniente qualsiasi migrazione. Struttura, durata, idoneità e report specifici del fornitore possono richiedere modifiche prima di confrontare i tassi di hit. Qualità e portabilità restano nella scelta d’acquisto.
Da componente economica a lavoro completato economico
Prove utili collegano settimane di token letti, frequenza di creazione, input non memorizzato, output, strumenti, latenza, ritenti ed escalation a completamento e accettazione umana. Spesa del modello, servizi esterni e lavoro vanno distinti.
Un confronto rappresentativo richiede stessi compiti interni, contesto, strumenti, impostazioni, ritenti e criteri di accettazione. Dare capacità aggiuntive o budget più largo a un modello distorce il confronto economico. Valutazioni indipendenti dovrebbero esporre condizioni, non usare il prezzo del token come costo dell’attività.
I prossimi segnali sono fatture reali, adozione dei partner e risultati indipendenti per attività. Nuovi tagli potrebbero fare del riuso economico una base; nessuna risposta potrebbe indicare differenziazione per qualità, infrastruttura o design cache. Sono possibilità, non conseguenze già stabilite.
Anthropic ha ridotto una spesa ricorrente importante per agenti con prefissi lunghi e stabili. Il risparmio generale resta condizionale. Se la cache scende ma il costo per risultato accettato no, il caro potrebbe essere output, fallimenti ripetuti, strumenti esterni o correzione umana, non il contesto appena scontato.
Fonti e approfondimenti
Annuncio originale Claude; lancio Haiku e prezzo cache; lancio Sonnet 5.5; approfondimento sulle basi tecniche ricercabili; cache dei prompt Anthropic; documentazione GPT-6.1 Sol; lancio OpenAI; guida cache OpenAI.