
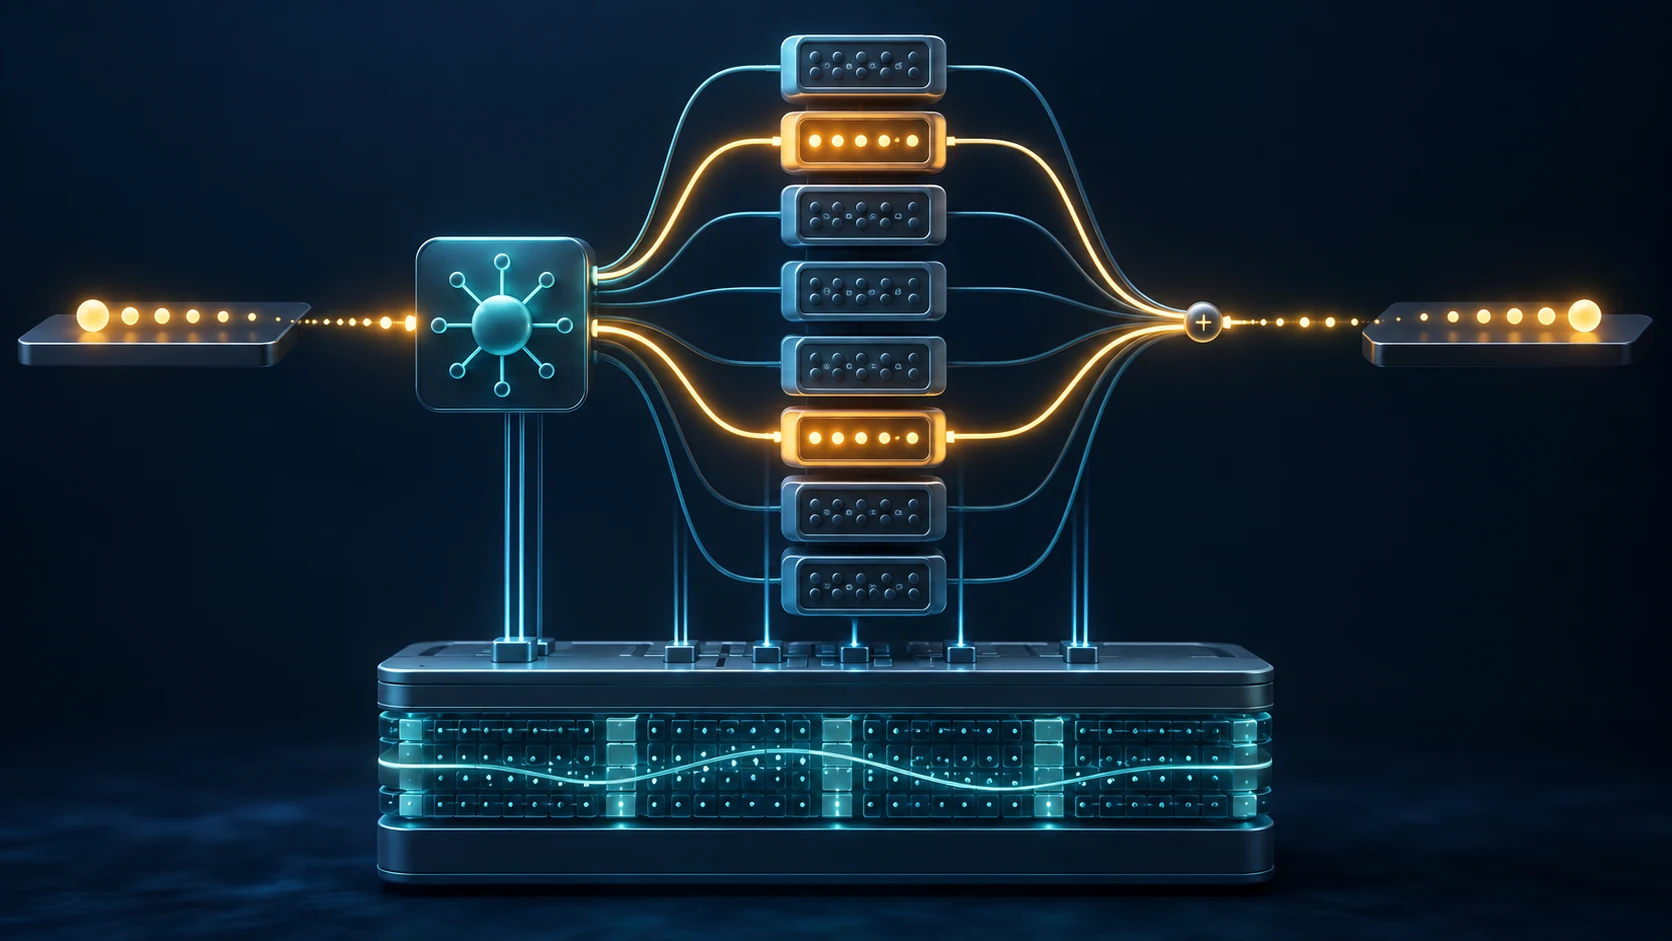
Ein Mixture-of-Experts-Modell (MoE) lässt einen Router für jedes Token nur einen Teil seiner Expertennetzwerke auswählen. In vielen Transformer-Architekturen ersetzen diese Experten bestimmte Feed-forward-Schichten, während Aufmerksamkeit und andere Komponenten gemeinsam genutzt werden. So kann die Gesamtzahl der Parameter wachsen, ohne dass für jedes Token sämtliche Experten berechnet werden. Die Gesamtgröße des Modells sagt jedoch allein weder die Laufzeit noch den Speicherbedarf aus.
Wie funktioniert das Routing? Der Router bewertet die Experten anhand der internen Darstellung eines Tokens, wählt wenige aus und kombiniert ihre Ergebnisse. Verschiedene Tokens können deshalb unterschiedliche Wege nehmen. Beim Training werden häufig Verfahren zur Lastverteilung eingesetzt, damit nicht fast alle Tokens bei denselben Experten landen. Aus dem Namen „Experte“ folgt keine nachgewiesene Spezialisierung auf Code oder natürliche Sprache; solche Rollen müssten für ein konkretes Modell untersucht werden.
Mixtral 8x7B als belegtes Beispiel. Nach Angaben von Mistral AI besitzt der Feed-forward-Teil acht Experten, von denen pro Token zwei ausgewählt werden. Das Modell hat rund 46,7 Milliarden Parameter insgesamt und nutzt ungefähr 12,9 Milliarden pro Token aktiv. Die Bezeichnung 8x7B bedeutet nicht, dass acht voneinander unabhängige vollständige 7B-Modelle laufen: Andere Schichten werden geteilt. Die veröffentlichten Benchmarkergebnisse beschreiben Mixtral unter den getesteten Bedingungen, nicht jedes MoE-Modell.
Rechenarbeit ist nicht Arbeitsspeicher. Nicht ausgewählte Experten führen für das betreffende Token keine Berechnung aus. Bei einer gewöhnlichen Bereitstellung müssen ihre Gewichte dennoch irgendwo gespeichert werden. Der Rechenaufwand pro Token kann daher einem kleineren Modell ähneln, während der Speicherbedarf eher von der gesamten Gewichtsmenge abhängt. Quantisierung, Auslagerung und verteilte Experten können diesen Bedarf verändern, bringen aber mögliche Nachteile bei Latenz und Betrieb mit sich. Spitzenverbrauch, Durchsatz und Antwortzeit sollten auf der vorgesehenen Hardware gemessen werden.
Worauf kommt es bei der Auswahl an? Vergleichen Sie die Qualität mit denselben Aufgaben, Eingaben und Kontextlängen. Erfassen Sie Gesamt- und aktive Parameter getrennt sowie die Kosten bei der geplanten Stapelgröße. Prüfen Sie, wie die Laufzeitumgebung Routing und Platzierung der Experten unterstützt; beim Fine-Tuning zählen auch die trainierten Schichten und die Lastverteilung. OpenAI hat nicht genügend Architekturdetails veröffentlicht, um GPT-4 als bestätigtes MoE einzuordnen. Mixtral und der Forschungsansatz Switch Transformer sind öffentlich dokumentierte Beispiele. MoE garantiert weder höhere Qualität noch geringere Kosten für jede Anwendung.
Quellen: Mistral AI, Mixtral-Papier, Hugging Face, Switch-Transformer-Papier, OpenAI-Bericht zu GPT-4.