
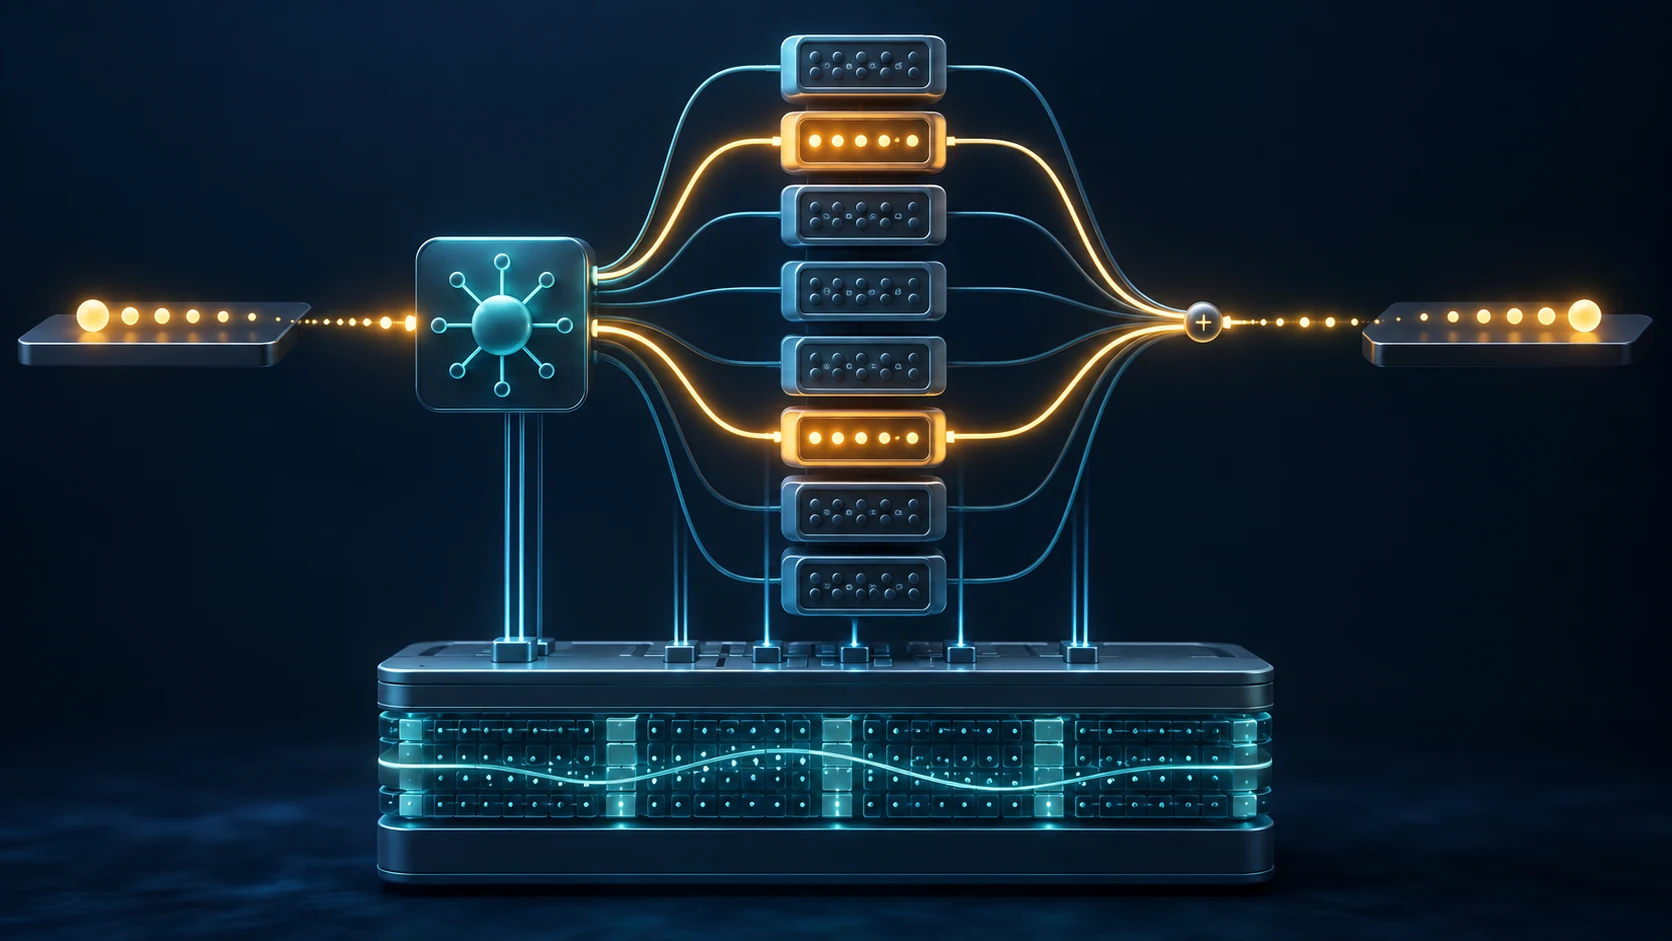
Un modelo Mixture of Experts (MoE), o mezcla de expertos, utiliza un enrutador para decidir qué subredes procesan cada token. En muchos Transformers, los expertos sustituyen algunas capas de propagación hacia delante, mientras que la atención y otros componentes se comparten. Esto permite aumentar los parámetros totales sin emplearlos todos en cada token. El tamaño del modelo, el cálculo activo y la memoria necesaria para servirlo son medidas distintas.
¿Cómo funciona el enrutamiento? El enrutador puntúa a los expertos según la representación interna del token, selecciona unos pocos y combina sus salidas. Distintos tokens pueden seguir rutas diferentes. Durante el entrenamiento se emplean mecanismos de equilibrio para evitar que casi todos los tokens acaben en los mismos expertos. La palabra «experto» no demuestra que una subred se encargue del código y otra del lenguaje natural; esa función debe comprobarse en cada modelo.
Mixtral 8x7B como ejemplo documentado. Mistral AI describe ocho expertos en los bloques de propagación hacia delante y selecciona dos por token. El modelo tiene unos 46.700 millones de parámetros totales, de los que aproximadamente 12.900 millones están activos por token. El nombre no significa que se ejecuten ocho modelos completos e independientes de 7.000 millones de parámetros: algunas capas son compartidas. Los resultados de los ensayos publicados para Mixtral no garantizan el mismo rendimiento en todos los MoE.
Menos cálculo no equivale a menos memoria. Los expertos no elegidos no realizan operaciones para ese token, pero una instalación convencional debe conservar sus pesos en algún lugar. El cálculo por token puede parecerse al de un modelo menor, mientras que la memoria depende más del conjunto de pesos. La cuantización, la descarga de pesos y la distribución de expertos entre dispositivos pueden modificar los requisitos, con posibles costes de latencia y mantenimiento. Conviene medir memoria máxima, rendimiento, tiempo de respuesta y coste en el equipo previsto.
¿Cómo elegir? Compare la calidad con las mismas tareas, entradas y longitudes de contexto. Anote por separado los parámetros totales y activos y pruebe el servicio con el tamaño de lote previsto. Compruebe cómo la infraestructura gestiona el enrutamiento y la ubicación de los expertos; para el ajuste fino, revise qué capas se entrenan y si la carga se reparte. OpenAI no ha publicado detalles arquitectónicos suficientes para confirmar que GPT-4 sea un MoE. Mixtral y el Switch Transformer de investigación sí cuentan con descripciones públicas. MoE ofrece una forma de repartir el cálculo, pero no garantiza mejor calidad ni menor coste en todos los casos.
Fuentes: Mistral AI, artículo Mixtral, Hugging Face, artículo Switch Transformer, informe técnico GPT-4.