
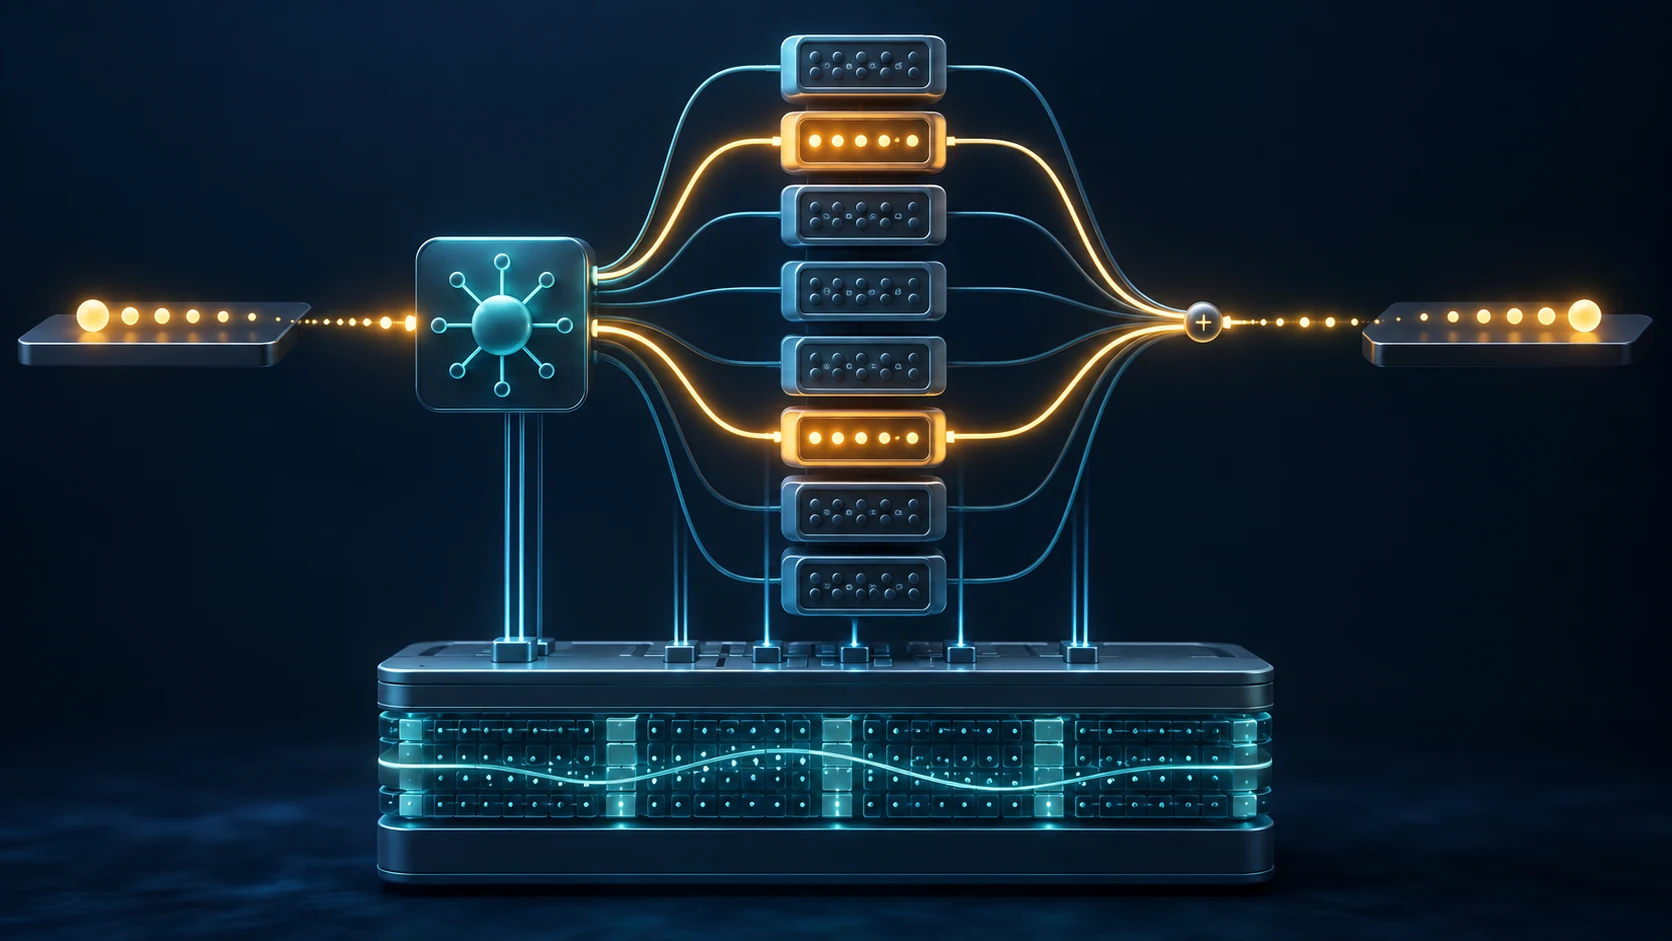
Mixture of Experts(MoE)は、各トークンを処理する少数の「専門家」ネットワークをルーターが選ぶ構成です。一般的なTransformerのMoEでは、一部のフィードフォワード層を複数の専門家に置き換え、注意機構などは共有します。モデル全体のパラメータを増やしても、各トークンでそのすべてを計算する必要はありません。ただし、総パラメータ数、実際に計算に使う量、必要なメモリは別の指標です。
ルーティングの仕組み。 ルーターが入力の内部表現から専門家を評価し、少数を選んで出力を統合します。トークンによって選択先は変わります。学習時には、一部の専門家だけに入力が集中しないよう負荷を調整することがあります。「専門家」という名前から、あるネットワークが必ずコード担当、別のネットワークが自然言語担当だと推測することはできません。
Mixtral 8x7Bの例。 Mistral AIが公開した構成では、フィードフォワード部分に八つの専門家があり、トークンごとに二つを選びます。総パラメータは約467億、トークンごとに使うパラメータは約129億です。「8x7B」は、独立した70億パラメータのモデルを八つ丸ごと動かすという意味ではありません。注意機構など共有される部分があります。Mixtralのベンチマーク結果を、あらゆるMoEの性能保証として扱うべきではありません。
計算量とメモリの違い。 選ばれなかった専門家はそのトークンの計算には参加しませんが、通常の完全な配置では全専門家の重みをどこかに保持する必要があります。そのため、トークンあたりの計算量が小さくても、必要なメモリは総パラメータ数に近い規模になり得ます。量子化、オフロード、専門家の分散配置で条件は変わりますが、遅延や運用の負担も変化します。目的の機器で最大メモリ、処理量、応答時間を測定してください。
導入前の確認。 同じタスク、入力、コンテキスト長で品質を比較し、総パラメータと有効パラメータを分けて記録します。サービング環境がルーティングと専門家の配置をどう扱うか、微調整時にルーターと専門家層をどう学習するかも確認します。OpenAIはGPT-4の構造を確証できる詳細を公開していないため、GPT-4を確認済みのMoE例とは呼べません。公開資料で構造を確認できる例にはMixtralと研究モデルのSwitch Transformerがあります。
出典:Mistral AI、Mixtral論文、Hugging Face、Switch Transformer論文、OpenAIのGPT-4技術報告。