
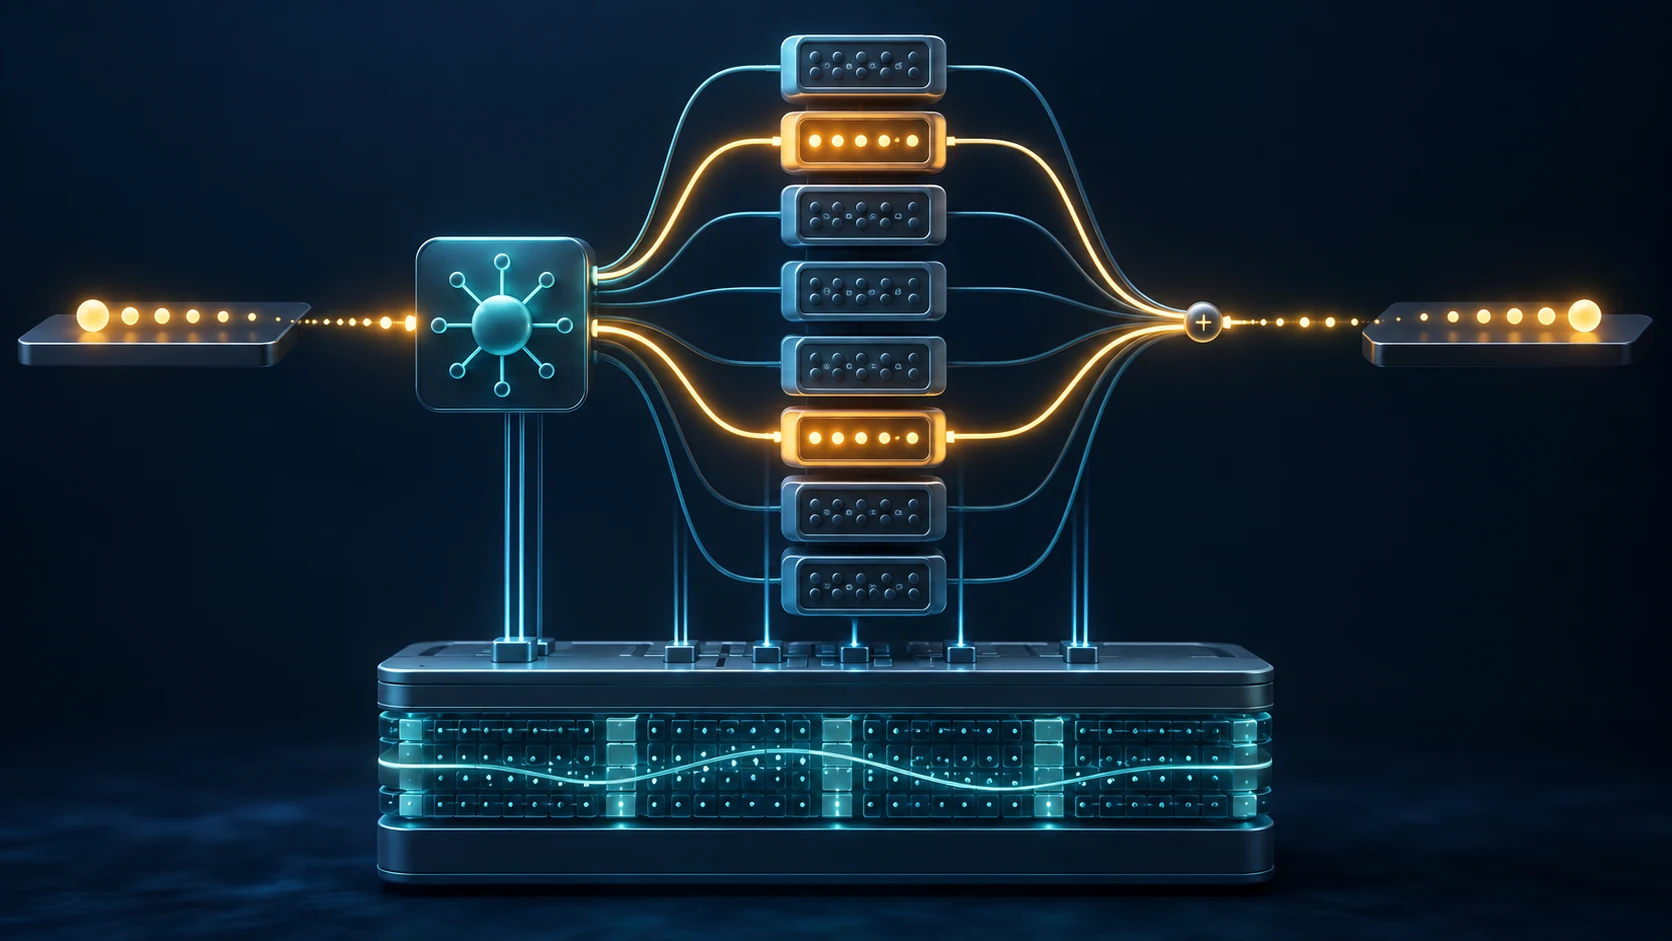
混合专家模型(MoE)让路由器为每个 token 选择少数专家网络。在常见的 Transformer 实现中,专家替换部分前馈层,注意力等组件仍由各条路径共享。这样可以增加模型的总参数量,而不必在每个 token 上运行全部专家;但总参数量、计算量和部署所需内存是三个不同指标。
路由怎样工作? 路由器根据 token 的隐藏状态给专家打分,选出少数专家并合并输出。不同 token 可能走不同路径。训练时通常需要负载均衡机制,避免大多数 token 都集中到少数专家。这里的“专家”是学得的子网络,不能未经验证就给它贴上“代码专家”或“自然语言专家”的固定标签。
Mixtral 8x7B 的实证数据。 Mistral AI 公布的结构是每层八位专家、每个 token 选两位;总参数约 467 亿,每个 token 活跃参数约 129 亿。“8x7B”不表示八个完整的 70 亿参数模型独立运行,部分结构是共享的。它的评测结果适用于所测模型和基准,不应推广为所有 MoE 的性能承诺。
省计算不等于省显存。 未选中的专家不参与该 token 的矩阵计算,但完整部署仍要在某处保存所有权重。常规部署的内存需求可能更接近总参数规模,而每个 token 的计算量更接近活跃参数规模。量化、权重卸载和专家并行可以改变硬件需求,也可能带来延迟和运维成本。应在目标设备上实测峰值内存、吞吐、延迟与费用。
如何选型? 使用同一任务、提示和上下文长度比较模型质量,并分别记录总参数、活跃参数及实际服务成本。微调前确认训练框架如何处理路由器与专家层,观察专家负载是否失衡。OpenAI 没有公开足以确认 GPT-4 具体架构的资料,因此不能把它列为已证实的 MoE 案例;Mixtral 和研究论文中的 Switch Transformer 才有公开结构可核对。MoE 是一种计算权衡,不保证在每个任务上更准确或更便宜。
来源:Mistral AI 发布说明、Mixtral 论文、Hugging Face 部署说明、Switch Transformer 论文、OpenAI GPT-4 技术报告。