
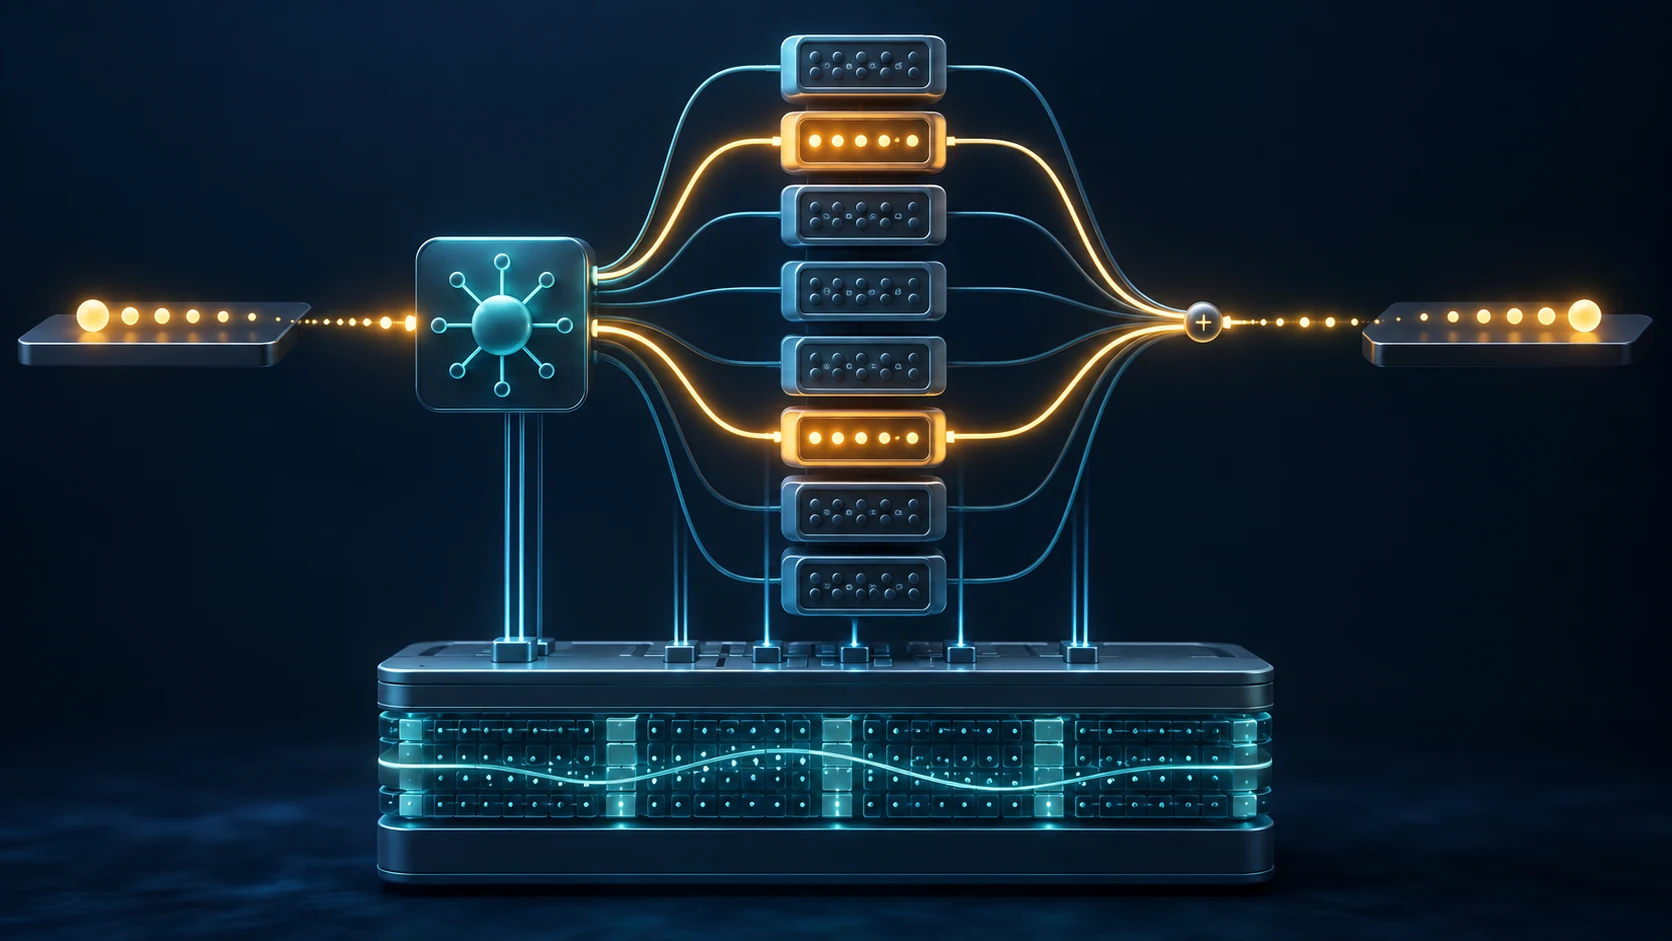
Mixture of Experts (MoE), czyli mieszanina ekspertów, to sposób budowania sieci, w którym router wybiera część podsieci do przetworzenia danego tokenu. W wielu transformatorach eksperci zastępują wybrane warstwy feed-forward, podczas gdy mechanizm uwagi i pozostałe elementy są wspólne. Dzięki temu można zwiększyć całkowitą liczbę parametrów bez wykonywania wszystkich obliczeń dla każdego tokenu. Większy model nie oznacza jednak automatycznie szybszego ani tańszego wdrożenia.
Jak działa routing? Router ocenia dostępnych ekspertów, wybiera niewielką grupę i łączy ich wyniki. Różne tokeny mogą przechodzić przez różne ścieżki. Podczas uczenia potrzebne bywają mechanizmy równoważące obciążenie, aby większość tokenów nie trafiała stale do tych samych ekspertów. Nazwa „ekspert” nie oznacza, że dana podsieć ma prostą etykietę, na przykład „kod” albo „język naturalny”; takich ról nie należy zakładać bez badań konkretnego modelu.
Przykład Mixtral 8x7B. Według Mistral AI warstwa feed-forward tego modelu ma ośmiu ekspertów, a dla każdego tokenu router wybiera dwóch. Model ma około 46,7 mld parametrów łącznie, z czego około 12,9 mld jest aktywnych na token. Nazwa 8x7B nie oznacza ośmiu niezależnych modeli 7B: część parametrów jest wspólna. Wyników Mixtrala w opublikowanych testach nie należy przenosić na każdy model MoE.
Obliczenia a pamięć. Nieaktywni eksperci nie wykonują swoich obliczeń dla danego tokenu, lecz ich wagi zwykle nadal trzeba gdzieś przechowywać. Zwykłe uruchomienie pełnego modelu może więc potrzebować pamięci odpowiadającej całkowitej liczbie parametrów, choć liczba operacji na token przypomina mniejszy model. Kwantyzacja, przenoszenie wag między pamięcią a urządzeniem i rozdzielanie ekspertów między akceleratory zmieniają wymagania, lecz mogą zwiększyć opóźnienie lub złożoność obsługi. Przed wdrożeniem trzeba zmierzyć szczytowe zużycie pamięci, przepustowość i opóźnienie na docelowym sprzęcie.
Jak ocenić model? Porównaj jakość na tych samych zadaniach, danych wejściowych i długościach kontekstu. Zapisz osobno liczbę parametrów całkowitych i aktywnych oraz koszt serwowania przy oczekiwanej wielkości partii. Sprawdź, czy używany stos obsługuje routing i rozmieszczenie ekspertów; przy dostrajaniu zweryfikuj, które warstwy są trenowane i jak kontroluje się równowagę obciążenia.
Czy GPT-4 jest potwierdzonym przykładem MoE? Nie. OpenAI nie opublikowało wystarczających szczegółów architektury GPT-4, aby to potwierdzić. Udokumentowanymi przykładami są Mixtral oraz badawczy Switch Transformer. MoE może ograniczyć część obliczeń na token, ale nie gwarantuje lepszej jakości ani mniejszego kosztu w każdym zastosowaniu.
Źródła: Mistral AI, artykuł Mixtral, Hugging Face, artykuł Switch Transformer, raport OpenAI GPT-4.