
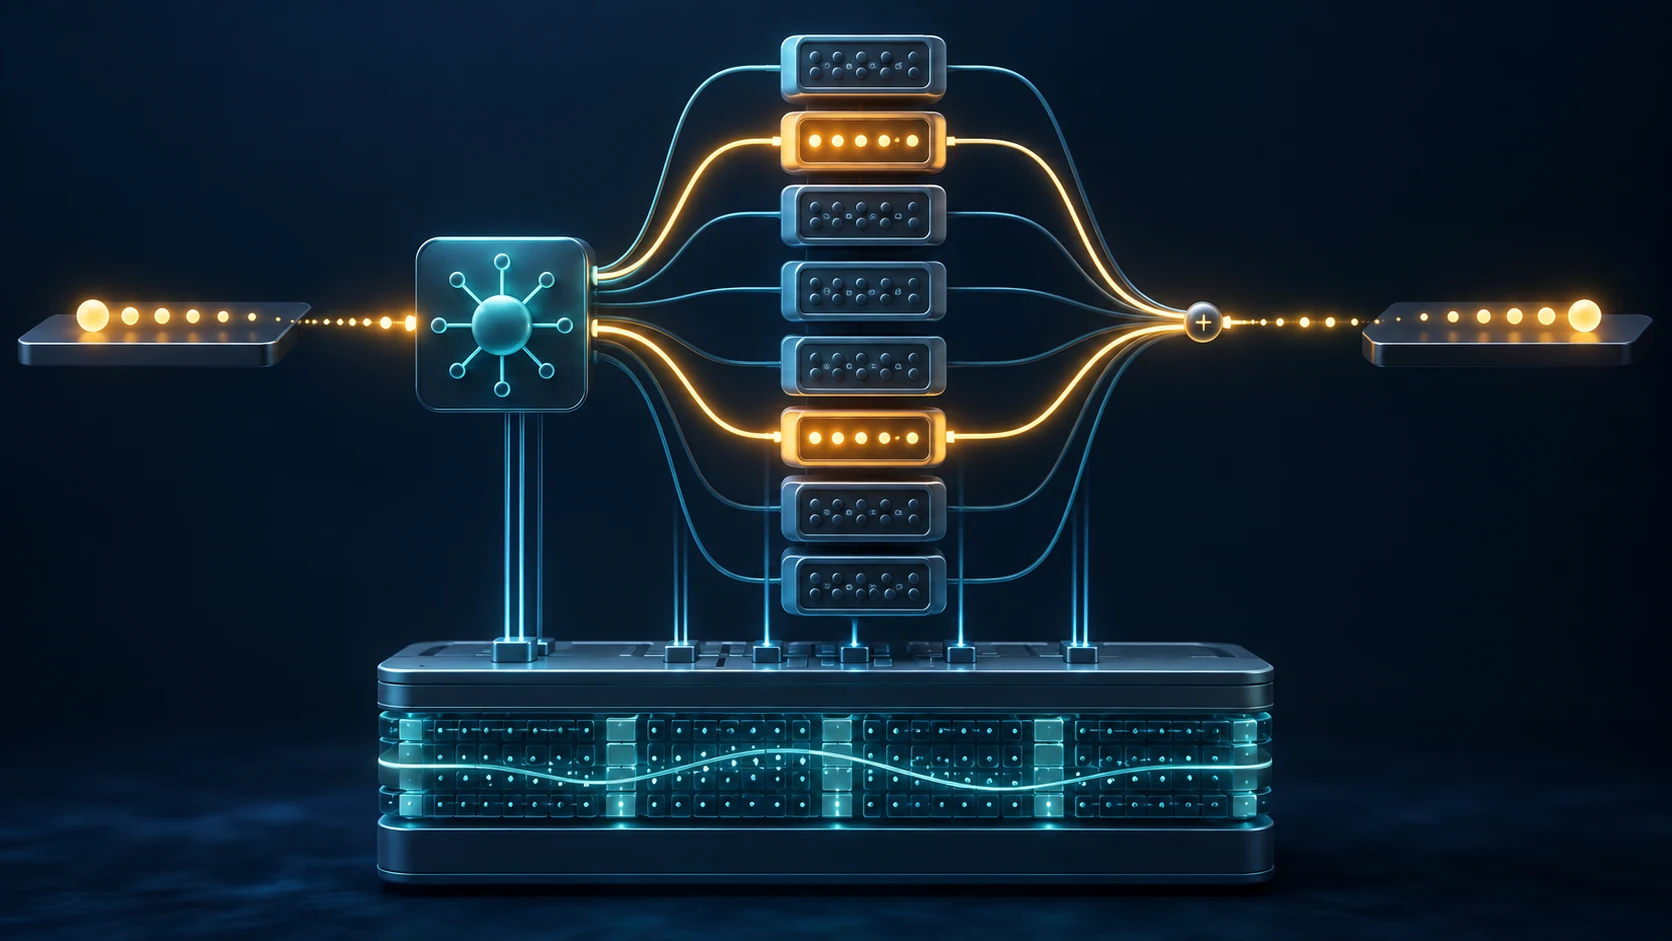
혼합 전문가 모델(MoE)은 라우터가 토큰마다 일부 전문가 네트워크를 골라 처리하게 하는 구조입니다. 일반적인 Transformer 구현에서는 여러 전문가가 일부 피드포워드 층을 대신하고, 어텐션 등 다른 구성 요소는 공유합니다. 전체 파라미터를 늘리면서도 토큰마다 모든 전문가를 계산하지 않을 수 있습니다. 그러나 전체 파라미터 수, 실제 계산에 쓰인 파라미터 수, 모델을 저장할 메모리 요구량은 서로 다른 수치입니다.
라우팅 방식. 라우터는 입력의 내부 표현을 바탕으로 전문가를 평가하고 소수의 출력을 합칩니다. 토큰에 따라 선택되는 경로가 달라질 수 있습니다. 학습 중 특정 전문가에 입력이 과도하게 몰리지 않도록 부하 균형 기법을 쓰기도 합니다. 이름이 '전문가'라고 해서 어떤 네트워크는 코드, 다른 네트워크는 일반 언어만 담당한다고 단정할 수는 없습니다.
Mixtral 8x7B의 예. Mistral AI가 공개한 구조에는 피드포워드 부분에 전문가 여덟 개가 있고, 토큰마다 두 개를 선택합니다. 전체 파라미터는 약 467억 개, 토큰당 활성 파라미터는 약 129억 개입니다. 이름이 독립적인 70억 파라미터 모델 여덟 개를 통째로 실행한다는 뜻은 아닙니다. 공유되는 층도 있습니다. Mixtral의 공개 벤치마크 결과를 모든 MoE 모델의 성능으로 일반화해서는 안 됩니다.
연산과 메모리는 다릅니다. 선택되지 않은 전문가는 해당 토큰의 계산을 수행하지 않지만, 일반적인 전체 모델 배포에서는 모든 가중치를 어딘가에 보관해야 합니다. 따라서 토큰당 연산량이 작아도 필요한 메모리는 전체 파라미터 규모에 가까울 수 있습니다. 양자화, 가중치 오프로딩, 전문가 병렬화는 하드웨어 요구량을 바꿀 수 있지만 지연 시간과 운영 복잡성도 바꿉니다. 실제 장비에서 최대 메모리, 처리량, 지연 시간과 비용을 측정해야 합니다.
선택 전에 확인할 점. 같은 작업과 입력, 문맥 길이에서 품질을 비교하고 전체·활성 파라미터를 별도로 기록합니다. 서비스 환경이 라우팅과 전문가 배치를 어떻게 처리하는지, 미세 조정 시 어떤 층을 학습하는지도 살펴봅니다. OpenAI는 GPT-4의 구조를 확인할 충분한 세부 정보를 공개하지 않았으므로 이를 확인된 MoE 사례로 소개할 수 없습니다. Mixtral과 연구 모델 Switch Transformer는 구조가 공개된 사례입니다.
출처: Mistral AI, Mixtral 논문, Hugging Face, Switch Transformer 논문, OpenAI GPT-4 기술 보고서.