
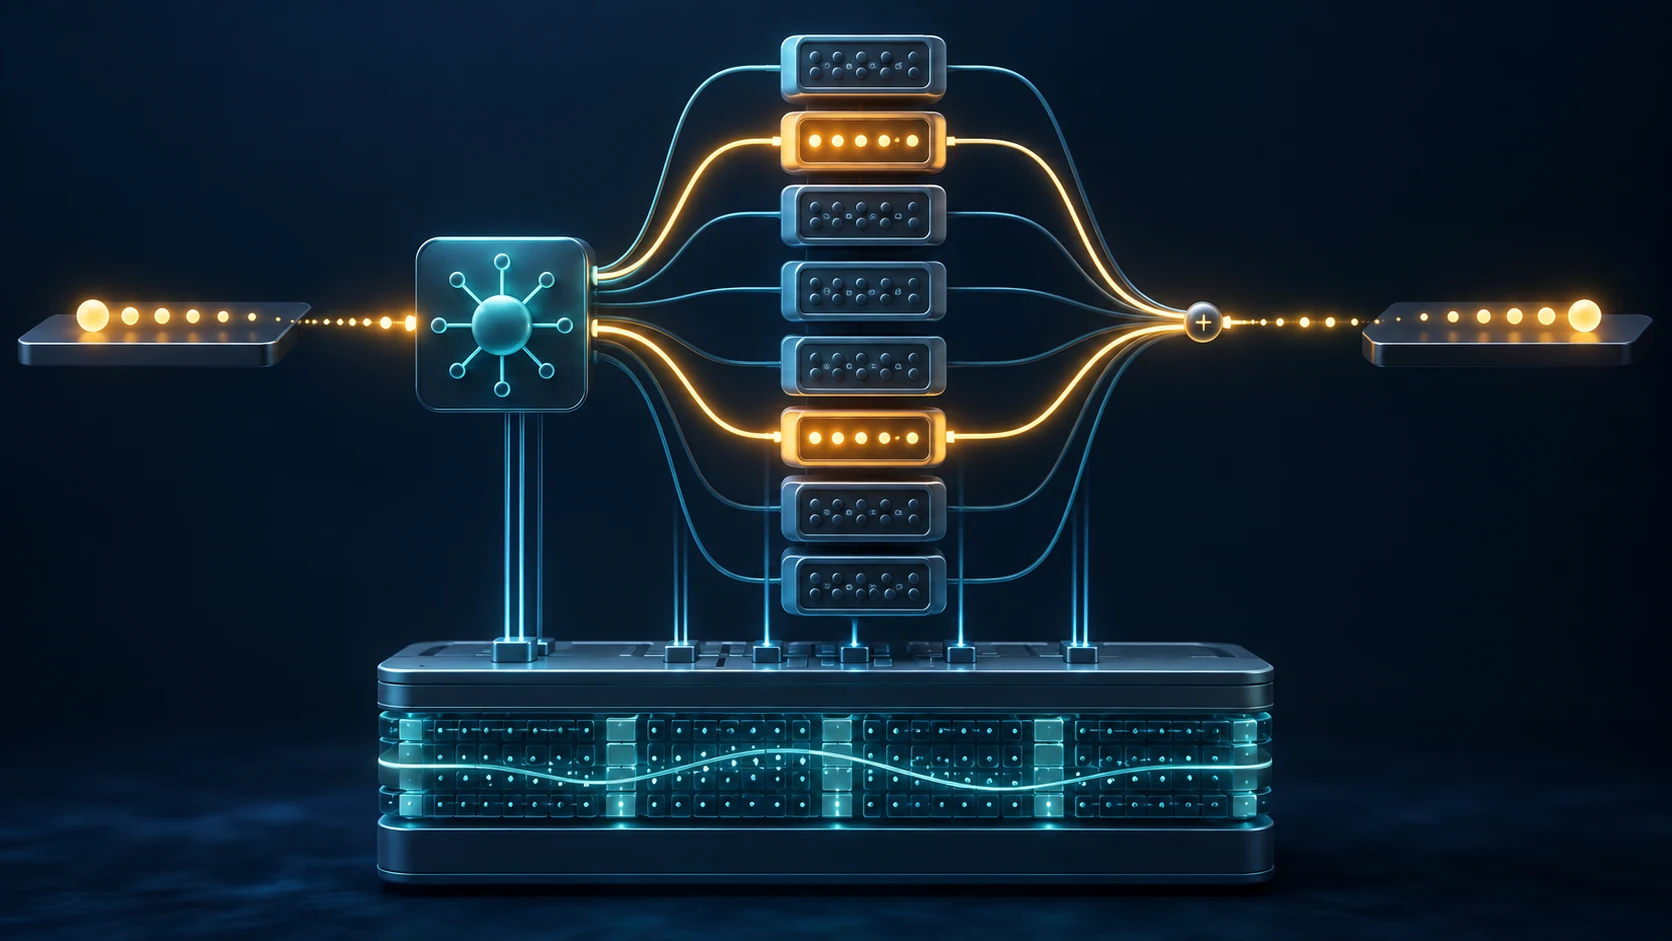
Un modello Mixture of Experts (MoE) usa un router per scegliere quali reti esperte elaborano ogni token. In molte architetture Transformer gli esperti sostituiscono alcuni livelli feed-forward, mentre l'attenzione e altri componenti restano condivisi. Si può così aumentare il numero totale di parametri senza impiegarli tutti per ogni token. Tuttavia dimensione del modello, lavoro computazionale attivo e memoria necessaria sono misure diverse.
Come funziona il routing? Il router valuta gli esperti in base alla rappresentazione interna del token, ne seleziona un piccolo gruppo e combina i risultati. Token diversi possono percorrere strade diverse. Durante l'addestramento si usano spesso meccanismi di bilanciamento per evitare che quasi tutti i token finiscano sempre sugli stessi esperti. Il nome “esperto” non dimostra che una rete si occupi di codice e un'altra di linguaggio naturale: una simile specializzazione va verificata nel modello specifico.
Mixtral 8x7B come esempio documentato. Mistral AI descrive otto esperti nei blocchi feed-forward e ne seleziona due per token. Il modello contiene circa 46,7 miliardi di parametri totali e ne attiva circa 12,9 miliardi per token. Il nome non indica otto modelli completi da 7 miliardi di parametri indipendenti: alcuni componenti sono condivisi. I risultati dei benchmark pubblicati per Mixtral non garantiscono le stesse prestazioni per ogni MoE.
Calcolo e memoria non coincidono. Gli esperti non selezionati non eseguono il calcolo per quel token, ma in una distribuzione ordinaria i loro pesi devono comunque essere conservati. Il costo computazionale per token può somigliare a quello di un modello più piccolo, mentre la memoria può riflettere la quantità totale dei pesi. Quantizzazione, offloading e distribuzione degli esperti tra dispositivi possono modificare il fabbisogno, introducendo possibili compromessi di latenza e gestione. Occorre misurare memoria di picco, throughput, tempo di risposta e costo sull'hardware previsto.
Come valutare una scelta? Confronta la qualità sulle stesse attività, istruzioni e lunghezze di contesto. Registra separatamente parametri totali e attivi, poi prova il servizio con la dimensione di batch prevista. Verifica come l'infrastruttura gestisce routing e collocazione degli esperti; nel fine-tuning controlla quali livelli vengono aggiornati e se il carico resta bilanciato. OpenAI non ha pubblicato dettagli sufficienti per confermare che GPT-4 sia un MoE. Mixtral e lo Switch Transformer di ricerca sono esempi con struttura documentata. MoE non garantisce qualità superiore o costi inferiori in ogni applicazione.
Fonti: Mistral AI, paper Mixtral, Hugging Face, paper Switch Transformer, rapporto tecnico GPT-4.