
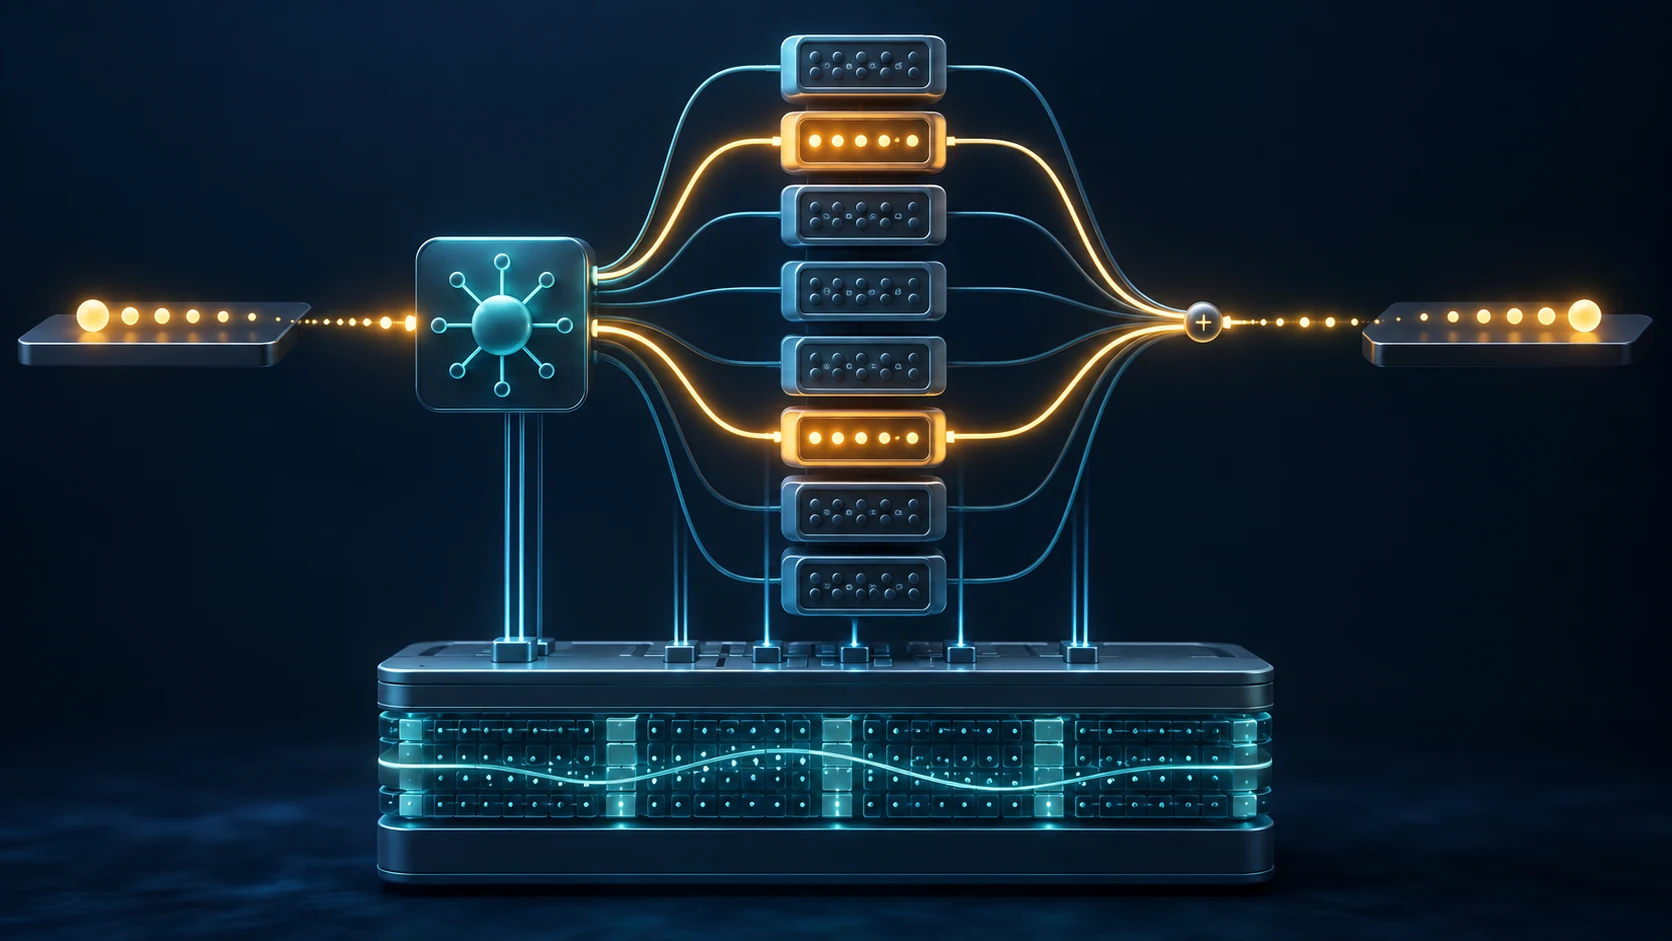
Un modèle Mixture of Experts (MoE), ou mélange d'experts, utilise un routeur pour choisir les sous-réseaux qui traiteront chaque token. Dans de nombreux Transformers, ces experts remplacent certaines couches feed-forward, tandis que l'attention et d'autres composants restent partagés. On peut ainsi augmenter le nombre total de paramètres sans calculer tous les experts pour chaque token. La taille totale, le calcul actif et la mémoire nécessaire au déploiement restent toutefois trois mesures différentes.
Comment fonctionne le routage ? Le routeur attribue un score aux experts à partir de la représentation interne du token, en sélectionne quelques-uns et combine leurs sorties. Des tokens différents peuvent suivre des chemins différents. Pendant l'entraînement, des mécanismes d'équilibrage évitent qu'une poignée d'experts reçoive presque tout le trafic. Le mot « expert » ne prouve pas qu'un sous-réseau soit chargé du code et un autre de la langue courante : une telle spécialisation doit être vérifiée sur le modèle concerné.
L'exemple documenté de Mixtral 8x7B. Mistral AI décrit huit experts dans la partie feed-forward et une sélection de deux experts par token. Le modèle compte environ 46,7 milliards de paramètres au total, dont 12,9 milliards actifs par token. Son nom ne signifie pas que huit modèles complets de 7 milliards de paramètres fonctionnent indépendamment : plusieurs composants sont communs. Les résultats publiés pour Mixtral et ses tests ne constituent pas une promesse de performance pour tous les MoE.
Moins de calcul ne signifie pas moins de mémoire. Les experts non sélectionnés ne calculent pas la sortie du token, mais un déploiement classique doit toujours conserver leurs poids quelque part. Le coût de calcul par token peut donc ressembler à celui d'un plus petit modèle, alors que la mémoire suit davantage la quantité totale de poids. La quantification, le déchargement des poids et le parallélisme des experts peuvent modifier ce besoin, avec des compromis de latence et de complexité. Il faut mesurer la mémoire maximale, le débit, le temps de réponse et le coût sur le matériel visé.
Comment choisir ? Comparez la qualité sur les mêmes tâches, entrées et longueurs de contexte. Notez séparément les paramètres totaux et actifs, puis testez le système avec la taille de lot prévue. Vérifiez la prise en charge du routage et du placement des experts; pour l'adaptation, examinez les couches entraînées et la répartition de la charge. OpenAI n'a pas publié assez de détails d'architecture pour confirmer que GPT-4 est un MoE. Mixtral et le Switch Transformer de recherche sont des exemples décrits publiquement. Cette architecture offre un compromis de calcul, pas une garantie de meilleure qualité ou de coût réduit dans tous les cas.
Sources : Mistral AI, article Mixtral, Hugging Face, article Switch Transformer, rapport technique GPT-4.