
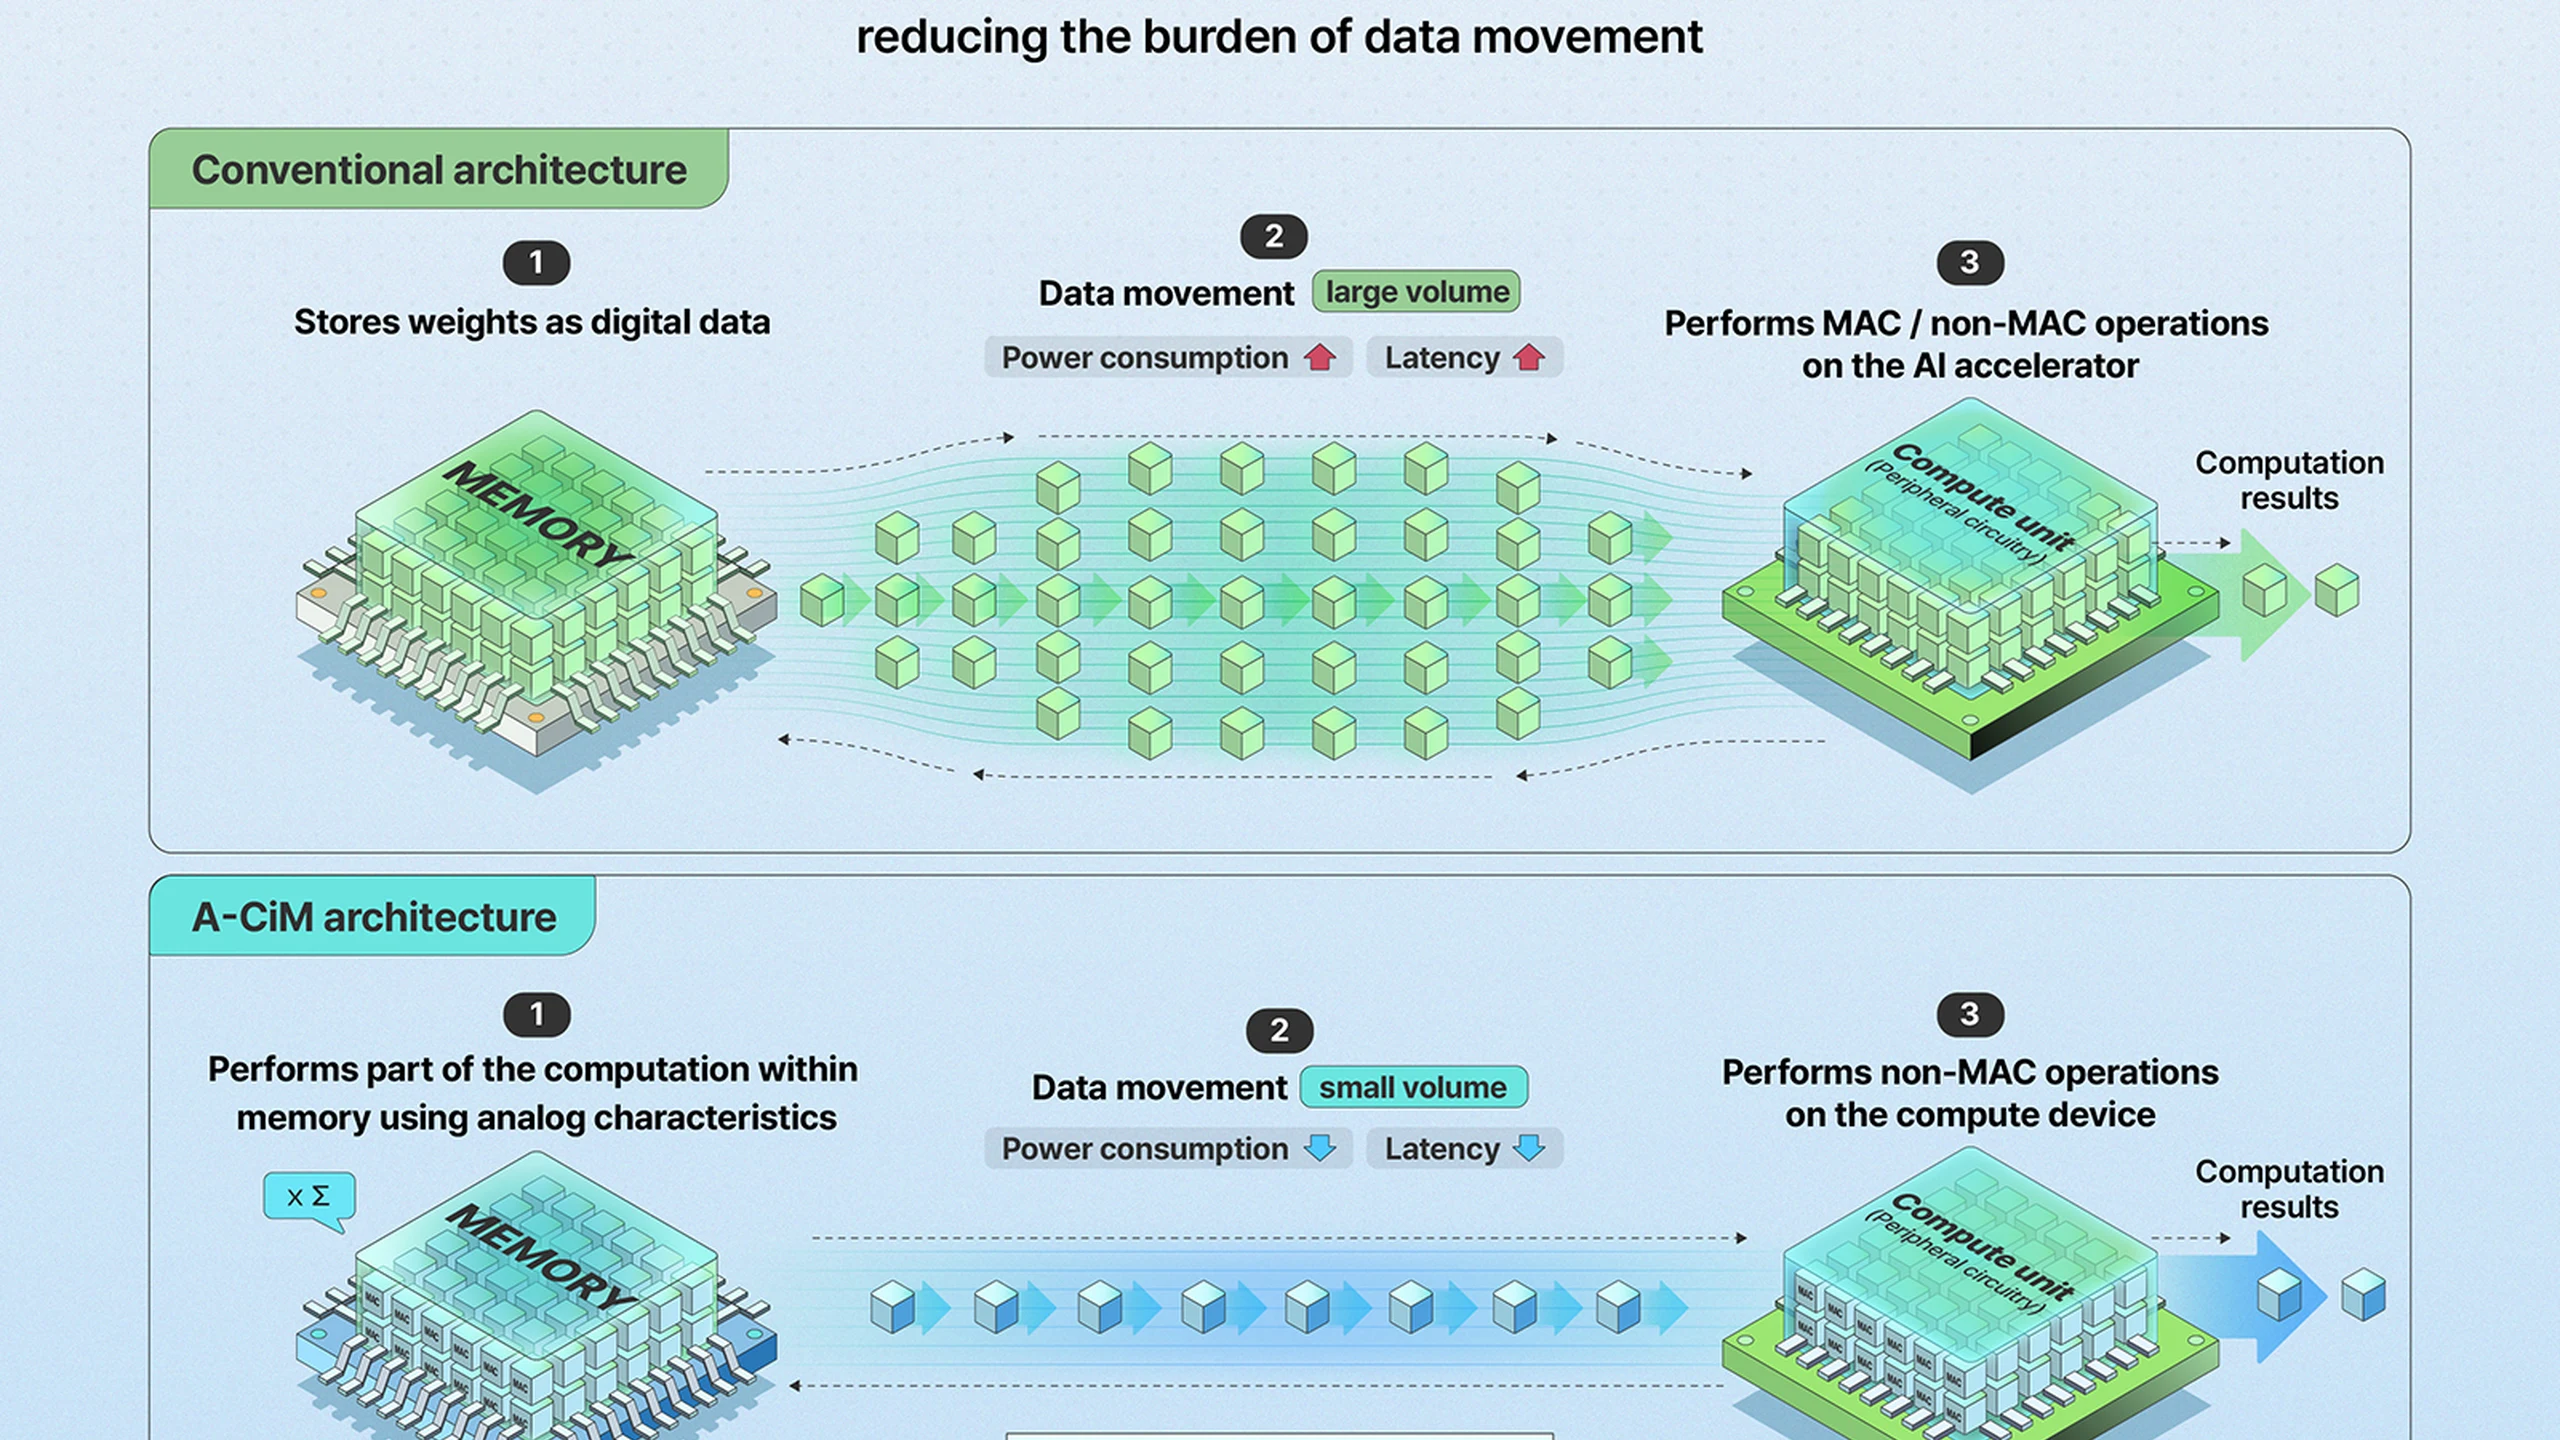
SK hynix intenta cambiar dónde se realiza la aritmética de IA, no solo cuántos datos caben en NAND. Su última explicación pública de 3D FeNAND propone conservar los pesos del modelo en memoria apilada verticalmente y ejecutar allí determinadas operaciones de multiplicación y acumulación. El ahorro potencial procede de evitar transferencias repetidas a un procesador separado.
La explicación del 14 de octubre de 2026 desarrolla una investigación presentada en IEDM en diciembre de 2025. Comunica mejoras llamativas, pero no anuncia chip comercial, fecha de producción ni programa de homologación de clientes. El avance es coordinar celdas, controles auxiliares y distribución del trabajo, no afirmar que un SSD corriente sustituye a una GPU.
Dos comparaciones no forman una promesa única
La explicación de la empresa informa de hasta 16 veces más rendimiento y 4.950 veces más eficiencia energética frente a determinadas matrices bidimensionales convencionales, con la carga evaluada y una superficie de chip limitada. Son comparaciones arquitectónicas, no multiplicadores universales para un servidor de IA completo.
Un resumen técnico utiliza otra referencia: el diseño 3D FeNAND anterior. Frente a él, la optimización conjunta entrega 20,4 veces más TOPS y 7,17 veces más TOPS por vatio. TOPS mide billones de operaciones por segundo; TOPS/W expresa eficiencia energética. No se pueden combinar ni intercambiar ambas bases.
La densidad ayuda a explicar por qué la mejora energética frente a una matriz plana puede superar mucho al aumento de rendimiento. Al conservar más pesos localmente disminuyen recargas, reescrituras y esperas alrededor del cálculo. Pero el ahorro depende del modelo y su distribución: no demuestra una reducción de 4.950 veces en la factura eléctrica de un sistema en producción.
Tres cambios conectados convierten densidad en cálculo
FeNAND utiliza polarización ferroeléctrica que permanece al retirar el campo eléctrico. Ese estado controla la corriente de la celda y representa varios niveles de pesos no volátiles. La NAND 3D comercial suele usar nitruro de captura de carga, reteniendo electrones en una capa aislante. El almacenamiento digital denso y el control preciso de corriente analógica exigen soluciones diferentes.
Una cadena vertical larga introduce resistencia. La corriente produce una caída IR, una pérdida de tensión que puede comprimir la separación entre estados analógicos. Cuanto más próximos estén, más difícil será distinguirlos. Apilar más celdas no garantiza por sí mismo más cálculo correcto.
En las celdas, SK hynix aplica modulación del número de pulsos: una secuencia controlada de programación ajusta los estados con corrientes bajas y teniendo en cuenta la caída IR. Es un método de programación multinivel, no simplemente un transistor más rápido. Mejora el intervalo de corriente utilizable del que dependen los pesos analógicos.
El segundo cambio aborda costes externos a la celda. Las líneas de palabra seleccionan y controlan celdas; variar repetidamente su tensión consume energía y tiempo. La activación de dos líneas reduce esas transiciones. Incluir los controles en el diseño evita rodear una celda eficiente de una conmutación costosa.
El tercero reorganiza páginas. La segmentación de procesamiento dentro de la página sitúa varias capas neuronales y copias de determinadas operaciones en una misma página, reduciendo operaciones de propagación y cambios de líneas de palabra. La división de páginas compara una organización de 16 KB con otra de 4 KB para ajustarse a la carga. Una página demasiado grande activa circuitos inútiles; una demasiado pequeña puede exigir más operaciones.
Por ello, el artículo recogido en el programa de IEDM conecta celda, elementos externos y página. La capacidad vertical solo aporta valor si programación, conmutación y distribución permiten aprovecharla con trabajo útil.
La barrera de memoria no desaparece para todo
La literatura sobre cálculo en memoria identifica el movimiento de datos como un coste importante en tiempo y energía. Las matrices analógicas utilizan corrientes físicas para multiplicar entradas por pesos almacenados y sumar resultados en paralelo. Mantener muchos pesos cerca puede reducir tráfico entre almacenamiento, DRAM, cachés y acelerador.
La inferencia con pesos estables encaja como primer destino plausible. El entrenamiento exige actualizaciones frecuentes, precisión y ejecución flexible, más difíciles de acomodar. HBM y GPU no quedan obsoletas: HBM puede atender activaciones cambiantes y tráfico general, mientras una capa FeNAND densa realiza operaciones adecuadas con pesos fijos.
Las alternativas tienen otros compromisos. SRAM es rápida y compatible con procesos lógicos, pero volátil y ocupa bastante superficie. Las matrices cruzadas RRAM ofrecen resistencia programable, aunque afrontan variabilidad, desgaste y costes de conversión. Las memorias magnéticas y de cambio de fase también equilibran densidad, velocidad y fiabilidad; la lógica digital cercana a memoria ofrece precisión más predecible, quizá con menores ganancias energéticas.
En IEDM 2025, Macronix describió cálculo en almacenamiento NAND 3D de modo mixto para LLM, usando Qwen 2.5 Math 7B y MATH500 para evaluar errores. Es investigación vecina, no una comparación directa que valide a SK hynix. Asimismo, el anterior resumen de IEEE sobre FeNAND registró al menos 256 niveles de conductancia y un 87,8% de precisión en su tarea evaluada; no mide un modelo lingüístico actual ni esta nueva arquitectura.
Precisión y periféricos determinan la ventaja real
El paralelismo analógico intercambia parte de la certeza digital por eficiencia física. Ruido, variaciones de fabricación, efectos de circuito y errores de conversión alteran los resultados, según la revisión sobre precisión analógica. Corregirlos puede elevar la precisión consumiendo la superficie, tiempo o energía que se quería ahorrar.
FeNAND también debe controlar resistencia de cadenas verticales, interacciones entre celdas y variaciones de umbral de conmutación. Retención ferroeléctrica, resistencia a programaciones repetidas, deriva y sensibilidad térmica tienen que mantenerse aceptables en matrices grandes. Más niveles de pesos estrechan el margen entre estados y agravan estas exigencias.
Un acelerador utilizable debe contabilizar convertidores analógico-digitales, entrega de entradas, acumulación de resultados parciales, planificación y comunicación con el procesador anfitrión. Refrigeración y alimentación añaden costes. Sin límites comparables, los TOPS/W de una matriz y la medida de un sistema GPU completo responden preguntas distintas.
El software es igual de importante. Los compiladores deben distribuir operaciones según páginas, precisión y niveles de corriente disponibles; la calibración debe mantener una exactitud útil. La atención, dispersión o cuantización pueden cambiar más rápido que los procesos de fabricación. El diseño necesita programabilidad para seguir siendo útil cuando cambie la carga original.
Qué convertiría el resultado en un argumento de producto
La siguiente prueba convincente sería un chip fabricado con la optimización conjunta, que informe de precisión junto con rendimiento y energía e incluya convertidores y lógica periférica. Medidas a distintas temperaturas y en varios chips mostrarían si el resultado supera condiciones favorables. Las pruebas con modelos actuales deben revelar tamaño, precisión, actualizaciones, distribución por páginas y frecuencia de recarga.
Después harán falta pruebas de integración del material ferroeléctrico, rendimiento de fabricación, retención y durabilidad, además de herramientas y un socio de aceleradores o plataforma de evaluación. Ningún multiplicador energético sustituye esos hitos. Hoy se trata de un avance de investigación hacia inferencia especializada, no de una especificación de compra.
Para seguir el sector, guardar artículos y definiciones de pruebas en una base de conocimiento de documentación técnica ayuda a no mezclar comparaciones. La cuestión decisiva es si la densidad sigue ahorrando energía al medir juntos precisión, software y todo el hardware auxiliar.