
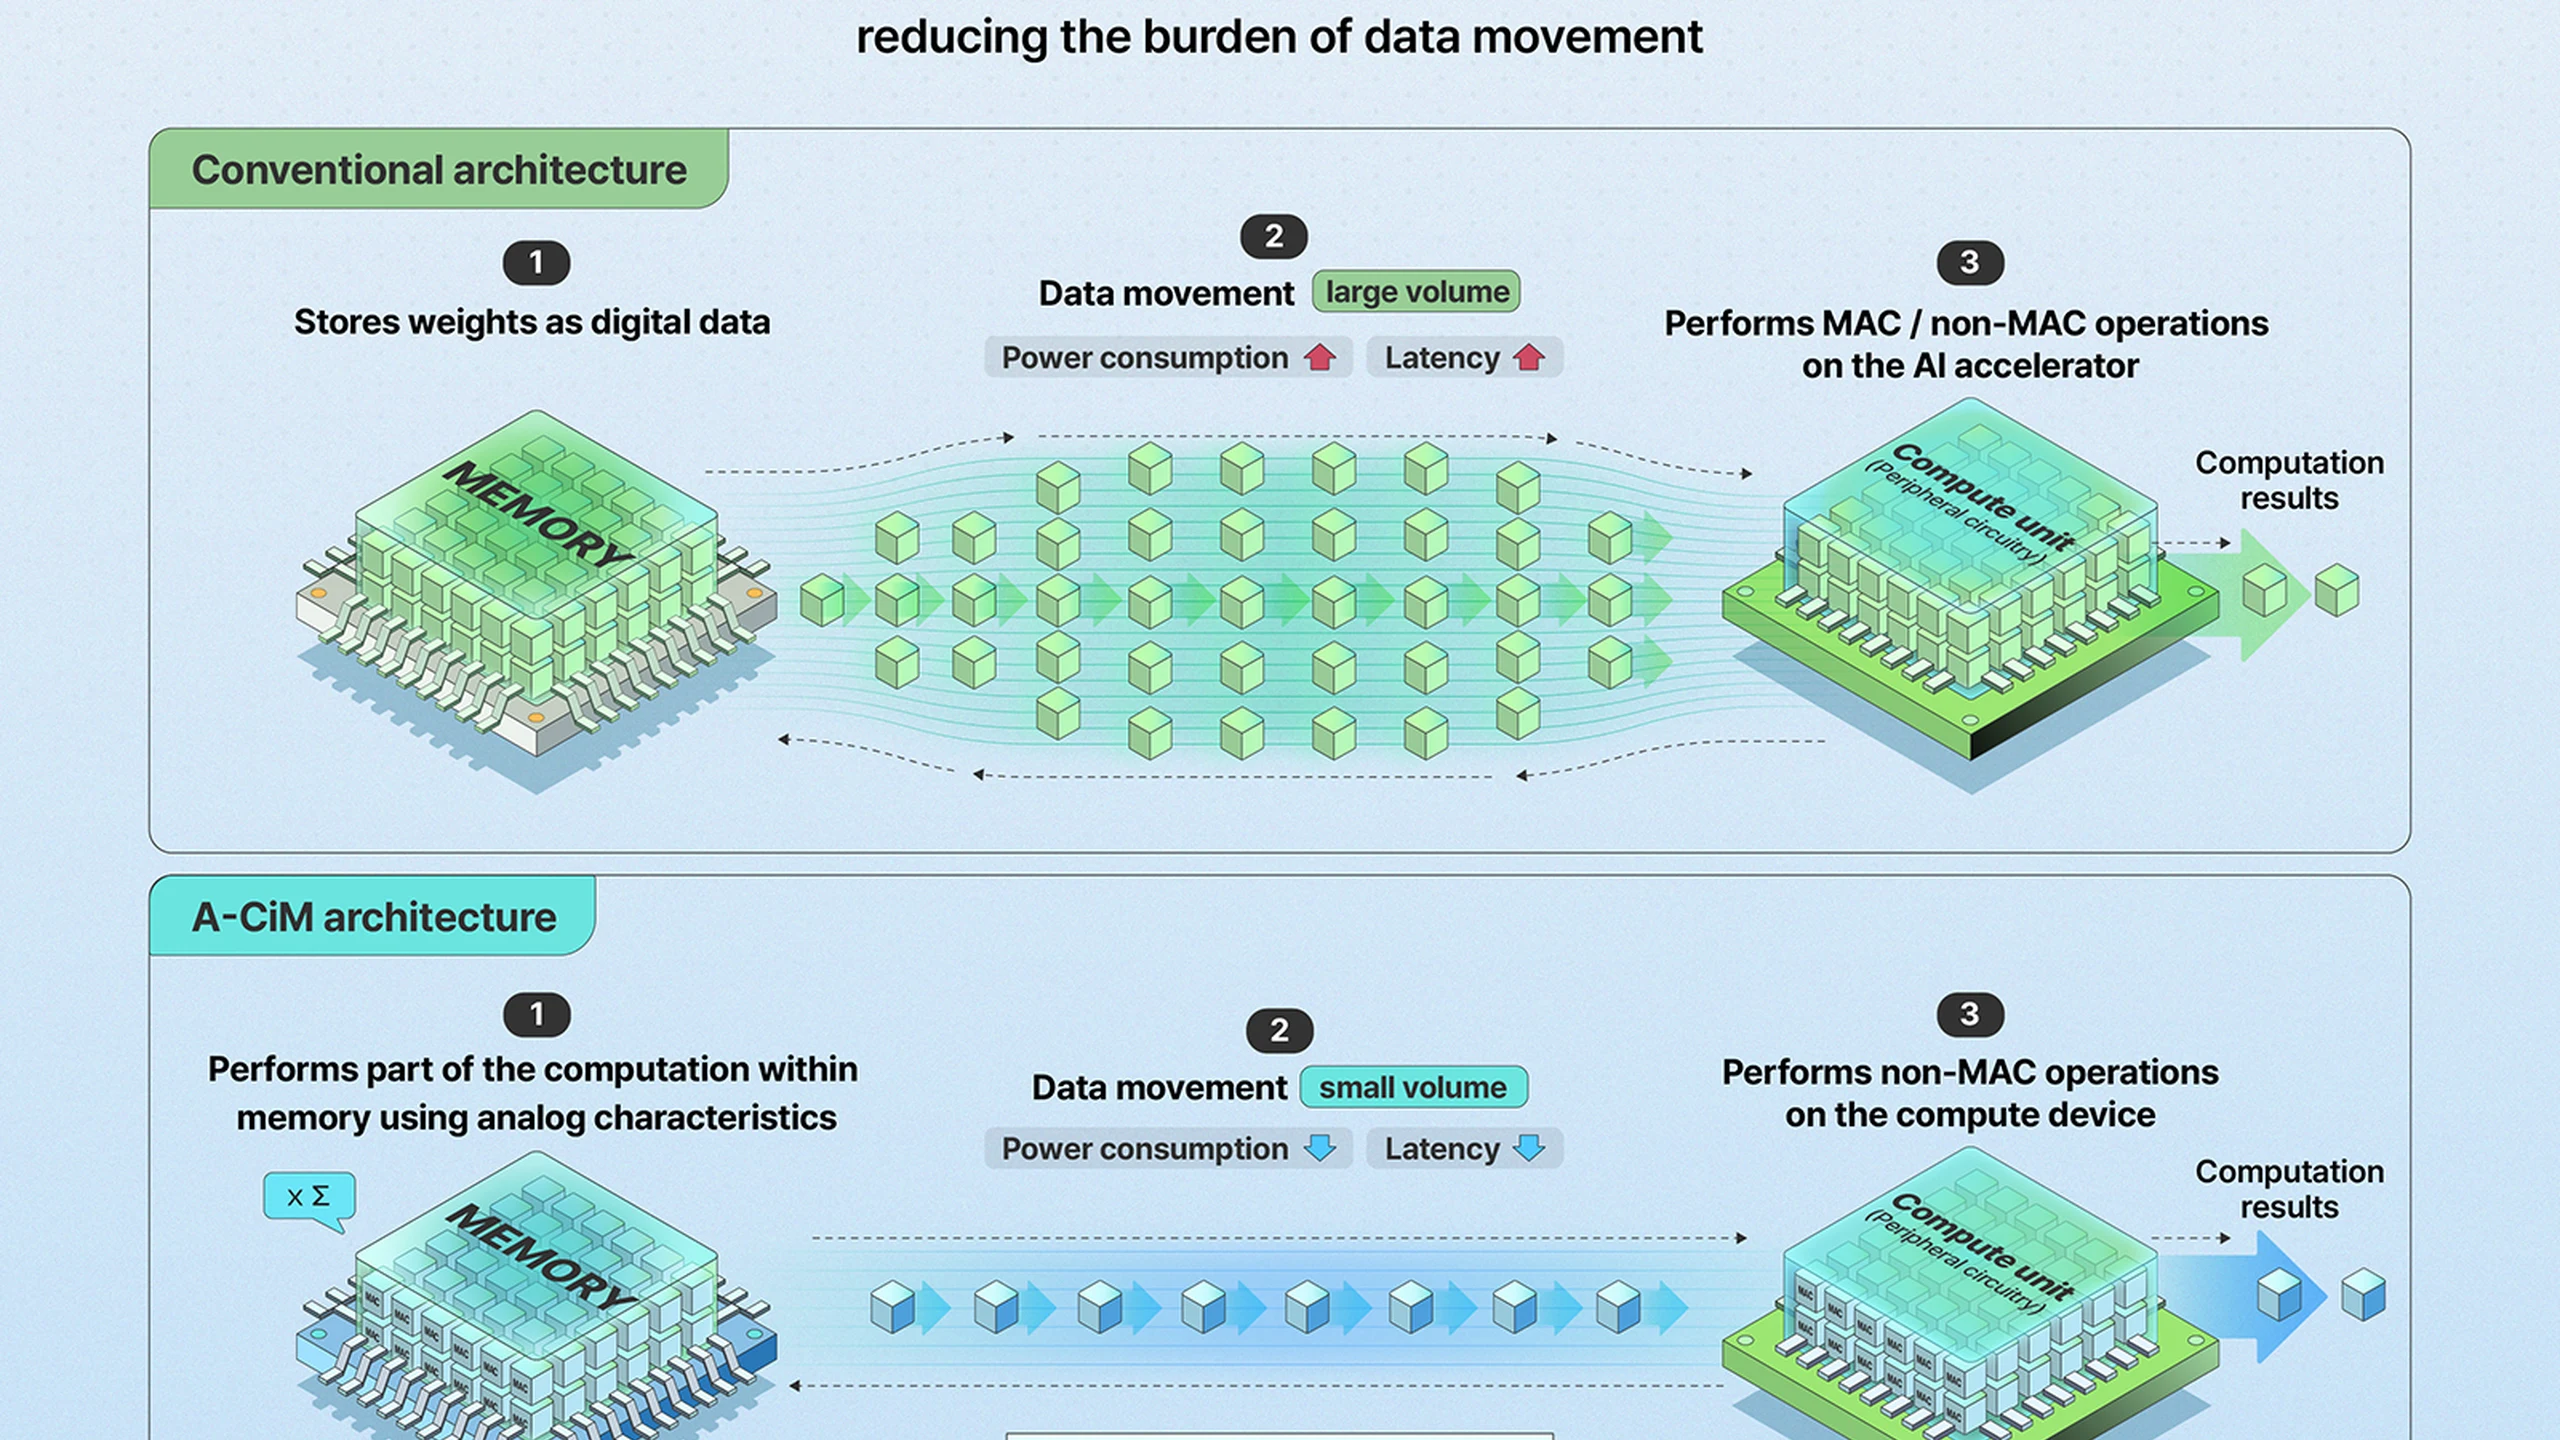
SK hynix veut changer le lieu où s’effectue l’arithmétique de l’IA, pas seulement la quantité de données stockées dans la NAND. Sa dernière présentation publique de la 3D FeNAND décrit des poids conservés dans une mémoire empilée verticalement et certaines multiplications-accumulations exécutées sur place. L’économie potentielle vient de transferts répétés vers un processeur séparé qui deviennent inutiles.
Le compte rendu du 14 octobre 2026 explique une recherche présentée à l’IEDM en décembre 2025. Il annonce des progrès impressionnants, mais aucune puce commerciale, date de production ou procédure de qualification client. L’avancée tient à la coordination entre cellules, commandes périphériques et placement des tâches, et non à un SSD ordinaire remplaçant un GPU.
Deux comparaisons ne font pas une seule promesse
Selon la présentation de l’entreprise, le débit atteint jusqu’à 16 fois et l’efficacité énergétique jusqu’à 4 950 fois ceux de certaines matrices bidimensionnelles conventionnelles, pour les charges et contraintes de surface étudiées. Ce sont des comparaisons d’architectures, pas des coefficients universels applicables à un serveur d’IA entier.
Un résumé technique prend une autre référence : l’ancienne architecture 3D FeNAND. La co-optimisation apporte alors 20,4 fois plus de TOPS et 7,17 fois plus de TOPS par watt. Les TOPS mesurent des milliers de milliards d’opérations par seconde ; les TOPS/W indiquent l’efficacité énergétique. Ces deux références ne se combinent ni ne s’échangent.
La densité aide à comprendre pourquoi le gain énergétique face à une matrice plane peut largement dépasser le gain de débit. Davantage de poids conservés localement signifie moins de rechargements, de réécritures et d’attente autour du calcul. Mais l’économie dépend du modèle et de son placement : elle ne prouve pas une facture électrique divisée par 4 950 dans un système de production.
Trois changements liés rendent la densité exploitable
La FeNAND utilise une polarisation ferroélectrique qui persiste après retrait du champ électrique. Cet état commande le courant de cellule et peut représenter plusieurs niveaux de poids non volatils. La NAND 3D commerciale recourt généralement au nitrure de piégeage de charges, qui retient des électrons dans une couche isolante. Stockage numérique dense et contrôle précis d’un courant analogique répondent à des exigences différentes.
Une longue chaîne verticale ajoute de la résistance. Le courant crée une chute IR, soit une perte de tension susceptible de réduire l’écart entre états analogiques. Des états proches sont plus difficiles à distinguer. Empiler davantage de cellules ne garantit donc pas davantage de calcul exact.
Au niveau des cellules, SK hynix utilise une modulation du nombre d’impulsions : une séquence contrôlée de programmation ajuste les états à faible courant en tenant compte de la chute IR. Il s’agit d’une méthode multiniveau, pas simplement d’un transistor plus rapide. Elle améliore la plage de courant exploitable dont dépendent les poids analogiques.
La deuxième modification vise les coûts hors cellule. Les lignes de mots sélectionnent et commandent les cellules ; modifier régulièrement leur tension consomme énergie et temps. L’activation de deux lignes réduit ces transitions. Intégrer ces commandes au calcul évite qu’une cellule efficace soit entourée de commutations coûteuses.
La troisième porte sur les pages. Le traitement en pipeline à l’intérieur d’une page y place plusieurs couches neuronales et des copies d’opérations choisies, réduisant les opérations de propagation et les transitions de lignes de mots. Le découpage compare une page de 16 Ko à une organisation de 4 Ko adaptée à la charge. Une page trop grande active des circuits inutilisés ; trop petite, elle peut multiplier les opérations.
L’article inscrit au programme de l’IEDM relie ainsi cellules, éléments hors cellule et pages. La capacité verticale ne devient utile que si programmation, commutation et placement permettent au travail réel d’en profiter.
Le mur mémoire ne disparaît pas partout
La littérature sur le calcul en mémoire décrit les déplacements de données comme un coût majeur en temps et en énergie. Les matrices analogiques exploitent les courants physiques pour multiplier les entrées par des poids stockés et sommer les résultats en parallèle. Conserver beaucoup de poids à proximité peut réduire le trafic entre stockage, DRAM, caches et accélérateur.
L’inférence à poids stables constitue une première cible plausible. L’entraînement exige des mises à jour fréquentes, de la précision et une exécution flexible, plus difficiles à prendre en charge. HBM et GPU ne deviennent pas inutiles : la HBM peut servir les activations changeantes et le trafic général, tandis qu’un étage FeNAND dense réalise des opérations adaptées à poids fixes.
D’autres approches ont d’autres compromis. La SRAM est rapide et compatible avec les procédés logiques, mais volatile et gourmande en surface. Les matrices croisées RRAM offrent une résistance programmable, avec des difficultés de variabilité, endurance et conversion. Mémoires magnétiques et à changement de phase équilibrent aussi densité, vitesse et fiabilité ; la logique numérique proche mémoire offre une précision plus prévisible, éventuellement pour des gains énergétiques moindres.
À l’IEDM 2025, Macronix a présenté un calcul dans le stockage NAND 3D en mode mixte pour LLM, utilisant Qwen 2.5 Math 7B et MATH500 pour évaluer les erreurs. C’est une recherche voisine, pas une comparaison validant directement SK hynix. De même, l’ancienne présentation IEEE de la FeNAND rapportait au moins 256 niveaux de conductance et 87,8 % de précision sur la tâche évaluée, pas sur un modèle linguistique actuel ou cette nouvelle architecture.
Précision et périphériques décident du bénéfice réel
Le parallélisme analogique échange une partie de la certitude numérique contre une efficacité physique. Bruit, variations de procédé, effets de circuit et erreurs de conversion influencent les résultats, comme l’explique la revue de précision analogique. Les corrections peuvent améliorer la précision en consommant la surface, le temps ou l’énergie censés être économisés.
La FeNAND doit aussi maîtriser résistance des chaînes verticales, interactions entre cellules voisines et variations des seuils de commutation. Rétention ferroélectrique, résistance aux programmations répétées, dérive et sensibilité thermique doivent rester acceptables à grande échelle. Davantage de niveaux de poids réduit les marges entre états et rend ces effets plus critiques.
Un accélérateur exploitable doit comptabiliser convertisseurs analogique-numérique, acheminement des entrées, accumulation des résultats partiels, ordonnancement et communication avec l’hôte. Refroidissement et alimentation s’ajoutent. Sans périmètres comparables, les TOPS/W d’une matrice et la mesure d’un système GPU complet répondent à des questions différentes.
Le logiciel compte autant. Les compilateurs doivent placer les opérations selon les pages, précisions et niveaux de courant disponibles ; l’étalonnage doit préserver une exactitude utile. Attention, parcimonie et quantification peuvent évoluer plus vite que les procédés de fabrication. Le système doit rester programmable lorsque la charge initiale change.
Ce qui transformerait la recherche en argument produit
La prochaine preuve convaincante serait une puce co-optimisée fabriquée, publiant précision, débit et énergie avec convertisseurs et logique périphérique inclus. Des mesures à plusieurs températures et sur plusieurs puces montreraient la robustesse hors conditions favorables. Les essais de modèles actuels devraient détailler taille, précision, mises à jour des poids, placement des pages et fréquence de rechargement.
Il faudra ensuite démontrer intégration ferroélectrique, rendement de fabrication, rétention et endurance, avec outils de développement et partenaire d’accélérateurs ou plateforme d’évaluation. Aucun multiplicateur ne remplace ces étapes. Le résultat actuel est une avancée de recherche vers l’inférence spécialisée, pas une spécification d’achat.
Les équipes peuvent conserver articles et définitions de tests dans une base de connaissances de documentation technique pour distinguer les comparaisons. La question décisive reste de savoir si la densité économise encore de l’énergie lorsque précision, logiciel et matériel périphérique sont mesurés ensemble.