
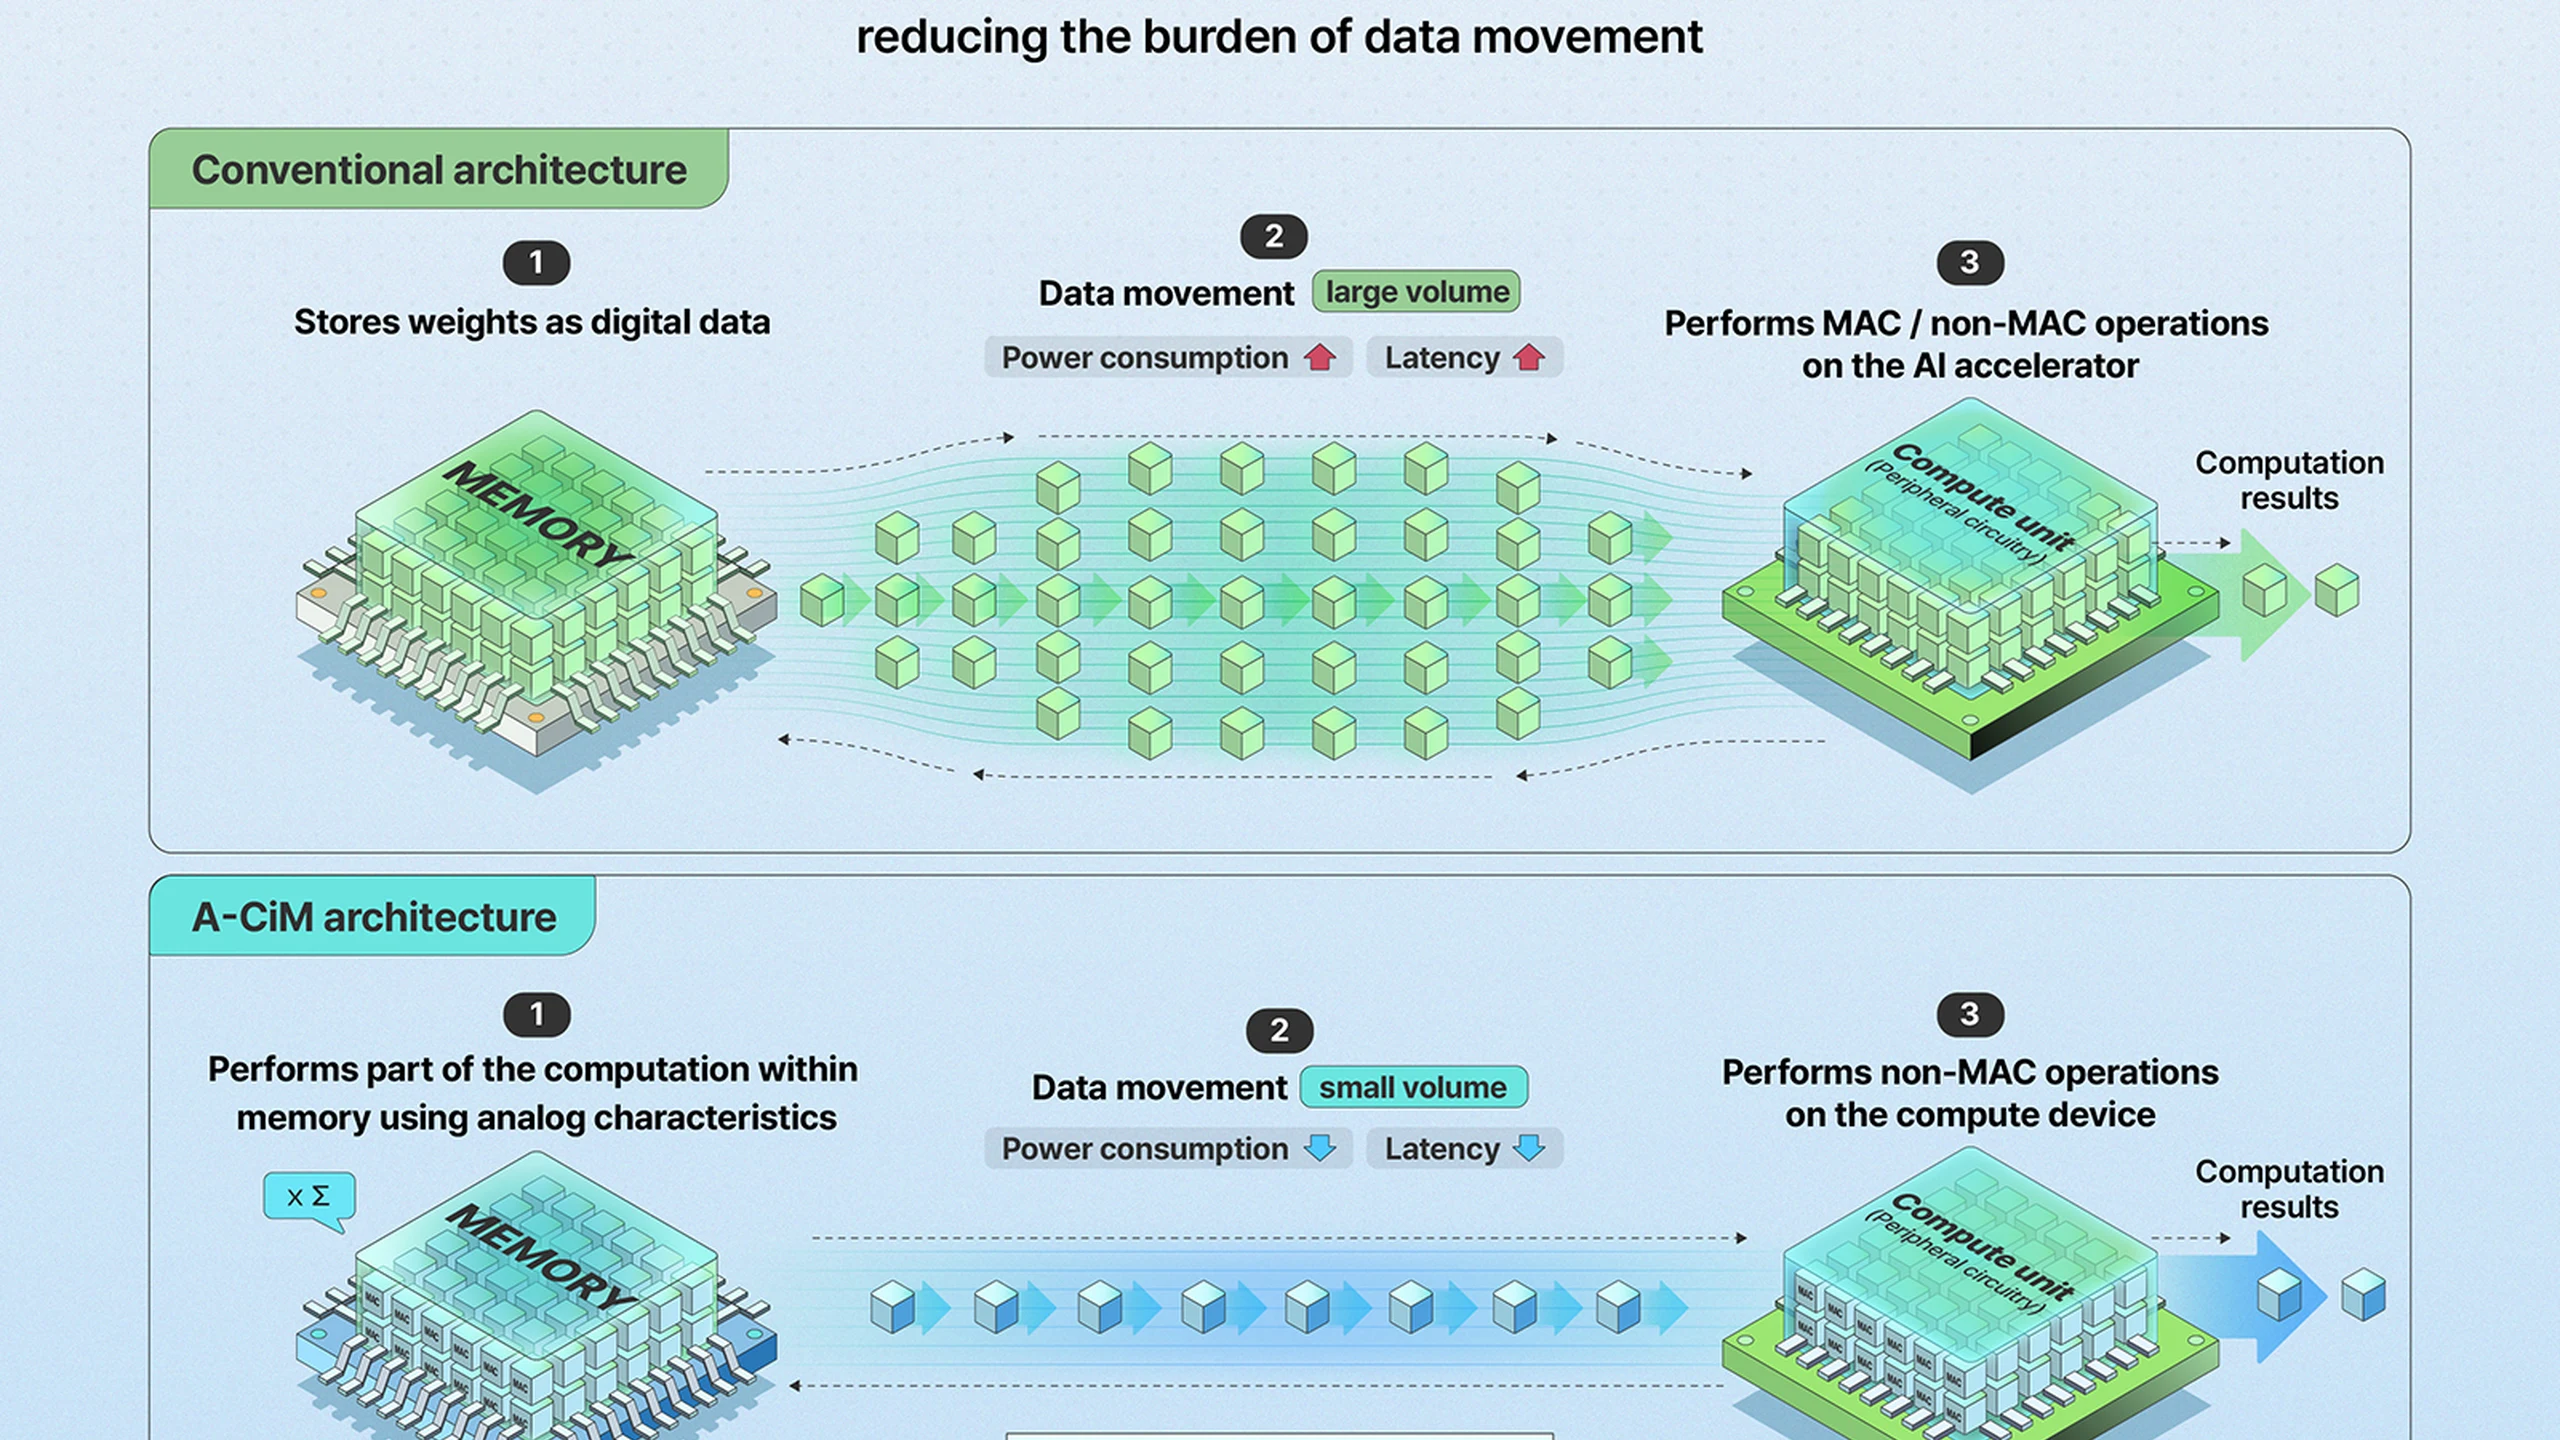
SK hynix chce zmienić miejsce wykonywania działań arytmetycznych AI, a nie tylko pojemność NAND. Najnowsze publiczne wyjaśnienie 3D FeNAND opisuje przechowywanie wag modelu w pionowo ułożonej pamięci i wykonywanie tam wybranych operacji mnożenia z akumulacją. Potencjalna oszczędność wynika z unikania wielokrotnych transferów do osobnego procesora.
Opis z 14 października 2026 r. dotyczy badań przedstawionych na IEDM w grudniu 2025 r. Podaje duże wzrosty wydajności, ale nie zapowiada komercyjnego układu, terminu produkcji ani programu kwalifikacji u klientów. Istotny postęp to wspólne projektowanie komórek, układów sterujących i rozmieszczenia pracy, nie deklaracja, że zwykły SSD zastąpi GPU.
Dwa porównania nie tworzą jednej obietnicy
Opis firmy podaje do 16 razy większą przepustowość obliczeniową i 4950 razy większą efektywność energetyczną niż wybrane konwencjonalne macierze dwuwymiarowe, przy badanym obciążeniu i ograniczonej powierzchni układu. To porównania architektur, a nie uniwersalne mnożniki dla kompletnego serwera AI.
Podsumowanie techniczne przyjmuje inny punkt odniesienia: wcześniejszy projekt 3D FeNAND. Wobec niego wspólna optymalizacja zapewniła 20,4 razy więcej TOPS i 7,17 razy więcej TOPS na wat. TOPS oznacza biliony operacji na sekundę, a TOPS/W efektywność energetyczną. Tych podstaw nie można łączyć ani zamieniać.
Gęstość tłumaczy, dlaczego wzrost efektywności względem płaskiej macierzy może być znacznie większy niż wzrost przepustowości. Więcej wag przechowywanych lokalnie oznacza mniej ponownych ładowań, zapisów i oczekiwania wokół obliczeń. Oszczędność zależy jednak od modelu i mapowania; nie dowodzi 4950-krotnego zmniejszenia rachunku za prąd systemu produkcyjnego.
Trzy powiązane zmiany pozwalają wykorzystać gęstość
FeNAND wykorzystuje polaryzację ferroelektryczną utrzymującą się po usunięciu pola elektrycznego. Steruje ona prądem komórki i może reprezentować wiele nieulotnych poziomów wag. Komercyjna pamięć 3D NAND zwykle korzysta z azotku pułapkującego ładunek, zatrzymując elektrony w warstwie izolującej. Gęsty zapis cyfrowy i precyzyjne sterowanie prądem analogowym stawiają inne wymagania.
Długi pionowy łańcuch wnosi rezystancję. Przepływ prądu powoduje spadek IR, czyli utratę napięcia, która może zmniejszyć odstępy między stanami analogowymi. Blisko położone stany trudniej odróżnić. Więcej ułożonych komórek nie oznacza zatem automatycznie większej liczby poprawnych obliczeń.
Na poziomie komórki SK hynix stosuje modulację liczby impulsów: kontrolowana seria impulsów programujących dostraja stany przy małym prądzie, z uwzględnieniem spadku IR. To metoda programowania wielopoziomowego, nie tylko szybszy tranzystor. Poprawia użyteczny zakres prądowy, od którego zależą analogowe wagi.
Druga zmiana dotyczy kosztów poza komórką. Linie słów wybierają i kontrolują komórki; częste zmiany ich napięcia pochłaniają energię i czas. Aktywacja dwóch linii ogranicza takie przejścia. Włączenie sterowania w projekt obliczeniowy zapobiega otaczaniu oszczędnej komórki kosztownym przełączaniem.
Trzecia warstwa to organizacja stron. Potok wewnątrz strony umieszcza tam kilka warstw sieci neuronowej i kopie wybranych operacji, ograniczając operacje propagacji oraz przełączenia linii słów. Podział stron porównuje stronę 16 KB z układem 4 KB, aby dopasować je do obciążenia. Zbyt duża strona aktywuje nieużywane obwody, zbyt mała może wymagać dodatkowych operacji.
Dlatego praca wymieniona w programie IEDM łączy schematy komórek, elementów poza nimi i stron. Pionowa pojemność ma wartość dopiero wtedy, gdy programowanie, przełączanie i mapowanie pozwalają użytecznie ją wykorzystać.
Bariera pamięci nie znika dla każdego zadania
Literatura o obliczeniach w pamięci wskazuje ruch danych jako istotny koszt czasu i energii. Macierze analogowe wykorzystują fizyczne prądy do mnożenia wejść przez zapisane wagi i równoległego sumowania wyników. Zachowanie dużego zestawu wag blisko obliczeń może ograniczyć ruch między pamięcią masową, DRAM, pamięciami podręcznymi i akceleratorem.
Wnioskowanie ze stabilnymi wagami jest prawdopodobnym pierwszym zastosowaniem. Trening wymaga częstych aktualizacji, precyzji i elastycznego wykonywania, które trudniej obsłużyć. HBM i GPU nie stają się zbędne: HBM może obsługiwać zmieniające się aktywacje i ogólny ruch akceleratora, a gęsta warstwa FeNAND odpowiednie operacje ze stałymi wagami.
Inne metody mają odmienne kompromisy. SRAM jest szybki i zgodny z procesami logicznymi, lecz ulotny i zajmuje sporo powierzchni. Macierze krzyżowe RRAM oferują programowalną rezystancję, ale zmagają się ze zmiennością, trwałością i konwersją. Pamięci magnetyczne i zmiennofazowe także równoważą gęstość, szybkość i niezawodność; cyfrowa logika przy pamięci zapewnia bardziej przewidywalną precyzję, być może przy mniejszych oszczędnościach.
Na IEDM 2025 Macronix opisał mieszany tryb obliczeń w pamięci masowej 3D NAND dla LLM, oceniając błędy za pomocą Qwen 2.5 Math 7B i MATH500. To sąsiednie badania, nie bezpośrednie potwierdzenie wyników SK hynix. Podobnie wcześniejszy przegląd IEEE dotyczący FeNAND podawał co najmniej 256 poziomów przewodności i dokładność 87,8% w ocenianym zadaniu, a nie dla obecnego modelu językowego czy nowej architektury.
Dokładność i peryferia decydują o praktycznej korzyści
Równoległość analogowa wymienia część cyfrowej pewności na efektywność fizyczną. Szum, zmienność procesu, efekty obwodowe i błędy konwersji wpływają na wyniki, jak omawia przegląd dokładności analogowej. Korekcja może zwiększać precyzję, pochłaniając powierzchnię, czas lub energię, które miały zostać zaoszczędzone.
FeNAND musi też kontrolować opór pionowych łańcuchów, oddziaływania sąsiednich komórek i różnice progów przełączania. Ferroelektryczna retencja, wytrzymałość na wielokrotne programowanie, dryft i wrażliwość termiczna muszą pozostać akceptowalne w dużych macierzach. Więcej poziomów wag zmniejsza margines między stanami i nasila znaczenie tych efektów.
Akcelerator do wdrożenia musi uwzględniać przetworniki analogowo-cyfrowe, dostarczanie wejść, akumulację wyników częściowych, harmonogramowanie i komunikację z hostem. Chłodzenie i zasilanie dodają koszty. Bez porównywalnych granic TOPS/W macierzy i pomiar całego systemu GPU odpowiadają na różne pytania.
Oprogramowanie jest równie ważne. Kompilatory muszą mapować operacje na dostępne strony, precyzję i poziomy prądu, a kalibracja utrzymywać użyteczną dokładność. Mechanizmy uwagi, rzadkość i kwantyzacja mogą zmieniać się szybciej niż procesy produkcyjne. Potrzebna jest programowalność, by projekt pozostał przydatny po zmianie pierwotnego obciążenia.
Jakie dowody zamienią badania w argument produktowy
Kolejnym przekonującym dowodem byłby wyprodukowany, wspólnie zoptymalizowany układ raportujący dokładność wraz z przepustowością i energią, z uwzględnieniem przetworników oraz logiki peryferyjnej. Pomiary w wielu temperaturach i na kilku układach pokazałyby odporność poza sprzyjającymi warunkami. Testy obecnych modeli powinny ujawniać rozmiar, precyzję, aktualizacje wag, rozmieszczenie stron i częstotliwość przeładowań.
Następnie potrzebne są dowody integracji ferroelektryków, uzysku produkcji, retencji i trwałości oraz narzędzia deweloperskie, partner akceleratorowy lub platforma oceny. Żaden mnożnik efektywności nie zastąpi tych etapów. Obecny rezultat to postęp badań nad wyspecjalizowanym wnioskowaniem, nie specyfikacja zakupowa.
Zespoły mogą zachowywać publikacje i definicje testów w przeszukiwalnej bazie wiedzy dokumentów technicznych, aby nie mieszać porównań. Rozstrzygające jest, czy gęstość nadal oszczędza energię po wspólnym zmierzeniu dokładności, oprogramowania i całego otaczającego sprzętu.