
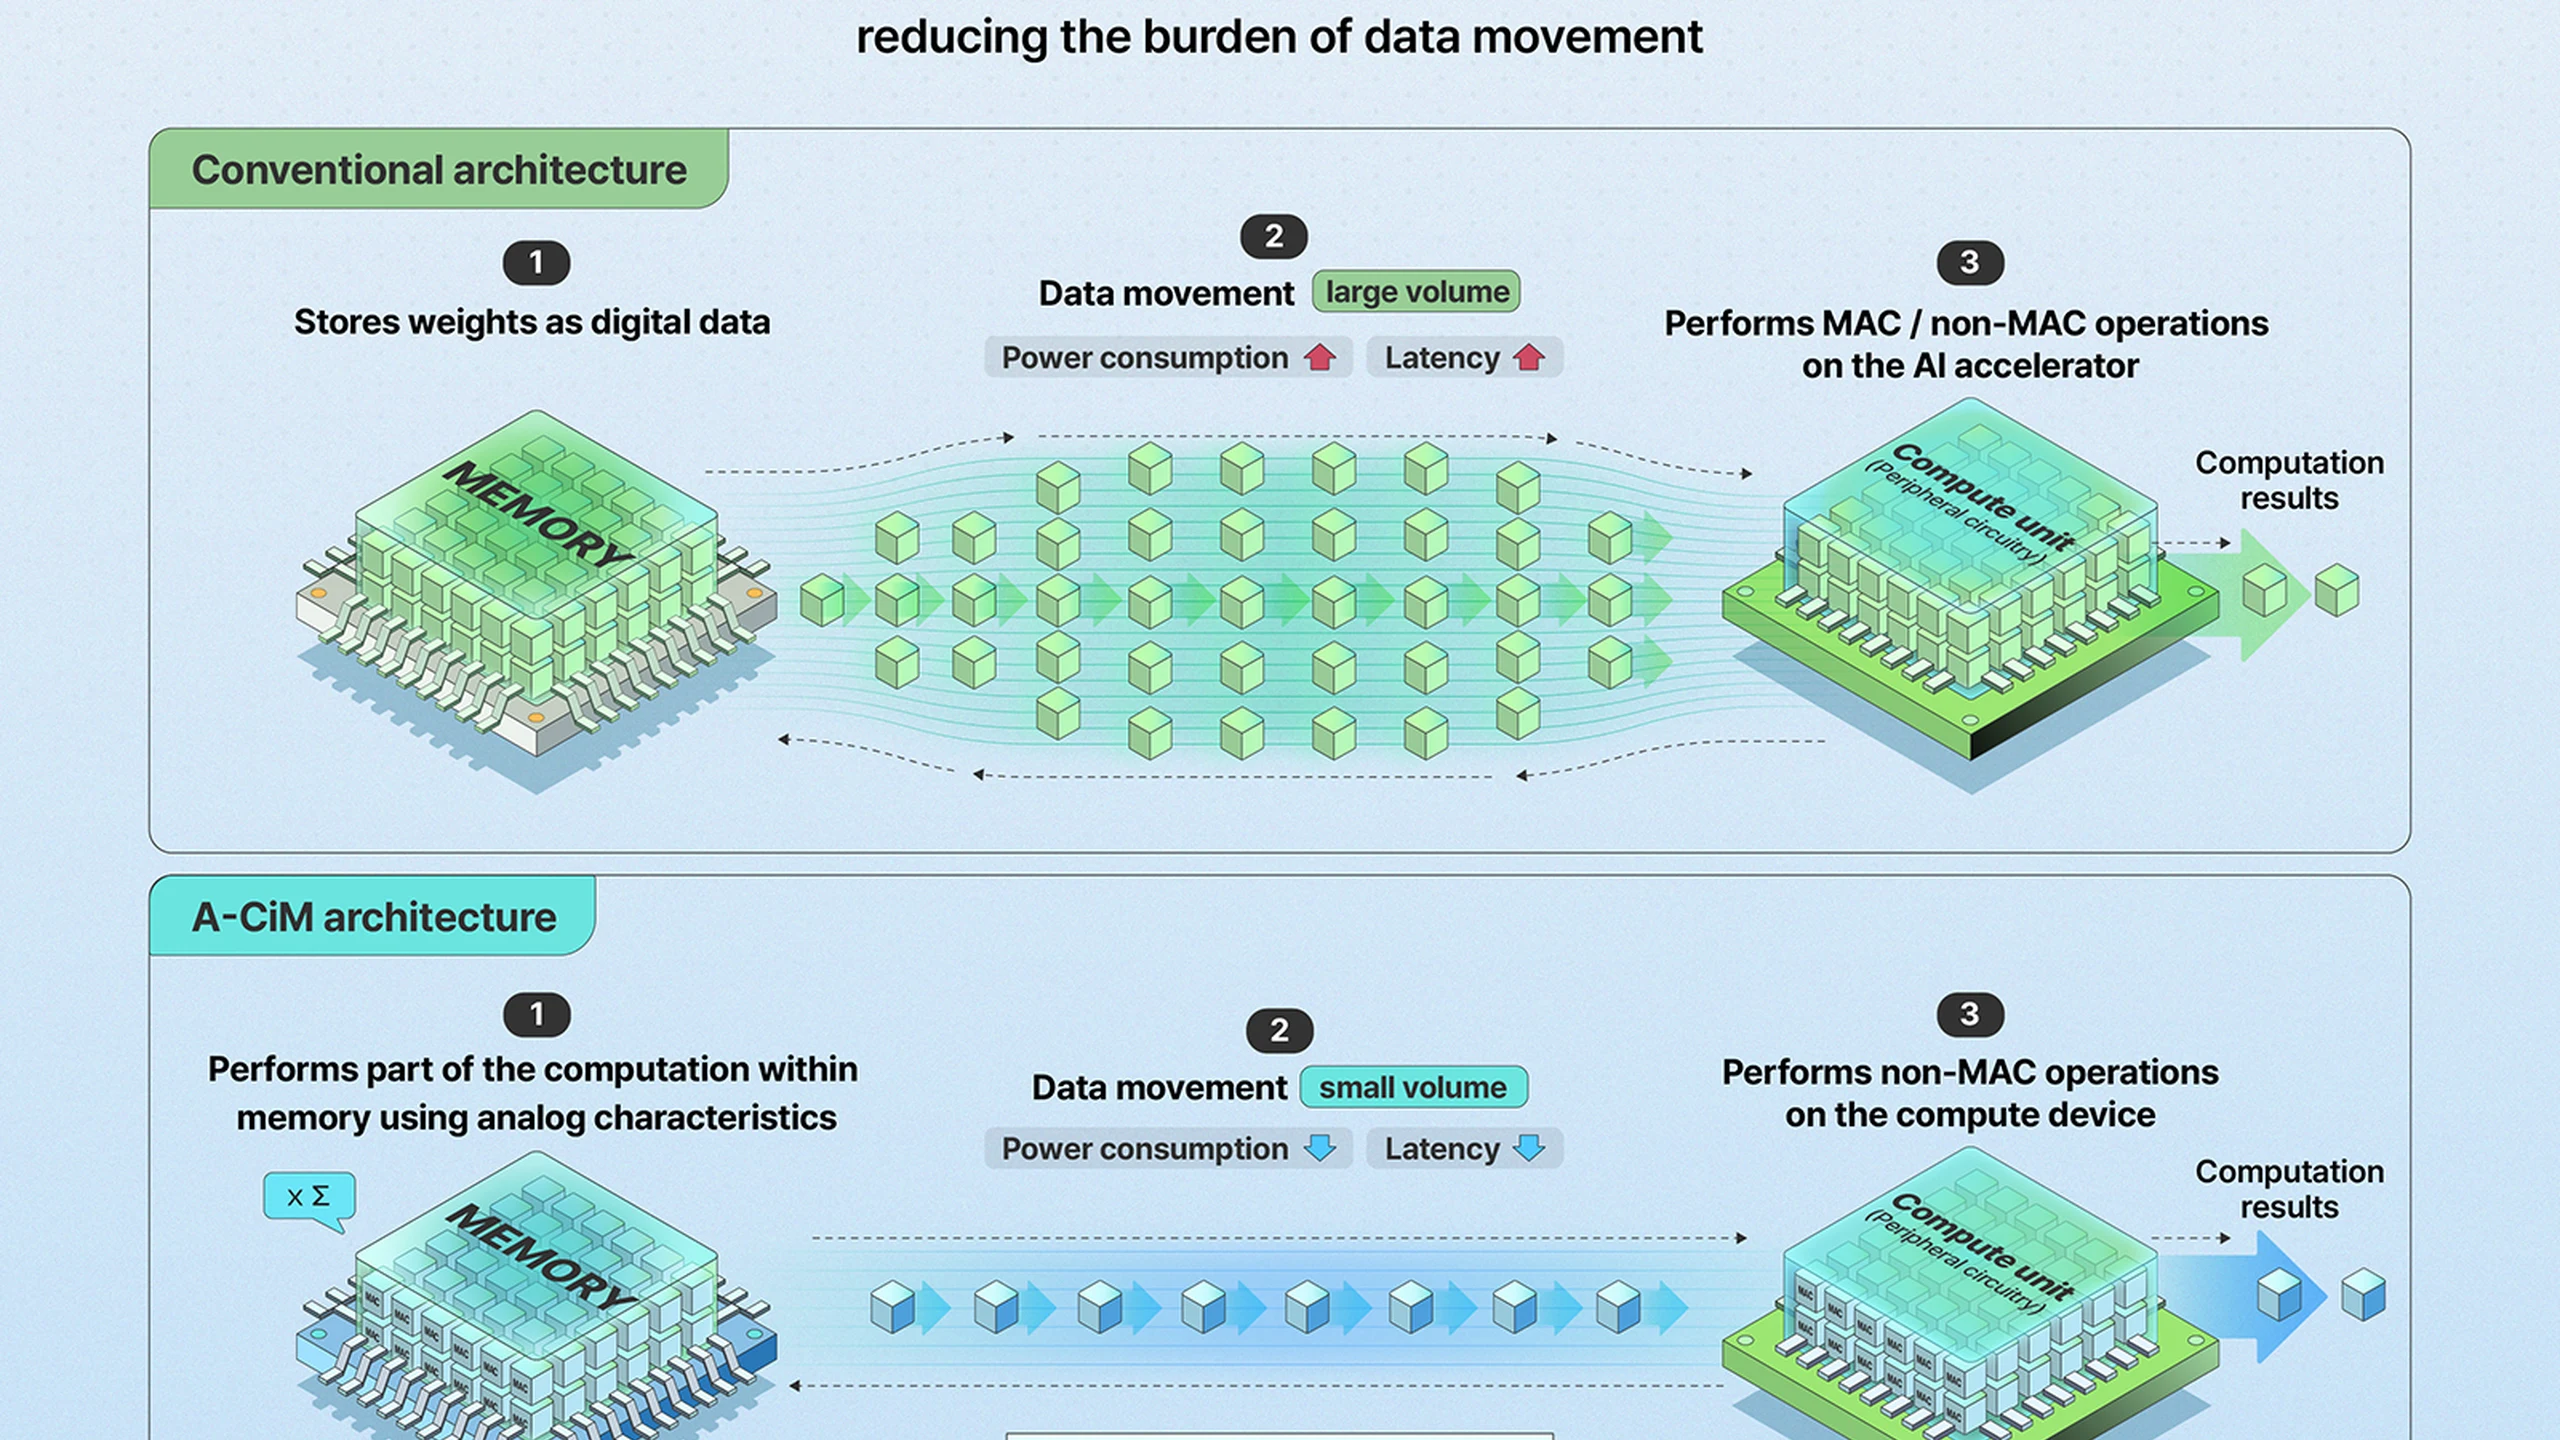
SK hynix vuole cambiare dove si svolge l’aritmetica dell’IA, non soltanto quanti dati contiene la NAND. L’ultima spiegazione pubblica della 3D FeNAND descrive pesi dei modelli conservati in memoria impilata verticalmente e alcune operazioni di moltiplicazione e accumulo svolte sul posto. Il risparmio potenziale deriva dall’evitare trasferimenti ripetuti a un processore separato.
Il resoconto del 14 ottobre 2026 approfondisce una ricerca presentata alla IEDM nel dicembre 2025. Riporta miglioramenti notevoli, ma nessun chip commerciale, data di produzione o programma di qualificazione clienti. Il progresso consiste nel progettare insieme celle, controlli di supporto e collocazione del lavoro, non nell’affermare che un normale SSD possa sostituire una GPU.
Due confronti non diventano un’unica promessa
Il resoconto dell’azienda indica fino a 16 volte più capacità di elaborazione e 4.950 volte più efficienza energetica rispetto a determinate matrici bidimensionali convenzionali, con il carico valutato e vincoli di superficie del chip. Sono confronti tra architetture, non moltiplicatori universali per un server IA completo.
Un riepilogo tecnico usa un altro riferimento: la precedente architettura 3D FeNAND. Rispetto a questa, l’ottimizzazione congiunta offre 20,4 volte più TOPS e 7,17 volte più TOPS per watt. TOPS indica migliaia di miliardi di operazioni al secondo; TOPS/W esprime l’efficienza energetica. Le due basi non possono essere sommate o scambiate.
La densità aiuta a capire perché il guadagno energetico rispetto a una matrice planare possa superare di molto quello di elaborazione. Più pesi conservati localmente significano meno ricaricamenti, riscritture e attese attorno al calcolo. Il risparmio dipende però da modello e mappatura: non dimostra una bolletta elettrica ridotta di 4.950 volte per un sistema in produzione.
Tre modifiche collegate rendono utile la densità
La FeNAND impiega polarizzazione ferroelettrica che resta dopo la rimozione del campo elettrico. Questo stato controlla la corrente della cella e rappresenta più livelli di pesi non volatili. La NAND 3D commerciale utilizza normalmente nitruro a intrappolamento di carica, trattenendo elettroni in uno strato isolante. Archiviazione digitale densa e controllo preciso della corrente analogica pongono requisiti diversi.
Una lunga stringa verticale introduce resistenza. Il passaggio di corrente provoca una caduta IR, una perdita di tensione che può comprimere la separazione tra stati analogici. Stati vicini sono più difficili da distinguere. Impilare più celle non significa quindi ottenere automaticamente più calcoli corretti.
A livello di cella, SK hynix usa la modulazione del numero di impulsi: una sequenza controllata di programmazione regola gli stati a bassa corrente tenendo conto della caduta IR. È un metodo multilivello, non soltanto un transistor più veloce. Migliora l’intervallo di corrente utilizzabile da cui dipendono i pesi analogici.
La seconda modifica riguarda i costi esterni alla cella. Le linee di parola selezionano e controllano le celle; modificarne ripetutamente la tensione consuma energia e tempo. L’attivazione di due linee riduce queste transizioni. Includere i controlli nel progetto evita che una cella efficiente sia circondata da commutazioni costose.
La terza riguarda le pagine. Il funzionamento in pipeline dentro la pagina colloca più strati neurali e copie di alcune operazioni nella stessa pagina, riducendo operazioni di propagazione e transizioni delle linee. La suddivisione confronta 16 KB con un’organizzazione da 4 KB per adattarsi al carico. Pagine troppo grandi attivano circuiti inutilizzati; troppo piccole possono richiedere più operazioni.
Il lavoro elencato nel programma IEDM collega perciò schemi di cella, elementi esterni e pagine. La capacità verticale vale soltanto se programmazione, commutazione e mappatura consentono al lavoro utile di sfruttarla.
Il limite della memoria non scompare ovunque
La letteratura sul calcolo in memoria identifica lo spostamento dei dati come costo importante in tempo ed energia. Le matrici analogiche usano correnti fisiche per moltiplicare ingressi e pesi memorizzati e sommare i risultati in parallelo. Conservare molti pesi vicino al calcolo può ridurre il traffico tra archiviazione, DRAM, cache e acceleratore.
L’inferenza con pesi stabili è una prima applicazione plausibile. L’addestramento richiede aggiornamenti frequenti, precisione ed esecuzione flessibile, più difficili da gestire. HBM e GPU non diventano superflue: la HBM può servire attivazioni variabili e traffico generale, mentre uno strato FeNAND denso esegue operazioni adatte con pesi fissi.
Le alternative hanno compromessi diversi. SRAM è veloce e compatibile con processi logici, ma volatile e relativamente ingombrante. Le matrici incrociate RRAM offrono resistenza programmabile, con problemi di variabilità, durata e conversione. Memorie magnetiche e a cambiamento di fase bilanciano anch’esse densità, velocità e affidabilità; la logica digitale vicina alla memoria offre precisione più prevedibile, forse con guadagni energetici inferiori.
Alla IEDM 2025, Macronix ha descritto calcolo nello storage NAND 3D a modalità mista per LLM, usando Qwen 2.5 Math 7B e MATH500 per valutare gli errori. È ricerca vicina, non una verifica diretta dei risultati SK hynix. Anche la precedente panoramica IEEE sulla FeNAND riportava almeno 256 livelli di conduttanza e l’87,8% di accuratezza nel compito valutato, non per un modello linguistico attuale o questa nuova architettura.
Accuratezza e periferiche decidono il vantaggio concreto
Il parallelismo analogico scambia parte della certezza digitale con efficienza fisica. Rumore, variazioni di processo, effetti circuitali ed errori di conversione influenzano i risultati, come spiega la rassegna sull’accuratezza analogica. Correggerli può aumentare la precisione consumando superficie, tempo o energia che si volevano risparmiare.
La FeNAND deve inoltre gestire resistenza delle stringhe verticali, interazioni tra celle vicine e variazioni della soglia di commutazione. Ritenzione ferroelettrica, resistenza a programmazioni ripetute, deriva e sensibilità termica devono restare accettabili su grandi matrici. Più livelli di pesi restringono il margine tra stati e rendono questi effetti più importanti.
Un acceleratore utilizzabile deve contare convertitori analogico-digitali, alimentazione degli ingressi, accumulo dei risultati parziali, pianificazione e comunicazione con l’host. Raffreddamento e alimentazione elettrica aggiungono costi. Senza confini comparabili, TOPS/W della matrice e misura di un sistema GPU completo rispondono a domande diverse.
Il software conta altrettanto. I compilatori devono mappare le operazioni su pagine, precisione e livelli di corrente disponibili; la calibrazione deve preservare un’accuratezza utile. Attenzione, sparsità e quantizzazione possono cambiare più velocemente dei processi produttivi. Serve programmabilità affinché il progetto rimanga utile quando cambia il carico originario.
Quali prove renderebbero la ricerca un caso di prodotto
La prossima prova convincente sarebbe un chip fabbricato con ottimizzazione congiunta, che riporti accuratezza insieme a prestazioni ed energia includendo convertitori e logica periferica. Misure a diverse temperature e su più chip mostrerebbero la tenuta oltre condizioni favorevoli. Le prove con modelli attuali dovrebbero dichiarare dimensione, precisione, aggiornamenti dei pesi, collocazione nelle pagine e frequenza di ricaricamento.
La produzione deve poi dimostrare integrazione ferroelettrica, resa, ritenzione e durata, insieme a strumenti di sviluppo e un partner per acceleratori o una piattaforma di valutazione. Nessun moltiplicatore sostituisce queste tappe. Il risultato attuale è un avanzamento di ricerca verso inferenza specializzata, non una specifica d’acquisto.
Chi segue il settore può conservare lavori e definizioni dei test in una base di conoscenza di documenti tecnici per distinguere i confronti. La domanda decisiva è se la densità risparmi ancora energia quando accuratezza, software e tutto l’hardware circostante vengono misurati insieme.