
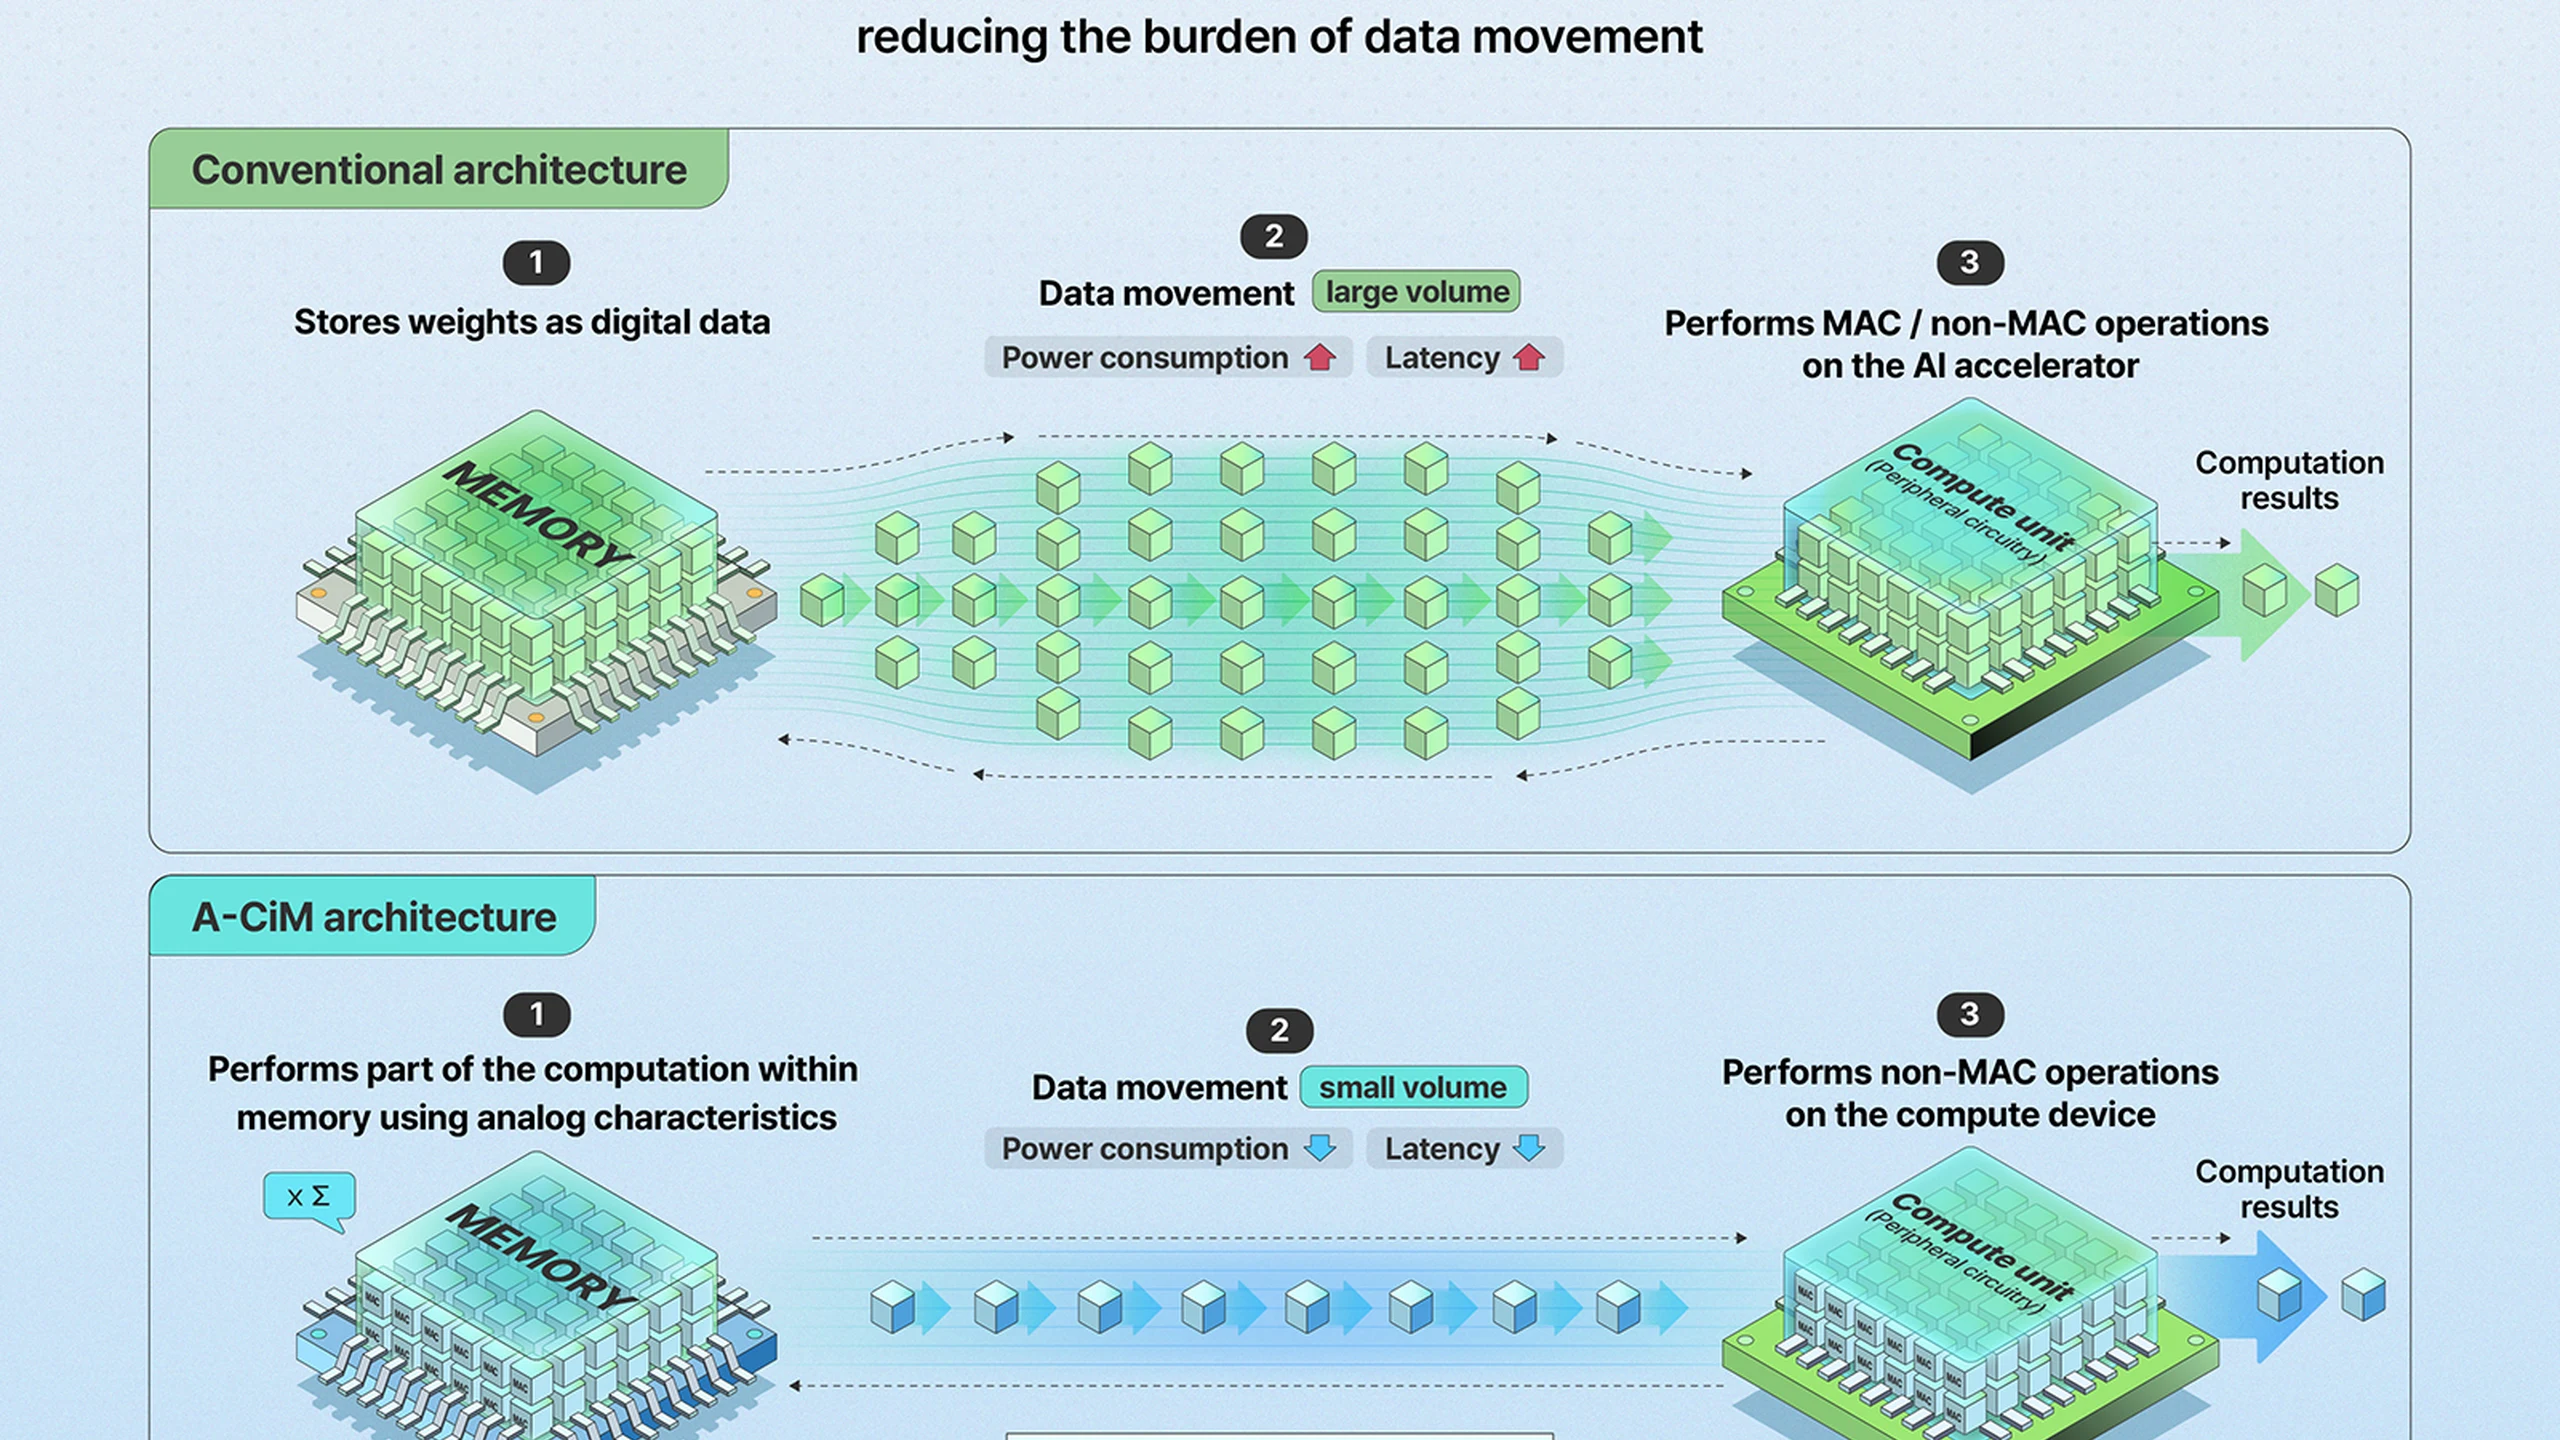
SK hynix 希望改变 AI 运算发生的位置,而不只是增加 NAND 能存下的数据量。其最新公开说明介绍了 3D FeNAND:将模型权重保留在垂直堆叠的存储结构里,并在其中完成部分乘加运算。潜在收益来自减少权重向独立处理器的反复搬运。
2026 年 10 月 14 日发布的说明,对应的是 2025 年 12 月 IEDM 上发表的研究。报告给出了显著增益,但没有宣布商用芯片、量产日期或客户认证计划。真正的进展是协同设计存储单元、外围控制与工作负载布局,而不是普通 SSD 已能取代 GPU。
两组比较,不能拼成一个性能承诺
公司说明称,在所评估的工作负载和受限芯片面积假设下,相比选定的传统二维阵列,吞吐量最高提高 16 倍,能效最高提高 4,950 倍。这些数字比较的是特定架构,并非适用于整台 AI 服务器的通用倍数。
技术摘要采用另一基准,即上一代 3D FeNAND 设计。相对于这个前代架构,协同优化带来 20.4 倍 TOPS 和 7.17 倍 TOPS/W。TOPS 是每秒万亿次运算,TOPS/W 衡量单位功率下的计算效率。两组基准不能合并,也不能互换。
高密度有助于解释:为什么相对平面阵列,能效增益可能远大于吞吐量增益。更多权重能留在本地,就能减少计算前后的重新加载、重复写入和等待。不过,节省多少仍取决于模型与映射方式;这并不等于已测得生产系统电费下降 4,950 倍。
三层协同,才能把密度变成有效计算
FeNAND 利用外加电场撤去后仍保留的铁电极化状态,控制单元电流,表示多个非易失性权重等级。商用 3D NAND 通常采用电荷俘获氮化物结构,将电子保存在绝缘层中。高密度数字存储与精确模拟电流控制,属于不同的工程要求。
较长的垂直串会引入电阻。电流通过时产生 IR 压降,压缩不同模拟状态之间的间距。状态越接近,越难可靠分辨,因此堆叠更多单元,并不自动意味着能够完成更多准确的计算。
在单元层面,SK hynix 使用脉冲数量调制,通过一串受控编程脉冲,在低电流且考虑 IR 压降的条件下调整状态。这是一种多等级编程方法,而不是单纯把晶体管做得更快。它改善的是模拟权重所依赖的可用电流范围。
第二层处理单元之外的开销。字线负责选择与控制存储单元,反复改变其电压会消耗能量和时间。双字线激活旨在减少这种切换负担。把控制电路也纳入计算优化很重要,否则高效的存储单元仍可能被昂贵的外围切换抵消优势。
第三层是页面组织。页内流水线在同一页面映射多个神经网络层,并复制部分运算,以减少前向操作和字线切换。页面拆分则比较 16 KB 页面与 4 KB 组织方式,使其更贴合负载。页面过大会激活闲置电路,过小又可能增加操作次数。
IEDM 会议议程所列论文因此将单元、非单元与页面方案联系起来。只有编程、切换和映射都允许有效计算利用这些容量,垂直密度才真正有价值。
存储墙不会在所有工作负载中消失
存内计算研究综述指出,搬运数据本身会带来显著的时间与能量成本。模拟阵列利用电流的物理特性,将输入与已存权重相乘并并行求和。大量权重就近保留,有机会降低存储、DRAM、缓存和加速器之间的流量。
权重相对稳定的推理,是较合理的初期应用方向。训练涉及频繁更新、更高精度要求和灵活执行,适配难度更大。HBM 与 GPU 并不会因此失去价值:HBM 仍可服务变化的激活值与通用加速器流量,而高密度 FeNAND 层负责适合的固定权重运算。
其他路线有不同取舍。SRAM 速度快且兼容逻辑工艺,但易失性、面积较大;RRAM 交叉阵列利用可编程电阻,却仍面临器件差异、耐久性和转换开销。相变与磁性存储同样需要平衡密度、速度和可靠性。数字近存逻辑的精度更可预测,潜在能效增益却可能较小。
IEDM 2025 上,Macronix 也介绍了面向大语言模型的混合模式 3D NAND 存储内计算,使用 Qwen 2.5 Math 7B 与 MATH500 评估误差。这是相邻研究,不是直接验证 SK hynix 结果的对照实验。同样,IEEE 此前的 FeNAND 概述提到至少 256 个电导等级及所测任务 87.8% 的准确率;不能将其说成当前语言模型或这项新架构的准确率。
精度和外围成本决定实际收益
模拟并行运算以部分数字确定性换取物理效率。模拟精度综述讨论了噪声、工艺差异、电路效应和转换误差对结果的影响。误差校正可以提高精度,却也会消耗该架构原本希望节省的面积、时间和能量。
FeNAND 还需应对垂直串电阻、邻近单元相互作用和开关阈值差异。铁电材料的数据保持能力、反复编程耐久性、漂移和温度敏感性,必须在大规模阵列中保持可接受水平。权重等级越多,相邻状态的裕量越小,这些效应便越重要。
可部署的加速器还必须计算模数转换器、输入传递、部分结果累加、调度与主机通信的成本,散热和供电也不能忽略。若边界不一致,阵列级 TOPS/W 与整套 GPU 系统的测量,回答的其实不是同一个问题。
软件同样关键。编译器要把运算映射到可用页面、精度和电流等级,校准工具要维持有用的准确性。注意力机制、稀疏模式或量化格式的更新,可能快于新工艺开发。即使原有工作负载发生变化,这种设计也需要足够的可编程性才能继续适用。
从研究走向产品,还需要哪些证据
下一步有说服力的证据,是制成协同优化芯片,在计入转换器与外围逻辑后,同时报告准确率、吞吐量和能耗。跨温度、跨多颗芯片的测量,才能说明结果是否超出有利条件下的表现。当前模型测试还应披露规模、精度、权重更新方式、页面布局与重载频率。
制造方面则需证明铁电工艺集成、良率、数据保持与耐久性,并配套开发工具、加速器合作方或评估平台。任何一个能效倍数都不能代替这些里程碑。当前结果是面向专用推理的一项研究进展,而不是可据此采购的产品规格。
跟踪该方向的团队可将论文与基准定义保存在可搜索的技术文档知识库中,避免混淆不同比较。最终需要回答的是:当精度、软件和全部外围硬件一起纳入测量时,高密度是否仍然节能。