
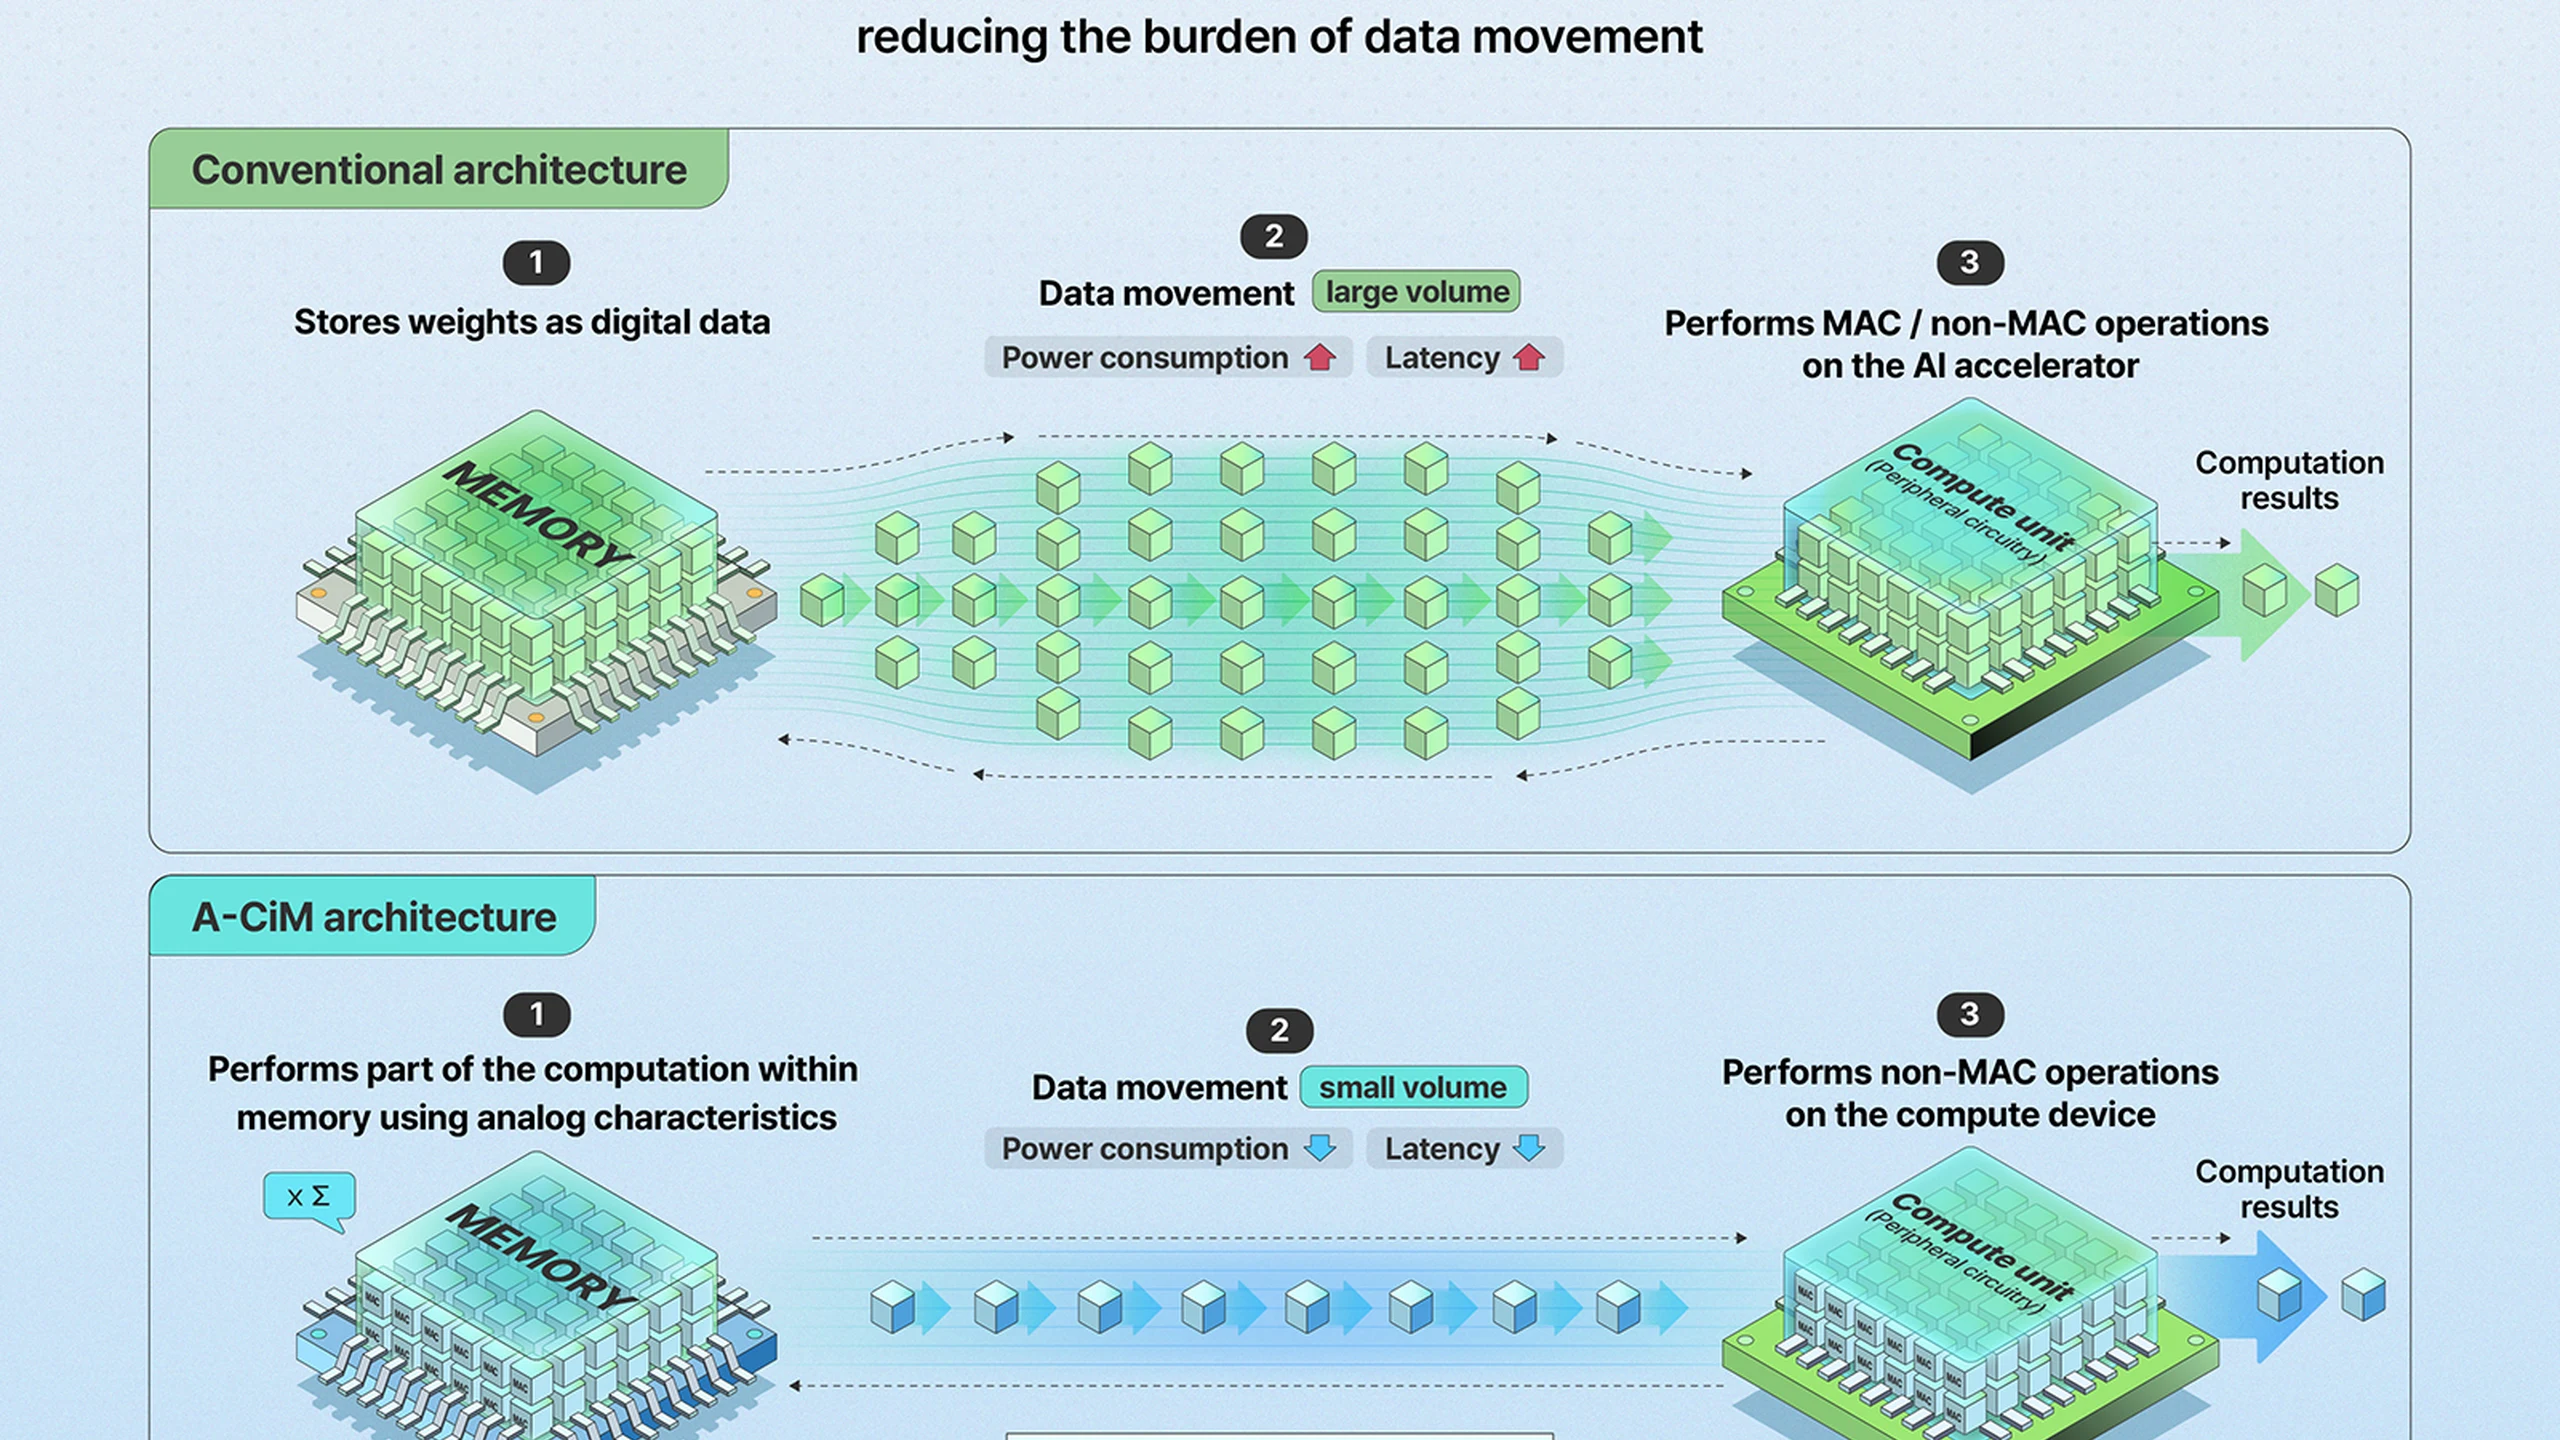
SK hynixが変えようとしているのは、NANDが保持できるデータ量だけではなく、AIの演算を行う場所だ。3D FeNANDの最新説明では、モデルの重みを垂直積層メモリー内に保持し、選択した積和演算をそこで実行する。別のプロセッサーへ何度も重みを送る必要を減らすことが、省エネルギーの源になる。
2026年10月14日の公開説明は、2025年12月のIEDMで発表した研究を扱う。大きな改善値は示したが、商用チップ、量産時期、顧客認定計画は発表していない。進歩の核心はセル、周辺制御、処理配置の協調設計であり、普通のSSDがGPUを置き換えるという話ではない。
二つの比較を一つの約束にしない
同社の説明によると、評価した負荷とチップ面積制約の下で、選択した従来の二次元アレイに対し、スループットは最大16倍、エネルギー効率は最大4,950倍となった。特定アーキテクチャーの比較であって、AIサーバー全体にそのまま当てはまる倍率ではない。
一方、技術要約は、従来の3D FeNANDを基準にする。この場合、協調最適化による改善はTOPSで20.4倍、TOPS/Wで7.17倍だ。TOPSは毎秒1兆回の演算、TOPS/Wは電力当たりの演算効率を表す。比較対象が違うため、両者を合算したり置き換えたりできない。
平面アレイとの比較で効率の改善が処理速度の改善を大きく上回り得る理由は、密度にある。より多くの重みを近くに保持すれば、再読み込み、書き直し、計算前後の待機が減る。ただし効果はモデルと配置に依存し、実運用システムの電気代が4,950分の1になったという測定ではない。
密度を有効な計算に変える三層の変更
FeNANDは電場を取り除いても残る強誘電分極を利用する。その状態でセル電流を制御し、複数の不揮発性の重みレベルを表す。商用3D NANDでは一般に、絶縁層に電子を閉じ込める電荷捕獲窒化膜が使われる。高密度なデジタル保存と、精密なアナログ電流制御では要求が異なる。
長い垂直ストリングには抵抗が加わる。電流が流れるとIRドロップ、つまり抵抗による電圧低下が生じ、アナログ状態間の間隔を圧縮し得る。状態が近いほど区別が難しいため、セルを増やすだけで正確な計算が増えるわけではない。
セルの最適化にはパルス数変調を使う。制御した連続書き込みパルスにより、低電流でIRドロップを考慮しながら状態を調整する。単にトランジスターを高速化するのではなく、多値書き込みを改善し、アナログ重みが使える電流範囲を確保する方法だ。
第二はセル以外の負担だ。セルを選択・制御するワード線の電圧を繰り返し変更すると、電力と時間がかかる。デュアルワード線活性化はその遷移を減らす。効率的なセルの周りで高コストの切り替えが続かないよう、制御回路も計算設計に含める。
第三はページ構成だ。ページ内パイプラインは複数のニューラルネットワーク層や選択した演算の複製を同一ページに置き、順方向の演算とワード線遷移を減らす。ページ分割では16 KBと4 KBを比較し、負荷に合わせる。大きすぎれば未使用回路を動かし、小さすぎれば演算回数が増え得る。
IEDMプログラムに載る論文がセル、非セル、ページの方式を結び付けるのはこのためだ。垂直方向の容量は、書き込み・切り替え・配置が実際の処理で利用できて初めて価値になる。
メモリーの壁がすべて消えるわけではない
インメモリー計算の研究では、データ移動が時間とエネルギーの大きな負担とされる。アナログアレイは電流を利用し、入力と保存した重みを乗算して並列に加算する。多数の重みを近くに置くことで、ストレージ、DRAM、キャッシュ、アクセラレーター間の転送を減らせる可能性がある。
重みが安定した推論は、初期用途として考えやすい。訓練では頻繁な更新、高い精度、柔軟な実行が必要になり、対応は難しくなる。HBMやGPUが不要になるわけではない。HBMが変化する活性値と一般的な転送を担い、高密度FeNAND層が適合する固定重みの演算を担う構成はあり得る。
他の方式にも別の妥協がある。SRAMは高速でロジック工程と相性がよいが、揮発性で面積を使う。RRAMクロスバーは可変抵抗を利用する一方、ばらつき、耐久性、変換コストが課題だ。相変化・磁気メモリーも密度、速度、信頼性を調整する。デジタルのニアメモリー演算は精度を予測しやすいが、効率改善は小さい場合がある。
IEDM 2025でMacronixは、LLM向け混合モード3D NANDストレージ内計算を示し、Qwen 2.5 Math 7BとMATH500で誤差を評価した。これは関連研究であり、SK hynixの結果を直接検証した比較ではない。以前のIEEEのFeNAND解説にある少なくとも256段階のコンダクタンスと対象課題で87.8%の精度も、現在の言語モデルや今回の新構成の精度を意味しない。
精度と周辺回路の費用が実効性能を決める
アナログの並列性は、デジタル的な確実性の一部と物理的効率を交換する。アナログ精度のレビューは、ノイズ、工程ばらつき、回路効果、変換誤差を扱う。補正で精度を上げても、そのための面積、時間、電力が節約分を消費し得る。
FeNANDでは垂直ストリング抵抗、隣接セル間の影響、しきい値ばらつきも管理する必要がある。強誘電体の保持、繰り返し書き込み耐性、ドリフト、温度感度が大規模アレイでも許容範囲に収まらなければならない。重みの段階数を増やすと隣接状態の余裕が狭まり、影響はさらに重要になる。
実用アクセラレーターでは、A/D変換器、入力供給、部分和の累積、スケジューリング、ホスト通信まで計上する必要がある。冷却と給電も費用に加わる。測定範囲が一致しなければ、アレイのTOPS/WとGPUシステム全体の測定は違う問いに答えている。
ソフトウェアも重要だ。コンパイラーは利用可能なページ、精度、電流レベルに演算を配置し、校正は有用な精度を保つ必要がある。注意機構、疎性、量子化の変化は新しい製造工程より速いかもしれない。元の負荷が変化しても使えるプログラム可能性が求められる。
製品化の根拠になる次の証拠
次に説得力があるのは、変換器と周辺ロジックを含む協調最適化チップを製造し、精度、処理量、エネルギーを併記することだ。複数の温度と複数チップでの測定が、有利な条件以外での再現性を示す。現行モデルでは規模、精度、重み更新、ページ配置、再読み込み頻度も開示する必要がある。
さらに強誘電体の工程統合、歩留まり、保持、耐久性を、開発ツール、アクセラレーター企業や評価基盤とともに示す必要がある。効率倍率だけでは代用できない。現時点の成果は専用推論に向けた研究の進歩であり、購入仕様ではない。
分野を追うチームは、論文とベンチマーク定義を検索可能な技術文書ナレッジベースに保存すると、比較の混同を防ぎやすい。決定的なのは、精度、ソフトウェア、周辺ハードウェアをすべて測っても高密度化が省エネルギーにつながるかだ。