
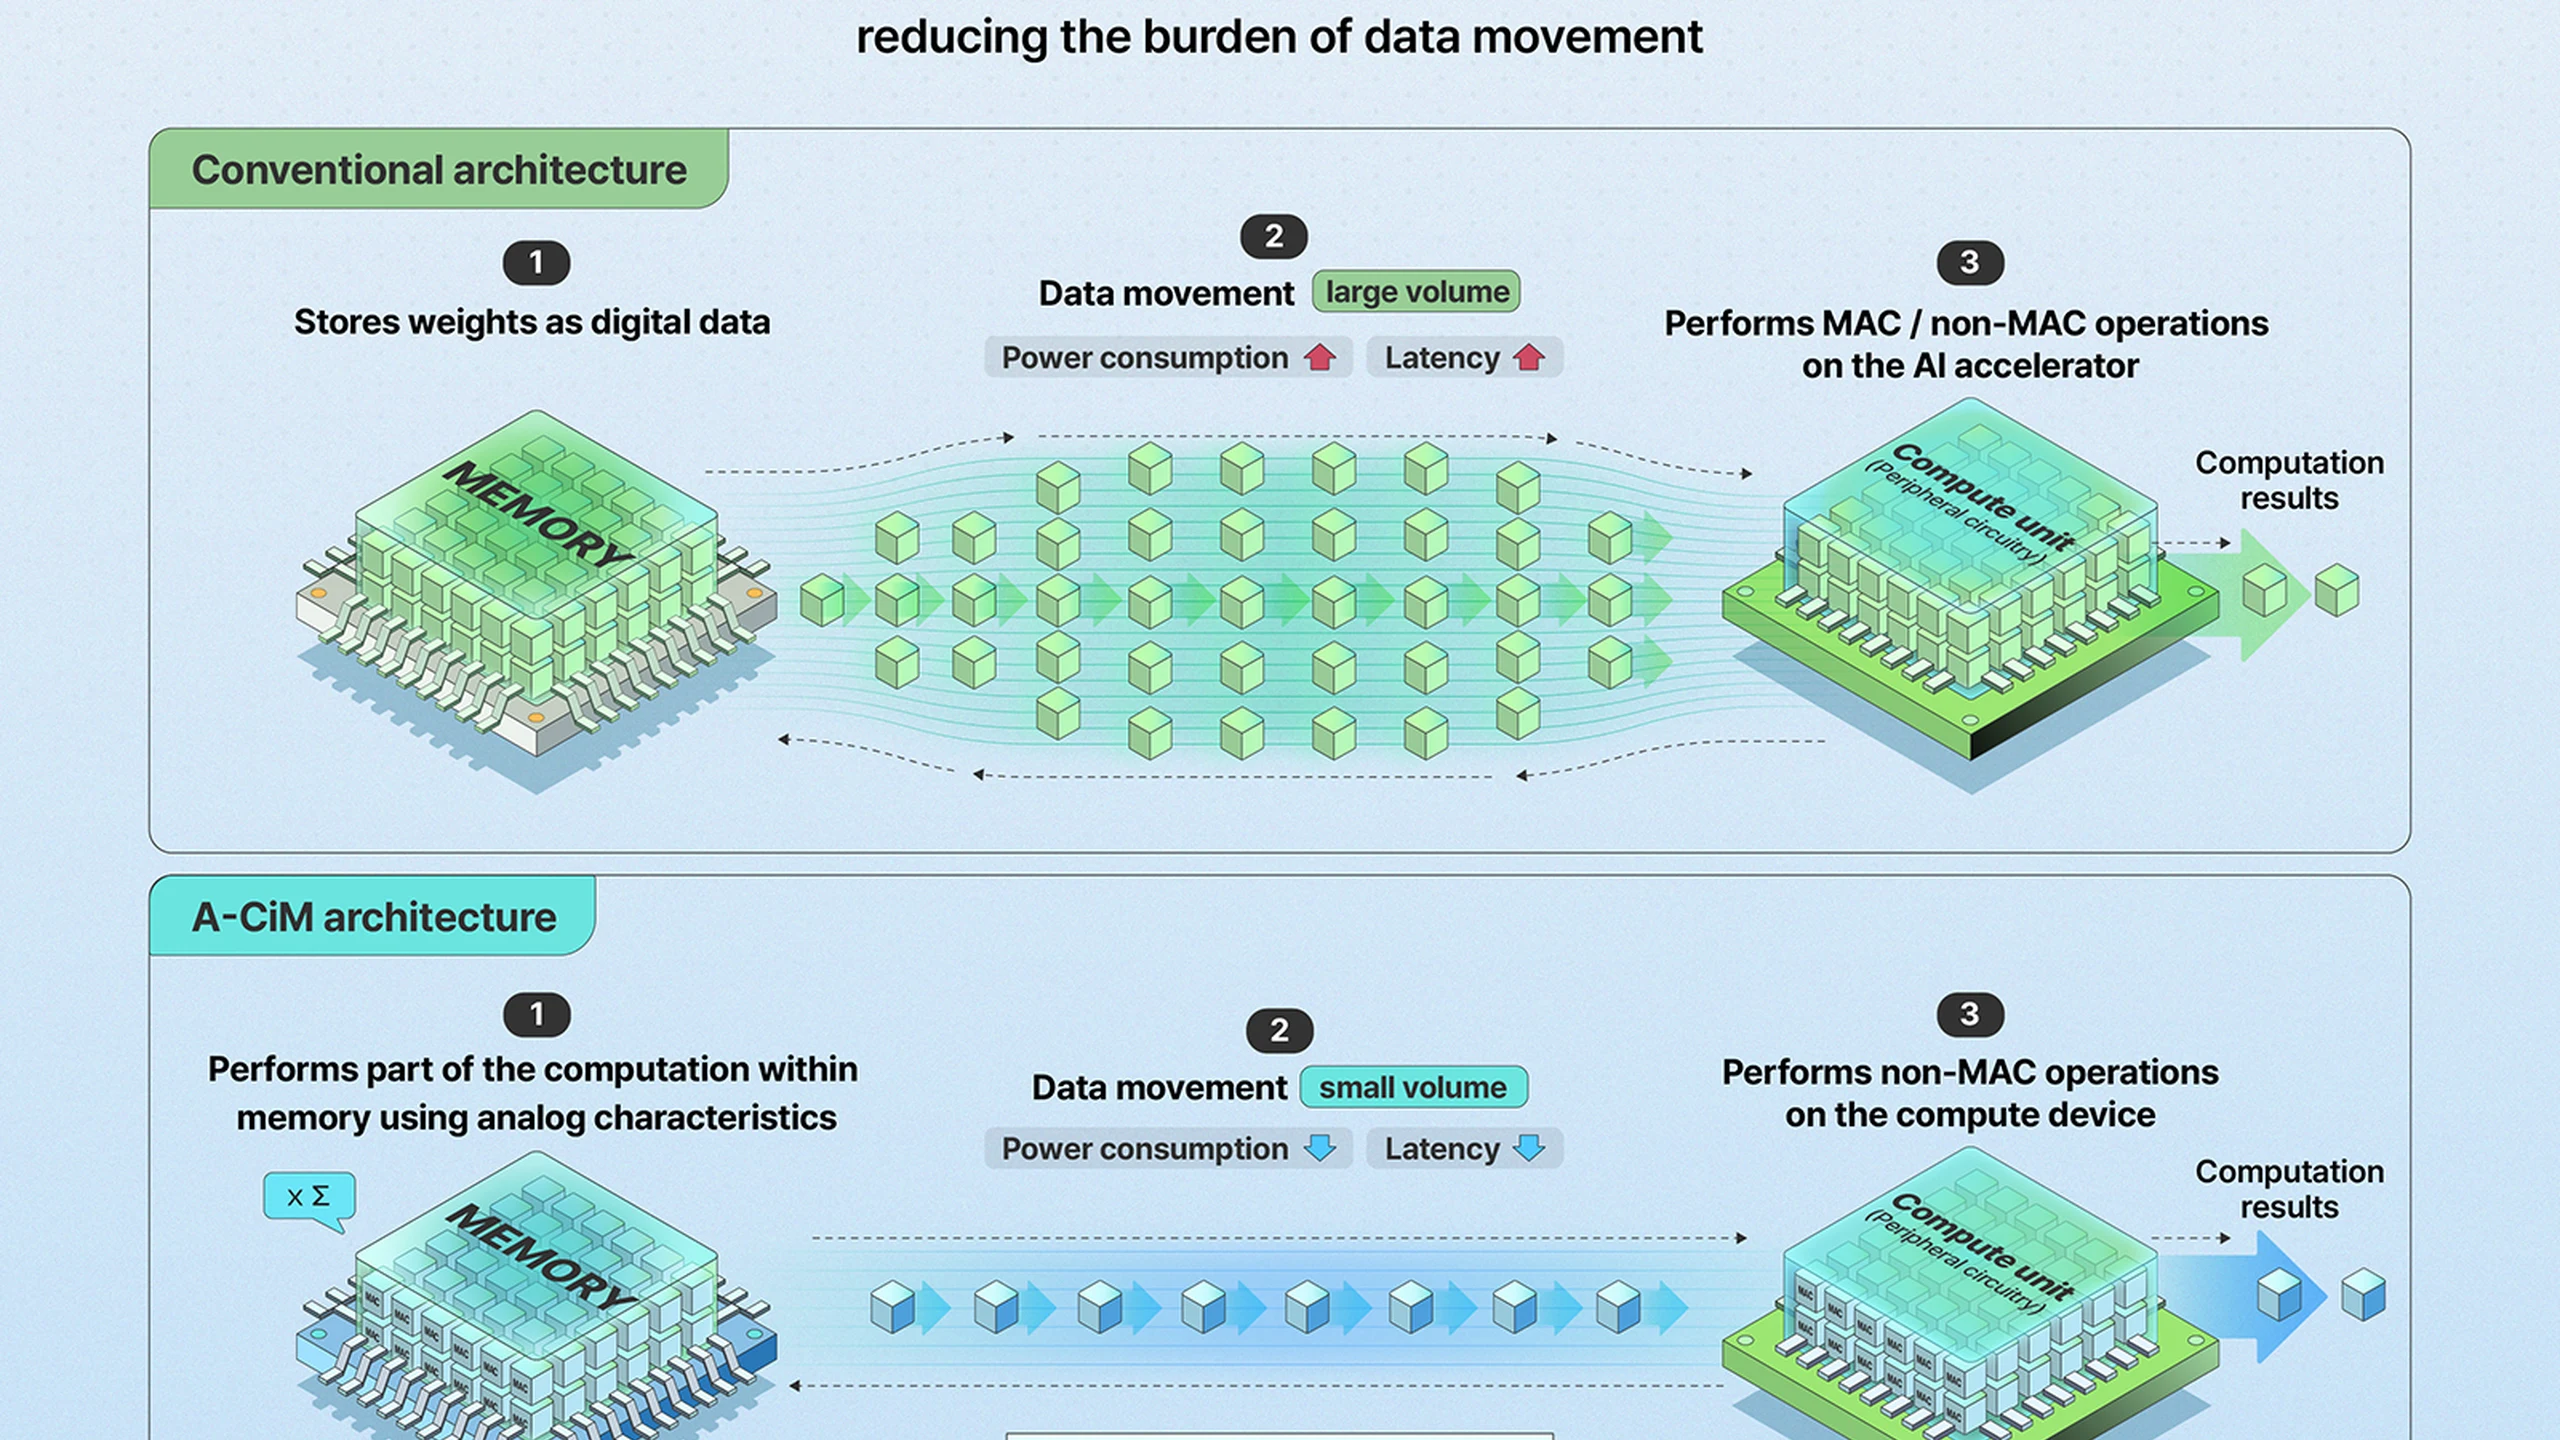
A SK hynix quer mudar onde a aritmética de IA acontece, não apenas quantos dados cabem na NAND. Sua explicação pública mais recente sobre 3D FeNAND descreve pesos de modelos mantidos em memória empilhada verticalmente, com algumas operações de multiplicação e acumulação realizadas ali. A economia potencial vem de evitar transferências repetidas para um processador separado.
O relato de 14 de outubro de 2026 detalha uma pesquisa apresentada na IEDM em dezembro de 2025. Os ganhos são expressivos, mas não há chip comercial, data de produção ou programa de qualificação de clientes anunciado. A novidade útil é coordenar células, controles de apoio e distribuição da carga, não afirmar que um SSD comum substitui uma GPU.
Duas comparações não formam uma promessa única
O relato da empresa informa até 16 vezes mais capacidade de processamento e 4.950 vezes mais eficiência energética que determinadas matrizes bidimensionais convencionais, na carga avaliada e sob restrição de área de chip. São comparações de arquiteturas, não multiplicadores universais para um servidor de IA completo.
Um resumo técnico usa outra referência: o projeto 3D FeNAND anterior. Frente a ele, a otimização conjunta trouxe 20,4 vezes mais TOPS e 7,17 vezes mais TOPS por watt. TOPS mede trilhões de operações por segundo; TOPS/W expressa eficiência energética. Essas bases não podem ser combinadas nem trocadas.
A densidade ajuda a explicar por que a melhoria energética diante de uma matriz plana pode superar muito o ganho de processamento. Com mais pesos locais, há menos recargas, regravações e espera ao redor do cálculo. A economia, porém, depende do modelo e do mapeamento; não demonstra uma conta de eletricidade 4.950 vezes menor em produção.
Três mudanças conectadas tornam a densidade utilizável
A FeNAND utiliza polarização ferroelétrica que permanece depois da remoção do campo elétrico. Esse estado controla a corrente da célula e representa vários níveis não voláteis de pesos. A NAND 3D comercial costuma usar nitreto de captura de carga, retendo elétrons numa camada isolante. Armazenamento digital denso e controle preciso de corrente analógica são requisitos distintos.
Uma cadeia vertical longa acrescenta resistência. A corrente gera uma queda IR, perda de tensão capaz de comprimir a separação entre estados analógicos. Estados próximos são mais difíceis de distinguir. Empilhar mais células não significa automaticamente obter mais cálculo correto.
No nível da célula, a SK hynix usa modulação do número de pulsos: uma sequência controlada de programação ajusta os estados sob correntes baixas, considerando a queda IR. Trata-se de programação multinível, não apenas de um transistor mais rápido. Ela melhora a faixa de corrente utilizável da qual os pesos analógicos dependem.
A segunda mudança ataca custos externos à célula. As linhas de palavra selecionam e controlam células; alterar repetidamente suas tensões consome energia e tempo. A ativação de duas linhas reduz essas transições. Incorporar os controles ao projeto de computação evita cercar uma célula eficiente de comutação cara.
A terceira é a organização das páginas. O processamento em pipeline dentro da página posiciona várias camadas neurais e cópias de operações selecionadas na mesma página, reduzindo operações de propagação e transições de linhas. A divisão compara uma página de 16 KB com organização de 4 KB para adequação à carga. Páginas grandes demais ativam circuitos sem uso; pequenas demais podem exigir operações extras.
Por isso, o artigo listado no programa da IEDM conecta célula, elementos externos e páginas. A capacidade vertical só tem valor se programação, comutação e mapeamento permitirem aproveitá-la em trabalho útil.
A barreira de memória não desaparece em toda tarefa
A literatura sobre computação na memória identifica a movimentação de dados como custo relevante de tempo e energia. Matrizes analógicas usam correntes físicas para multiplicar entradas pelos pesos armazenados e somar resultados em paralelo. Manter muitos pesos por perto pode reduzir tráfego entre armazenamento, DRAM, caches e acelerador.
Inferência com pesos estáveis é um primeiro destino plausível. Treinamento exige atualizações frequentes, precisão e execução flexível, mais difíceis de acomodar. HBM e GPUs não se tornam dispensáveis: a HBM pode atender ativações variáveis e tráfego geral, enquanto uma camada FeNAND densa executa operações adequadas com pesos fixos.
Outras abordagens têm compromissos diferentes. SRAM é rápida e compatível com processos lógicos, mas volátil e ocupa muita área. Matrizes cruzadas RRAM oferecem resistência programável, mas enfrentam variação, durabilidade e conversão. Memórias magnéticas e de mudança de fase também equilibram densidade, velocidade e confiabilidade; lógica digital próxima à memória oferece precisão mais previsível, talvez com ganhos energéticos menores.
Na IEDM 2025, a Macronix descreveu computação no armazenamento NAND 3D de modo misto para LLMs, usando Qwen 2.5 Math 7B e MATH500 para avaliar erros. É pesquisa vizinha, não comparação direta que valide os resultados da SK hynix. Da mesma forma, a visão anterior da IEEE sobre FeNAND relatou pelo menos 256 níveis de condutância e 87,8% de precisão na tarefa avaliada, não num modelo de linguagem atual ou nesta nova arquitetura.
Precisão e periféricos decidem o benefício real
O paralelismo analógico troca parte da certeza digital por eficiência física. Ruído, variação de processo, efeitos de circuito e erros de conversão afetam os resultados, como discute a revisão de precisão analógica. Correções podem aumentar a precisão consumindo a área, tempo ou energia que se desejava poupar.
A FeNAND também precisa controlar resistência de cadeias verticais, interações entre células vizinhas e variação de limiar de comutação. Retenção ferroelétrica, resistência a programações repetidas, deriva e sensibilidade térmica devem permanecer aceitáveis em matrizes grandes. Mais níveis de pesos estreitam a margem entre estados, tornando esses efeitos mais importantes.
Um acelerador utilizável deve incluir conversores analógico-digitais, entrega de entradas, acumulação de resultados parciais, escalonamento e comunicação com o processador principal. Resfriamento e alimentação somam custos. Sem fronteiras comparáveis, TOPS/W da matriz e medidas de um sistema GPU completo respondem perguntas diferentes.
O software é igualmente importante. Compiladores precisam mapear operações para páginas, precisão e níveis de corrente disponíveis; calibração deve manter exatidão útil. Atenção, esparsidade e quantização podem mudar mais rápido que os processos de fabricação. O projeto necessita programabilidade para continuar útil quando mudar a carga original.
O que transformaria a pesquisa num argumento de produto
A próxima prova convincente seria um chip fabricado com a otimização conjunta, informando precisão junto de desempenho e energia e incluindo conversores e lógica periférica. Medidas em várias temperaturas e chips mostrariam se o resultado sobrevive fora das condições favoráveis. Testes de modelos atuais devem revelar tamanho, precisão, atualizações de pesos, disposição das páginas e frequência de recarga.
Depois será necessário demonstrar integração ferroelétrica, rendimento de fabricação, retenção e durabilidade, com ferramentas de desenvolvimento e parceiro de aceleradores ou plataforma de avaliação. Nenhum multiplicador substitui esses marcos. O resultado atual é um avanço de pesquisa rumo à inferência especializada, não uma especificação de compra.
Equipes podem guardar artigos e definições de testes numa base de conhecimento de documentos técnicos para separar as comparações. A questão decisiva é se a densidade ainda economiza energia quando precisão, software e todo o hardware ao redor são medidos juntos.