
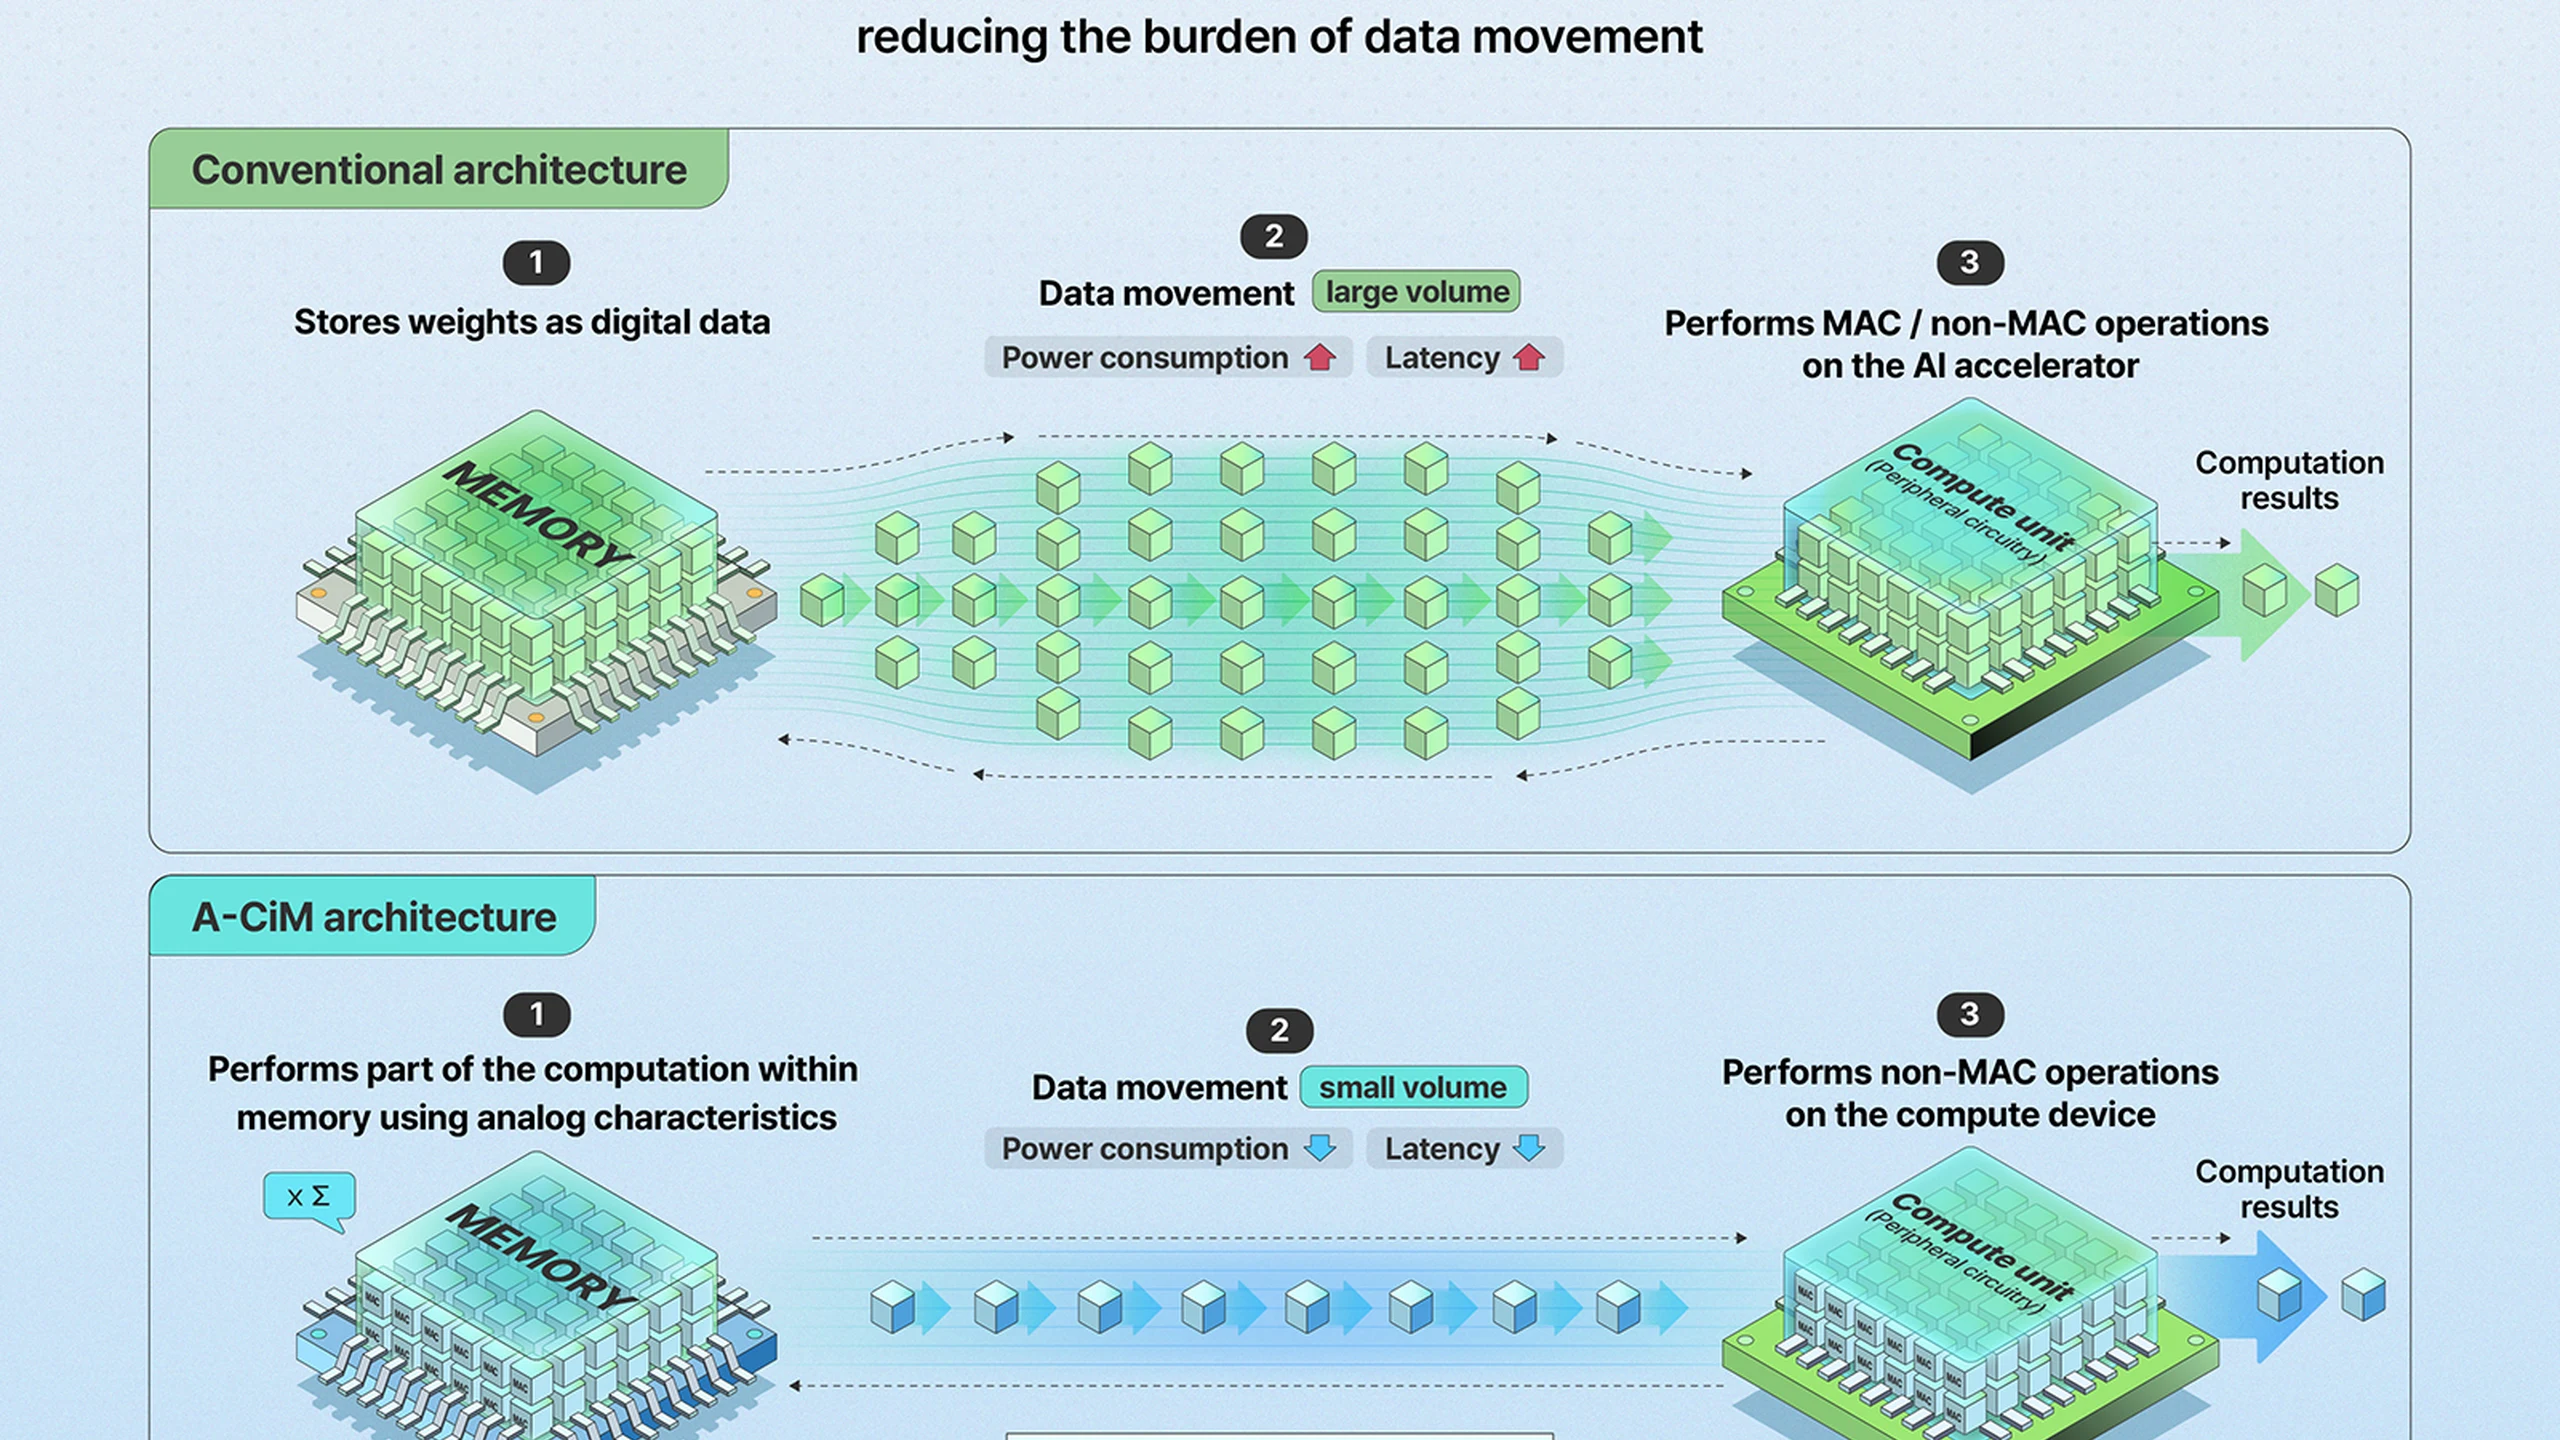
SK하이닉스가 바꾸려는 것은 NAND에 저장할 수 있는 데이터의 양뿐 아니라 AI 연산이 일어나는 위치다. 최신 3D FeNAND 설명은 모델 가중치를 수직 적층 메모리에 보관하고 일부 곱셈-누산 연산을 그 안에서 수행하는 방식을 다룬다. 별도 프로세서로 같은 가중치를 반복 전송하지 않는 데서 절감 효과가 나온다.
2026년 10월 14일 공개된 설명은 2025년 12월 IEDM에서 발표한 연구에 관한 것이다. 개선 폭은 크지만 상용 칩, 양산 날짜, 고객 인증 계획은 공개하지 않았다. 핵심 진전은 셀과 주변 제어, 작업 배치를 함께 설계했다는 것이지 일반 SSD가 GPU를 대체한다는 주장이 아니다.
서로 다른 두 비교를 하나의 약속으로 합칠 수 없다
회사 설명은 평가한 작업과 제한된 칩 면적 조건에서 특정 기존 2차원 어레이보다 처리량이 최대 16배, 에너지 효율이 최대 4,950배 높았다고 보고한다. 이는 특정 아키텍처끼리의 비교이며 AI 서버 전체에 일률적으로 적용할 수 있는 배수가 아니다.
기술 요약은 이전 3D FeNAND 설계를 별도 기준으로 삼는다. 그 설계 대비 공동 최적화로 TOPS는 20.4배, TOPS/W는 7.17배 개선됐다. TOPS는 초당 1조 회 연산, TOPS/W는 전력당 연산 효율을 뜻한다. 기준이 다르므로 두 비교를 합하거나 서로 바꿔 쓸 수 없다.
평면 어레이 대비 에너지 효율 개선이 처리량 개선보다 훨씬 클 수 있는 이유는 높은 밀도다. 더 많은 가중치를 가까이 저장하면 재로딩, 재기록, 계산 전후의 대기 시간이 줄어든다. 다만 절감 폭은 모델과 매핑에 달렸으며 실제 운영 시스템의 전기요금이 4,950분의 1이 됐다는 측정은 아니다.
밀도를 유용한 계산으로 바꾸는 세 가지 변화
FeNAND는 외부 전기장이 사라져도 남는 강유전체 분극을 이용한다. 이 상태로 셀 전류를 제어해 여러 비휘발성 가중치 수준을 표현한다. 상용 3D NAND는 보통 절연층에 전자를 가두는 전하 포획 질화막을 이용한다. 고밀도 디지털 저장과 정밀한 아날로그 전류 제어는 요구사항이 다르다.
긴 수직 스트링에는 저항이 생긴다. 전류가 흐르며 만드는 IR 강하, 즉 저항에 따른 전압 손실은 아날로그 상태 사이의 간격을 좁힐 수 있다. 서로 가까운 상태를 구별하기는 더 어렵다. 셀을 더 많이 쌓는다고 정확한 계산량도 자동으로 늘어나는 것은 아니다.
셀 단계에서는 펄스 수 변조를 적용한다. 제어된 프로그래밍 펄스를 연속으로 가해 낮은 전류와 IR 강하를 고려하면서 저장 상태를 조정한다. 단순히 더 빠른 트랜지스터를 만드는 것이 아니라 다중 수준 프로그래밍을 개선해 아날로그 가중치가 사용할 전류 범위를 확보하는 방법이다.
두 번째는 셀 밖의 비용이다. 워드라인은 셀을 선택하고 제어하며 전압을 반복 변경할 때 전력과 시간이 든다. 이중 워드라인 활성화는 이러한 전환 부담을 줄인다. 효율적인 셀 주변에서 비싼 스위칭이 계속되지 않도록 제어 회로도 연산 설계에 포함하는 것이다.
세 번째는 페이지 구성이다. 페이지 내 파이프라이닝은 여러 신경망 층과 일부 연산의 복제본을 같은 페이지에 놓아 순방향 연산과 워드라인 전환을 줄인다. 페이지 분할에서는 16 KB와 4 KB 구성을 비교해 작업에 맞춘다. 너무 큰 페이지는 쓰지 않는 회로까지 켜고, 너무 작으면 연산 횟수가 늘 수 있다.
IEDM 프로그램에 실린 논문이 셀·비셀·페이지 방식을 연결하는 이유다. 수직 적층의 용량은 프로그래밍, 스위칭, 배치가 실제 작업에서 이를 활용하도록 해 줄 때 가치가 있다.
메모리 장벽이 모든 작업에서 사라지는 것은 아니다
메모리 내 연산 문헌은 데이터 이동 자체에 상당한 시간과 에너지가 든다고 설명한다. 아날로그 어레이는 물리적 전류로 입력과 저장된 가중치를 곱하고 결과를 병렬로 더한다. 많은 가중치를 가까이 두면 저장장치, DRAM, 캐시, 가속기 사이의 전송을 줄일 가능성이 생긴다.
가중치가 안정적인 추론은 초기 적용 대상으로 합리적이다. 학습은 빈번한 갱신, 높은 정밀도, 유연한 실행이 필요해 더 까다롭다. HBM과 GPU가 불필요해지는 것도 아니다. HBM은 바뀌는 활성값과 일반 가속기 트래픽을 처리하고 고밀도 FeNAND 계층은 적합한 고정 가중치 연산을 맡을 수 있다.
다른 방식에도 각자의 절충이 있다. SRAM은 빠르고 로직 공정과 호환되지만 휘발성이며 면적을 많이 차지한다. RRAM 크로스바는 가변 저항을 쓰지만 소자 편차, 내구성, 변환 비용이 문제다. 상변화·자기 메모리도 밀도와 속도, 신뢰성을 조정한다. 디지털 근접 메모리 연산은 정밀도를 더 예측하기 쉽지만 효율 향상은 작을 수 있다.
IEDM 2025에서 Macronix는 LLM용 혼합 모드 3D NAND 저장장치 내 연산을 설명하고 Qwen 2.5 Math 7B와 MATH500으로 오차를 평가했다. 이는 인접 연구이지 SK하이닉스 결과를 직접 검증한 비교가 아니다. 이전 IEEE FeNAND 개요의 최소 256개 전도도 수준과 평가 과제 정확도 87.8%도 현재 언어모델이나 이번 새 아키텍처의 정확도를 뜻하지 않는다.
정확도와 주변 회로 비용이 실제 이득을 결정한다
아날로그 병렬성은 디지털의 확실성 일부를 물리적 효율과 맞바꾼다. 아날로그 정확도 리뷰는 잡음, 공정 편차, 회로 효과, 변환 오차를 다룬다. 보정으로 정밀도를 높여도 그 과정에서 절약하려던 면적과 시간, 에너지가 다시 소모될 수 있다.
FeNAND는 수직 스트링 저항, 인접 셀 간 상호작용, 스위칭 문턱값 편차도 관리해야 한다. 강유전체의 보존 특성, 반복 프로그래밍 내구성, 드리프트와 온도 민감성이 대규모 어레이에서도 허용 범위여야 한다. 가중치 수준을 늘릴수록 인접 상태 간 여유가 줄어 이 문제는 더 중요해진다.
배치 가능한 가속기는 아날로그-디지털 변환기, 입력 전달, 부분합 누적, 스케줄링, 호스트 통신까지 비용에 넣어야 한다. 냉각과 전력 공급 비용도 추가된다. 측정 경계가 다르면 어레이 수준 TOPS/W와 GPU 시스템 전체 측정은 서로 다른 질문에 답한다.
소프트웨어도 중요하다. 컴파일러는 사용 가능한 페이지와 정밀도, 전류 수준에 맞춰 연산을 배치해야 하며 교정은 유용한 정확도를 유지해야 한다. 어텐션 기법과 희소성, 양자화 변화는 새 제조 공정보다 빠를 수 있다. 처음 대상으로 삼은 작업이 바뀌어도 쓸 수 있는 프로그래밍 가능성이 필요하다.
연구가 제품의 근거가 되려면
다음으로 설득력 있는 증거는 변환기와 주변 로직을 포함해 공동 최적화한 칩을 제작하고 정확도, 처리량, 에너지를 함께 보고하는 것이다. 여러 온도와 여러 칩의 측정은 유리한 조건 밖에서도 결과가 유지되는지 보여 준다. 최신 모델 시험에서는 규모와 정밀도, 가중치 갱신, 페이지 배치, 재로딩 빈도도 공개해야 한다.
제조 측면에서는 강유전체 공정 통합, 수율, 보존성과 내구성의 증거에 개발 도구, 가속기 협력사 또는 평가 플랫폼이 더해져야 한다. 효율 배수만으로 이런 이정표를 대신할 수 없다. 현재 성과는 특수 추론을 향한 연구 진전이지 구매 사양서가 아니다.
분야를 추적하는 팀은 논문과 벤치마크 정의를 검색 가능한 기술 문서 지식베이스에 보관해 서로 다른 비교를 구분할 수 있다. 결정적인 질문은 정확도와 소프트웨어, 주변 하드웨어를 모두 측정해도 높은 밀도가 에너지를 절약하는지다.