
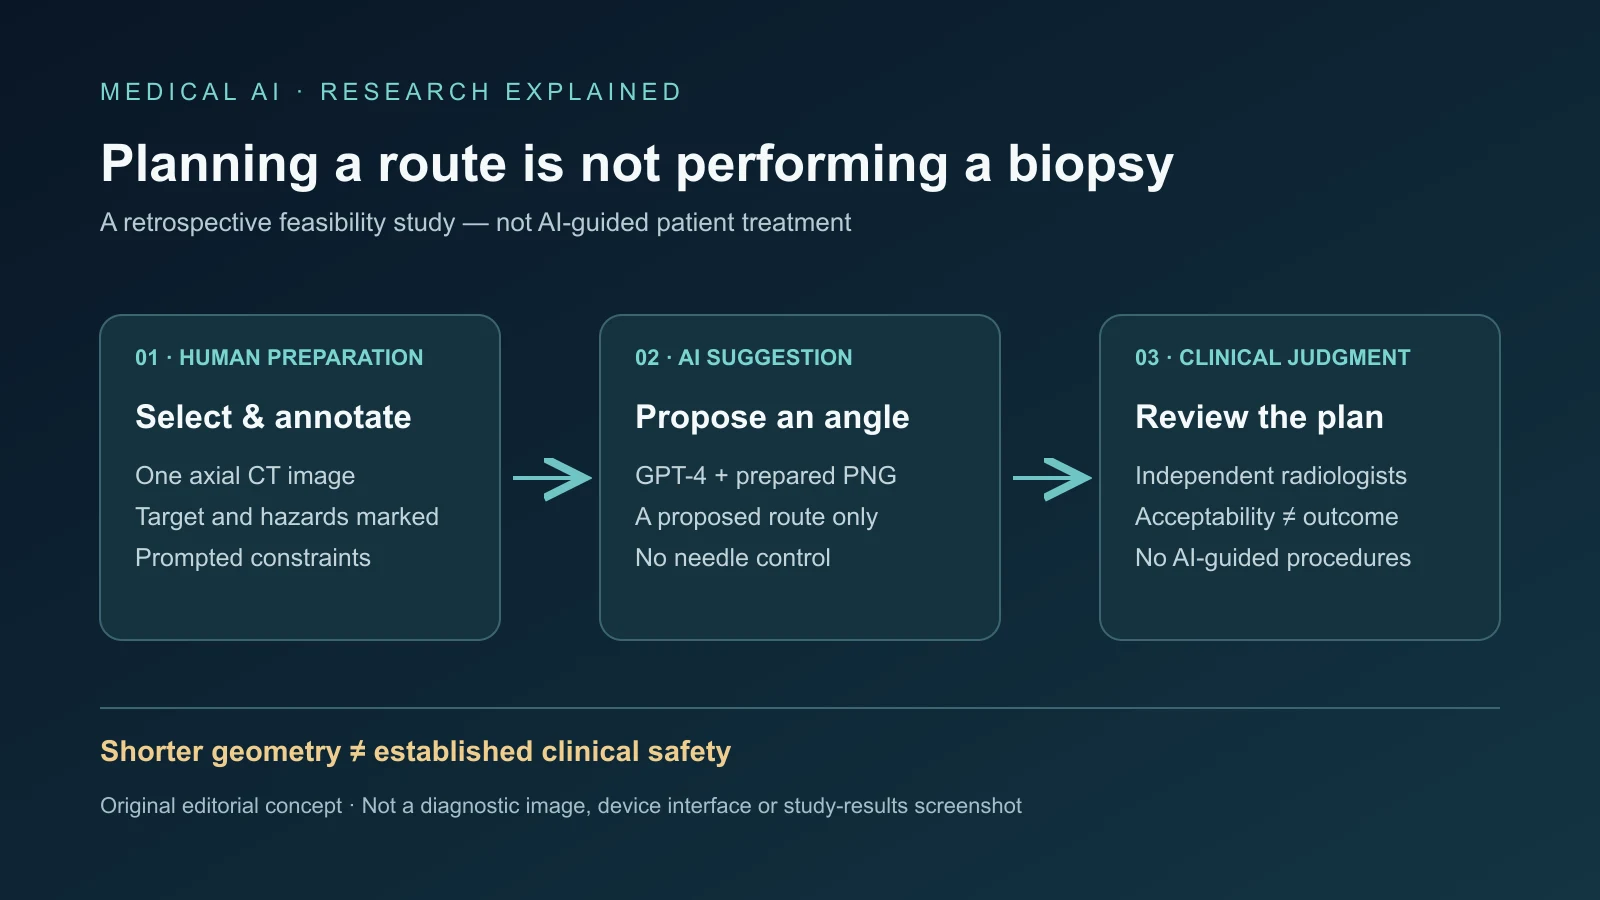
Ein retrospektives Experiment am Memorial Sloan Kettering Cancer Center zeigte, dass GPT-4 aus sorgfältig vorbereiteten CT-Bildern plausible Einstichwinkel vorschlagen konnte. Unabhängige Radiologen hielten 28 von 30 Wegen, also 93,3 Prozent, für angemessen. Die vorgeschlagenen Wege durchquerten im Median 5 Millimeter Lungengewebe, gegenüber 23 Millimetern bei bereits von erfahrenen Ärzten verwendeten Wegen.
Das sind Machbarkeitsergebnisse, keine Belege für sicherere Biopsien. Kein Patient wurde nach den KI-Vorschlägen behandelt. Zwei Pläne scheiterten an der Prüfung: Einer durchquerte viermal so viel Lungengewebe wie der manuelle Weg, ein anderer weckte Bedenken zur Nadelstabilität. Der Fortschritt ist eine überprüfbare Planungshypothese, kein autonomer Navigator und keine nachgewiesene Verringerung von Komplikationen.
Vor jedem Vorschlag stand Expertenarbeit
Die frei zugängliche Studie in CVIR Oncology verwendete 30 aufeinanderfolgende historische Eingriffe dreier interventioneller Radiologen mit jeweils mindestens zehn Jahren Erfahrung. Die deidentifizierte Gruppe umfasste 17 Männer und 13 Frauen, das mediane Alter betrug 65 Jahre. Knoten maßen 5–45 Millimeter, im Median 21. Darunter waren fünf apikale, sieben subpleurale, drei paramediastinale und vier lungenbasisnahe Läsionen mit unterschiedlichen anatomischen Herausforderungen.
Ein Forscher wählte einen axialen CT-Schnitt, beschnitt und vergrößerte ihn und ergänzte in GIMP ein radiales Raster, bevor das medizinische Bild in PNG umgewandelt wurde. Ein Autor markierte das Ziel blau und empfindliche Strukturen rot. Das Modell erhielt also ein Bild, dessen Ziel und Gefahren bereits Menschen erkannt hatten, keine unveränderte Untersuchung zur selbstständigen anatomischen Erkennung.
Ein standardisierter Prompt gab fünf Kriterien vor: Ziel erreichen, Lungengewebe möglichst wenig durchqueren und Knochen, Fissuren sowie Mediastinum vermeiden. Jeder Fall begann in einem neuen Chat. Bei fehlenden Bedingungen durften die Forscher nachfragen und erfassten die erste Antwort mit allen verlangten Parametern. Der Median lag bei zwei Iterationen, der Interquartilsabstand bei einer bis drei.
Zwei erfahrene interventionelle Radiologen, die nicht an den ursprünglichen Eingriffen beteiligt waren, bewerteten die Wege unabhängig und verblindet hinsichtlich ihrer Herkunft. Getestet wurde ein plausibler Winkel nach erheblicher menschlicher Vorbereitung, nicht autonome Segmentierung, vollständige dreidimensionale Planung, Live-Navigation oder robotische Nadelsteuerung. Fachärzte blieben im gesamten Ablauf erforderlich.
Kürzere Linien bedeuteten keine besseren klinischen Ergebnisse
GPT-4s mediane Lungenstrecke betrug 5 Millimeter bei einem Interquartilsabstand von 0–25; manuell waren es 23 beziehungsweise 5–57 Millimeter. Die berichtete Differenz war statistisch signifikant, p=0,0063. Null Millimeter traten bei subpleuralen Läsionen an der Pleuraoberfläche auf, die direkt ohne normales Lungenparenchym erreichbar sein können. Die Länge bleibt dennoch nur ein Teil des Eingriffsrisikos.
Der mittlere Einstichwinkel lag bei 179 Grad gegenüber 174 Grad manuell, ohne statistisch signifikante Differenz. Ähnliche Gruppenmittel verdeckten erhebliche Einzelfallunterschiede. Die Hauptergebnisse berichteten nur acht gute Übereinstimmungen, definiert durch Winkel innerhalb von zehn Grad und ähnliche Gewebeebenen. An anderer Stelle nannten die Autoren unter einer strengeren Auslegung drei Übereinstimmungen. Diese Zahlen dürfen nicht stillschweigend zu einer Quote vereinheitlicht werden.
Wichtig ist die ungleiche Vergleichsbasis: Die ärztlichen Wege waren erfolgreich an Patienten ausgeführt worden, die Modellwege blieben Linien auf Planungsbildern. Eine überzeugende Linie in einem axialen Schnitt kann in benachbarten Schichten unbrauchbar sein. Atmung, Körperlage, Verankerung, Gerätegrenzen und veränderliche Anatomie bestimmen die tatsächliche Nutzbarkeit mit.
Bei den ursprünglichen Eingriffen gab es keine schweren Komplikationen. Vier Patienten hatten minimale, ohne Behandlung abklingende Pneumothoraces, zwei leichte, selbstlimitierende Hämoptysen. Diese Ergebnisse gehören zu den ärztlich geführten Eingriffen, nicht zu GPT-4. Die Studie simulierte keine Veränderung durch alternative Wege und kann die diagnostische Ausbeute niemals verwendeter Wege nicht bestimmen.
Die beiden Fehler zeigen konkurrierende Bedingungen
In Fall 19 schlug GPT-4 20 Millimeter Lungenstrecke vor, gegenüber 5 Millimetern manuell: viermal so viel und entgegen dem Minimierungsziel. Es gab außerdem einen breiten Winkelbereich statt eines präzisen bevorzugten Plans an. Die Prüfer hielten den Weg theoretisch für möglich, aber nicht für gute klinische Praxis. Das Vermeiden offensichtlicher Hindernisse genügte nicht.
Fall 27 betraf einen subpleuralen Knoten. Der Vorschlag durchquerte unnötig 5 Millimeter Lunge und warf Stabilitätsfragen auf. Zu wenig Kontakt mit stützendem Gewebe kann eine koaxiale Biopsienadel unzureichend verankern und während der Probenentnahme Bewegung oder Verrutschen begünstigen. Minimale Gewebestrecke und sichere Fixierung sind nicht immer dasselbe Ziel.
Die zweidimensionale Darstellung erfasste weder Strukturen oberhalb oder unterhalb der Ebene noch den vollständigen dreidimensionalen Verlauf. Radiologen prüfen normalerweise mehrere Schichten und multiplanare Rekonstruktionen. GPT-4 erkannte nicht selbstständig alle Läsionen, segmentierte keine Organe und bestimmte Sicherheitsabstände nicht zuverlässig. Ein festgelegter Mindestabstand von fünf Millimetern zu subklavialen und axillären Gefäß-Nerven-Bündeln fehlte ebenfalls, weil die Patientenlagerung diese von den untersuchten Wegen fernhielt. Künftige Systeme dürfen dies nicht voraussetzen.
Nachfragen waren nicht vollständig geskriptet, sodass verschiedene Nutzer dasselbe Bild unterschiedlich lenken konnten. Getrennte Chats minderten fallübergreifende Kontamination, bewiesen aber keine Wiederholbarkeit desselben Winkels bei identischen Fällen. Allgemeine KI-Dienste ändern sich zudem: Validierung muss an eine kontrollierte Modellversion, definierte Eingaben und dokumentierte Verfahren gebunden sein, statt automatisch für spätere Konfigurationen zu gelten.
Spezialplaner liefern Kontext statt einer Rangliste
Eine spezialisierte Studie von 2024 verband dreidimensionale Läsionserkennung mit bayesscher Trajektorienoptimierung. Trainiert wurde mit 2.147 Knoten aus 219 Scans, die Erkennung zusätzlich mit 235 Scans und 354 Läsionen validiert. Die berichtete Erkennungs-AUROC betrug 97,4 Prozent, mittlere Sensitivität 93,5 und Spezifität 93,2 Prozent. Das sind Erkennungsmaße, keine Anteile klinisch erfolgreicher Biopsien.
Der Wegvergleich umfasste 150 Patienten; eine Winkeldifferenz unter fünf Grad galt als Übereinstimmung. In 85,3 Prozent der bewerteten Fälle entstanden machbare Wege, 82 Prozent entsprachen unter dieser Definition tatsächlichen Wegen, mit durchschnittlich 2,30 Grad Abweichung unter den Übereinstimmungen. Die Software erledigte dreidimensionale Segmentierung und Erkennung, die GPT-4 nicht ausführte, blieb jedoch retrospektiv und ohne nachgewiesenen Patientennutzen.
Ein regelbasierter Machbarkeitsnachweis von 2023 erzeugte je fünf Wege für 28 Patienten. Vier erfahrene Ärzte bewerteten 140 Wege; Computer- und Arztbewertungen waren in 57,9 Prozent identisch, und alle 28 algorithmisch ausgewählten besten Wege galten als sicher. Das war Prüferurteil, kein Nachweis klinisch verringerter Komplikationen.
TRAX, der Trajectory Recommendation Algorithm for CT-guided Biopsy, ordnet rund 20.000 Wege, nachdem ein Arzt das Ziel festgelegt hat. Bei einem Vergleich mit 53 Patienten hielten verblindete Prüfer alle KI- und arztgewählten Wege für sicher. In 58 Prozent waren Bewertungen gleich, 23 Prozent bevorzugten TRAX und 19 Prozent den Arztweg, ohne statistisch signifikanten Präferenzunterschied. TRAX-Wege waren etwas kürzer; die Hälfte verlief schräg, während 81,1 Prozent der Arztwege axial waren.
Eingaben, Datensätze, Definitionen und Winkelschwellen unterschieden sich. Die Prozentsätze erlauben keine direkte Systemrangliste. Spezialplaner können anatomische Regeln kodieren, Abstände messen und viele Optionen konsistent ordnen. Allgemeine multimodale Modelle sind flexibel, hängen aber stark von Vorbereitung und Prompts ab. Auch als Entscheidungshilfe brauchen sie eine Oberfläche, die Vorschläge von freigegebenen Plänen trennt sowie vollständigen Verlauf und menschliche Prüfung dokumentiert.
Was eine stärkere Validierung zeigen müsste
Identische Fälle wiederholt auszuführen und Prompts vollständig zu standardisieren, würde die Konsistenz prüfen. Studien sollten Häufigkeit und Ausmaß menschlicher Korrekturen erfassen. Eine native CT-Gesamtvolumenanalyse müsste Läsionen, Lungen, Gefäße, Rippen, Fissuren, Mediastinum und weitere relevante Strukturen segmentieren, explizite Abstände bestimmen und den ganzen Weg darstellen. Die Kombination mit Segmentierungssoftware schafft separat zu validierende Integrationsrisiken.
Externe multizentrische Daten müssen Scanner, Rekonstruktionen, Lagerungen und Läsionsorte jenseits eines Krebszentrums abdecken. Prospektive Tests könnten im Schattenmodus beginnen, ohne die Versorgung zu verändern. Spätere kontrollierte Studien könnten KI-unterstützte mit üblicher Planung vergleichen, bei fachärztlicher Letztverantwortung, und diagnostische Ausbeute, Pneumothorax, Blutungen, Dauer, Strahlenbelastung, Neupositionierungen und Erholung messen.
Fehler sind gesondert zu berichten, nicht durch Mittelwerte zu verdecken. Direkte robotische Ausführung verlangte wesentlich stärkere Belege und Geräteaufsicht. Die 30 Fälle mit 28 akzeptablen Plänen und 18 Millimetern weniger medianer Lungenstrecke rechtfertigen weitere Experimente. Zusammen mit manuellen Markierungen, improvisierten Nachfragen, zwei verworfenen Wegen und fehlenden KI-geführten Patientenergebnissen rechtfertigen sie weder sofortigen klinischen Einsatz noch die Behauptung, kürzere Chatbot-Linien machten Biopsien sicherer.
Quellen
GPT-4-Machbarkeitsstudie · 3D-Planungsstudie · Regelbasierte Planungsstudie · TRAX-Vergleich · Index des Ausgangsberichts