
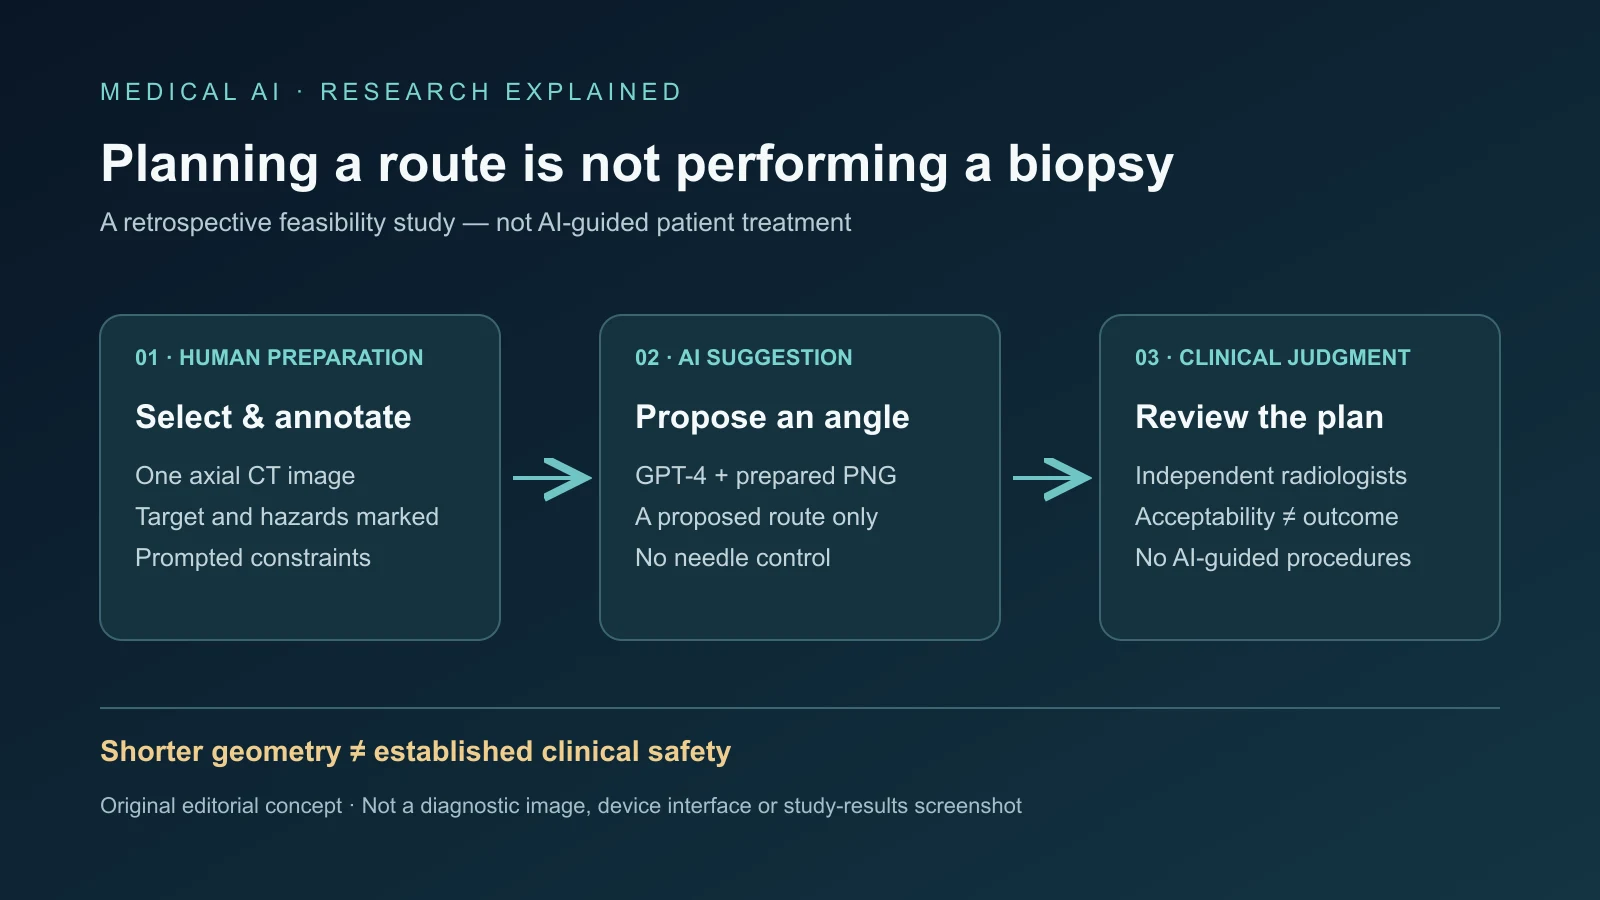
Un esperimento retrospettivo al Memorial Sloan Kettering Cancer Center ha mostrato che GPT-4 poteva proporre angoli d'ingresso plausibili da immagini TC accuratamente preparate. Radiologi indipendenti hanno giudicato adeguate 28 traiettorie su 30, il 93,3 per cento. I percorsi proposti attraversavano una mediana di 5 millimetri di tessuto polmonare, contro 23 per quelli già usati da clinici esperti.
Sono risultati di fattibilità, non prove di biopsie più sicure. Nessun paziente ha subito una procedura guidata dalle proposte dell'IA. Due piani non hanno superato la revisione: uno attraversava quattro volte il tessuto del percorso manuale, l'altro sollevava dubbi sulla stabilità dell'ago. Il progresso utile è un'ipotesi verificabile di pianificazione, non un navigatore autonomo o una riduzione dimostrata delle complicanze.
Ogni raccomandazione seguiva una preparazione esperta
Lo studio ad accesso aperto in CVIR Oncology ha usato 30 procedure storiche consecutive svolte da tre radiologi interventisti, ciascuno con almeno dieci anni di esperienza. La coorte deidentificata comprendeva 17 uomini e 13 donne, età mediana 65 anni. I noduli misuravano 5–45 millimetri, mediana 21. Le sedi includevano cinque lesioni apicali, sette subpleuriche, tre paramediastiniche e quattro presso la base polmonare, con difficoltà anatomiche differenti.
Un ricercatore selezionava una sezione assiale, la ritagliava e ingrandiva e aggiungeva una griglia radiale in GIMP prima di convertire l'immagine medica in PNG. Un autore segnava il bersaglio in blu e le strutture sensibili in rosso. Il modello riceveva quindi un'immagine in cui persone avevano già identificato bersaglio e rischi, non un esame intatto da interpretare autonomamente.
Il prompt standard forniva cinque criteri: raggiungere il bersaglio, minimizzare il tessuto polmonare attraversato ed evitare ossa, scissure e mediastino. Ogni caso iniziava in una nuova chat. Si potevano aggiungere richieste se mancava una condizione, registrando la prima risposta con tutti i parametri. La mediana era due iterazioni, intervallo interquartile da una a tre.
Due radiologi interventisti esperti, non coinvolti negli interventi originali, valutavano indipendentemente i percorsi senza conoscerne l'origine. Si testava un angolo plausibile dopo notevole preparazione umana, non segmentazione autonoma, pianificazione tridimensionale completa, navigazione in tempo reale o controllo robotico dell'ago. Gli specialisti restavano necessari nell'intero processo.
Linee più corte non equivalevano a esiti clinici migliori
La mediana di attraversamento polmonare di GPT-4 era 5 millimetri, intervallo interquartile 0–25, contro 23 e 5–57 per i percorsi manuali. La differenza riportata era statisticamente significativa, p=0,0063. L'attraversamento nullo riguardava lesioni subpleuriche accanto alla superficie pleurica, raggiungibili direttamente senza parenchima normale. La lunghezza resta però solo una componente del rischio.
L'angolo medio proposto era 179 gradi contro 174 per le vie manuali, senza differenza significativa. Medie simili nascondevano forti differenze nei singoli casi. I risultati principali riportavano buona concordanza in appena otto casi, con angoli entro dieci gradi e passaggio simile nei piani tissutali. Altrove gli autori descrivevano un'interpretazione più severa con tre corrispondenze. Non si devono fondere silenziosamente questi conteggi in un unico tasso.
Il confronto era diseguale: i percorsi clinici erano stati eseguiti con successo sui pazienti, quelli del modello restavano linee sulle immagini. Una linea convincente in una sezione assiale può essere impraticabile nelle sezioni vicine. Respirazione, posizione, ancoraggio, limiti degli strumenti e anatomia variabile influiscono sull'uso reale.
Le procedure originali non avevano complicanze maggiori. Quattro pazienti presentarono pneumotorace minimo risolto senza intervento, due emottisi lieve e autolimitante. Questi esiti appartengono alle procedure cliniche, non a GPT-4. Non fu simulato se le alternative li avrebbero cambiati, né si può determinare la resa diagnostica di vie mai utilizzate.
I due fallimenti mostrano vincoli concorrenti
Nel Caso 19, GPT-4 proponeva 20 millimetri di polmone contro 5 manualmente: quattro volte tanto, contraddicendo l'obiettivo di minimizzazione. Offriva anche un ampio intervallo di angoli anziché un piano preferito preciso. I revisori giudicarono il percorso teoricamente fattibile ma non conforme alla buona pratica clinica. Evitare ostacoli evidenti non bastava.
Il Caso 27 riguardava un nodulo subpleurico. La proposta attraversava inutilmente 5 millimetri di polmone e poneva dubbi di stabilità. Un contatto troppo ridotto con il tessuto di sostegno può ancorare insufficientemente un ago coassiale, favorendo movimento o dislocazione durante il prelievo. Minimizzare distanza e fissare l'ago non sono sempre lo stesso obiettivo.
L'impostazione bidimensionale non rappresentava strutture sopra o sotto il piano né l'intero tragitto tridimensionale. I radiologi normalmente esaminano più sezioni e ricostruzioni multiplanari. GPT-4 non individuava autonomamente tutte le lesioni, non segmentava organi e non definiva margini affidabili. Lo studio ometteva anche un margine minimo specificato di cinque millimetri dai fasci neurovascolari succlavi e ascellari perché la posizione dei pazienti li teneva lontani dai tragitti. I sistemi futuri non possono presumere tale condizione.
Le richieste successive non erano completamente prestabilite, quindi utenti diversi potevano indirizzare la stessa immagine verso risposte diverse. Sessioni separate riducevano contaminazioni tra casi, senza dimostrare la ripetibilità dello stesso angolo sul medesimo caso. Gli aggiornamenti dei servizi generali aggiungono incertezza: la validazione deve riferirsi a versione controllata, input definiti e processo documentato, non trasferirsi automaticamente a configurazioni successive.
I pianificatori specializzati offrono contesto, non una classifica
Uno studio dedicato del 2024 combinava rilevamento tridimensionale delle lesioni e ottimizzazione bayesiana delle traiettorie. Era addestrato su 2.147 noduli da 219 scansioni, con validazione del rilevamento su altre 235 scansioni e 354 lesioni. L'AUROC riportata era 97,4 per cento, sensibilità media 93,5 e specificità 93,2. Sono metriche di rilevamento, non percentuali di biopsie clinicamente riuscite.
Il confronto delle traiettorie riguardava 150 pazienti e definiva corrispondenza una differenza angolare inferiore a cinque gradi. Furono generati percorsi fattibili nell'85,3 per cento dei casi valutati; l'82 per cento coincideva con quelli reali secondo quella definizione, con deviazione media di 2,30 gradi tra i corrispondenti. Il sistema svolgeva segmentazione e rilevamento 3D assenti nel GPT-4, ma rimaneva retrospettivo, senza beneficio clinico dimostrato.
Una prova di concetto basata su regole del 2023 generava cinque percorsi per ciascuno di 28 pazienti. Quattro medici esperti valutarono 140 percorsi; punteggi del computer e clinici coincidevano nel 57,9 per cento dei casi e tutte le 28 migliori vie scelte dall'algoritmo furono considerate sicure. Era giudizio dei revisori, non prova di complicanze ridotte nell'uso clinico.
TRAX, Trajectory Recommendation Algorithm for CT-guided Biopsy, ordina circa 20.000 percorsi dopo che un medico identifica il bersaglio. In un confronto su 53 pazienti, lettori in cieco giudicarono sicure tutte le vie scelte dall'IA e dai medici. Le valutazioni coincidevano nel 58 per cento, favorivano TRAX nel 23 e il medico nel 19, senza differenza significativa di preferenza. Le vie TRAX erano leggermente più corte; metà usava un piano obliquo, mentre l'81,1 per cento di quelle cliniche era assiale.
Input, dati, definizioni e soglie differivano: queste percentuali non classificano direttamente i sistemi. I pianificatori dedicati codificano anatomia, misurano distanze e ordinano coerentemente molte alternative. I modelli generali sono flessibili ma dipendono molto da preparazione e prompt. Anche per confrontare opzioni o documentare motivazioni serve un'interfaccia che separi suggerimenti e piani approvati, mostri il percorso anatomico completo e conservi la revisione umana.
Che cosa dovrebbe dimostrare una validazione più forte
Ripetere casi identici e standardizzare tutti i prompt verificherebbe la coerenza; gli studi devono registrare frequenza ed effetto delle correzioni umane. L'analisi nativa del volume TC completo dovrebbe segmentare lesioni, polmoni, vasi, coste, scissure, mediastino e altre strutture, calcolare margini espliciti e mostrare l'intero tragitto. Collegare un modello linguistico alla segmentazione introduce rischi d'integrazione da validare separatamente.
Dati esterni multicentrici devono coprire scanner, ricostruzioni, posizioni e sedi oltre un centro oncologico. I test prospettici potrebbero iniziare in modalità ombra, senza influenzare la cura. Successivi studi controllati confronterebbero pianificazione assistita e abituale con responsabilità finale dei radiologi, misurando resa diagnostica, pneumotorace, sanguinamento, durata, radiazioni, riposizionamento e recupero.
I fallimenti vanno riportati separatamente, non nascosti dalle medie. L'esecuzione robotica diretta richiederebbe prove molto più forti e supervisione del dispositivo. I 30 casi con 28 piani accettabili e 18 millimetri in meno nella mediana giustificano altri esperimenti. Annotazioni manuali, richieste improvvisate, due percorsi respinti e nessun esito di pazienti guidati dall'IA non giustificano l'uso clinico immediato né l'affermazione che linee più corte disegnate da un chatbot rendano più sicure le biopsie.
Fonti
Studio di fattibilità GPT-4 · Studio di pianificazione 3D · Pianificazione basata su regole · Confronto TRAX · Indice del resoconto originale