
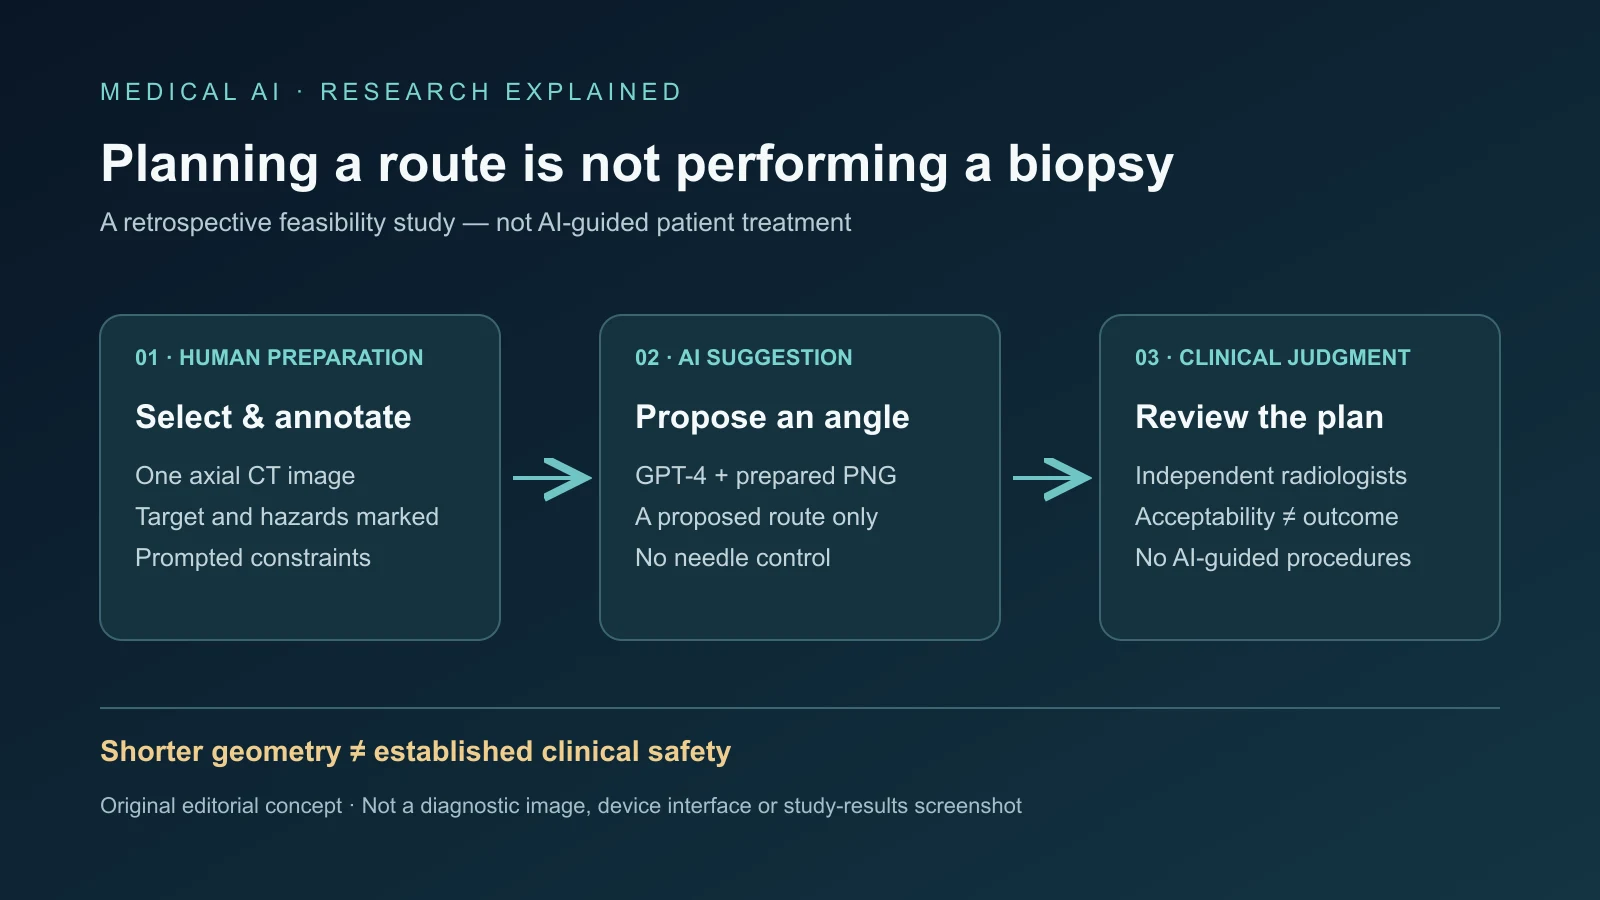
纪念斯隆·凯特琳癌症中心的一项肺活检回顾性实验发现,GPT-4能根据精心准备的CT图像提出看似合理的进针角度。独立放射科医生认为30条路径中的28条足够合适,占93.3%。建议针路穿过肺组织的中位距离为5毫米,而资深医生已实际采用的路径为23毫米。
这是可行性结果,不是活检更安全的证据。没有患者接受由这些AI方案引导的操作。两条路径未通过审查,其中一条穿过的肺组织是人工路径的四倍,另一条引出了针体稳定性问题。有意义的进展是一个可以检验的规划假说,而非自主导航系统,也不是并发症减少已获证明。
每个建议之前都有专家准备
发表于开放获取期刊CVIR Oncology的研究,使用三名介入放射科医生完成的30例连续历史操作,每位医生均有至少十年经验。去标识化队列包括17名男性和13名女性,中位年龄65岁。结节直径5至45毫米,中位21毫米;位置包括肺尖5例、胸膜下7例、纵隔旁3例、肺底附近4例,带来不同解剖挑战。
研究人员选择一张轴位CT切片,裁剪放大,在GIMP中叠加放射状网格,再把医学图像转换成PNG。一名作者用蓝圈标出病灶,用红色标出敏感结构。模型接收的是目标和危险结构已由人识别的图像,而不是需要独立识别解剖结构的原始检查。
标准提示提供五项条件:到达靶点、尽量减少肺组织穿行,并避开骨骼、肺裂及纵隔。每例开启新会话;若遗漏条件,研究人员可以追加提示,记录首个涵盖全部要求的回答。迭代次数中位为两次,四分位距一至三次。
两位未参与原操作的资深介入放射科医生,在不知道路径来源的情况下独立审查。这是在大量人工准备后,测试通用多模态模型能否提出合理角度,并未测试自主分割、完整三维规划、实时导航或机器人控针。工作流各阶段仍需要专业医生。
线更短不等于临床结局更好
GPT-4路径穿过肺组织的中位距离为5毫米,四分位距0至25毫米;人工路径对应为23毫米和5至57毫米。差异具有统计学意义,报告p值为0.0063。零穿行距离出现在紧邻胸膜表面的胸膜下病灶,直接进针可避免经过正常肺实质,但长度只是操作风险的一部分。
建议进针角度均值为179度,人工路径为174度,差异无统计学意义。相似的组均值掩盖了明显的个案差异:主要结果以角度相差不超过10度、经过组织平面类似为条件,仅报告8例吻合;作者在另一处采用更严格解释,得到3例。这些数字不应被悄悄合成一个一致率。
比较还存在重要的不对等:医生路径已在患者身上成功实施,模型路径却只是规划图上的线。一张轴位切片上合理的路线,在相邻切片间未必可行。呼吸运动、体位、针体锚定、设备限制及变化中的解剖都会影响实际可用性。
原有操作没有重大并发症。4名患者发生无需干预即消退的轻微气胸,2名出现轻度、自限性咯血。这些结局属于医生引导的操作,不能归功于GPT-4。研究没有模拟替代路径是否会改变这些情况,也不能评估从未实际使用路径的诊断取材成功率。
两次失败揭示相互竞争的约束
第19例中,GPT-4建议穿过20毫米肺组织,而人工路径只有5毫米,工作目标要求减少穿行,模型却提出四倍距离。它还给出宽泛角度范围,而非精确的首选方案。审查者认为其理论上可行,却不符合良好临床实践;避开明显障碍并不够。
第27例为胸膜下结节。建议路径不必要地穿过5毫米肺组织,并引发稳定性担忧。如果与支撑组织接触过少,同轴活检针可能锚定不足,在取样时容易移动或脱位。最小化组织穿行与固定穿刺针并非总是同一目标。
二维设置无法表示所选平面上下的结构,也无法呈现完整三维进针过程。医生通常查看多张切片和多平面重建。GPT-4没有独立检测全部病灶、分割器官或可靠确定安全边界。研究还未规定与锁骨下及腋部神经血管束至少5毫米的距离,因为当时体位使这些结构远离评估针路;未来系统不能默认这一条件成立。
追加提示并未完全脚本化,不同用户可能把同一图像引向不同答案。独立会话减少了跨病例污染,却未证明重复运行同一病例会得到相同角度。通用AI服务更新又增加不确定性:验证必须绑定受控模型版本、明确输入和有记录的流程,不能自动迁移到后续配置。
专用规划器提供参照,而不是简单排行榜
一项2024年专用系统研究结合三维病灶检测与贝叶斯针路优化,使用219次扫描中的2147个结节训练,另以235次扫描、354个病灶验证检测。报告的检测AUROC为97.4%,平均敏感度93.5%,特异度93.2%。这些是检测指标,不是临床活检成功率。
其针路比较涉及150名患者,将角度差小于5度定义为吻合。85.3%的评估病例生成可行路径,82%按该定义与实际路径匹配;匹配路径的平均角度偏差为2.30度。该软件执行了GPT-4没有做的三维分割和检测,但仍是回顾性评估,未证明患者获益。
2023年的规则式概念验证,为28名患者每人生成5条路径。4名资深医生评估140条路径,计算机与医生评分在57.9%的情况下相同,算法选出的28条最佳路径均获安全评价。这是审查者判断,不是推荐方案已在临床降低并发症的证明。
CT引导活检轨迹推荐算法TRAX,在医生确定靶点后,对约2万条路径排序。一项53人对照中,盲法审查者认为AI与医生所选路径均安全。58%的评价相同,23%更偏好TRAX,19%更偏好医生,偏好差异无统计学意义。TRAX路径略短,半数使用斜面,医生路径则有81.1%位于轴位平面。
这些研究的输入、数据集、定义和吻合阈值不同,百分比不能直接用于排名。专用系统可编码解剖约束、测量距离、一致地排序大量备选路线;通用多模态模型更灵活,却高度依赖准备与提示。即使用于比较选项或记录理由,也需要界面区分模型建议与获批方案,展示完整解剖路径并保留人工审查。
更强验证必须回答什么
重复相同病例、完全标准化提示可检验一致性;研究应记录人工纠正频率和改变输出的程度。原生全容积CT分析需要分割病灶、肺、血管、肋骨、肺裂、纵隔及其他相关结构,计算明确边界并展示完整针路。语言模型与分割软件组合也会引入需要单独验证的整合风险。
外部、多中心数据必须覆盖不同扫描仪、重建设置、体位及病灶位置,而非仅一家癌症中心。前瞻性测试可先采用不影响医疗的影子模式,再进行AI辅助与常规规划的受控比较,由合格放射科医生保留最终责任,测量取材诊断率、气胸、出血、操作时间、辐射、重新定位及恢复。
失败应单独报告,不能被平均数掩盖。直接机器人执行需要强得多的证据及器械监管。30例中的28条可接受方案、肺组织中位穿行减少18毫米,支持进一步实验;但人工标注、非脚本化追问、两条被否决路径和没有AI引导患者结局的事实,都不支持立即临床部署,也不支持“聊天机器人画出的短路径让活检更安全”的主张。
来源
GPT-4可行性研究 · 三维规划研究 · 规则式规划研究 · TRAX对照研究 · 原始报道索引