
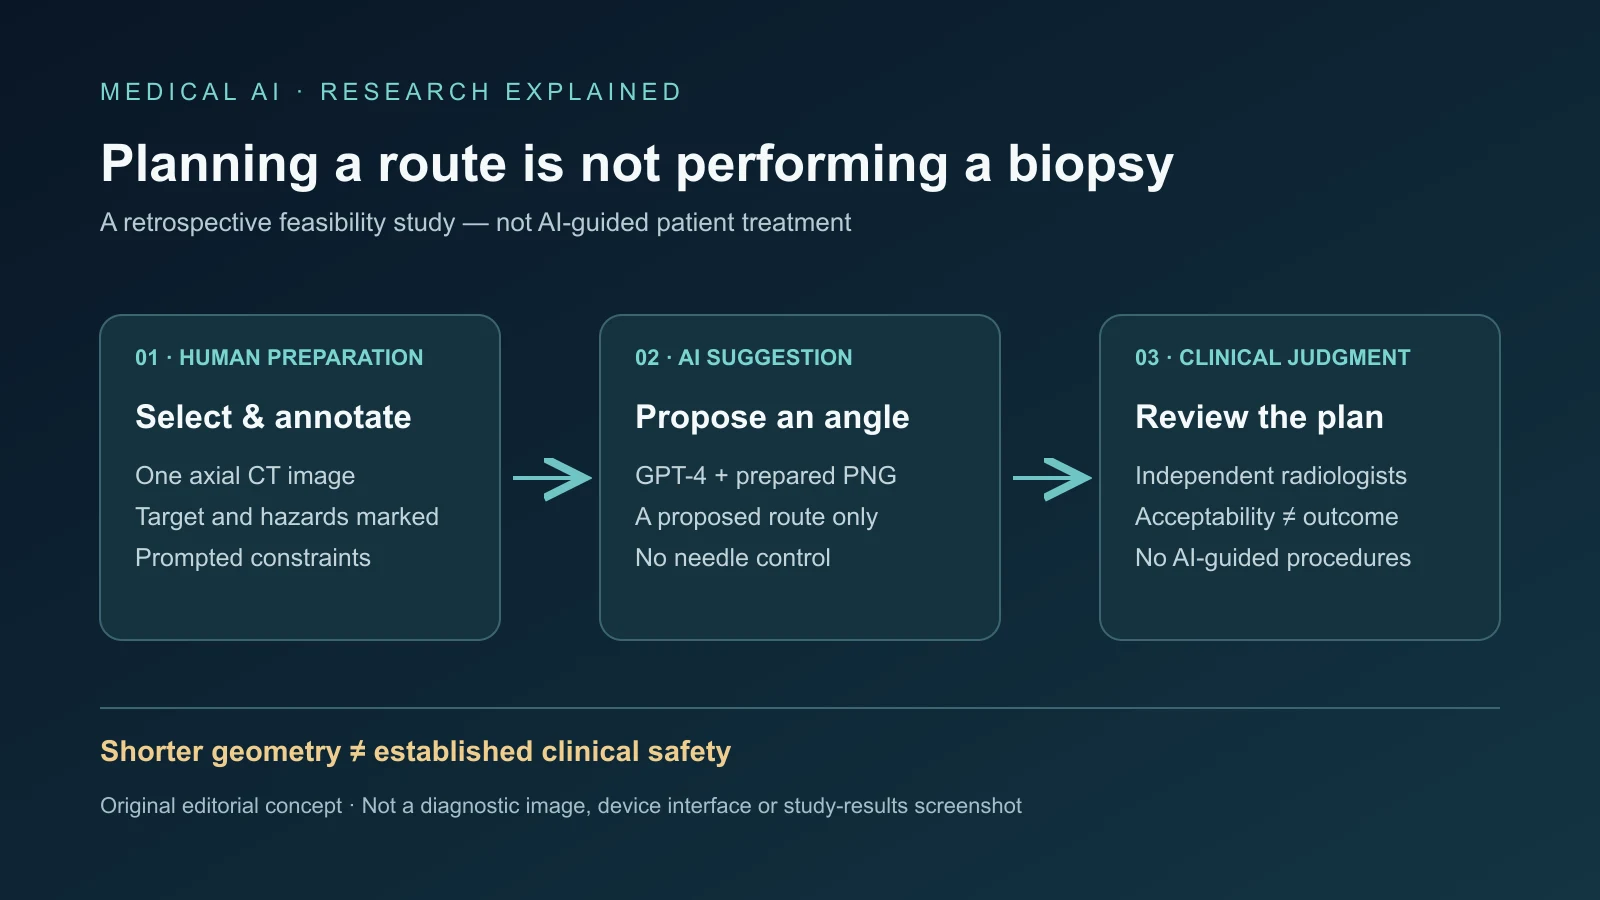
Un experimento retrospectivo del Memorial Sloan Kettering Cancer Center encontró que GPT-4 podía proponer ángulos de entrada plausibles a partir de imágenes de TC cuidadosamente preparadas. Radiólogos independientes consideraron adecuadas 28 de 30 rutas, el 93,3 por ciento. Los trayectos propuestos atravesaban una mediana de 5 milímetros de tejido pulmonar, frente a 23 en las rutas ya utilizadas por médicos experimentados.
Son resultados de viabilidad, no pruebas de biopsias más seguras. Ningún paciente recibió una intervención guiada por esas propuestas. Dos planes no superaron la revisión: uno atravesaba cuatro veces más pulmón que la ruta manual y otro planteaba dudas sobre estabilidad de la aguja. El avance útil es una hipótesis de planificación comprobable, no un navegador autónomo ni una reducción demostrada de complicaciones.
Cada recomendación partía de preparación experta
El estudio de acceso abierto en CVIR Oncology usó 30 procedimientos históricos consecutivos realizados por tres radiólogos intervencionistas con al menos diez años de experiencia cada uno. La cohorte desidentificada incluía 17 hombres y 13 mujeres, mediana de edad de 65 años. Los nódulos medían 5–45 milímetros, mediana de 21. Había cinco lesiones apicales, siete subpleurales, tres paramediastínicas y cuatro próximas a la base, con distintos desafíos anatómicos.
Un investigador elegía un corte axial, lo recortaba y ampliaba y añadía una cuadrícula radial en GIMP antes de convertir la imagen médica a PNG. Un autor marcaba el objetivo en azul y las estructuras sensibles en rojo. El modelo recibía, por tanto, una imagen cuyo objetivo y riesgos ya habían identificado personas, no un examen intacto que exigiera detección anatómica independiente.
El prompt estándar aportaba cinco criterios: llegar al objetivo, minimizar tejido pulmonar atravesado y evitar huesos, cisuras y mediastino. Cada caso comenzaba en un chat nuevo. Se podían añadir instrucciones si faltaba una condición, registrando la primera respuesta con todos los parámetros. La mediana fue dos iteraciones, con rango intercuartílico de una a tres.
Dos radiólogos intervencionistas experimentados ajenos a los procedimientos originales evaluaban las rutas de forma independiente y sin conocer su origen. Se probaba un ángulo plausible después de amplia preparación humana, no segmentación autónoma, planificación tridimensional completa, navegación en vivo o control robótico de la aguja. Los especialistas seguían siendo necesarios en todo el proceso.
Una línea más corta no equivalía a un mejor resultado clínico
La mediana de recorrido pulmonar de GPT-4 fue 5 milímetros, rango intercuartílico 0–25; para las rutas manuales, 23 y 5–57 milímetros. La diferencia reportada fue estadísticamente significativa, p=0,0063. El recorrido cero correspondía a lesiones subpleurales junto a la superficie pleural, donde la entrada directa puede evitar parénquima normal. La longitud sigue siendo solo una parte del riesgo.
El ángulo medio propuesto era 179 grados frente a 174 manualmente, sin diferencia significativa. Medias parecidas ocultaban grandes diferencias por caso. Los resultados principales describían buena concordancia solo en ocho casos, con ángulos separados por hasta diez grados y recorrido parecido entre planos tisulares. En otro apartado los autores describían una interpretación más estricta con tres coincidencias. No deben fusionarse silenciosamente ambas cifras en una única tasa.
La comparación era desigual: las rutas médicas se habían ejecutado con éxito en pacientes, mientras las del modelo eran líneas sobre imágenes. Una línea convincente en un corte axial puede ser inviable en cortes vecinos. Respiración, posición corporal, anclaje, límites del equipo y cambios anatómicos influyen en su utilidad real.
Los procedimientos originales no tuvieron complicaciones graves. Cuatro pacientes presentaron neumotórax mínimo resuelto sin intervención; dos hemoptisis leve y autolimitada. Esos resultados pertenecen a las intervenciones clínicas, no a GPT-4. No se simuló si las rutas alternativas los cambiarían, ni puede establecerse el rendimiento diagnóstico de trayectos nunca empleados.
Los dos fallos muestran restricciones en conflicto
En el Caso 19, GPT-4 propuso 20 milímetros de pulmón frente a 5 manualmente: cuatro veces más y contrario al objetivo de minimización. También ofreció un rango amplio de ángulos en lugar de un plan preferente preciso. Los revisores lo consideraron teóricamente viable, pero ajeno a la buena práctica clínica. Evitar obstáculos evidentes no bastaba.
El Caso 27 era un nódulo subpleural. La propuesta atravesaba innecesariamente 5 milímetros de pulmón y suscitaba dudas de estabilidad. Poco contacto con tejido de soporte puede dejar una aguja coaxial insuficientemente anclada, expuesta a movimiento o desplazamiento durante la toma de muestras. Minimizar la distancia y fijar la aguja no siempre son el mismo objetivo.
La configuración bidimensional no representaba estructuras por encima o debajo del plano ni la trayectoria tridimensional completa. Los radiólogos suelen examinar múltiples cortes y reconstrucciones multiplanares. GPT-4 no detectó por sí solo todas las lesiones, segmentó órganos ni definió márgenes fiables. El estudio omitió además un margen mínimo especificado de cinco milímetros de los haces neurovasculares subclavios y axilares, porque la posición de los pacientes los alejaba de las rutas. Futuros sistemas no pueden asumir esa condición.
Las repreguntas no estaban completamente guionizadas, por lo que distintos usuarios podían orientar la misma imagen hacia respuestas diferentes. Las sesiones separadas reducían contaminación entre casos, pero no demostraban que repetir uno produjera el mismo ángulo. Las actualizaciones de servicios generales añaden incertidumbre: la validación debe vincularse a versión controlada, entradas definidas y proceso documentado, no transferirse automáticamente a configuraciones posteriores.
Los planificadores especializados ofrecen contexto, no una clasificación
Un estudio específico de 2024 combinó detección tridimensional de lesiones y optimización bayesiana de trayectorias. Se entrenó con 2147 nódulos de 219 exploraciones y validó detección en otras 235 con 354 lesiones. La AUROC reportada fue 97,4 por ciento, sensibilidad media 93,5 y especificidad 93,2. Son métricas de detección, no porcentajes de biopsias clínicamente exitosas.
La comparación de rutas incluyó 150 pacientes y definió coincidencia como diferencia angular inferior a cinco grados. Se generaron rutas viables en el 85,3 por ciento de casos evaluados; el 82 por ciento coincidía con rutas reales bajo esa definición, con desviación media de 2,30 grados entre las coincidentes. El software hacía segmentación y detección 3D ausentes en GPT-4, pero seguía siendo retrospectivo, sin beneficio para pacientes demostrado.
Una prueba de concepto basada en reglas de 2023 generó cinco rutas para cada uno de 28 pacientes. Cuatro médicos experimentados evaluaron 140 rutas; las puntuaciones del ordenador y los médicos coincidían en el 57,9 por ciento y las 28 mejores rutas algorítmicas fueron consideradas seguras. Era juicio de revisores, no prueba de reducción clínica de complicaciones.
TRAX, Trajectory Recommendation Algorithm for CT-guided Biopsy, ordena unas 20 000 rutas después de que un médico identifica el objetivo. En una comparación con 53 pacientes, lectores cegados consideraron seguras todas las rutas de IA y médicos. Las valoraciones coincidían en el 58 por ciento, favorecían TRAX en el 23 y al médico en el 19, sin diferencia de preferencia significativa. Las rutas TRAX eran ligeramente más cortas; la mitad usaba un plano oblicuo y el 81,1 por ciento de las médicas era axial.
Entradas, datos, definiciones y umbrales diferían, por lo que los porcentajes no clasifican directamente sistemas. Los planificadores específicos codifican anatomía, miden distancias y ordenan muchas alternativas consistentemente. Los modelos generales son flexibles, pero dependen de preparación y prompts. Incluso para comparar opciones o documentar razones, la interfaz debe separar sugerencias y planes aprobados, mostrar la ruta anatómica completa y preservar revisión humana.
Qué debería establecer una validación más sólida
Repetir casos idénticos y estandarizar todos los prompts probaría consistencia; deben registrarse frecuencia y efecto de las correcciones humanas. Analizar el volumen completo de TC exigiría segmentar lesiones, pulmones, vasos, costillas, cisuras, mediastino y otras estructuras, calcular márgenes explícitos y mostrar todo el recorrido. Integrar un modelo lingüístico con segmentación crea riesgos que necesitan validación propia.
Los datos externos multicéntricos deben cubrir escáneres, reconstrucciones, posiciones y localizaciones más allá de un centro oncológico. Los ensayos prospectivos podrían empezar en modo sombra sin cambiar la atención. Después, estudios controlados compararían planificación asistida y habitual bajo responsabilidad final de radiólogos, midiendo rendimiento diagnóstico, neumotórax, sangrado, duración, radiación, reposicionamiento y recuperación.
Los fallos deben comunicarse por separado, no esconderse en medias. La ejecución robótica directa exigiría pruebas mucho mayores y supervisión del dispositivo. Los 30 casos, 28 planes aceptables y 18 milímetros menos de mediana justifican más experimentos. Las anotaciones manuales, repreguntas improvisadas, dos rutas rechazadas y ningún resultado de pacientes guiados por IA no justifican despliegue inmediato ni afirmar que líneas más cortas de un chatbot vuelven más seguras las biopsias.
Fuentes
Estudio de viabilidad GPT-4 · Estudio de planificación 3D · Planificación por reglas · Comparación TRAX · Índice del reportaje original