
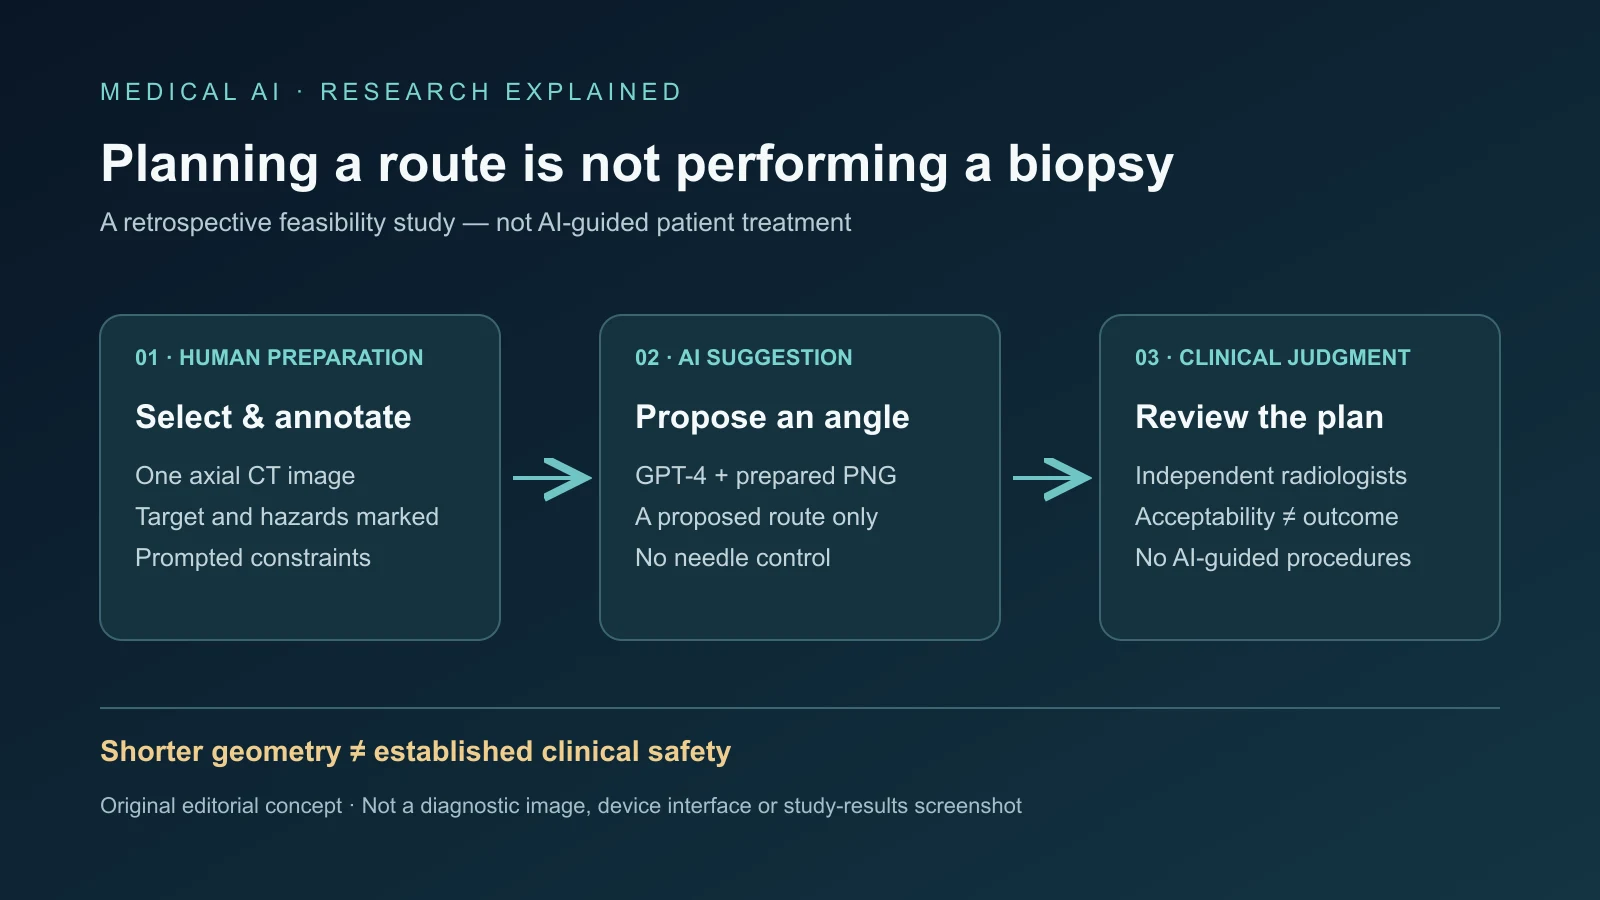
Memorial Sloan Kettering Cancer Center의 후향적 폐 생검 실험에서 GPT-4는 정교하게 준비한 CT 영상으로 그럴듯한 진입 각도를 제안했다. 독립 영상의학 전문의는 30개 경로 중 28개, 93.3퍼센트를 적절하다고 판단했다. 제안 경로가 통과하는 폐 조직 거리의 중앙값은 5밀리미터로, 숙련된 임상의가 실제 사용한 경로의 23밀리미터보다 짧았다.
이는 실행 가능성 결과이지 더 안전한 생검의 증거는 아니다. AI 제안으로 유도한 시술을 받은 환자는 없었다. 두 계획은 검토를 통과하지 못했다. 하나는 수동 경로보다 네 배 많은 폐 조직을 통과했고, 다른 하나는 바늘 안정성 우려를 일으켰다. 유용한 진전은 시험 가능한 계획 가설이며 자율 내비게이터나 합병증 감소의 입증이 아니다.
모든 권고 전에 전문가 준비가 있었다
공개 접근 학술지 CVIR Oncology 연구는 각각 최소 10년 경험을 가진 세 중재영상의학 전문의가 수행한 연속된 과거 시술 30건을 사용했다. 비식별 집단은 남성 17명, 여성 13명이고 나이 중앙값은 65세였다. 결절은 5~45밀리미터, 중앙값 21밀리미터였다. 폐첨부 5개, 흉막하 7개, 종격동 주변 3개, 폐기저부 인근 4개 병변을 포함해 서로 다른 해부학적 문제가 있었다.
연구자는 축상 CT 단면을 고른 뒤 자르고 확대하고 GIMP에서 방사형 격자를 추가해 의료 영상을 PNG로 변환했다. 저자 한 명이 목표를 파란 원으로, 민감한 구조를 빨간색으로 표시했다. 따라서 모델은 사람에게서 이미 목표와 위험 구조를 식별받은 영상으로 작업했다. 독립적 해부학 검출이 필요한 수정되지 않은 전체 검사는 아니었다.
표준 프롬프트는 목표 도달, 폐 조직 통과 최소화, 뼈·엽간열·종격동 회피라는 다섯 조건을 제시했다. 사례마다 새 채팅을 열었고 조건을 놓치면 추가 지시를 할 수 있었다. 모든 요구 변수를 반영한 첫 답변을 기록했으며 반복 횟수 중앙값은 2회, 사분위 범위는 1~3회였다.
기존 시술에 참여하지 않은 숙련된 중재영상의학 전문의 두 명이 경로 출처를 모르는 상태에서 독립 평가했다. 상당한 사람의 준비 후 타당한 각도를 제시할 수 있는지 시험했지, 자율 분할이나 완전한 3차원 계획, 실시간 유도, 로봇 바늘 제어를 시험하지 않았다. 전체 과정에서 전문의가 계속 필요했다.
짧은 선이 더 좋은 임상 결과는 아니었다
GPT-4의 폐 통과 중앙값은 5밀리미터, 사분위 범위는 025였고 수동 경로는 각각 23과 557밀리미터였다. 보고된 차이는 통계적으로 유의했으며 p=0.0063이었다. 통과 거리 0은 흉막 표면에 붙은 흉막하 병변에서 나타났다. 직접 접근하면 정상 폐실질을 피할 수 있지만 길이는 시술 위험의 한 요소에 불과하다.
제안 진입 각도 평균은 179도, 수동 경로는 174도로 유의한 차이가 없었다. 비슷한 집단 평균은 사례별 큰 차이를 감췄다. 주요 결과는 각도 차이 10도 이내이면서 조직 평면을 지나는 길이 비슷한 조건에서 단 8건의 좋은 일치를 보고했다. 다른 부분에서는 더 엄격한 해석으로 3건을 제시했다. 두 수치를 말없이 하나의 일치율로 합쳐서는 안 된다.
비교는 중요한 점에서 불균등했다. 의사 경로는 환자에서 성공적으로 실행됐지만 모델 경로는 계획 영상 위 선이었다. 한 축상 단면에서 설득력 있는 선도 인접 단면에서는 불가능할 수 있다. 호흡, 자세, 고정, 장비 한계, 변화하는 해부학이 실제 사용을 좌우한다.
원래 시술에는 중대한 합병증이 없었다. 4명은 개입 없이 해소된 경미한 기흉, 2명은 가볍고 자연히 멎는 객혈을 보였다. 이는 의사가 유도한 시술의 결과이지 GPT-4의 성과가 아니다. 대안 경로가 이를 바꿨을지 시뮬레이션하지 않았고, 한 번도 사용하지 않은 경로의 진단 수율도 확립할 수 없다.
두 실패는 경쟁하는 제약을 드러낸다
사례 19에서 GPT-4는 폐를 20밀리미터 통과하는 경로를 제안했다. 수동 경로는 5밀리미터로, 최소화 목표와 반대로 네 배였다. 명확한 선호 계획 대신 넓은 각도 범위도 내놓았다. 평가자는 이론적으로 가능하지만 좋은 임상 관행에 맞지 않는다고 판단했다. 눈에 띄는 장애물을 피하는 것만으로 충분하지 않았다.
사례 27은 흉막하 결절이었다. 제안 경로는 불필요하게 폐 5밀리미터를 통과했고 안정성 우려도 있었다. 지지 조직과 접촉이 너무 적으면 동축 생검 바늘이 충분히 고정되지 않아 채취 중 움직이거나 이탈할 수 있다. 통과 거리를 최소화하는 것과 바늘을 단단히 고정하는 것은 항상 같은 목표가 아니다.
2차원 설정은 선택 평면 위아래 구조나 전체 3차원 진행 경로를 표현하지 못했다. 전문의는 보통 여러 단면과 다평면 재구성을 본다. GPT-4는 모든 병변을 독립 검출하거나 장기를 분할하거나 안전 여유를 신뢰성 있게 정하지 않았다. 연구는 쇄골하 및 액와 신경혈관 다발에서 최소 5밀리미터 여유라는 조건도 지정하지 않았다. 환자 자세가 평가 경로에서 이를 멀리 두었기 때문이지만 향후 시스템은 그 조건을 당연시할 수 없다.
후속 프롬프트는 완전히 정형화되지 않아 사용자마다 같은 영상을 다른 답변으로 유도할 수 있었다. 독립 세션은 사례 간 오염을 줄였지만 같은 사례를 반복하면 같은 각도가 나오는지는 증명하지 않았다. 일반 AI 서비스 업데이트도 불확실성을 더한다. 검증은 통제된 모델 버전과 정의된 입력, 기록된 과정에 연결해야 하며 후속 구성에 자동 이전할 수 없다.
전문 계획기는 맥락을 제공하지만 단순 순위는 아니다
2024년 전용 시스템 연구는 3차원 병변 검출과 베이지안 경로 최적화를 결합했다. 219개 스캔의 결절 2147개로 학습하고, 별도 235개 스캔의 병변 354개로 검출을 검증했다. 보고된 검출 AUROC는 97.4퍼센트, 평균 민감도는 93.5퍼센트, 특이도는 93.2퍼센트였다. 이는 검출 지표이며 임상 생검 성공률이 아니다.
경로 비교는 150명을 대상으로 각도 차이 5도 미만을 일치로 정의했다. 평가 사례의 85.3퍼센트에서 가능한 경로를 생성했고, 82퍼센트는 그 정의에서 실제 경로와 일치했으며 일치 사례의 평균 편차는 2.30도였다. 이 소프트웨어는 GPT-4가 하지 않은 3차원 분할과 검출을 수행했지만 여전히 후향 평가였고 환자 이익을 입증하지 않았다.
2023년 규칙 기반 개념 증명은 28명에게 각각 5개 경로를 만들었다. 숙련 의사 4명이 140개 경로를 평가했고 컴퓨터와 의사 점수는 57.9퍼센트에서 같았다. 알고리즘이 고른 최선의 28개 경로는 모두 안전하다고 평가됐다. 이는 검토자 판단이며 임상 사용에서 합병증을 줄였다는 증거가 아니다.
TRAX, 즉 Trajectory Recommendation Algorithm for CT-guided Biopsy는 의사가 목표를 지정한 뒤 약 2만 개 경로를 순위화한다. 53명 비교에서 눈가림 평가자는 AI와 의사가 고른 모든 경로를 안전하다고 봤다. 점수는 58퍼센트에서 같았고 23퍼센트는 TRAX, 19퍼센트는 의사 경로를 선호했지만 선호 차이는 유의하지 않았다. TRAX 경로는 약간 짧았고 절반이 비스듬한 평면을 사용했다. 의사 경로의 81.1퍼센트는 축상이었다.
입력, 데이터, 정의와 일치 기준이 달라 비율로 시스템을 직접 순위 매길 수 없다. 전용 계획기는 해부 제약을 코드화하고 거리를 측정하며 많은 대안을 일관되게 비교한다. 범용 모델은 유연하지만 준비와 프롬프트에 의존한다. 선택지를 비교하거나 근거를 기록하는 지원 역할에서도 제안과 승인 계획을 구분하고 전체 해부학 경로와 사람 검토를 남기는 인터페이스가 필요하다.
더 강한 검증이 확립해야 할 것
동일 사례 반복과 완전 표준 프롬프트로 일관성을 시험하고, 사람 교정 빈도와 출력 변화 정도를 기록해야 한다. CT 전체 용적의 직접 분석에는 병변, 폐, 혈관, 늑골, 엽간열, 종격동과 기타 구조의 분할, 명시적 여유, 전체 경로 표시가 필요하다. 언어 모델과 분할 소프트웨어 결합은 별도 검증할 통합 위험을 만든다.
외부 다기관 데이터는 한 암센터를 넘어 스캐너, 재구성 설정, 자세, 병변 위치를 포괄해야 한다. 전향 시험은 진료에 영향을 주지 않는 그림자 모드로 시작할 수 있다. 이후 통제 연구에서 자격 있는 영상의학 전문의가 최종 책임을 지고 AI 보조와 기존 계획을 비교하며 진단 수율, 기흉, 출혈, 시간, 방사선량, 바늘 재배치와 회복을 측정할 수 있다.
실패는 평균에 감추지 말고 따로 보고해야 한다. 직접 로봇 실행에는 훨씬 강한 증거와 의료기기 감독이 필요하다. 30건 중 28개 적절한 계획과 18밀리미터 짧은 폐 통과 중앙값은 추가 실험을 정당화한다. 그러나 수작업 주석, 비정형 후속 질문, 두 탈락 경로와 AI 유도 환자 결과 부재를 고려하면 즉시 임상 배포하거나 챗봇의 짧은 선이 생검을 더 안전하게 만든다고 주장할 근거는 아니다.
출처
GPT-4 타당성 연구 · 3차원 계획 연구 · 규칙 기반 계획 연구 · TRAX 비교 연구 · 원 보도 색인