
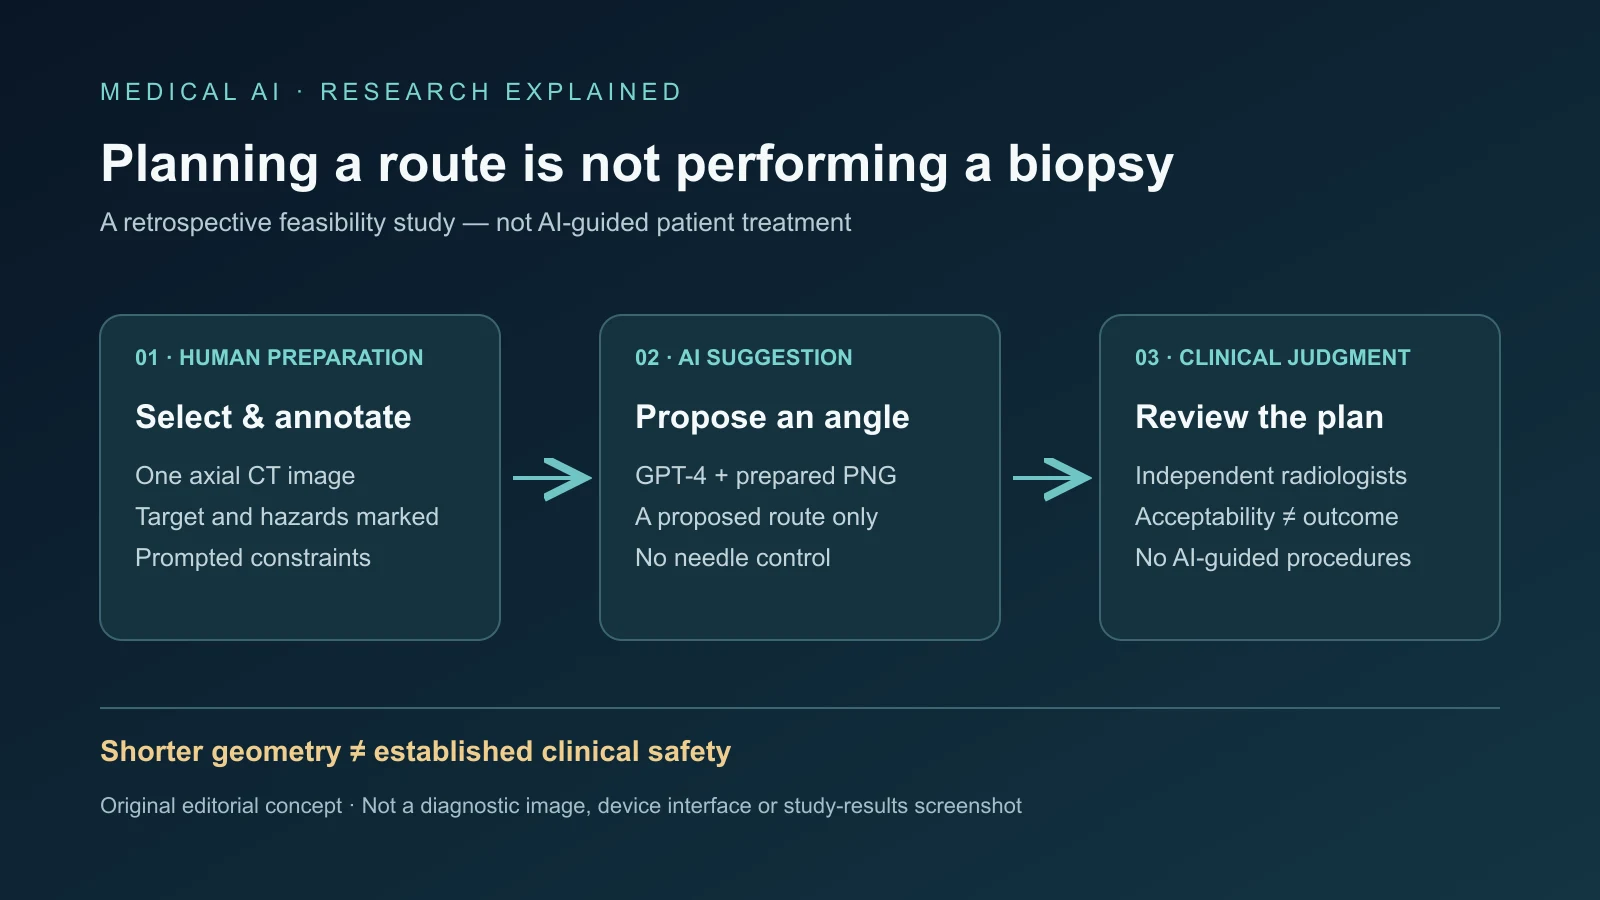
Memorial Sloan Kettering Cancer Centerの後ろ向き実験では、GPT-4は丁寧に準備したCT画像からもっともらしい進入角を提案できた。独立した放射線科医は30経路中28、93.3%を適切と判断した。肺組織の通過距離中央値は5ミリで、熟練医が実際に使った経路の23ミリより短かった。
これは実行可能性の結果であって、より安全な生検の証拠ではない。AI案で誘導された処置を受けた患者はいない。2案は審査で却下され、一つは手動経路の4倍の肺組織を通り、もう一つは針の安定性に懸念があった。進展は検証可能な計画仮説であり、自律ナビゲーターや合併症減少の実証ではない。
提案の前には専門家の準備があった
公開論文が掲載されたCVIR Oncologyの研究は、各10年以上の経験を持つ3人のIVR医が実施した連続30処置を使った。匿名化集団は男性17人、女性13人、年齢中央値65歳。結節径は5~45ミリ、中央値21ミリで、肺尖部5、胸膜下7、縦隔傍3、肺底近傍4の病変を含み、それぞれ解剖学的課題が異なった。
研究者は軸位CT断面を選び、切り抜きと拡大を行い、GIMPで放射状グリッドを加えて医用形式からPNGに変換した。著者の一人が標的を青い円で、重要構造を赤で示した。モデルが受け取ったのは、人がすでに標的と危険部位を特定した画像であり、自力で解剖を検出すべき未加工の検査ではなかった。
標準プロンプトは、標的到達、肺組織通過の最小化、骨・葉間裂・縦隔の回避という5条件を与えた。症例ごとに新規チャットを開始し、条件を見落とすと追加入力を許した。全条件を取り込んだ最初の回答を記録し、反復の中央値は2回、四分位範囲は1~3回だった。
元の処置に関与しない経験豊富な2人のIVR医が、経路の由来を知らずに独立評価した。大幅な人手の準備後に妥当な角度を出せるかの試験であり、自律セグメンテーション、完全3次元計画、リアルタイム誘導、ロボット針制御は試していない。全工程で専門家が必要だった。
短い線は良い臨床転帰と同義ではない
GPT-4の肺通過距離は中央値5ミリ、四分位範囲0~25ミリで、手動は23ミリと5~57ミリだった。差は統計的に有意で、p=0.0063。通過ゼロは胸膜表面に接する胸膜下病変で、直接入れば正常肺実質を通らない例だった。ただし長さは処置リスクの一要素にすぎない。
平均進入角は179度、手動は174度で有意差はなかった。集団平均が近くても症例ごとの差は大きい。主要結果の良好な一致は8例のみで、角度差10度以内かつ似た組織面の経路という定義だった。別の箇所には、より厳しい解釈による3例という記載もある。この二つを黙って一つの一致率にまとめるべきではない。
比較には重要な非対称性がある。医師の経路は患者で実行され成功していたが、モデル案は画像上の線にとどまった。ある軸位断面で妥当でも、隣接断面で実行困難になる。呼吸、体位、固定、装置の制約、変化する解剖は実用性を左右する。
元の処置に重大な合併症はなかった。4人に介入不要で消失した軽微な気胸、2人に軽い自然軽快性の喀血があった。これは医師による処置の転帰であり、GPT-4の功績ではない。代替経路で転帰が変わるかはシミュレーションされず、使用していない経路の診断収率も評価できない。
二つの失敗が示す競合する条件
症例19でGPT-4は肺を20ミリ通過する経路を提案したが、手動は5ミリだった。最小化の指示に反して4倍になったうえ、明確な推奨角度でなく広い角度範囲を示した。評価者は理論上は可能でも良い臨床実践ではないと判断した。明らかな障害を避けるだけでは足りない。
症例27は胸膜下結節で、提案は不要に5ミリの肺を通過し、安定性も懸念された。支える組織との接触が少なすぎると、同軸生検針の固定が不十分になり、採取中に動いたり抜けたりしやすくなる。距離の最小化と針の確実な固定は必ずしも同じ目的ではない。
2次元の設定は、選択面の上下の構造や完全な3次元経路を表せない。放射線科医は通常、複数断面と多断面再構成を見る。GPT-4は全病変の独立検出、臓器分割、信頼できる安全余裕の決定をしていない。鎖骨下・腋窩の神経血管束から最低5ミリという指定も省かれた。体位により評価経路から離れていたためだが、将来のシステムはそれを前提にできない。
追加質問は完全には定型化されず、利用者によって同じ画像を違う回答へ誘導し得る。独立セッションは症例間の混入を減らしたが、同じ症例を繰り返して同じ角度になるかは未確認だ。汎用AIサービス更新も不確実性を加える。検証は制御された版、定義した入力、記録された工程に結び付けるべきで、後の構成へ自動的には移せない。
専用計画器は文脈を与えるが、単純な順位表にはならない
2024年の専用システム研究は3次元病変検出とベイズ的経路最適化を組み合わせた。219スキャンの2147結節で学習し、別の235スキャン、354病変で検出を検証した。検出AUROCは97.4%、平均感度93.5%、特異度93.2%と報告された。これは検出性能であり、臨床生検の成功率ではない。
150人の経路比較では角度差5度未満を一致とした。評価例の85.3%で実行可能経路が得られ、82%がその定義で実際の経路と一致し、一致例の平均偏差は2.30度だった。GPT-4がしていない3次元分割と検出を扱ったが、なお後ろ向き評価で、患者利益の証明ではない。
2023年の規則ベース概念実証は28人に各5経路を生成した。熟練医4人が140経路を評価し、コンピューターと医師の点数は57.9%で一致した。アルゴリズムが選んだ最良28経路はすべて安全とされた。これは評価者判断であり、臨床で合併症が減った証拠ではない。
TRAX(Trajectory Recommendation Algorithm for CT-guided Biopsy)は医師の標的指定後、約2万経路を順位付けする。53人の比較で盲検評価者はAIと医師の全選択経路を安全とした。評価は58%で同じ、23%でTRAX、19%で医師を好み、好みの差は統計的に有意でなかった。TRAX経路は少し短く、半数が斜めの面を使い、医師の81.1%は軸位だった。
入力、データ、定義、一致閾値が違うため、割合で直接順位を付けられない。専用計画器は解剖制約を符号化し、距離を測り、多数候補を一貫して評価できる。汎用モデルは柔軟だが準備とプロンプトに依存する。選択肢比較や理由の記録を支援する場合も、提案と承認計画を分け、完全経路と人の評価を残す画面が必要だ。
より強い検証で何を確かめるか
同一症例の反復と完全に標準化したプロンプトで一貫性を測り、人の修正頻度と回答への影響を記録すべきだ。CT全体積の直接解析には、病変、肺、血管、肋骨、葉間裂、縦隔などの分割、明確な余裕、全経路表示が必要になる。言語モデルと分割ソフトの統合には独自のリスクがあり、別途検証を要する。
外部の多施設データで、一施設を超えた装置、再構成、体位、病変位置を扱う必要がある。前向き試験は医療を変えないシャドーモードから始められる。その後、専門医が最終責任を持つ対照研究で通常計画とAI支援を比較し、診断収率、気胸、出血、時間、被曝、再位置決め、回復を測る。
失敗は平均に隠さず個別に報告すべきだ。ロボットによる直接実行は、はるかに強い証拠と機器監督が必要になる。30例中28案が許容され、肺通過中央値が18ミリ短かったことは追加研究を支持する。しかし手作業の注釈、非定型の追問、却下された2経路、AI誘導患者の転帰がないことを踏まえると、直ちに臨床導入したり、チャットボットの短い線で生検が安全になると主張したりする根拠にはならない。
出典
GPT-4実行可能性研究 · 3次元計画研究 · 規則ベース計画研究 · TRAX比較研究 · 元報道の索引