
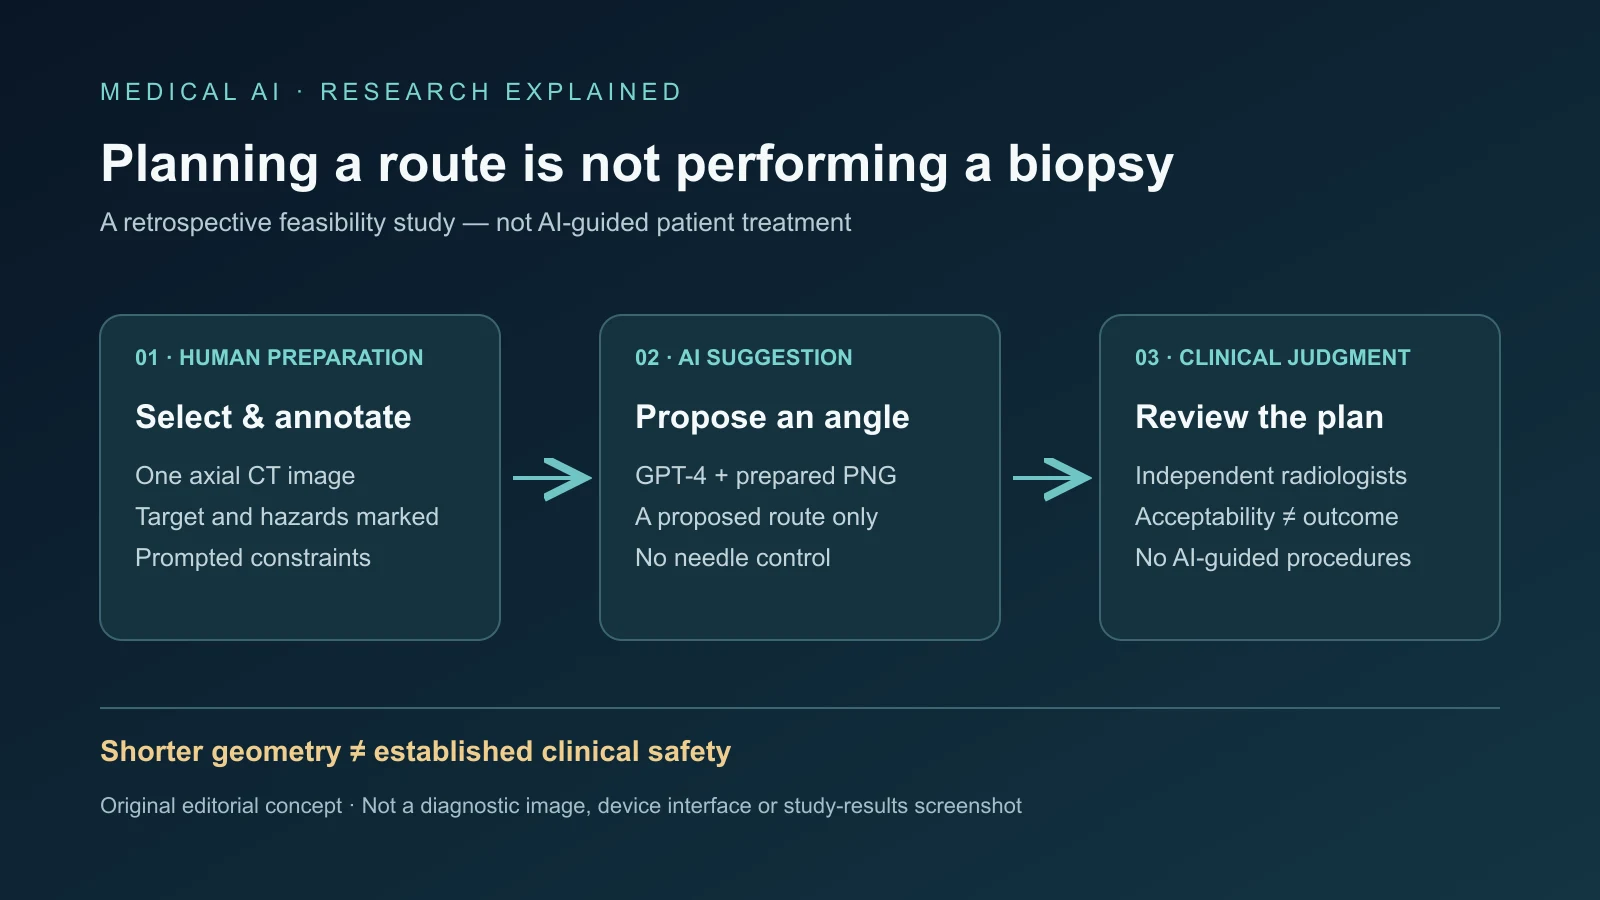
Retrospektywny eksperyment w Memorial Sloan Kettering Cancer Center wykazał, że GPT-4 potrafi proponować wiarygodne kąty wkłucia na starannie przygotowanych obrazach TK. Niezależni radiolodzy uznali 28 z 30 tras za odpowiednie, czyli 93,3 procent. Mediana długości przejścia przez tkankę płuca wynosiła 5 milimetrów, wobec 23 dla tras wcześniej wykorzystanych przez doświadczonych lekarzy.
To wynik wykonalności, nie dowód bezpieczniejszych biopsji. Żaden pacjent nie przeszedł zabiegu prowadzonego według propozycji AI. Dwa plany nie przeszły oceny: jeden przecinał czterokrotnie więcej tkanki płuca niż trasa ręczna, drugi budził obawy o stabilność igły. Postępem jest sprawdzalna hipoteza planowania, nie autonomiczny nawigator ani udowodnione ograniczenie powikłań.
Każdą rekomendację poprzedzała praca ekspertów
Otwarte badanie w CVIR Oncology wykorzystało 30 kolejnych historycznych zabiegów wykonanych przez trzech radiologów interwencyjnych, każdego z co najmniej dziesięcioletnim doświadczeniem. Zdeidentyfikowana grupa obejmowała 17 mężczyzn i 13 kobiet, z medianą wieku 65 lat. Guzki miały 5–45 milimetrów, mediana 21. Lokalizacje obejmowały pięć szczytowych, siedem podopłucnowych, trzy przyśródpiersiowe i cztery przy podstawie płuca, stwarzając różne problemy anatomiczne.
Badacz wybierał osiowy przekrój TK, przycinał i powiększał obraz oraz dodawał promienistą siatkę w GIMP, a następnie konwertował obraz medyczny do PNG. Jeden autor oznaczał cel niebieskim okręgiem, a wrażliwe struktury czerwienią. Model otrzymywał więc obraz, na którym ludzie już zidentyfikowali cel i zagrożenia, a nie niezmienione badanie wymagające samodzielnego rozpoznania anatomii.
Standardowy prompt podawał pięć kryteriów: osiągnąć cel, ograniczyć przejście przez płuco oraz ominąć kości, szczeliny i śródpiersie. Każdy przypadek zaczynał się w nowym czacie. Badacze mogli doprecyzowywać polecenie, jeśli pominięto warunek, zapisując pierwszą odpowiedź obejmującą wszystkie parametry. Mediana wynosiła dwie iteracje, a rozstęp międzykwartylowy od jednej do trzech.
Dwaj doświadczeni radiolodzy interwencyjni, nieuczestniczący w pierwotnych zabiegach, oceniali trasy niezależnie i bez wiedzy o ich pochodzeniu. Testowano wiarygodny kąt po znacznej pracy przygotowawczej ludzi, nie autonomiczną segmentację, pełne planowanie 3D, nawigację na żywo czy robotyczne sterowanie igłą. Specjaliści pozostawali potrzebni na całej drodze.
Krótsze linie nie oznaczały lepszych wyników klinicznych
Mediana przejścia przez płuco dla GPT-4 wyniosła 5 milimetrów, rozstęp międzykwartylowy 0–25; dla tras ręcznych odpowiednio 23 i 5–57 milimetrów. Różnica była statystycznie istotna, p=0,0063. Zerowe przejście dotyczyło zmian podopłucnowych przy powierzchni opłucnej, gdzie bezpośrednia trasa może ominąć prawidłowy miąższ. Długość jest jednak tylko częścią ryzyka zabiegu.
Średni proponowany kąt wyniósł 179 stopni wobec 174 dla tras lekarzy, bez istotnej różnicy. Podobne średnie ukrywały duże różnice indywidualne. Główne wyniki podawały dobrą zgodność tylko w ośmiu przypadkach, przy kątach różniących się najwyżej o dziesięć stopni i podobnym przebiegu przez płaszczyzny tkanek. W innym miejscu autorzy opisali surowszą interpretację z trzema dopasowaniami. Nie wolno po cichu łączyć tych liczb w jeden wskaźnik zgodności.
Porównanie było nierówne: trasy lekarzy skutecznie wykonano u pacjentów, a propozycje modelu pozostawały liniami na obrazach. Przekonująca linia w jednym przekroju może nie działać w sąsiednich. Oddychanie, ułożenie ciała, zakotwiczenie, ograniczenia sprzętu i zmiany anatomii wpływają na rzeczywistą możliwość użycia.
Pierwotne zabiegi nie spowodowały poważnych powikłań. U czterech pacjentów wystąpiła minimalna odma ustępująca bez interwencji, u dwóch łagodne, samoograniczające się krwioplucie. To wyniki zabiegów prowadzonych przez lekarzy, nie GPT-4. Nie symulowano, czy alternatywne trasy je zmieniłyby, i nie można określić wydajności diagnostycznej nigdy niewykorzystanych tras.
Dwie porażki ujawniają sprzeczne ograniczenia
W przypadku 19 GPT-4 zaproponował 20 milimetrów przejścia przez płuco wobec 5 ręcznie: czterokrotnie więcej, wbrew celowi minimalizacji. Podał też szeroki zakres kątów zamiast precyzyjnego preferowanego planu. Oceniający uznali trasę za teoretycznie wykonalną, ale niezgodną z dobrą praktyką kliniczną. Samo omijanie oczywistych przeszkód nie wystarczało.
Przypadek 27 dotyczył guzka podopłucnowego. Propozycja niepotrzebnie przecinała 5 milimetrów płuca i budziła obawy o stabilność. Zbyt mały kontakt z tkanką podpierającą może niewystarczająco zakotwiczyć współosiową igłę biopsyjną, zwiększając podatność na ruch lub przemieszczenie podczas pobierania. Minimalna długość i stabilne mocowanie nie zawsze są tym samym celem.
Ujęcie dwuwymiarowe nie przedstawiało struktur nad i pod wybraną płaszczyzną ani całego przebiegu 3D. Radiolodzy zwykle przeglądają wiele przekrojów i rekonstrukcje wielopłaszczyznowe. GPT-4 nie wykrywał samodzielnie wszystkich zmian, nie segmentował narządów i nie określał niezawodnie marginesów bezpieczeństwa. Nie ustalono też minimalnego pięciomilimetrowego odstępu od podobojczykowych i pachowych pęczków naczyniowo-nerwowych, ponieważ pozycja pacjentów odsuwała je od ocenianych tras. Przyszłe systemy nie mogą tego zakładać.
Dalsze prompty nie były całkowicie ustandaryzowane, więc różni użytkownicy mogli kierować tym samym obrazem inaczej. Oddzielne sesje ograniczały przenoszenie informacji między przypadkami, ale nie dowodziły powtarzalności kąta przy ponownym uruchomieniu tego samego przypadku. Aktualizacje ogólnych usług AI dodają niepewność: walidacja musi dotyczyć kontrolowanej wersji, określonych wejść i udokumentowanego procesu, nie automatycznie późniejszych konfiguracji.
Wyspecjalizowane planery dają kontekst, nie ranking
Badanie dedykowanego systemu z 2024 roku łączyło wykrywanie zmian 3D z bayesowską optymalizacją trajektorii. Trenowano na 2147 guzkach z 219 skanów, a detekcję walidowano na kolejnych 235 skanach z 354 zmianami. Podane AUROC detekcji wynosiło 97,4 procent, średnia czułość 93,5 i swoistość 93,2 procent. Są to metryki wykrywania, nie odsetki klinicznie udanych biopsji.
Porównanie trajektorii obejmowało 150 pacjentów; dopasowanie oznaczało różnicę kąta poniżej pięciu stopni. Wykonalne trasy powstały w 85,3 procent ocenianych przypadków, 82 procent pasowało do rzeczywistych według tej definicji, a średnie odchylenie wśród dopasowanych wyniosło 2,30 stopnia. System wykonywał segmentację 3D i detekcję, których GPT-4 nie realizował, ale nadal była to retrospektywna ocena bez dowodu korzyści pacjentów.
Regułowy dowód koncepcji z 2023 roku generował po pięć tras dla 28 pacjentów. Czterej doświadczeni lekarze ocenili 140 ścieżek; oceny komputerowe i lekarskie były identyczne w 57,9 procent przypadków, a wszystkie 28 najlepszych tras wybranych algorytmicznie uznano za bezpieczne. Była to opinia oceniających, nie dowód zmniejszenia powikłań w praktyce.
TRAX, Trajectory Recommendation Algorithm for CT-guided Biopsy, szereguje około 20 000 tras po wskazaniu celu przez lekarza. W porównaniu 53 pacjentów zaślepieni oceniający uznali wszystkie trasy AI i lekarskie za bezpieczne. Oceny zgadzały się w 58 procent, w 23 procent preferowano TRAX, w 19 lekarza, bez istotnej statystycznie różnicy preferencji. Trasy TRAX były nieco krótsze; połowa biegła ukośnie, podczas gdy 81,1 procent tras lekarzy było osiowych.
Badania różniły się wejściami, danymi, definicjami i progami dopasowania, więc procenty nie tworzą bezpośredniego rankingu. Specjalistyczne planery mogą kodować anatomię, mierzyć odległości i konsekwentnie oceniać wiele wariantów. Modele ogólne są elastyczne, ale zależą od przygotowania i promptów. Nawet wsparcie porównywania opcji lub dokumentacji uzasadnienia wymaga oddzielenia sugestii od zatwierdzonych planów, pokazania całej anatomii i zachowania oceny człowieka.
Co musiałaby ustalić silniejsza walidacja
Powtarzanie identycznych przypadków i pełna standaryzacja promptów sprawdziłyby spójność; należy rejestrować częstość ludzkich korekt i stopień zmiany odpowiedzi. Analiza pełnej objętości TK potrzebuje segmentacji zmian, płuc, naczyń, żeber, szczelin, śródpiersia i innych struktur, jawnych marginesów oraz całego przebiegu. Łączenie modelu językowego z segmentacją wprowadza osobne ryzyka integracji wymagające walidacji.
Zewnętrzne dane wieloośrodkowe muszą obejmować różne skanery, rekonstrukcje, pozycje i lokalizacje zmian, nie jeden ośrodek onkologiczny. Prospektywne testy mogłyby zacząć się w trybie cienia bez wpływu na leczenie. Późniejsze kontrolowane badania porównywałyby planowanie wspomagane AI ze zwykłym, z końcową odpowiedzialnością radiologów, mierząc wydajność diagnostyczną, odmę, krwawienie, czas, promieniowanie, zmianę pozycji igły i powrót do zdrowia.
Porażki trzeba podawać oddzielnie, nie ukrywać w średnich. Bezpośrednie sterowanie robotem wymagałoby znacznie silniejszych dowodów i nadzoru nad wyrobem medycznym. Wynik 30 przypadków, 28 akceptowalnych planów i mediany przejścia krótszej o 18 milimetrów uzasadnia dalsze eksperymenty. Ręczne oznaczenia, improwizowane pytania, dwie odrzucone trasy i brak wyników pacjentów prowadzonych przez AI nie uzasadniają jednak natychmiastowego wdrożenia ani twierdzenia, że krótsze linie chatbota czynią biopsję bezpieczniejszą.
Źródła
Badanie wykonalności GPT-4 · Badanie planowania 3D · Planowanie regułowe · Porównanie TRAX · Indeks pierwotnej relacji