
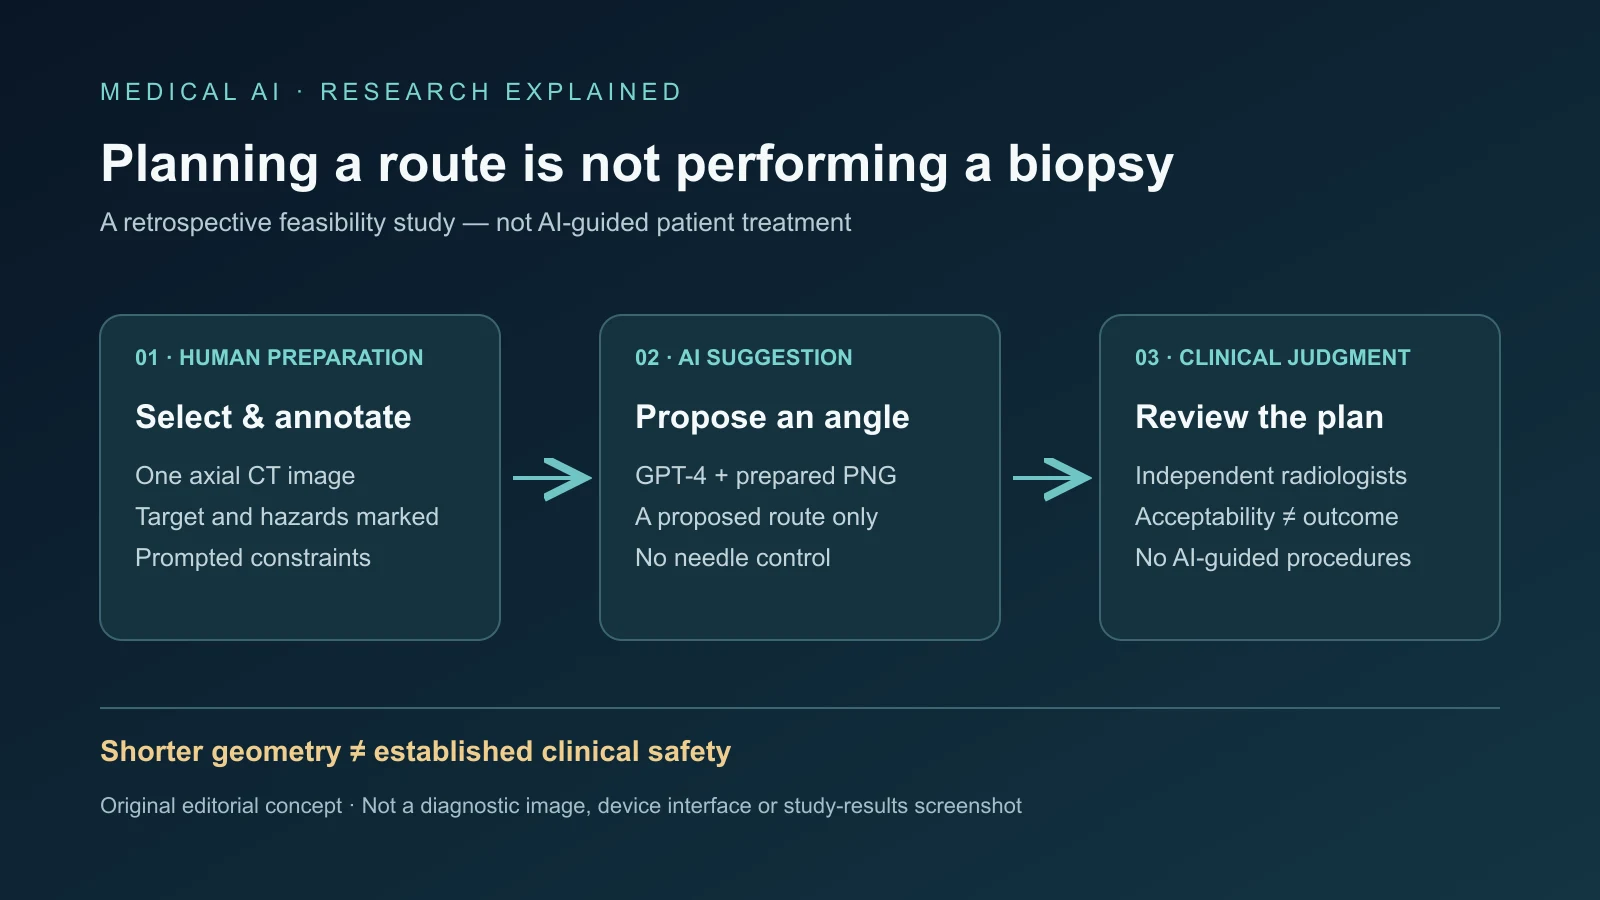
Une expérience rétrospective au Memorial Sloan Kettering Cancer Center a montré que GPT-4 pouvait proposer des angles d’entrée plausibles à partir d’images de scanner soigneusement préparées. Des radiologues indépendants ont jugé adéquats 28 trajets sur 30, soit 93,3 %. Les propositions traversaient une médiane de 5 millimètres de tissu pulmonaire, contre 23 pour les trajets déjà employés par des cliniciens expérimentés.
Ce sont des résultats de faisabilité, pas des preuves de biopsies plus sûres. Aucun patient n’a subi de procédure guidée par ces propositions. Deux plans ont échoué à l’examen : l’un traversait quatre fois plus de tissu pulmonaire que le trajet manuel, l’autre soulevait un problème de stabilité de l’aiguille. L’avancée utile est une hypothèse de planification testable, non un navigateur autonome ou une réduction démontrée des complications.
Une préparation experte précédait chaque recommandation
L’étude en libre accès dans CVIR Oncology utilisait 30 procédures historiques consécutives réalisées par trois radiologues interventionnels ayant chacun au moins dix ans d’expérience. La cohorte désidentifiée comptait 17 hommes et 13 femmes, d’âge médian 65 ans. Les nodules mesuraient 5–45 millimètres, médiane 21. Les localisations comprenaient cinq lésions apicales, sept sous-pleurales, trois para-médiastinales et quatre près de la base pulmonaire, avec des difficultés anatomiques différentes.
Un chercheur sélectionnait une coupe axiale, la recadrait et l’agrandissait, puis ajoutait une grille radiale dans GIMP avant de convertir l’image médicale en PNG. Un auteur entourait la cible en bleu et les structures sensibles en rouge. Le modèle recevait donc une image dont les cibles et dangers avaient déjà été repérés par des humains, non un examen brut exigeant une détection anatomique autonome.
Un prompt standard fournissait cinq critères : atteindre la cible, minimiser la traversée pulmonaire et éviter os, scissures et médiastin. Chaque cas commençait dans une nouvelle conversation. Les chercheurs pouvaient relancer si une condition manquait et retenaient la première réponse intégrant tous les paramètres. La médiane était de deux itérations, avec un intervalle interquartile d’une à trois.
Deux radiologues interventionnels expérimentés, non impliqués dans les procédures initiales, évaluaient indépendamment les trajets en ignorant leur origine. On testait un angle plausible après une préparation humaine importante, non la segmentation autonome, une planification tridimensionnelle complète, la navigation en direct ou le contrôle robotique d’une aiguille. Les spécialistes restaient indispensables dans toute la chaîne.
Une ligne plus courte n’était pas un meilleur résultat clinique
La traversée pulmonaire médiane de GPT-4 était de 5 millimètres, intervalle interquartile 0–25 ; les trajets manuels donnaient 23 et 5–57 millimètres. La différence rapportée était statistiquement significative, p=0,0063. Les traversées nulles concernaient des lésions sous-pleurales au contact de la plèvre, accessibles directement sans parenchyme normal. La longueur ne reste qu’un élément du risque.
L’angle moyen proposé était de 179 degrés contre 174 manuellement, sans différence significative. Des moyennes proches masquaient des écarts importants par patient. Les résultats principaux ne rapportaient une bonne concordance que dans huit cas, définie par des angles distants d’au plus dix degrés et des plans tissulaires similaires. Ailleurs, les auteurs donnaient une interprétation plus stricte aboutissant à trois concordances. Ces nombres ne doivent pas être fusionnés silencieusement en un taux unique.
La comparaison était déséquilibrée : les trajets des cliniciens avaient été exécutés avec succès sur des patients, tandis que ceux du modèle restaient des lignes sur des images. Une ligne convaincante dans une coupe peut devenir impraticable dans les coupes voisines. Respiration, position, ancrage, contraintes du matériel et anatomie changeante conditionnent l’usage réel.
Les procédures initiales n’avaient entraîné aucune complication majeure. Quatre patients avaient un pneumothorax minime résolu sans intervention ; deux une hémoptysie légère spontanément résolutive. Ces résultats appartiennent aux procédures médicales, pas à GPT-4. L’étude n’a pas simulé l’effet des trajets alternatifs et ne peut établir le rendement diagnostique de voies jamais utilisées.
Les deux échecs révèlent des contraintes concurrentes
Dans le Cas 19, GPT-4 proposait 20 millimètres de traversée contre 5 manuellement : quatre fois plus, contrairement à l’objectif de minimisation. Il offrait aussi une large plage d’angles plutôt qu’un plan préféré précis. Les évaluateurs jugeaient le trajet théoriquement faisable, mais incompatible avec une bonne pratique clinique. Éviter les obstacles évidents ne suffisait pas.
Le Cas 27 concernait un nodule sous-pleural. La proposition traversait inutilement 5 millimètres de poumon et inquiétait quant à la stabilité. Un contact trop court avec les tissus de soutien peut mal ancrer une aiguille coaxiale, favorisant mouvements ou déplacement pendant le prélèvement. Minimiser la distance et fixer l’aiguille ne sont pas toujours le même objectif.
Le dispositif bidimensionnel ne représentait ni les structures au-dessus et au-dessous du plan ni le trajet tridimensionnel complet. Les radiologues examinent normalement plusieurs coupes et des reconstructions multiplanaires. GPT-4 n’a pas repéré seul toutes les lésions, segmenté les organes ou défini des marges fiables. L’étude omettait aussi une marge minimale spécifiée de cinq millimètres des faisceaux neurovasculaires sous-claviers et axillaires, car la position des patients les éloignait des trajets. De futurs systèmes ne peuvent présumer cette condition.
Les relances n’étaient pas entièrement scriptées : différents utilisateurs pouvaient orienter la même image vers des réponses différentes. Les sessions séparées réduisaient la contamination entre cas, mais ne démontraient pas la répétabilité du même angle pour un cas identique. Les mises à jour des services généraux d’IA ajoutent une incertitude : la validation doit viser une version contrôlée, des entrées définies et une procédure documentée, non se transférer automatiquement aux configurations suivantes.
Les outils spécialisés donnent un contexte, pas un classement
Une étude spécialisée de 2024 associait détection tridimensionnelle de lésions et optimisation bayésienne des trajectoires. L’entraînement utilisait 2 147 nodules de 219 scanners ; la détection était validée sur 235 autres scanners comportant 354 lésions. L’AUROC rapportée était de 97,4 %, la sensibilité moyenne de 93,5 % et la spécificité de 93,2 %. Ce sont des mesures de détection, non des taux de biopsies cliniquement réussies.
La comparaison de trajectoires concernait 150 patients et définissait une concordance par moins de cinq degrés de différence. Des trajets faisables étaient produits dans 85,3 % des cas ; 82 % correspondaient aux voies réelles selon cette définition, avec 2,30 degrés d’écart moyen parmi les concordants. Le logiciel réalisait segmentation et détection 3D absentes de l’expérience GPT-4, mais restait rétrospectif, sans bénéfice patient démontré.
Une preuve de concept fondée sur des règles, en 2023, générait cinq trajets pour chacun de 28 patients. Quatre médecins expérimentés notaient les 140 voies ; les notes informatiques et médicales étaient identiques dans 57,9 % des cas et les 28 meilleures voies choisies par l’algorithme étaient jugées sûres. C’était un jugement d’évaluateurs, pas la preuve d’une baisse clinique des complications.
TRAX, Trajectory Recommendation Algorithm for CT-guided Biopsy, classe environ 20 000 voies une fois la cible identifiée par un médecin. Dans une comparaison de 53 patients, les lecteurs en aveugle jugeaient sûrs tous les trajets sélectionnés par l’IA ou les médecins. Les notes concordaient à 58 %, favorisaient TRAX à 23 % et le médecin à 19 %, sans différence significative de préférence. Les voies TRAX étaient légèrement plus courtes ; la moitié employait un plan oblique, tandis que 81,1 % des trajets médicaux étaient axiaux.
Entrées, jeux de données, définitions et seuils différaient : ces pourcentages ne permettent pas de classer directement les systèmes. Les outils spécialisés peuvent encoder l’anatomie, mesurer les distances et ordonner régulièrement beaucoup d’options. Les modèles généraux sont souples, mais dépendent fortement de la préparation et des prompts. Même pour comparer les possibilités ou documenter le raisonnement, l’interface doit distinguer suggestions et plans approuvés, montrer le trajet anatomique complet et conserver l’examen humain.
Ce qu’une validation plus solide devrait établir
Répéter des cas identiques et standardiser tous les prompts testerait la cohérence ; il faut documenter la fréquence et l’effet des corrections humaines. L’analyse native du volume complet devrait segmenter lésions, poumons, vaisseaux, côtes, scissures, médiastin et autres structures, définir des marges explicites et montrer toute la voie. Associer un modèle linguistique à la segmentation crée des risques d’intégration à valider séparément.
Des données externes multicentriques doivent couvrir appareils, reconstructions, positions et localisations au-delà d’un seul centre oncologique. Les tests prospectifs pourraient commencer en mode fantôme sans modifier les soins. Ensuite, des études contrôlées compareraient planification assistée et habituelle, sous responsabilité finale des radiologues, en mesurant rendement diagnostique, pneumothorax, saignement, durée, irradiation, repositionnement et récupération.
Les échecs doivent être publiés séparément, non masqués par les moyennes. L’exécution robotique directe exigerait des preuves bien plus fortes et une surveillance du dispositif. Les 30 cas, 28 plans acceptables et 18 millimètres de traversée médiane en moins justifient d’autres expériences. Annotations manuelles, relances improvisées, deux voies rejetées et aucun résultat de patients guidés par l’IA ne justifient ni déploiement immédiat ni affirmation que des lignes plus courtes dessinées par un chatbot rendent les biopsies plus sûres.
Sources
Étude de faisabilité GPT-4 · Étude de planification 3D · Planification par règles · Comparaison TRAX · Index du reportage initial