
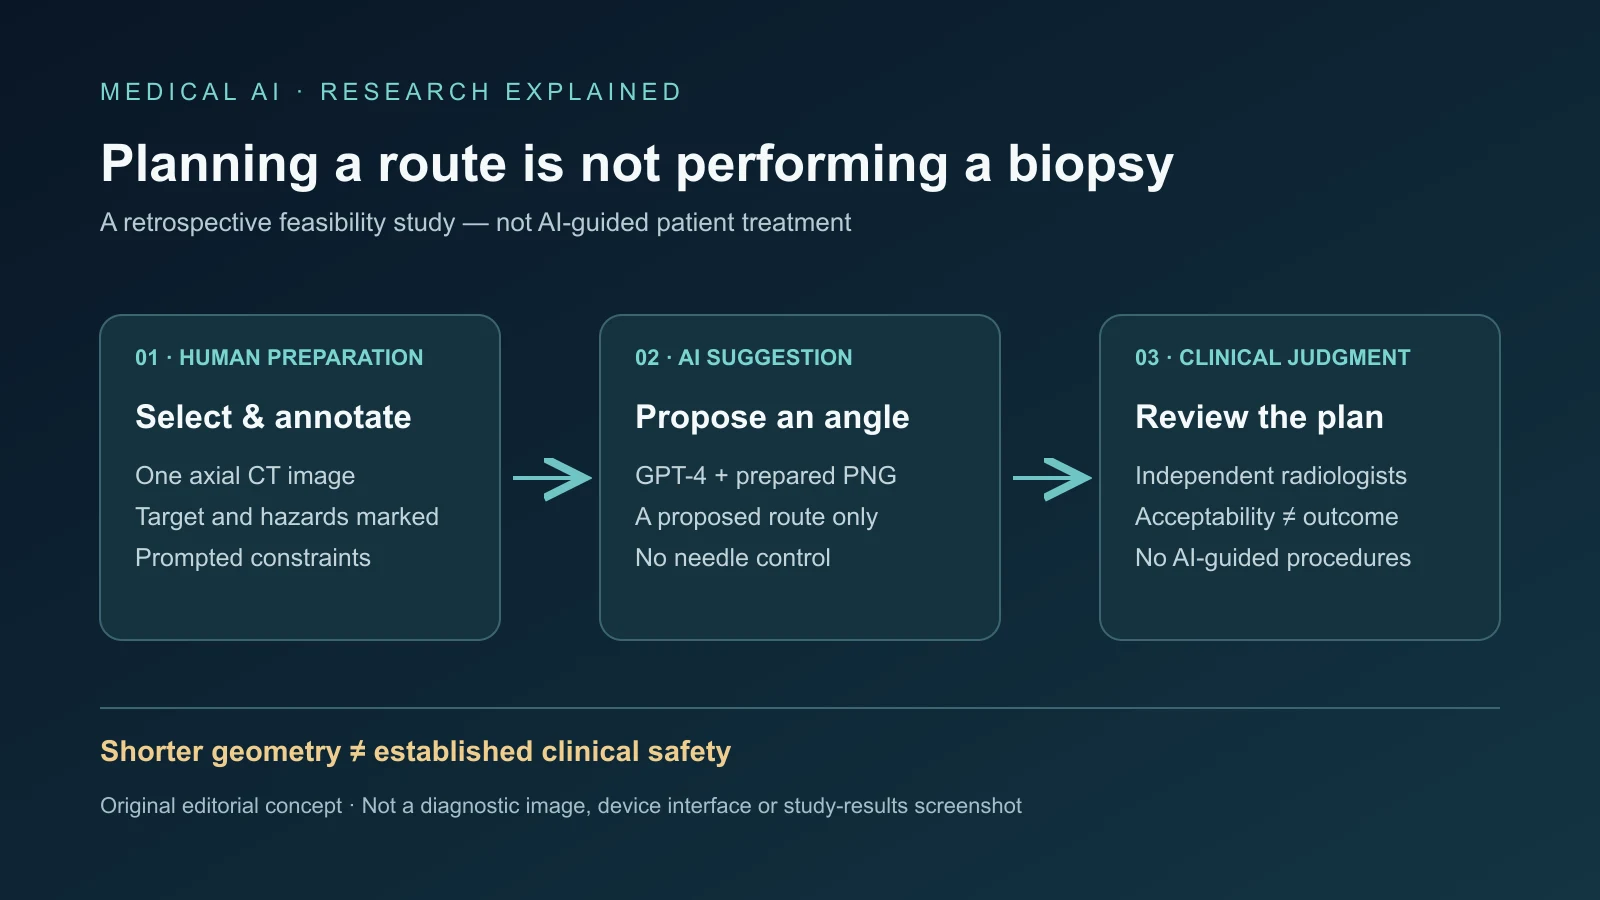
Um experimento retrospectivo no Memorial Sloan Kettering Cancer Center mostrou que GPT-4 podia propor ângulos de entrada plausíveis a partir de imagens de TC cuidadosamente preparadas. Radiologistas independentes consideraram adequados 28 de 30 trajetos, ou 93,3%. As propostas atravessavam uma mediana de 5 milímetros de tecido pulmonar, contra 23 nos trajetos já utilizados por médicos experientes.
São resultados de viabilidade, não evidência de biópsias mais seguras. Nenhum paciente passou por procedimento guiado pelas propostas da IA. Dois planos falharam na revisão: um atravessava quatro vezes mais tecido pulmonar que o trajeto manual, e outro levantava preocupação com a estabilidade da agulha. O avanço útil é uma hipótese de planejamento testável, não um navegador autônomo ou redução demonstrada de complicações.
A preparação especializada veio antes de toda recomendação
O estudo de acesso aberto em CVIR Oncology usou 30 procedimentos históricos consecutivos realizados por três radiologistas intervencionistas, cada um com pelo menos dez anos de experiência. A coorte desidentificada incluía 17 homens e 13 mulheres, mediana de 65 anos. Os nódulos mediam 5–45 milímetros, mediana de 21. Havia cinco lesões apicais, sete subpleurais, três paramediastinais e quatro próximas à base pulmonar, com desafios anatômicos diferentes.
Um pesquisador selecionava um corte axial, recortava e ampliava a imagem e adicionava uma grade radial no GIMP antes de converter o formato médico para PNG. Um autor marcava o alvo em azul e estruturas sensíveis em vermelho. O modelo recebia, portanto, uma imagem cujos alvos e perigos já haviam sido identificados por pessoas, não um exame intacto exigindo detecção anatômica independente.
Um prompt padronizado fornecia cinco critérios: atingir o alvo, minimizar travessia pulmonar e evitar ossos, fissuras e mediastino. Cada caso começava em um novo chat. Pesquisadores podiam acrescentar instruções quando faltasse uma condição, registrando a primeira resposta com todos os parâmetros. A mediana foi de duas iterações, com intervalo interquartil de uma a três.
Dois radiologistas intervencionistas experientes, sem participação nos procedimentos originais, avaliaram independentemente os trajetos sem conhecer sua origem. Testou-se um ângulo plausível após grande preparação humana, não segmentação autônoma, planejamento tridimensional completo, navegação ao vivo ou controle robótico da agulha. Especialistas continuaram necessários ao longo do processo.
Linhas menores não equivaleram a melhores resultados clínicos
A mediana de travessia do GPT-4 foi 5 milímetros, intervalo interquartil 0–25; para os trajetos manuais, 23 e 5–57 milímetros. A diferença relatada foi estatisticamente significativa, p=0,0063. Travessia zero ocorreu em lesões subpleurais junto à superfície pleural, onde um caminho direto pode evitar parênquima normal. O comprimento continua sendo apenas parte do risco do procedimento.
O ângulo médio proposto foi 179 graus contra 174 no trajeto manual, sem diferença estatisticamente significativa. Médias parecidas ocultavam diferenças importantes por caso. Os resultados principais relataram boa concordância em apenas oito casos, com ângulos dentro de dez graus e trajeto semelhante pelos planos teciduais. Em outro trecho, os autores descreveram interpretação mais estrita com três correspondências. Esses números não devem ser silenciosamente fundidos em uma única taxa.
A comparação era desigual: os trajetos médicos haviam sido executados com sucesso em pacientes, enquanto os da IA permaneciam linhas em imagens. Uma linha convincente em um corte axial pode não funcionar nos cortes vizinhos. Respiração, posição, ancoragem, limitações dos equipamentos e anatomia variável influenciam o uso real.
Os procedimentos originais não tiveram complicações graves. Quatro pacientes apresentaram pneumotórax mínimo resolvido sem intervenção; dois tiveram hemoptise leve e autolimitada. Esses resultados pertencem aos procedimentos médicos, não ao GPT-4. Não houve simulação de como os caminhos alternativos os alterariam, nem se pode estabelecer rendimento diagnóstico de trajetos nunca utilizados.
As duas falhas expõem restrições concorrentes
No Caso 19, GPT-4 propôs 20 milímetros de travessia pulmonar contra 5 no trajeto manual: quatro vezes mais, contrariando a minimização pedida. Também ofereceu uma faixa ampla de ângulos, não um plano preferencial preciso. Os revisores consideraram a proposta teoricamente viável, mas incompatível com boa prática clínica. Evitar obstáculos evidentes não bastava.
O Caso 27 envolvia um nódulo subpleural. O trajeto atravessava desnecessariamente 5 milímetros de pulmão e gerava dúvidas sobre estabilidade. Pouco contato com tecido de apoio pode deixar uma agulha coaxial de biópsia insuficientemente ancorada, sujeita a movimento ou deslocamento durante a coleta. Minimizar distância e fixar a agulha nem sempre são o mesmo objetivo.
A configuração bidimensional não representava estruturas acima ou abaixo do plano nem o percurso tridimensional completo. Radiologistas normalmente examinam vários cortes e reconstruções multiplanares. GPT-4 não detectou sozinho todas as lesões, segmentou órgãos ou definiu margens confiáveis. O estudo também omitiu uma margem mínima especificada de cinco milímetros dos feixes neurovasculares subclávios e axilares porque a posição dos pacientes os afastava dos trajetos. Sistemas futuros não podem presumir essa condição.
Os prompts posteriores não foram totalmente roteirizados, permitindo que usuários diferentes conduzissem a mesma imagem a respostas distintas. Sessões separadas reduziram contaminação entre casos, mas não demonstraram repetibilidade do ângulo em execuções do mesmo caso. Atualizações dos serviços gerais de IA acrescentam incerteza: a validação precisa se vincular a versão controlada, entradas definidas e processo documentado, não se transferir automaticamente para configurações posteriores.
Planejadores especializados dão contexto, não uma classificação simples
Um estudo específico de 2024 combinou detecção tridimensional de lesões e otimização bayesiana de trajetórias. Treinou com 2.147 nódulos de 219 exames e validou detecção em outros 235 exames contendo 354 lesões. A AUROC de detecção relatada foi 97,4%, a sensibilidade média 93,5% e a especificidade 93,2%. São métricas de detecção, não percentuais de biópsias clinicamente bem-sucedidas.
A comparação de trajetórias envolveu 150 pacientes e definiu correspondência como diferença angular inferior a cinco graus. Houve rotas viáveis em 85,3% dos casos avaliados; 82% correspondiam aos trajetos reais sob essa definição, com desvio médio de 2,30 graus entre as correspondências. O sistema fazia segmentação e detecção tridimensionais ausentes no GPT-4, mas continuava retrospectivo, sem benefício clínico demonstrado.
Uma prova de conceito baseada em regras, de 2023, gerou cinco trajetos para cada um de 28 pacientes. Quatro médicos experientes avaliaram 140 trajetos; notas de computador e médicos foram idênticas em 57,9% dos casos, e todos os 28 melhores caminhos escolhidos pelo algoritmo foram considerados seguros. Era julgamento dos revisores, não prova de redução de complicações em uso clínico.
TRAX, Trajectory Recommendation Algorithm for CT-guided Biopsy, classifica cerca de 20.000 rotas depois que um médico identifica o alvo. Em comparação com 53 pacientes, revisores cegados julgaram seguras todas as rotas escolhidas pela IA e pelos médicos. As notas coincidiam em 58%, favoreciam TRAX em 23% e os médicos em 19%, sem diferença estatisticamente significativa de preferência. Os caminhos TRAX eram ligeiramente menores; metade usava plano inclinado, enquanto 81,1% dos médicos eram axiais.
Entradas, conjuntos de dados, definições e limiares diferiam. Os percentuais não permitem ordenar diretamente os sistemas. Planejadores específicos codificam anatomia, medem distâncias e classificam muitas alternativas consistentemente. Modelos gerais são flexíveis, mas dependem de preparação e prompts. Mesmo para comparar opções ou documentar raciocínio, a interface precisa separar sugestões de planos aprovados, mostrar o percurso anatômico completo e preservar revisão humana.
O que uma validação mais forte precisaria estabelecer
Repetir casos idênticos e padronizar todos os prompts testaria consistência; estudos devem registrar frequência e efeito das correções humanas. A análise nativa de volume completo de TC precisaria segmentar lesões, pulmões, vasos, costelas, fissuras, mediastino e outras estruturas, definir margens explícitas e mostrar todo o trajeto. Combinar o modelo com segmentação cria riscos de integração que exigem validação própria.
Dados externos e multicêntricos devem abranger scanners, reconstruções, posições e localizações além de um centro oncológico. Testes prospectivos poderiam começar em modo sombra, sem influenciar o cuidado. Estudos controlados posteriores comparariam planejamento assistido e habitual, mantendo a decisão final com radiologistas qualificados e medindo rendimento diagnóstico, pneumotórax, sangramento, duração, radiação, reposicionamento e recuperação.
Falhas precisam ser relatadas separadamente, não escondidas em médias. Execução robótica direta exigiria evidências muito mais fortes e supervisão do dispositivo. Os 30 casos, 28 planos aceitáveis e 18 milímetros a menos na mediana justificam novos experimentos. Anotação manual, perguntas improvisadas, duas rotas rejeitadas e ausência de resultados de pacientes guiados pela IA não justificam implantação imediata nem afirmar que linhas menores desenhadas por um chatbot tornam biópsias mais seguras.
Fontes
Estudo de viabilidade GPT-4 · Estudo de planejamento 3D · Planejamento por regras · Comparação TRAX · Índice da reportagem original