
Das stärkste Ergebnis von HierHGT-DTI ist eine bessere Rangfolge von Verbindungen für Proteinziele, die im Training fehlten – nicht die Entdeckung eines validierten Medikaments. Zhangben Chen und Yaping Wan von der University of South China verbinden chemische Struktur und Proteinsequenz in einem typisierten, mehrskaligen Graphen. Ihre Resultate sprechen für strengere Evaluierungen und zeigen zugleich, wie viel Vertrautes auch ein „Cold Start“ bewahren kann.
Die am 14. September 2026 veröffentlichte BMC-Bioinformatics-Studie vergleicht sechs Alternativen auf DrugBank, BioSNAP und BindingDB. Praktisch geht es darum, welche Wirkstoff-Zielprotein-Paare zuerst begrenzte biochemische oder zelluläre Tests erhalten. Ein Prognosewert bestätigt weder physische Bindung noch biochemische Mechanismen oder klinische Wirksamkeit.
Wo der Benchmark-Vorteil gilt und wo nicht
Die Forscher nutzten zufällige, Cold-Drug- und Cold-Protein-Splits. Zufällige Splits halten Paare zurück, können aber dieselben Wirkstoffe und Proteine im Training und Test enthalten. Cold-Drug hält ganze Wirkstoffidentitäten zurück; Cold-Protein schließt Testsequenzen auch aus der Validierung aus. Letzteres ähnelt eher einem neu relevanten Ziel ohne etablierte Ligandendaten.
HierHGT-DTI führte in allen sechs DrugBank-/BioSNAP-Settings. MolTrans, TransformerCPI, DrugBAN, DO-GMA, GeNNius und HiGraphDTI verwendeten dieselben Splits und fünf Zufalls-Seeds, statt Ergebnisse aus anderen Publikationen zu übernehmen. Mehrere Seeds verringern die Abhängigkeit von günstiger Initialisierung.
DrugBanks Cold-Protein-AUROC betrug 0,864, die AUPR 0,878. Die stärkste Baseline erreichte einen AUROC von 0,776: 8,8 Prozentpunkte Abstand; der AUPR-Vorsprung betrug 7,9 Punkte. BioSNAP erreichte 0,863 und 0,866 gegenüber einem stärksten Baseline-AUROC von 0,805, also 5,8 Punkten Abstand. Diese Hauptunterschiede überstanden die Mehrfachvergleichskorrektur für die DrugBank-/BioSNAP-Benchmark-Familie.
BindingDB verhindert eine Behauptung allgemeiner Überlegenheit. HierHGT-DTI führte beim Cold-Protein-AUPR mit 0,681, HiGraphDTI aber beim AUROC mit 0,835 gegenüber 0,831. HiGraphDTI gewann dort auch bei zufälligen und Cold-Drug-Splits. Zufällige AUROC/AUPR waren 0,934/0,837 gegenüber HierHGT-DTIs 0,932/0,829.
Die aufbereiteten Datensätze unterscheiden sich: DrugBank hatte 34.748 Paare und 17.250 Positive, BioSNAP 27.457 und 13.830, BindingDB 24.743 und 5.784. Die Positivrate betrug bei BindingDB 23,4%, bei den anderen nahezu 50%. AUROC fasst die positive-versus-negative Rangfolge über Schwellen hinweg zusammen. AUPR betont Präzision und Recall beim Auffinden Positiver, ändert sich aber mit deren Häufigkeit; Rohwerte sind zwischen diesen Datensätzen nicht unmittelbar vergleichbar.
Eine unbekannte Identität bedeutet nicht unbekannte Biologie
Genetik, Krankheitsbiologie, Resistenzforschung und Signalwegdaten können neue Ziele ergeben, ohne genügend getestete Liganden für übliche überwachte Verfahren. Arbeiten über unerforschte Therapieziele zeigen die Bedeutung dünner Interaktionshistorien. Forschung zur Benchmark-Memorisierung warnt jedoch, dass vertraute chemische Ähnlichkeit Tests leichter macht als den Einsatz.
In konventionellen Cold-Drug-Splits von DrugBank und BioSNAP teilten mehr als die Hälfte der Testverbindungen ein Bemis–Murcko-Gerüst mit Trainings- oder Validierungsverbindungen. Es erfasst Kernringe und ihre Verbindung: keine molekulare Identität, aber potenziell erhebliche strukturelle Vertrautheit.
In zusätzlichen gerüstdisjunkten Tests fiel HierHGT-DTIs AUROC um 2,5 Punkte auf BioSNAP, 2,1 auf DrugBank und 1,4 auf BindingDB. Nur dieses Modell wurde unter dem strengeren Protokoll getestet; daraus folgt keine neue relative Rangfolge gegenüber den sechs Baselines.
Cold-Protein hat eine entsprechende Grenze. Identische Sequenzen fehlten, doch Proteine wurden nicht nach Sequenzfamilien geclustert und getrennt. Enge Homologe konnten beide Seiten verbinden. Belegt ist damit Transfer über identische Proteine hinaus, nicht zu weit entfernten Familien.
Wie molekulare Details zum Paarwert werden
Eingaben sind Wirkstoff-SMILES für die chemische Struktur und Aminosäuresequenzen des Ziels. Experimentell gelöste dreidimensionale Strukturen sind nicht nötig. Das kompakte ESM-2 mit acht Millionen Parametern liefert pro Rest ein 320-dimensionales Embedding und vorhergesagte Kontaktkarten. Das erschließt reine Sequenzziele, lässt aber offen, welcher Gewinn aus vortrainierten Merkmalen statt Graphorganisation stammt.
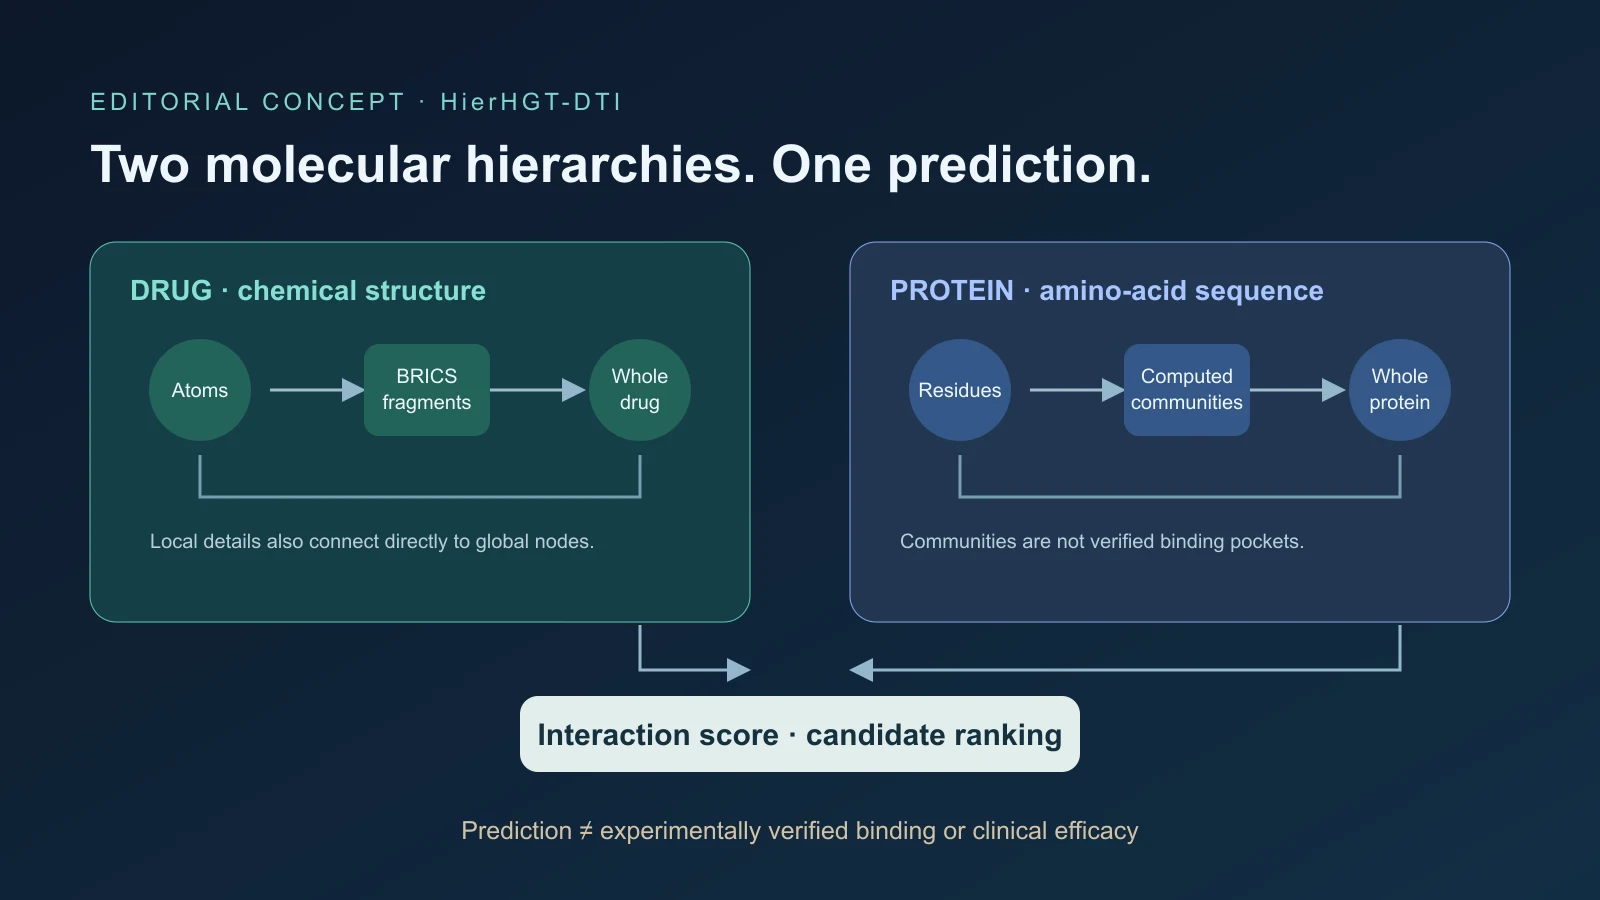
Jedes Kandidatenpaar wird ein heterogener Graph mit sechs Knotentypen. Auf Wirkstoffseite stehen Atome, Teilstrukturen und ein Wirkstoff-Superknoten; auf Proteinseite Reste, Restgemeinschaften und ein Protein-Superknoten. Atomdeskriptoren haben 74 Dimensionen, darunter Element, Valenz, Ladung, Aromatizität, Hybridisierung und Chiralität. RDKit erzeugt mit regelbasierter BRICS-Fragmentierung chemisch sinnvolle Teilstrukturen.
Die Proteinseite behält vollständige Sequenzen, statt lange Proteine abzuschneiden; überlappende Fenster liefern Kontakte bei zu langen Eingaben. Sequenznähe, prognostizierte Kontakte und Embedding-Ähnlichkeit verbinden Reste, Louvain-Clustering bildet Gemeinschaften. Der Code nennt sie „pockets“, doch es sind berechnete Gruppen, keine experimentell gemessenen Ligandenbindetaschen.
Benachbarte Ebenen sind bidirektional verbunden: Atom–Teilstruktur–Wirkstoff und Rest–Gemeinschaft–Protein. Direkte Atom-Wirkstoff- und Rest-Protein-Abkürzungen tragen feine Informationen zu globalen Knoten. Eine bidirektionale Kante zwischen den beiden Superknoten existiert in positiven und ungelabelten Paaren; sie verrät deshalb kein Label.
Der Graph besitzt 18 gerichtete Relationstypen. Zwei heterogene Graph-Transformer-Schichten mit vier Attention-Heads und Dimension 128 behandeln Beziehungen unterschiedlich. Jeder Knoten sammelt Nachrichten je eingehender Relation; eine gelernte Zuweisung kombiniert sie anhand von Beziehungspräferenzen und Nachbarzahlen. Der Prädiktor kombiniert Wirkstoff-/Proteinvektoren, elementweise Produkte und absolute Differenzen zum Interaktionswert.
Warum die Hierarchie keine bewiesene Ursache ist
Ohne Zwischenhierarchie änderte sich AUPR in sechs DrugBank-/BioSNAP-Settings nur um −0,0042 bis +0,0041. Keiner dieser Vergleiche war signifikant; die komplette bilaterale Hierarchie führte verwandte Varianten nur in drei Settings an. Ohne direkte Detail-zu-Global-Abkürzungen sank die mittlere AUPR in allen sechs um 0,0002–0,0109.
Auch das ist keine eindeutige Kausalität. Nach Korrektur über alle 96 Tests blieb keine Ablation signifikant. Die gemeinsame Entfernung beider Shortcut-Familien verhindert außerdem, Wirkstoff- und Proteinseite getrennt zuzuordnen.
Eine nachträgliche Entfernung in einem BioSNAP-Checkpoint senkte AUROC bei Shortcuts um 0,239, bei proteininternen Relationen um 0,069 und bei Hierarchie um 0,038. Das diagnostiziert Abhängigkeiten eines trainierten Modells, nicht die Ursache seiner allgemeinen Überlegenheit. Vertretbar ist ein wirksames integriertes Mehrwegesystem: Direkte Pfade erscheinen hilfreich, die Zwischenhierarchie zeigt uneinheitlichen Nutzen.
Unbekannte Negative und eine kleine Interpretation
Positive Labels sind erfasste Interaktionen; viele vermeintliche Negative sind dagegen nur unbeobachtete Paare. „Nicht erfasst“ kann ungetestet bedeuten, nicht biologisch unmöglich. DrugBanks deduplizierter Pool enthielt 17.250 Positive und 17.498 Kandidaten-Negative. Ursprüngliche Metadaten dokumentierten Kandidatenuniversum, Seed, Gradgewichtung, Gerüst- und Proteinähnlichkeitskontrollen nicht vollständig.
Die Kandidatenkonstruktion beeinflusste Resultate. Endpunktgradbewusstes Sampling verringerte AUPR in ausgewählten Tests gegenüber gleichverteiltem Sampling um 0,040–0,067. Ein Verhältnis von drei Kandidaten-Negativen zu einem Positiven ergab AUPR von 0,680–0,878. Absolute Leistung hängt somit vom Screening-Pool ab.
Wie Forschung zur Precision-Recall-Evaluierung erläutert, kann AUROC bei vielen Negativen beruhigend wirken, während die Präzision an der Listenspitze praktisch wichtiger bleibt. BindingDBs unterschiedliche Rangfolgen verdeutlichen das. Keine Metrik schätzt ohne prospektiven Test Labor-Trefferraten.
Ein externes Interpretationsbeispiel untersuchte fünf erfasste positive Interaktionen mit GABAA-Rezeptor-Alpha-Untereinheiten, darunter Clonazepam, Isofluran und Desfluran. Die Überlappung der fünf höchstbewerteten Reste mit erwarteten groben Regionen reichte von null bis fünf. Ein unbereinigter Permutationswert erreichte 0,050, ein anderer 0,077; die übrigen waren schwächer. Das validierte weder physische Bindungsstellen noch Mechanismen. Attention zeigt einflussreiche Eingaben, nicht automatisch biochemische Ursachen.
Reproduktion heute, prospektive Belege als nächster Schritt
Feste Vorverarbeitung nutzte Kontaktschwelle 0,5, Louvain-Auflösung 1,0 und mindestens drei Reste je Gemeinschaft. Das wurde nicht systematisch optimiert. Andere Schwellen, Clustering-Verfahren oder größere ESM-2-Repräsentationen könnten Ergebnisse ändern. Ein einfacherer Prädiktor mit denselben Embeddings bleibt nötig, um den typisierten Graphen zu isolieren.
Die Läufe verwendeten eine Nvidia RTX 4090 mit vorberechneten Molekül- und Proteineingaben. Über neun Hauptkombinationen von Datensatz und Split dauerte Training 26,8–43,6 Minuten je Seed. Mittlere Testinferenz dauerte 5,3–11,1 Sekunden, etwa 592–890 Beispiele je Sekunde, bei 1,53–2,54GiB maximal zugewiesenem GPU-Speicher. Sequenzvorberechnung kommt außerhalb dieser Trainingszeiten hinzu.
Das Reproduktionspaket enthält Code, Konfigurationen, aufbereitete Splits, Manifeste, Ergebnisübersichten und Anleitungen. Geordnete Aufzeichnungen sind ebenfalls wichtig; der verwandte Artikel über technische Wissensbasen behandelt durchsuchbare Annahmen, nicht Genauigkeitsbelege für dieses Modell.
Entscheidend wären Proteinfamilien-Holdouts mit denselben Baselines, Kandidaten, Seeds, Metriken und Tuning-Budgets; ein eingefrorenes Modell mit neuer Zielprotein-Bibliothek und verblindeten Assays; sowie repräsentationskontrollierte Ablationen mit getrennten Wirkstoff-/Protein-Shortcuts. Positive-Unlabeled-Lernen vermeidet, alle unregistrierten Paare als negativ zu behandeln. Zeitliche Splits trainieren vor einem Stichtag und testen spätere Entdeckungen ohne Zukunftswissen in der Vorverarbeitung.
Eine prospektive Studie sollte Bindung, funktionelle Aktivität, Fehlpositive und Anreicherung gegenüber praktischen Alternativen berichten. Negative Resultate könnten Sequenzähnlichkeit oder Datenbankverzerrung aufdecken. Bislang priorisiert HierHGT-DTI Kandidaten und ersetzt weder Docking, biochemische Assays, Zellforschung, Toxikologie noch klinische Prüfung. Die stärkste Benchmark-Evidenz verdient Reproduktion, keine Umdeutung zur Arzneimittelentdeckung.