
El resultado más sólido de HierHGT-DTI es clasificar mejor compuestos para proteínas excluidas del entrenamiento, no descubrir un medicamento validado. Zhangben Chen y Yaping Wan, de la University of South China, combinan estructura química y secuencia proteica en un grafo tipado multiescala. Los resultados apoyan evaluaciones más exigentes, pero muestran cuánto conocimiento familiar conserva el “arranque en frío”.
El estudio de BMC Bioinformatics, publicado el 14 de septiembre de 2026, compara seis alternativas en DrugBank, BioSNAP y BindingDB. Su promesa es priorizar qué pares compuesto–diana merecen primero los escasos ensayos bioquímicos o celulares. Una puntuación no confirma unión física, mecanismo bioquímico ni eficacia clínica.
Dónde se sostiene la ventaja y dónde no
Los investigadores utilizan particiones aleatorias, cold-drug y cold-protein. Las aleatorias reservan pares pero pueden conservar los mismos fármacos y proteínas entre entrenamiento y prueba. Cold-drug excluye identidades completas de fármacos; cold-protein excluye las secuencias de prueba también de la validación. Esta última aproxima mejor una diana nueva sin datos establecidos de ligandos.
HierHGT-DTI lidera las seis configuraciones DrugBank/BioSNAP. MolTrans, TransformerCPI, DrugBAN, DO-GMA, GeNNius y HiGraphDTI utilizan particiones equivalentes y las mismas cinco semillas aleatorias, no cifras copiadas de otros artículos. Repetir semillas reduce la dependencia de una inicialización favorable.
En DrugBank cold-protein, AUROC alcanza 0,864 y AUPR 0,878. La mejor referencia tiene AUROC 0,776: una diferencia de 8,8 puntos porcentuales; la ventaja AUPR es 7,9 puntos. BioSNAP registra 0,863 y 0,866, frente a una mejor AUROC de referencia de 0,805, es decir, 5,8 puntos. Estas diferencias principales sobreviven a la corrección por comparaciones múltiples de la familia DrugBank/BioSNAP.
BindingDB impide afirmar superioridad universal. HierHGT-DTI lidera AUPR cold-protein con 0,681, pero HiGraphDTI obtiene mejor AUROC, 0,835 frente a 0,831. HiGraphDTI también lidera las particiones aleatoria y cold-drug. Sus AUROC/AUPR aleatorias son 0,934/0,837, frente a 0,932/0,829.
Los datos preparados difieren: DrugBank contiene 34.748 pares y 17.250 positivos; BioSNAP, 27.457 y 13.830; BindingDB, 24.743 y 5.784. Los positivos representan el 23,4% en BindingDB y cerca del 50% en los otros. AUROC resume el orden entre positivos y negativos a distintos umbrales. AUPR enfatiza precisión y exhaustividad entre positivos recuperados, pero depende de su prevalencia; los valores brutos no se comparan directamente entre estos conjuntos.
Una identidad nueva no implica biología desconocida
La genética, las enfermedades, la resistencia o las vías biológicas pueden producir dianas sin suficientes ligandos probados para la supervisión convencional. Los trabajos sobre dianas terapéuticas inexploradas muestran por qué importa la escasez de interacciones registradas. La investigación sobre memorización de benchmarks advierte, sin embargo, que parecerse a compuestos familiares puede hacer las pruebas más fáciles que el despliegue.
En las particiones cold-drug convencionales de DrugBank y BioSNAP, más de la mitad de los compuestos de prueba comparten un andamio Bemis–Murcko con entrenamiento o validación. Representa anillos centrales y su estructura de unión: no identidad molecular, pero sí posible familiaridad estructural importante.
En pruebas adicionales sin andamios compartidos, AUROC de HierHGT-DTI cae 2,5 puntos en BioSNAP, 2,1 en DrugBank y 1,4 en BindingDB. Solo este modelo sigue ese protocolo más estricto; no permite establecer una nueva clasificación relativa frente a las seis referencias.
Cold-protein tiene una limitación paralela. Se excluyen secuencias idénticas, pero no se separan proteínas tras agruparlas por familias. Homólogos cercanos pueden quedar a ambos lados. La evidencia muestra transferencia más allá de proteínas idénticas, no una transferencia demostrada hacia familias lejanas.
Cómo los detalles moleculares generan una puntuación
Las entradas son cadenas SMILES de la estructura química y secuencias de aminoácidos de la diana; no necesitan estructuras tridimensionales resueltas experimentalmente. ESM-2 compacto, de ocho millones de parámetros, aporta representaciones de 320 dimensiones por residuo y mapas de contactos predichos. Permite usar dianas conocidas solo por secuencia, pero deja sin aislar cuánto mejora el preentrenamiento y cuánto el grafo.
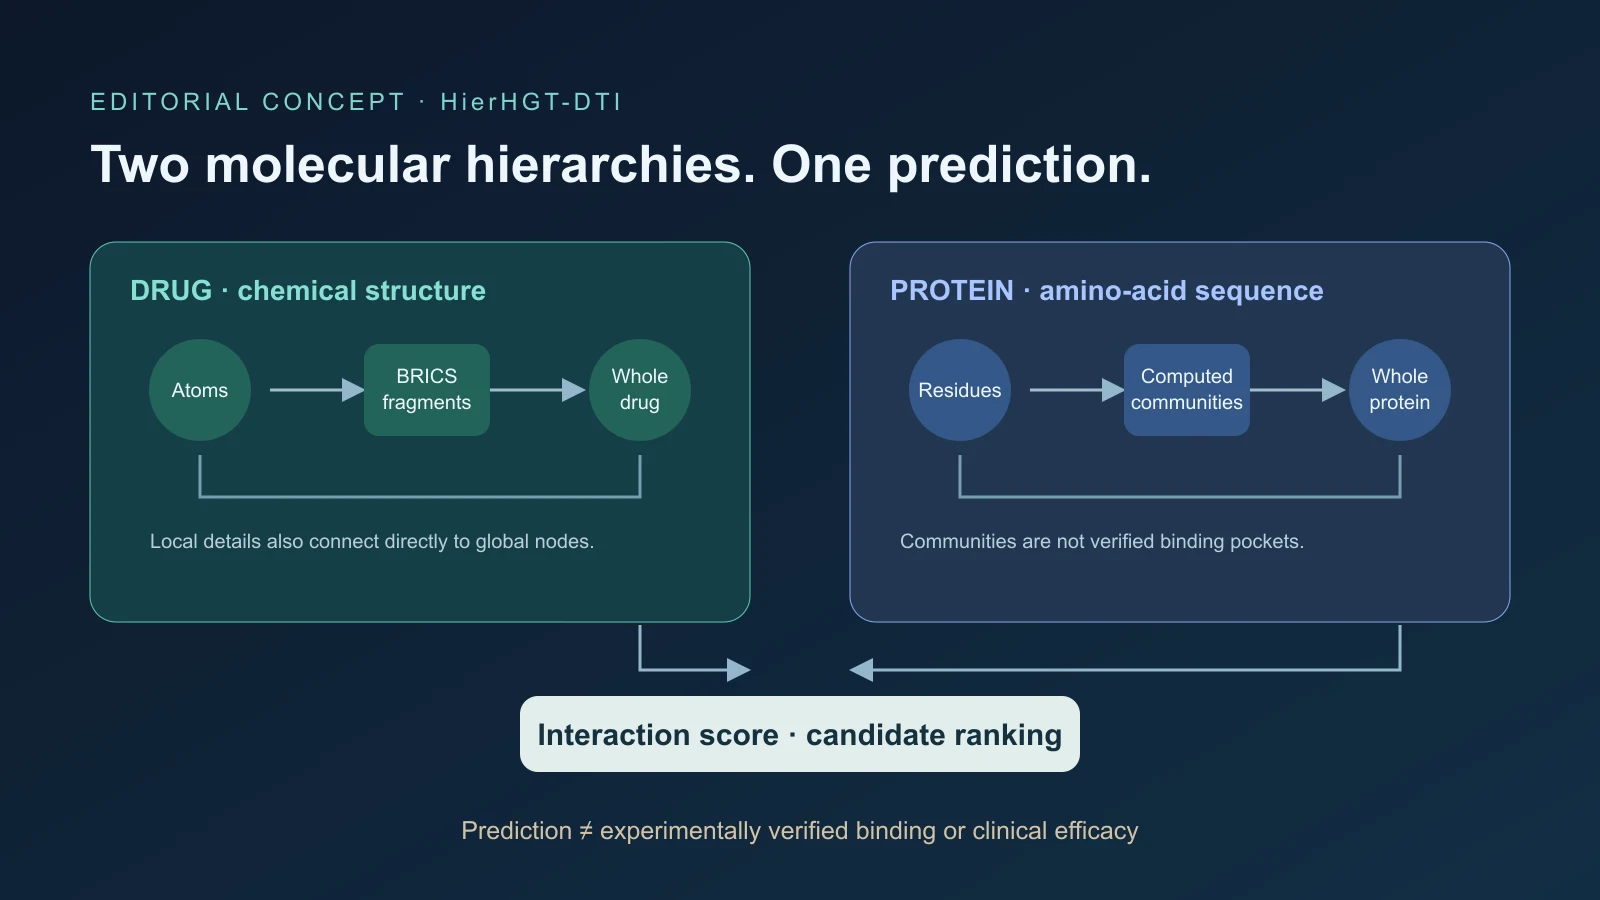
Cada par forma un grafo heterogéneo de seis tipos de nodos. El fármaco incluye átomos, subestructuras y supernodo global; la proteína incluye residuos, comunidades y supernodo global. Los descriptores atómicos tienen 74 dimensiones, entre ellas elemento, valencia, carga, aromaticidad, hibridación y quiralidad. La fragmentación BRICS de RDKit genera subestructuras químicamente significativas mediante reglas.
La rama proteica conserva secuencias completas sin truncar las largas; ventanas superpuestas producen contactos cuando una pasada no basta. Proximidad de secuencia, contactos predichos y similitud de representaciones conectan residuos; Louvain forma comunidades. El código las llama “pockets”, pero son agrupaciones calculadas, no bolsillos de unión medidos experimentalmente.
Las escalas adyacentes se conectan bidireccionalmente: átomo–subestructura–fármaco y residuo–comunidad–proteína. Atajos directos átomo–fármaco y residuo–proteína llevan detalles al nivel global. La arista bidireccional entre supernodos existe en pares positivos y sin etiquetar, por lo que no revela la respuesta.
El grafo utiliza 18 relaciones dirigidas. Dos capas de transformador heterogéneo, con cuatro cabezas de atención y dimensión oculta 128, distinguen relaciones. Cada nodo reúne mensajes por relación entrante; una asignación aprendida los combina según preferencias y número de vecinos. El predictor une vectores fármaco/proteína, productos elemento a elemento y diferencias absolutas para calcular la interacción.
La jerarquía no es una causa probada de la mejora
Retirar la jerarquía intermedia cambia AUPR solo entre −0,0042 y +0,0041 en seis configuraciones DrugBank/BioSNAP. Ninguna comparación jerárquica es significativa; la versión bilateral completa lidera variantes relacionadas solo tres veces. Retirar los atajos directos reduce AUPR media en las seis, entre 0,0002 y 0,0109.
Tampoco eso demuestra causalidad definitiva. Ninguna ablación sigue siendo significativa tras corregir los 96 ensayos. Eliminar juntas ambas familias de atajos impide además atribuir el efecto al lado del fármaco o de la proteína.
La retirada posterior al entrenamiento en un checkpoint BioSNAP reduce AUROC en 0,239 para atajos, 0,069 para relaciones internas de la proteína y 0,038 para jerarquía. Diagnostica dependencias de un modelo concreto, no la causa de su ventaja general. La interpretación defendible es un sistema integrado eficaz con varias rutas: las directas parecen útiles, la jerarquía intermedia tiene beneficios medidos inconsistentes.
Negativos desconocidos y una pequeña prueba interpretativa
Los positivos son interacciones registradas, pero muchos supuestos negativos son pares no observados. “No registrado” puede significar no probado, no biológicamente imposible. DrugBank deduplicado contiene 17.250 positivos y 17.498 candidatos negativos. Los metadatos originales no documentan por completo universo de candidatos, semilla, ponderación por grado, controles de andamios o similitud proteica.
Cambiar los candidatos modifica los resultados. Un muestreo que considera el grado de los extremos reduce AUPR 0,040–0,067 frente al uniforme en pruebas seleccionadas. Tres candidatos negativos por positivo producen AUPR 0,680–0,878. El diseño del conjunto de cribado altera la prestación absoluta.
Como explica la investigación sobre evaluación precisión-exhaustividad, AUROC puede tranquilizar con muchos negativos mientras la precisión en los primeros puestos importa más operativamente. Las clasificaciones contradictorias de BindingDB ilustran la diferencia. Ninguna métrica estima aciertos de laboratorio sin ensayo prospectivo.
Una prueba externa examina cinco interacciones positivas con subunidades alfa del receptor GABAA, incluidas clonazepam, isoflurano y desflurano. La coincidencia de los cinco residuos mejor clasificados con regiones generales esperadas va de cero a cinco. Una permutación sin ajustar alcanza 0,050, otra 0,077; las demás son más débiles. No valida sitios físicos ni mecanismos. La atención identifica entradas influyentes, no automáticamente causas bioquímicas.
Reproducibilidad ahora, evidencia prospectiva después
El preprocesamiento fijo incluye umbral de contacto 0,5, resolución Louvain 1,0 y al menos tres residuos por comunidad. No se optimiza sistemáticamente. Otros umbrales, agrupaciones o ESM-2 mayores podrían alterar resultados. Sigue faltando un predictor simple con las mismas representaciones para aislar la aportación del grafo tipado.
Las ejecuciones utilizan una Nvidia RTX 4090 y entradas moleculares y proteicas precalculadas. En nueve combinaciones principales de datos y partición, entrenar requiere 26,8–43,6 minutos por semilla. La inferencia de prueba media tarda 5,3–11,1 segundos, unos 592–890 ejemplos por segundo, con 1,53–2,54GiB de memoria GPU máxima asignada. El precálculo de secuencias añade trabajo fuera de esos tiempos.
El paquete de reproducción aporta código, configuraciones, particiones procesadas, manifiestos, resúmenes e instrucciones. También importan los registros organizados; el artículo relacionado sobre una base técnica consultable trata de preservar supuestos, no de demostrar la precisión de este modelo.
Las pruebas decisivas son excluir familias proteicas con referencias, candidatos, semillas, métricas y presupuestos iguales; congelar el modelo para ordenar una biblioteca de una diana nueva antes de ensayos ciegos; y hacer ablaciones controladas por representación, separando atajos de fármaco y proteína. El aprendizaje positivo-no etiquetado evitaría tratar como negativo todo par no registrado. Particiones temporales entrenarían antes de una fecha y predecirían descubrimientos posteriores sin filtrar conocimiento futuro al preprocesamiento.
Un estudio prospectivo debería publicar unión confirmada, actividad funcional, falsos positivos y enriquecimiento frente a alternativas prácticas. Resultados negativos podrían revelar similitud engañosa o sesgo de bases. Por ahora HierHGT-DTI prioriza candidatos, no sustituye docking, bioquímica, células, toxicología ni evaluación clínica. Sus mejores benchmarks merecen reproducción, no convertirse en anuncios de medicamentos descubiertos.