
HierHGT-DTIの最も強い結果は、学習時に除外したタンパク質標的に対する化合物の順位付け改善であり、検証済み医薬品の発見ではない。南華大学のZhangben ChenとYaping Wanは、化学構造とタンパク質配列を型付きマルチスケールグラフに組み合わせた。結果は厳格な評価の重要性を示す一方、「コールドスタート」にも既知の情報が残ることを明らかにする。
2026年9月14日公開のBMC Bioinformatics論文は、DrugBank、BioSNAP、BindingDBで6つの比較手法を評価した。実用上の狙いは、限られた生化学・細胞実験をどの化合物と標的の組に先に割り当てるかという優先順位付けだ。予測スコアは物理的結合、生化学的機序、臨床効果を確認しない。
優位性が成立する場所と、成立しない場所
評価はランダム、コールド薬剤、コールドタンパク質の3分割を用いた。ランダム分割はペアを除外しても、同じ薬剤やタンパク質が学習と試験に残り得る。コールド薬剤は薬剤全体の同一性を除外し、コールドタンパク質は試験配列を学習・検証から除く。後者は配位子データが乏しい新しい標的に近い。
HierHGT-DTIはDrugBankとBioSNAPの全6設定で首位だった。MolTrans、TransformerCPI、DrugBAN、DO-GMA、GeNNius、HiGraphDTIも同じ分割と5つの乱数シードを使い、別論文の数値を寄せ集めた比較ではない。複数シードは有利な初期化への依存を減らす。
DrugBankのコールドタンパク質AUROCは0.864、AUPRは0.878だった。最強比較手法のAUROCは0.776で、差は8.8ポイント、AUPR差は7.9ポイント。BioSNAPは0.863と0.866で、最強比較手法のAUROC0.805との差は5.8ポイントだった。これらの主な差はDrugBank/BioSNAP評価群の多重比較補正後も残った。
BindingDBは普遍的優位性を否定する。HierHGT-DTIはコールドタンパク質AUPR0.681で首位だが、AUROCはHiGraphDTIが0.835対0.831で上回った。HiGraphDTIはランダムとコールド薬剤でも首位。ランダム分割のAUROC/AUPRは0.934/0.837で、HierHGT-DTIは0.932/0.829だった。
前処理後のDrugBankは34,748ペア・17,250陽性、BioSNAPは27,457・13,830、BindingDBは24,743・5,784だった。陽性率はBindingDBが23.4%、他の2つは約50%。AUROCは閾値全体で陽性と陰性の順位を要約する。AUPRは検出した陽性の適合率と再現率を重視するが、陽性率で変わるため、異なるデータセットの生の値を直接比較できない。
未知の同一性は未知の生物学とは限らない
遺伝学、疾患生物学、耐性研究、経路の証拠から新標的が生まれても、通常の教師あり学習に十分な試験済み配位子があるとは限らない。未開拓の治療標的に関する先行研究は記録不足の重要性を示す。一方、ベンチマーク記憶研究は、既知化合物との類似性が実運用より試験を容易にし得ると警告する。
通常のDrugBankとBioSNAPのコールド薬剤分割では、試験化合物の半数超が学習・検証化合物とBemis–Murcko骨格を共有した。中心の環と接続構造を表す骨格は同一分子ではないが、強い構造的既知性を残し得る。
骨格を共有しない追加試験ではAUROCがBioSNAPで2.5ポイント、DrugBankで2.1ポイント、BindingDBで1.4ポイント下がった。この厳格な条件は本モデルだけに適用されたため、6比較手法との新しい相対順位は分からない。
コールドタンパク質にも同様の限界がある。完全に同じ配列は除外されたが、配列ファミリーでクラスタリングして分割したわけではなく、近い相同タンパク質が両側に残り得る。証拠は同一タンパク質を超えた転移を示すが、遠縁ファミリーへの転移を実証してはいない。
分子の詳細がペアのスコアになる仕組み
入力は化学構造を記述する薬剤SMILESと、標的のアミノ酸配列で、実験で解いた三次元構造は不要だ。800万パラメータの小型ESM-2が残基ごとの320次元埋め込みと予測接触マップを提供する。配列しかない標的も扱えるが、改善が事前学習特徴とグラフ構成のどちらに由来するかは未確定である。
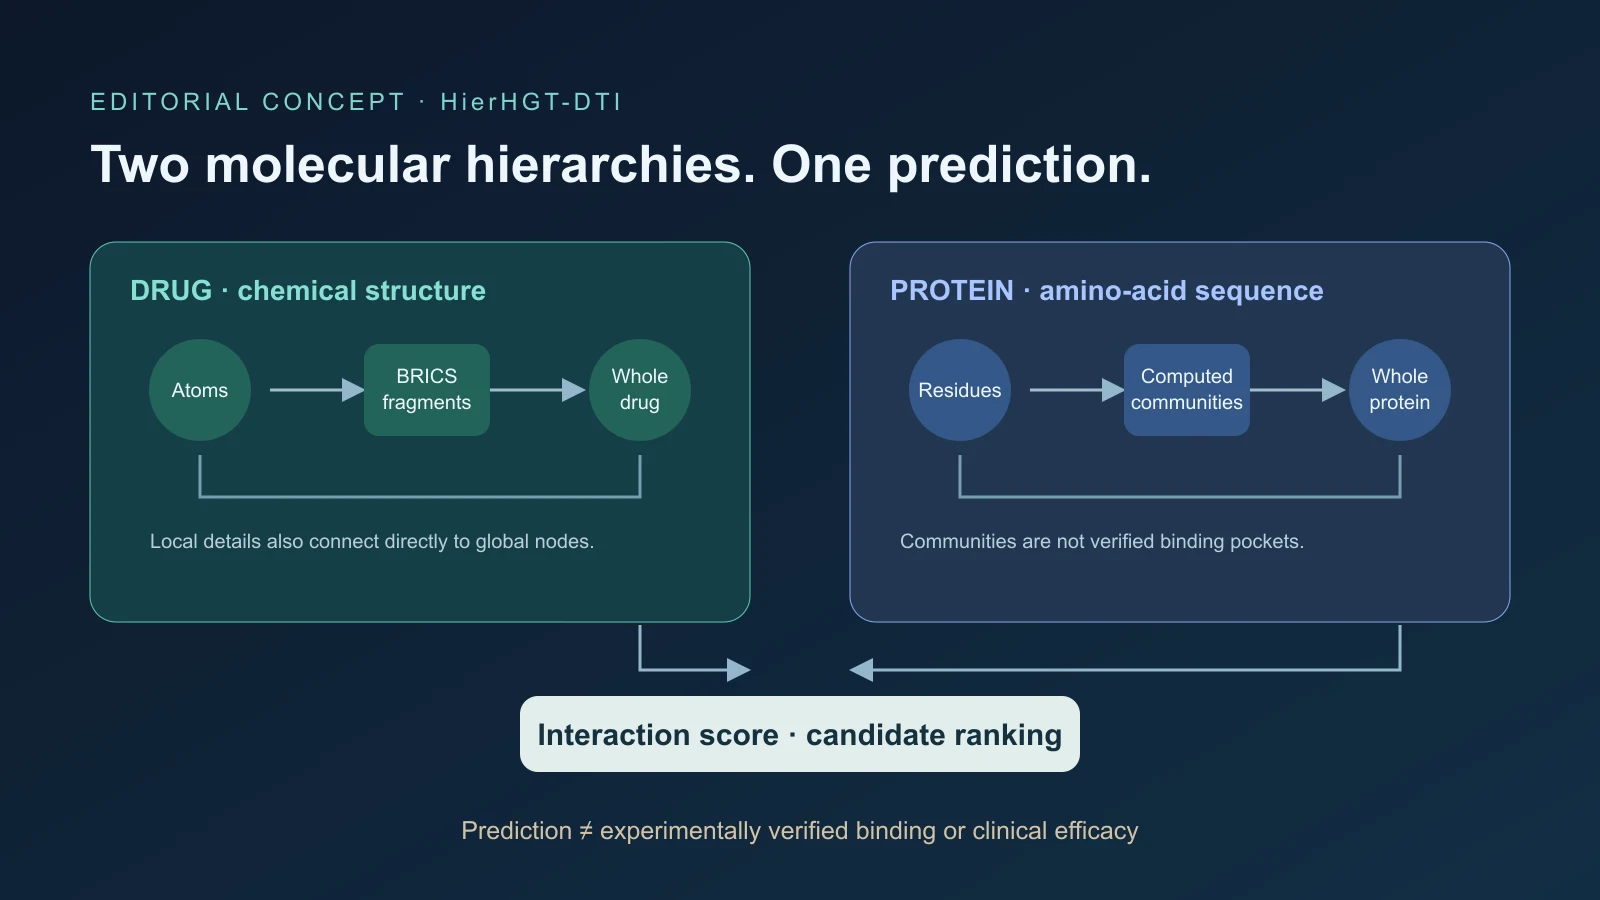
候補ペアは6種類のノードを持つ1つの異種グラフになる。薬剤側は原子、化学部分構造、薬剤全体のスーパーノード。タンパク質側は残基、残基コミュニティ、タンパク質全体のスーパーノードだ。原子記述は74次元で、元素、原子価、電荷、芳香族性、混成、キラリティーを含む。RDKitのルールベースBRICS分割が化学的に意味のある部分構造を作る。
タンパク質側は長い配列を切り詰めず、1回で処理できなければ重複窓で予測接触を得る。配列近接、予測接触、埋め込み類似性で残基をつなぎ、Louvainクラスタリングでコミュニティを作る。コード上の「pockets」は計算上の群であり、実測の配位子結合ポケットではない。
隣接する原子―部分構造―薬剤、残基―コミュニティ―タンパク質を双方向で結ぶ。原子から薬剤、残基からタンパク質への直接ショートカットも詳細を全体ノードに送る。薬剤とタンパク質のスーパーノードを結ぶ双方向辺は陽性・未ラベルの双方にあり、辺の存在が正解を漏らすわけではない。
有向関係は18種類。2層の異種グラフTransformerが4つの注意ヘッド、隠れ次元128で異なる関係を区別する。各ノードは入ってくる関係ごとにメッセージを集め、関係の選好と近傍数を使う学習済み配分で統合する。最後に薬剤・タンパク質ベクトル、要素積、絶対差を合わせ、相互作用スコアにする。
階層が改善原因と証明されたわけではない
中間階層を外したAUPR変化は、DrugBank/BioSNAPの6設定で−0.0042〜+0.0041にとどまった。階層比較はどれも有意ではなく、両側の完全階層が関連変種の首位だったのは3設定だけ。細部から全体への直接ショートカットを外すと、全6設定で平均AUPRが0.0002〜0.0109低下した。
それでも決定的な因果証拠ではない。96検定全体の補正後に有意なアブレーション比較はなかった。両側のショートカットを同時に除いているため、薬剤側とタンパク質側の効果も分離できない。
あるBioSNAPチェックポイントの推論時に、直接ショートカット、タンパク質内部関係、階層関係をそれぞれ除去すると、AUROCは順に0.239、0.069、0.038低下した。これは1つの学習済みモデルの依存を示し、広い優位性の原因を証明しない。妥当な解釈は複数経路を持つ統合システムの有効性であり、直接経路は有用そうだが中間階層の測定利益は一貫しない。
未知の陰性と小規模な解釈実験
陽性は記録済み相互作用だが、多くの陰性は未観測ペアにすぎない。未記録は未試験かもしれず、生物学的に不可能とは限らない。DrugBankの重複除去後プールは17,250陽性と17,498候補陰性だった。元のサンプリング資料は候補母集団、シード、次数重み、骨格制御、タンパク質類似性制御を完全には記述していない。
候補構成を変えると結果も変わった。一部試験で端点次数を考慮した標本化は、一様標本化に比べAUPRを0.040〜0.067下げた。候補陰性と陽性を3対1にするとAUPRは0.680〜0.878となった。したがって絶対性能はスクリーニングプールの作り方に依存する。
適合率・再現率評価の研究が説明するように、陰性が多いとAUROCが安心できる値でも、上位候補の精度の方が実務上重要になり得る。BindingDBのAUROCとAUPRの順位不一致はその違いを示す。前向き試験なしに実験ヒット率は推定できない。
外部解釈実験は、clonazepam、isoflurane、desfluraneなど、GABAA受容体αサブユニットとの記録済み陽性相互作用5件を調べた。上位5残基と予想される粗い領域との一致は0/5〜5/5。未補正の置換検定値は1件が0.050、別の1件が0.077で、他は弱かった。物理的結合部位や機序を検証した結果ではない。注意は影響した入力を示しても生化学的因果を自動的に特定しない。
再現は可能、次は前向きの証拠
固定前処理は接触閾値0.5、Louvain解像度1.0、最小コミュニティ3残基を含み、体系的には最適化されていない。異なる閾値、クラスタリング、大型ESM-2で結果は変わり得る。同じ埋め込みを与えた単純予測器との比較も、型付きグラフの寄与を分離するために必要だ。
実行にはNvidia RTX 4090を1台と事前計算した分子・タンパク質入力を使った。9つの主要なデータセットと分割の組み合わせで、シード当たり学習は26.8〜43.6分。平均試験推論は5.3〜11.1秒、毎秒約592〜890サンプルで、最大割当GPUメモリは1.53〜2.54GiBだった。配列の事前計算は、この学習時間に含まれない追加作業である。
再現パッケージにはコード、設定、処理済み分割、マニフェスト、結果要約、手順がある。実験記録の整理も重要だ。関連する技術ナレッジベース記事は検索可能な前提記録の維持を扱い、本モデルの精度の根拠ではない。
次の決定的な検証は、同じ比較手法、候補、シード、指標、調整予算でのタンパク質ファミリー留保、新標的の化合物ライブラリを固定モデルで順位付けした盲検アッセイ、同じ表現で薬剤側・タンパク質側ショートカットを別々に外す対照実験だ。正例・未ラベル学習なら未記録をすべて陰性にしない。時間分割なら締切前の知識で学習し、後の発見を予測して前処理への未来情報混入を防げる。
前向き研究では結合確認、機能活性、偽陽性、実用的代替法に対する濃縮度を報告すべきだ。否定的結果も配列類似性やデータベース偏りを明らかにし得る。現状は候補の優先順位付け手法であり、ドッキング、生化学実験、細胞研究、毒性、臨床評価の代替ではない。強いベンチマーク証拠は再現すべきもので、医薬品発見の宣言に置き換えるべきではない。