
Il risultato più forte di HierHGT-DTI è una migliore classificazione dei composti per proteine escluse dall’addestramento, non la scoperta di un farmaco validato. Zhangben Chen e Yaping Wan della University of South China combinano struttura chimica e sequenza proteica in un grafo tipizzato multiscala. I risultati sostengono valutazioni più rigorose, mostrando però quanto di familiare rimanga nel “cold start”.
Lo studio su BMC Bioinformatics, pubblicato il 14 settembre 2026, confronta sei alternative su DrugBank, BioSNAP e BindingDB. La promessa pratica è scegliere quali coppie composto–target meritino per prime i limitati esperimenti biochimici o cellulari. Un punteggio non conferma legame fisico, meccanismo biochimico o efficacia clinica.
Dove il vantaggio si conferma e dove no
I ricercatori usano divisioni casuali, cold-drug e cold-protein. Quelle casuali escludono coppie ma possono conservare gli stessi farmaci e proteine fra addestramento e test. Cold-drug esclude intere identità di farmaci; cold-protein esclude le sequenze test anche dalla validazione. Quest’ultima configurazione è più vicina a un nuovo target privo di dati consolidati sui ligandi.
HierHGT-DTI guida tutte e sei le configurazioni DrugBank/BioSNAP. MolTrans, TransformerCPI, DrugBAN, DO-GMA, GeNNius e HiGraphDTI usano divisioni corrispondenti e gli stessi cinque seed casuali, non punteggi ripresi da altre pubblicazioni. Ripetere i seed limita la dipendenza da un’inizializzazione favorevole.
Su DrugBank cold-protein, AUROC è 0,864 e AUPR 0,878. La migliore alternativa raggiunge AUROC 0,776, con un divario di 8,8 punti percentuali; il vantaggio AUPR è 7,9 punti. BioSNAP registra 0,863 e 0,866 contro una migliore AUROC alternativa di 0,805, cioè 5,8 punti. Queste differenze principali superano la correzione per confronti multipli della famiglia DrugBank/BioSNAP.
BindingDB impedisce di parlare di superiorità universale. HierHGT-DTI guida AUPR cold-protein con 0,681, ma HiGraphDTI ottiene AUROC migliore, 0,835 contro 0,831. HiGraphDTI guida anche le divisioni casuale e cold-drug. Nel test casuale, AUROC/AUPR sono 0,934/0,837 contro 0,932/0,829.
I dati preparati differiscono: DrugBank conta 34.748 coppie e 17.250 positivi; BioSNAP 27.457 e 13.830; BindingDB 24.743 e 5.784. I positivi sono il 23,4% in BindingDB, circa il 50% negli altri. AUROC riassume l’ordinamento fra positivi e negativi a diverse soglie. AUPR privilegia precisione e richiamo dei positivi recuperati, ma dipende dalla prevalenza: i valori grezzi non sono direttamente confrontabili fra questi dataset.
Un’identità nuova non equivale a biologia sconosciuta
Genetica, malattie, resistenza o vie biologiche possono indicare target senza fornire abbastanza ligandi testati per la supervisione tradizionale. Le ricerche sui target terapeutici inesplorati spiegano l’importanza di storie d’interazione scarse. Gli studi sulla memorizzazione dei benchmark avvertono però che la somiglianza con composti noti può facilitare artificialmente i test.
Nelle divisioni cold-drug convenzionali di DrugBank e BioSNAP, oltre metà dei composti test condivide uno scaffold Bemis–Murcko con addestramento o validazione. Questo descrive gli anelli centrali e il loro collegamento: non identità molecolare, ma possibile familiarità strutturale significativa.
Con test aggiuntivi senza scaffold condivisi, AUROC di HierHGT-DTI scende di 2,5 punti su BioSNAP, 2,1 su DrugBank e 1,4 su BindingDB. Solo questo modello affronta il protocollo più severo; non se ne può ricavare una nuova classifica relativa alle sei alternative.
Cold-protein presenta una limitazione analoga. Le sequenze identiche sono escluse, ma le proteine non sono separate dopo raggruppamento per famiglia. Omologhi vicini possono rimanere su entrambi i lati. L’evidenza sostiene un trasferimento oltre le proteine identiche, non dimostra quello verso famiglie lontane.
Come i dettagli molecolari diventano un punteggio
Gli input sono SMILES della struttura chimica e sequenze amminoacidiche del target; non servono strutture tridimensionali risolte sperimentalmente. Il compatto ESM-2 da otto milioni di parametri fornisce embedding a 320 dimensioni per residuo e mappe di contatto previste. Consente di usare target noti soltanto per sequenza, ma resta da distinguere il contributo del preaddestramento da quello del grafo.
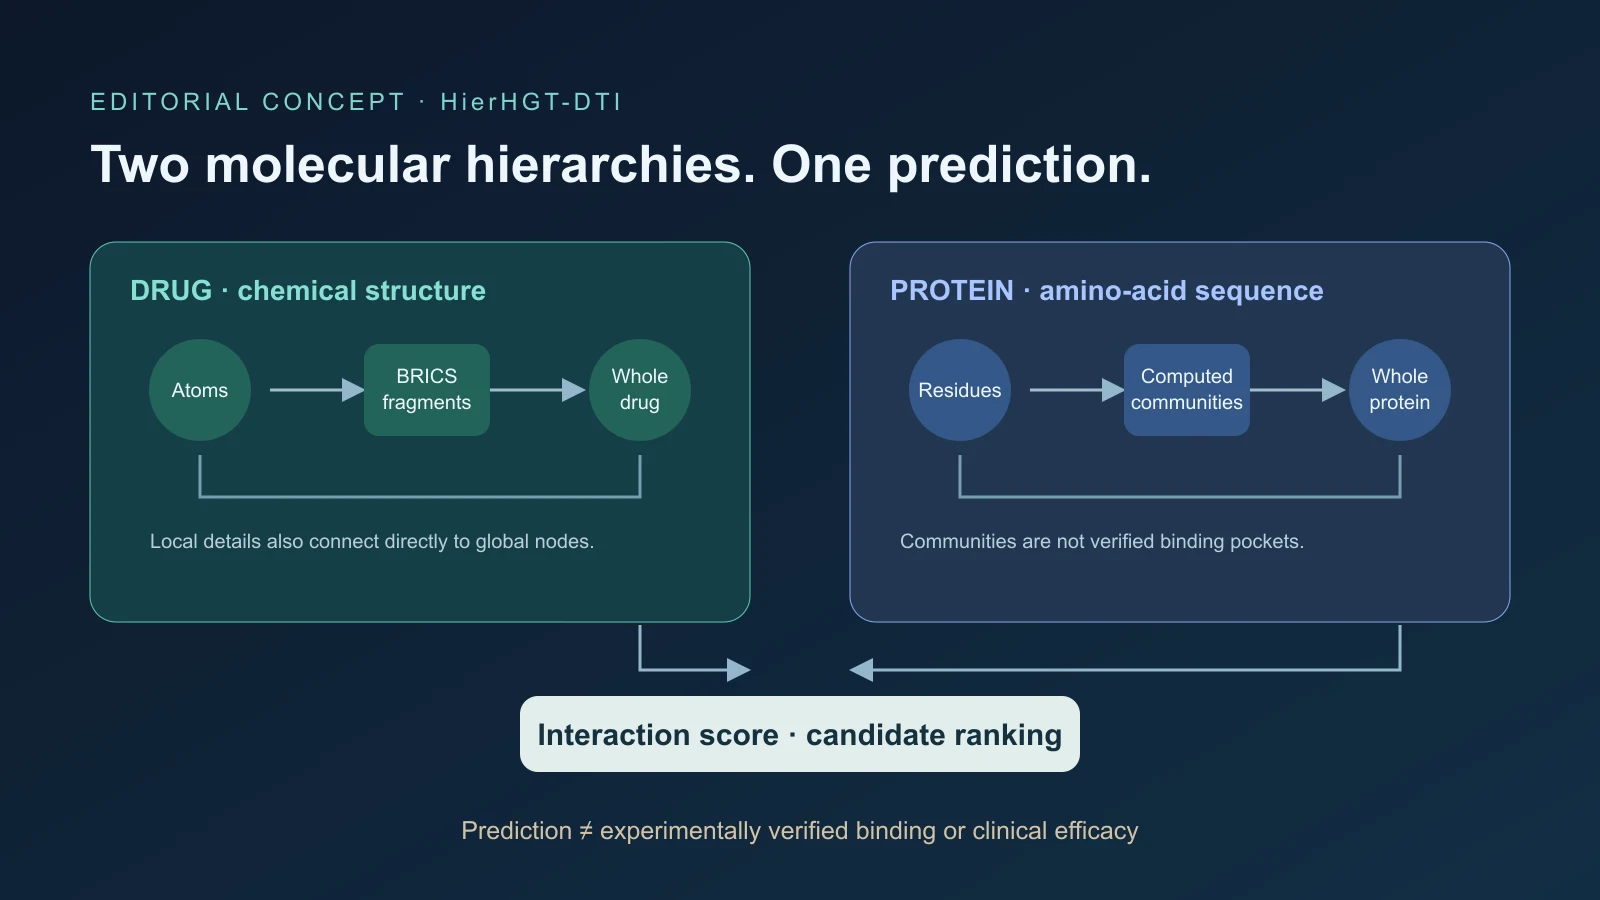
Ogni coppia diventa un grafo eterogeneo con sei tipi di nodi. Il farmaco comprende atomi, sottostrutture e supernodo globale; la proteina comprende residui, comunità e supernodo globale. I descrittori atomici hanno 74 dimensioni, fra cui elemento, valenza, carica, aromaticità, ibridazione e chiralità. La frammentazione BRICS a regole di RDKit crea sottostrutture chimicamente significative.
Il ramo proteico conserva le sequenze complete, senza troncare quelle lunghe; finestre sovrapposte forniscono contatti quando un passaggio non basta. Prossimità di sequenza, contatti previsti e somiglianza degli embedding collegano i residui, poi Louvain forma comunità. Il codice le chiama “pockets”, ma sono gruppi calcolati, non tasche di legame misurate sperimentalmente.
Le scale adiacenti si collegano bidirezionalmente: atomo–sottostruttura–farmaco e residuo–comunità–proteina. Scorciatoie dirette atomo–farmaco e residuo–proteina portano dettagli ai nodi globali. Un arco bidirezionale fra supernodi esiste sia nelle coppie positive sia in quelle senza etichetta: non rivela la risposta corretta.
Il grafo contiene 18 relazioni dirette. Due strati di transformer eterogeneo usano quattro teste di attenzione e dimensione nascosta 128, distinguendo i tipi di relazione. Ogni nodo raccoglie messaggi per relazione entrante; un’allocazione appresa li combina tramite preferenze e numero di vicini. Il predittore unisce vettori farmaco/proteina, prodotti elemento per elemento e differenze assolute nel punteggio d’interazione.
La gerarchia non è una causa dimostrata del guadagno
Rimuovere la gerarchia intermedia cambia AUPR soltanto da −0,0042 a +0,0041 nelle sei configurazioni DrugBank/BioSNAP. Nessun confronto gerarchico è significativo; la gerarchia bilaterale completa supera le varianti collegate solo in tre casi. Rimuovere le scorciatoie dirette riduce AUPR media in tutti e sei, di 0,0002–0,0109.
Nemmeno questo dimostra una causalità definitiva. Nessuna ablazione rimane significativa dopo la correzione su tutti i 96 test. Eliminare insieme le due famiglie di scorciatoie impedisce inoltre di attribuire l’effetto al lato farmaco o proteina.
La rimozione dopo l’addestramento in un checkpoint BioSNAP riduce AUROC di 0,239 per le scorciatoie, 0,069 per le relazioni interne alla proteina e 0,038 per la gerarchia. Diagnostica le dipendenze di un modello, non la causa del vantaggio generale. L’interpretazione difendibile è un sistema integrato efficace con più percorsi: quelli diretti sembrano utili, il beneficio della gerarchia intermedia è irregolare.
Negativi sconosciuti e una piccola prova interpretativa
I positivi sono interazioni registrate, ma molti presunti negativi sono semplicemente coppie non osservate. “Non registrato” può significare non testato, non biologicamente impossibile. DrugBank deduplicato contiene 17.250 positivi e 17.498 candidati negativi. I metadati iniziali non descrivono completamente universo dei candidati, seed, ponderazione per grado, controlli su scaffold e somiglianza proteica.
Cambiare i candidati cambia i risultati. Il campionamento sensibile al grado degli estremi riduce AUPR di 0,040–0,067 rispetto a quello uniforme in alcuni test. Tre candidati negativi per positivo producono AUPR 0,680–0,878. La prestazione assoluta dipende quindi dal pool di screening.
Come spiega la ricerca sulla valutazione precisione-richiamo, AUROC può rassicurare con molti negativi mentre la precisione in cima alla lista resta più rilevante operativamente. Le classifiche contrastanti di BindingDB mostrano la differenza. Nessuna metrica stima i successi in laboratorio senza test prospettici.
Un esercizio esterno esamina cinque interazioni positive con subunità alfa del recettore GABAA, fra cui clonazepam, isoflurano e desflurano. La sovrapposizione dei primi cinque residui con regioni generali attese varia da zero a cinque. Un valore di permutazione non corretto raggiunge 0,050, un altro 0,077; gli altri sono più deboli. Non vengono validati siti fisici o meccanismi. L’attenzione indica input influenti, non automaticamente cause biochimiche.
Riproducibilità oggi, evidenza prospettica domani
Le scelte fisse includono soglia di contatto 0,5, risoluzione Louvain 1,0 e almeno tre residui per comunità. Non sono ottimizzate sistematicamente. Altre soglie, raggruppamenti o ESM-2 più grandi potrebbero cambiare i risultati. Serve ancora un predittore semplice con gli stessi embedding per isolare il grafo tipizzato.
Le esecuzioni usano una Nvidia RTX 4090 con input molecolari e proteici precalcolati. Nelle nove combinazioni principali di dataset e divisione, l’addestramento dura 26,8–43,6 minuti per seed. Il test medio richiede 5,3–11,1 secondi, circa 592–890 campioni al secondo, con 1,53–2,54GiB di memoria GPU massima allocata. Il precalcolo delle sequenze aggiunge lavoro fuori da quei tempi.
Il pacchetto di riproduzione offre codice, configurazioni, divisioni elaborate, manifest, riepiloghi e istruzioni. Contano anche i registri organizzati; l’articolo collegato sulla base di conoscenza ingegneristica riguarda la conservazione di ipotesi ricercabili, non prove di accuratezza del modello.
I prossimi test decisivi sono esclusioni per famiglia proteica con alternative, candidati, seed, metriche e budget identici; un modello congelato che ordini una libreria per un nuovo target prima di saggi in cieco; ablazioni controllate per rappresentazione e scorciatoie separate per farmaco/proteina. L’apprendimento positivo-non etichettato eviterebbe di considerare negativa ogni coppia sconosciuta. Divisioni temporali addestrerebbero prima di una data limite e prevederebbero scoperte successive senza conoscenze future nel pretrattamento.
Uno studio prospettico dovrebbe riportare legame confermato, attività funzionale, falsi positivi e arricchimento rispetto ad alternative pratiche. Risultati negativi potrebbero svelare somiglianze ingannevoli e bias dei database. Per ora HierHGT-DTI ordina candidati: non sostituisce docking, saggi biochimici, cellule, tossicologia o clinica. I suoi migliori benchmark meritano riproduzione, non conversione in un annuncio di farmaci scoperti.