
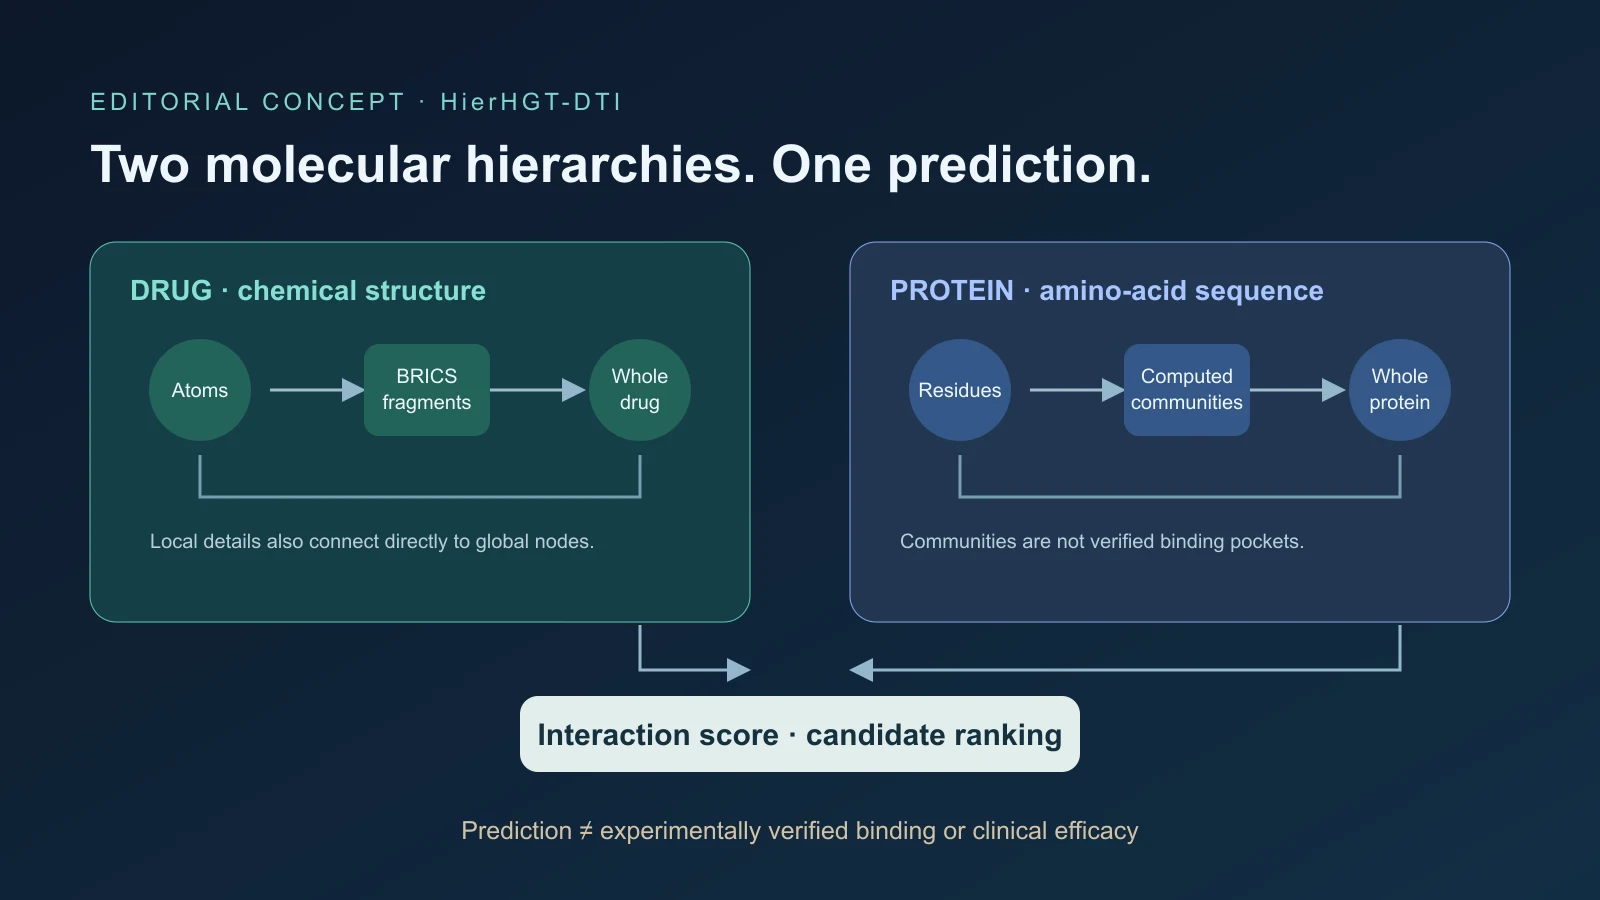
Najmocniejszym wynikiem HierHGT-DTI jest lepszy ranking związków dla białek wyłączonych z treningu, nie odkrycie zwalidowanego leku. Zhangben Chen i Yaping Wan z University of South China łączą strukturę chemiczną i sekwencję białka w typowanym grafie wieloskalowym. Wyniki przemawiają za trudniejszą oceną, ale pokazują też, ile znajomych informacji zachowuje „zimny start”.
Badanie w BMC Bioinformatics, opublikowane 14 września 2026 r., porównuje sześć alternatyw na DrugBank, BioSNAP i BindingDB. Praktyczną obietnicą jest wybór par związek–cel, które jako pierwsze otrzymają ograniczone testy biochemiczne lub komórkowe. Wynik predykcji nie potwierdza fizycznego wiązania, mechanizmu biochemicznego ani skuteczności klinicznej.
Gdzie przewaga się utrzymuje, a gdzie nie
Badacze stosują podziały losowe, cold-drug i cold-protein. Losowe wyłączają pary, ale mogą zachować te same leki i białka w treningu oraz teście. Cold-drug wyłącza całe tożsamości leków; cold-protein usuwa sekwencje testowe również z walidacji. Ten ostatni wariant lepiej przybliża nowy cel bez ustalonych danych o ligandach.
HierHGT-DTI prowadzi we wszystkich sześciu konfiguracjach DrugBank/BioSNAP. MolTrans, TransformerCPI, DrugBAN, DO-GMA, GeNNius i HiGraphDTI korzystają z tych samych podziałów i pięciu ziaren losowych, nie wyników przepisanych z innych publikacji. Powtarzanie ziaren ogranicza zależność od korzystnej inicjalizacji.
Na DrugBank cold-protein AUROC wynosi 0,864, AUPR 0,878. Najlepsza metoda odniesienia osiąga AUROC 0,776: różnica wynosi 8,8 punktu procentowego, a przewaga AUPR 7,9 punktu. BioSNAP uzyskuje 0,863 i 0,866 wobec najlepszego AUROC odniesienia 0,805, czyli różnicę 5,8 punktu. Te główne różnice przetrwały korektę wielokrotnych porównań rodziny DrugBank/BioSNAP.
BindingDB uniemożliwia twierdzenie o uniwersalnej wyższości. HierHGT-DTI prowadzi w cold-protein AUPR z 0,681, lecz HiGraphDTI ma lepszy AUROC, 0,835 wobec 0,831. HiGraphDTI prowadzi także w podziałach losowym i cold-drug. Losowe AUROC/AUPR wynoszą 0,934/0,837 wobec 0,932/0,829.
Przygotowane dane różnią się: DrugBank ma 34 748 par i 17 250 pozytywów; BioSNAP 27 457 i 13 830; BindingDB 24 743 i 5 784. Odsetek pozytywów to 23,4% w BindingDB i około 50% w pozostałych. AUROC podsumowuje ranking pozytywów i negatywów przy różnych progach. AUPR kładzie nacisk na precyzję i czułość wyszukanych pozytywów, lecz zależy od ich częstości; surowych wartości nie należy bezpośrednio porównywać między tymi zbiorami.
Nowa tożsamość nie oznacza nieznanej biologii
Genetyka, biologia chorób, oporność i szlaki mogą ujawniać cele bez wystarczającej liczby przetestowanych ligandów dla zwykłego uczenia nadzorowanego. Prace o niezbadanych celach terapeutycznych pokazują znaczenie skąpych historii interakcji. Badania nad zapamiętywaniem benchmarków ostrzegają jednak, że podobieństwo do znanych związków może ułatwiać testy względem wdrożenia.
W konwencjonalnych podziałach cold-drug DrugBank i BioSNAP ponad połowa związków testowych dzieli szkielet Bemisa–Murcko z treningiem lub walidacją. Opisuje on centralne pierścienie i łączącą je strukturę: nie identyczność cząsteczki, ale potencjalnie istotną znajomość budowy.
W dodatkowych testach bez wspólnych szkieletów AUROC HierHGT-DTI spada o 2,5 punktu na BioSNAP, 2,1 na DrugBank i 1,4 na BindingDB. Tylko ten model oceniono według ostrzejszego protokołu, więc nie wyznacza on nowego rankingu wobec sześciu metod odniesienia.
Cold-protein ma analogiczne ograniczenie. Identyczne sekwencje wykluczono, ale białek nie rozdzielono po grupowaniu rodzin. Bliskie homologi mogły pozostać po obu stronach. Dowody wspierają transfer poza identyczne białka, nie potwierdzają przenoszenia na odległe rodziny.
Jak szczegóły molekularne tworzą wynik
Wejściami są SMILES struktury chemicznej i sekwencje aminokwasowe celu; nie potrzeba eksperymentalnie określonych struktur trójwymiarowych. Kompaktowy ESM-2 z ośmioma milionami parametrów dostarcza 320-wymiarowych reprezentacji reszt oraz przewidywanych map kontaktów. Umożliwia pracę z celami znanymi jedynie z sekwencji, ale nie oddziela wkładu pretreningu od organizacji grafu.
Każda para tworzy graf heterogeniczny z sześcioma typami węzłów. Lek obejmuje atomy, podstruktury i globalny superwęzeł; białko – reszty, społeczności i globalny superwęzeł. Deskryptory atomowe mają 74 wymiary, m.in. pierwiastek, wartościowość, ładunek, aromatyczność, hybrydyzację i chiralność. Oparta na regułach fragmentacja BRICS w RDKit tworzy chemicznie znaczące podstruktury.
Gałąź białkowa zachowuje pełne sekwencje zamiast skracać długie; nakładające się okna dostarczają kontaktów, gdy jedno przejście nie wystarcza. Bliskość sekwencji, przewidywane kontakty i podobieństwo reprezentacji łączą reszty; Louvain tworzy społeczności. Kod nazywa je „pockets”, ale to grupy obliczeniowe, nie eksperymentalnie zmierzone kieszenie wiążące.
Sąsiednie skale łączą się dwukierunkowo: atom–podstruktura–lek i reszta–społeczność–białko. Bezpośrednie skróty atom–lek i reszta–białko przekazują szczegóły globalnie. Dwukierunkowa krawędź między superwęzłami istnieje w parach pozytywnych i nieoznaczonych, nie ujawnia więc odpowiedzi.
Graf ma 18 skierowanych relacji. Dwie warstwy transformera heterogenicznego, z czterema głowami uwagi i ukrytym wymiarem 128, rozróżniają typy relacji. Każdy węzeł zbiera komunikaty według relacji przychodzącej; wyuczona alokacja łączy preferencje i liczbę sąsiadów. Predyktor łączy wektory leku/białka, iloczyny elementowe i różnice bezwzględne w wynik interakcji.
Hierarchia nie jest dowiedzioną przyczyną poprawy
Usunięcie pośredniej hierarchii zmienia AUPR tylko od −0,0042 do +0,0041 w sześciu konfiguracjach DrugBank/BioSNAP. Żadne porównanie hierarchii nie jest istotne; pełna dwustronna wersja prowadzi wśród pokrewnych wariantów jedynie trzy razy. Usunięcie bezpośrednich skrótów obniża średni AUPR we wszystkich sześciu, o 0,0002–0,0109.
To również nie dowodzi jednoznacznej przyczynowości. Po korekcie wszystkich 96 testów żadna ablacja nie pozostaje istotna. Usunięcie obu rodzin skrótów razem uniemożliwia też przypisanie efektu stronie leku lub białka.
Usunięcie po treningu w jednym punkcie kontrolnym BioSNAP obniża AUROC o 0,239 dla skrótów, 0,069 dla relacji wewnętrznych białka i 0,038 dla hierarchii. Diagnozuje zależności jednego modelu, nie przyczynę ogólnej przewagi. Uzasadniony obraz to skuteczny zintegrowany system wielu dróg: bezpośrednie wydają się pomocne, korzyść z pośredniej hierarchii jest niespójna.
Nieznane negatywy i mała próba interpretacyjna
Pozytywy to zarejestrowane interakcje, ale wiele rzekomych negatywów jest niezaobserwowanymi parami. „Nieodnotowane” może znaczyć nieprzetestowane, nie biologicznie niemożliwe. DrugBank po deduplikacji zawiera 17 250 pozytywów i 17 498 kandydatów negatywnych. Pierwotne metadane nie opisują w pełni uniwersum kandydatów, ziarna, ważenia stopni, kontroli szkieletów i podobieństwa białek.
Zmiana kandydatów zmienia wyniki. Próbkowanie uwzględniające stopień końców obniża AUPR o 0,040–0,067 względem jednostajnego w wybranych testach. Trzech kandydatów negatywnych na jednego pozytywnego daje AUPR 0,680–0,878. Konstrukcja puli przesiewowej wpływa więc na wydajność bezwzględną.
Jak wyjaśnia badanie oceny precision-recall, AUROC może uspokajać przy wielu negatywach, podczas gdy operacyjnie ważniejsza jest precyzja na szczycie listy. Sprzeczne rankingi BindingDB ilustrują tę różnicę. Bez testów prospektywnych żadna miara nie szacuje trafień w laboratorium.
Zewnętrzne ćwiczenie analizuje pięć pozytywnych interakcji z podjednostkami alfa receptora GABAA, w tym klonazepam, izofluran i desfluran. Pokrycie pięciu najwyższych reszt z oczekiwanymi przybliżonymi regionami waha się od zera do pięciu. Nieskorygowana wartość permutacyjna sięga 0,050 w jednym przypadku i 0,077 w drugim; reszta jest słabsza. Nie weryfikuje to fizycznych miejsc ani mechanizmów. Uwaga pokazuje wpływowe wejścia, nie automatycznie przyczyny biochemiczne.
Odtwarzalność teraz, dowody prospektywne później
Stałe przetwarzanie obejmuje próg kontaktu 0,5, rozdzielczość Louvain 1,0 i minimum trzy reszty na społeczność. Nie optymalizowano tego systematycznie. Inne progi, grupowanie czy większe ESM-2 mogłyby zmienić wyniki. Nadal potrzeba prostego predyktora z tymi samymi reprezentacjami do oddzielenia wkładu typowanego grafu.
Przebiegi wykorzystują jedną Nvidia RTX 4090 i wcześniej obliczone wejścia molekularne oraz białkowe. W dziewięciu głównych kombinacjach danych i podziału trening trwa 26,8–43,6 minuty na ziarno. Średnia inferencja testowa zajmuje 5,3–11,1 sekundy, około 592–890 przykładów na sekundę, przy 1,53–2,54GiB maksymalnie przydzielonej pamięci GPU. Wcześniejsze obliczanie sekwencji wymaga dodatkowej pracy poza tym czasem.
Pakiet odtwarzania obejmuje kod, konfiguracje, przetworzone podziały, manifesty, podsumowania i instrukcje. Ważne są też uporządkowane zapisy; powiązany artykuł o przeszukiwalnej bazie technicznej dotyczy zachowania założeń, nie dowodów dokładności modelu.
Decydujące kolejne testy to wyłączenia rodzin białek z tymi samymi metodami, kandydatami, ziarnami, metrykami i budżetami; zamrożony model szeregujący bibliotekę nowego celu przed zaślepionymi testami; ablacje kontrolujące reprezentację i oddzielające skróty leku/białka. Uczenie na pozytywach i danych nieoznaczonych unikałoby uznawania każdej nieodnotowanej pary za negatywną. Podziały czasowe trenowałyby przed datą graniczną, przewidując późniejsze odkrycia bez przecieku przyszłej wiedzy do przetwarzania.
Badanie prospektywne powinno raportować potwierdzone wiązanie, aktywność funkcjonalną, fałszywe pozytywy i wzbogacenie względem praktycznych alternatyw. Negatywne wyniki mogłyby ujawnić mylące podobieństwo i obciążenie baz. Obecnie HierHGT-DTI priorytetyzuje kandydatów, nie zastępuje dokowania, biochemii, komórek, toksykologii ani oceny klinicznej. Najlepsze benchmarki zasługują na odtworzenie, nie na przekształcenie w ogłoszenie odkrytych leków.