
O resultado mais forte do HierHGT-DTI é ordenar melhor compostos para proteínas excluídas do treinamento, não descobrir um medicamento validado. Zhangben Chen e Yaping Wan, da University of South China, combinam estrutura química e sequência proteica em um grafo tipado multiescala. Os resultados apoiam avaliações mais exigentes, mas mostram quanto de familiar ainda existe na “partida a frio”.
O estudo da BMC Bioinformatics, publicado em 14 de setembro de 2026, compara seis alternativas em DrugBank, BioSNAP e BindingDB. A promessa prática é priorizar quais pares composto–alvo merecem primeiro os escassos testes bioquímicos ou celulares. Uma pontuação não confirma ligação física, mecanismo bioquímico ou eficácia clínica.
Onde a vantagem se sustenta e onde não
Os pesquisadores usam divisões aleatórias, cold-drug e cold-protein. A aleatória reserva pares, mas pode preservar os mesmos medicamentos e proteínas entre treinamento e teste. Cold-drug exclui identidades completas de medicamentos; cold-protein exclui sequências de teste também da validação. A última situação aproxima melhor um novo alvo sem dados estabelecidos sobre ligantes.
HierHGT-DTI lidera as seis configurações DrugBank/BioSNAP. MolTrans, TransformerCPI, DrugBAN, DO-GMA, GeNNius e HiGraphDTI usam divisões correspondentes e as mesmas cinco sementes aleatórias, não números trazidos de outras publicações. Repetir sementes reduz a dependência de uma inicialização favorável.
Em DrugBank cold-protein, AUROC chega a 0,864 e AUPR a 0,878. A melhor referência tem AUROC 0,776, diferença de 8,8 pontos percentuais; a vantagem AUPR é 7,9 pontos. BioSNAP registra 0,863 e 0,866, contra melhor AUROC de referência de 0,805, ou 5,8 pontos. Essas diferenças principais sobrevivem à correção de comparações múltiplas da família DrugBank/BioSNAP.
BindingDB impede afirmar superioridade universal. HierHGT-DTI lidera AUPR cold-protein com 0,681, mas HiGraphDTI obtém AUROC melhor, 0,835 contra 0,831. HiGraphDTI também lidera nas divisões aleatória e cold-drug. Seus AUROC/AUPR aleatórios são 0,934/0,837, contra 0,932/0,829.
Os dados preparados diferem: DrugBank tem 34.748 pares e 17.250 positivos; BioSNAP, 27.457 e 13.830; BindingDB, 24.743 e 5.784. A taxa positiva é 23,4% em BindingDB e próxima de 50% nos outros. AUROC resume a ordenação positivo/negativo em vários limiares. AUPR enfatiza precisão e revocação dos positivos recuperados, mas depende da prevalência; valores brutos não se comparam diretamente entre esses conjuntos.
Uma identidade nova não significa biologia desconhecida
Genética, doenças, resistência ou vias biológicas podem revelar alvos sem fornecer ligantes testados suficientes para supervisão convencional. Trabalhos sobre alvos terapêuticos inexplorados mostram por que históricos escassos importam. A pesquisa sobre memorização de benchmarks alerta, porém, que semelhança com compostos familiares pode facilitar testes em relação ao uso real.
Nas divisões cold-drug convencionais de DrugBank e BioSNAP, mais da metade dos compostos de teste compartilha um arcabouço Bemis–Murcko com treinamento ou validação. Ele descreve os anéis centrais e sua ligação: não identidade molecular, mas possível familiaridade estrutural relevante.
Em testes adicionais sem arcabouços compartilhados, AUROC do HierHGT-DTI cai 2,5 pontos em BioSNAP, 2,1 em DrugBank e 1,4 em BindingDB. Só esse modelo passa pelo protocolo mais rigoroso; não se pode derivar uma nova classificação relativa às seis referências.
Cold-protein tem limite semelhante. Sequências idênticas são excluídas, mas proteínas não são separadas após agrupamento por família. Homólogos próximos podem permanecer em ambos os lados. A evidência mostra transferência além de proteínas idênticas, não transferência demonstrada para famílias distantes.
Como os detalhes moleculares viram pontuação
As entradas são SMILES da estrutura química e sequências de aminoácidos do alvo; estruturas tridimensionais resolvidas experimentalmente não são necessárias. O ESM-2 compacto de oito milhões de parâmetros fornece representações de 320 dimensões por resíduo e mapas de contatos previstos. Isso permite trabalhar com alvos conhecidos apenas por sequência, mas não isola quanto do ganho vem do pré-treinamento e quanto do grafo.
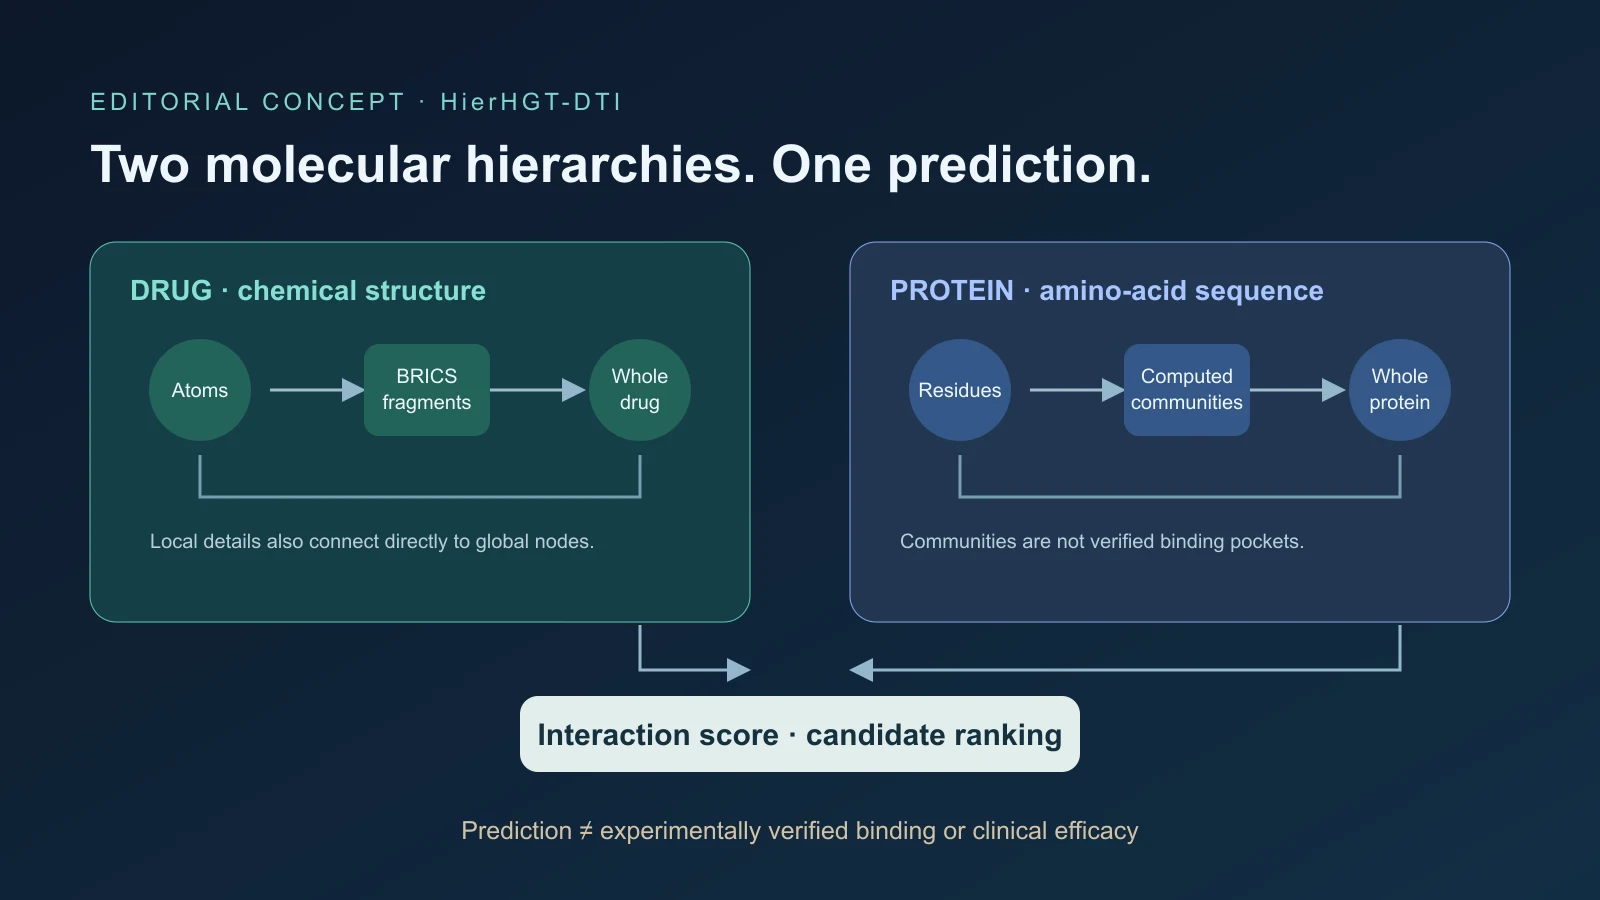
Cada par forma um grafo heterogêneo com seis tipos de nós. O medicamento inclui átomos, subestruturas e supernó global; a proteína inclui resíduos, comunidades e supernó global. Descritores atômicos têm 74 dimensões, incluindo elemento, valência, carga, aromaticidade, hibridização e quiralidade. A fragmentação BRICS baseada em regras do RDKit gera subestruturas quimicamente significativas.
O ramo proteico conserva sequências completas, sem truncar as longas; janelas sobrepostas fornecem contatos quando uma passagem não basta. Proximidade na sequência, contatos previstos e semelhança de representações conectam resíduos; Louvain forma comunidades. O código as chama “pockets”, mas são grupos calculados, não bolsões de ligação medidos experimentalmente.
Escalas adjacentes conectam-se bidirecionalmente: átomo–subestrutura–medicamento e resíduo–comunidade–proteína. Atalhos diretos átomo–medicamento e resíduo–proteína levam detalhes ao nível global. Uma aresta bidirecional entre supernós existe em pares positivos e não rotulados, portanto não revela a resposta.
O grafo usa 18 relações direcionadas. Duas camadas de transformador heterogêneo, com quatro cabeças de atenção e dimensão oculta 128, distinguem relações. Cada nó reúne mensagens por relação de entrada; uma alocação aprendida combina preferências e número de vizinhos. O preditor une vetores medicamento/proteína, produtos elemento a elemento e diferenças absolutas para calcular a interação.
A hierarquia não é uma causa comprovada do ganho
Remover a hierarquia intermediária muda AUPR apenas entre −0,0042 e +0,0041 nas seis configurações DrugBank/BioSNAP. Nenhuma comparação hierárquica é significativa; a versão bilateral completa lidera variantes relacionadas em apenas três casos. Remover atalhos diretos reduz AUPR média nos seis, entre 0,0002 e 0,0109.
Isso também não prova causalidade definitiva. Nenhuma ablação permanece significativa após correção dos 96 testes. Excluir juntas as duas famílias de atalhos impede atribuir o efeito ao medicamento ou à proteína.
A remoção após treinamento em um checkpoint BioSNAP reduz AUROC em 0,239 para atalhos, 0,069 para relações internas da proteína e 0,038 para hierarquia. Diagnostica dependências de um modelo, não a causa da vantagem geral. A interpretação defensável é um sistema integrado eficaz com múltiplas rotas: as diretas parecem úteis, o benefício medido da hierarquia intermediária é irregular.
Negativos desconhecidos e uma pequena interpretação
Positivos são interações registradas, mas muitos supostos negativos são pares não observados. “Não registrado” pode significar não testado, não biologicamente impossível. DrugBank deduplicado tem 17.250 positivos e 17.498 candidatos negativos. Metadados originais não documentam completamente universo de candidatos, semente, ponderação por grau, controles de arcabouço e semelhança proteica.
Mudar candidatos altera resultados. Amostragem consciente do grau dos extremos reduz AUPR 0,040–0,067 em relação à uniforme em testes selecionados. Três candidatos negativos por positivo produzem AUPR 0,680–0,878. O conjunto de triagem influencia, portanto, o desempenho absoluto.
Como explica a pesquisa sobre avaliação precisão-revocação, AUROC pode tranquilizar com muitos negativos enquanto a precisão no topo da lista importa mais operacionalmente. As classificações conflitantes de BindingDB ilustram isso. Nenhuma métrica estima acertos laboratoriais sem teste prospectivo.
Um exercício externo examina cinco interações positivas com subunidades alfa do receptor GABAA, incluindo clonazepam, isoflurano e desflurano. A sobreposição dos cinco resíduos mais bem classificados com regiões gerais esperadas vai de zero a cinco. Um valor de permutação sem ajuste chega a 0,050, outro a 0,077; os demais são mais fracos. Isso não valida sítios físicos nem mecanismos. Atenção identifica entradas influentes, não automaticamente causas bioquímicas.
Reproduzir agora, testar prospectivamente depois
O pré-processamento fixo inclui limiar de contato 0,5, resolução Louvain 1,0 e pelo menos três resíduos por comunidade. Não houve otimização sistemática. Outros limiares, agrupamentos ou ESM-2 maiores poderiam alterar os resultados. Ainda falta um preditor simples com as mesmas representações para isolar a contribuição do grafo tipado.
As execuções usam uma Nvidia RTX 4090 e entradas moleculares e proteicas pré-calculadas. Em nove combinações principais de dados e divisão, o treinamento leva 26,8–43,6 minutos por semente. A inferência média de teste dura 5,3–11,1 segundos, aproximadamente 592–890 exemplos por segundo, com 1,53–2,54GiB de memória GPU máxima alocada. O pré-cálculo das sequências acrescenta trabalho fora desses tempos.
O pacote de reprodução oferece código, configurações, divisões processadas, manifestos, resumos e instruções. Registros organizados também importam; o artigo relacionado sobre base técnica pesquisável trata de preservar premissas, não de provar a precisão deste modelo.
Testes decisivos seriam excluir famílias proteicas com referências, candidatos, sementes, métricas e orçamentos iguais; congelar o modelo para ordenar uma biblioteca de um alvo novo antes de ensaios cegos; e fazer ablações controladas por representação, separando atalhos de medicamento e proteína. Aprendizado positivo-não rotulado evitaria tratar como negativo todo par não registrado. Divisões temporais treinariam antes de uma data e preveriam descobertas posteriores sem vazamento de conhecimento futuro no pré-processamento.
Um estudo prospectivo deveria informar ligação confirmada, atividade funcional, falsos positivos e enriquecimento frente a alternativas práticas. Resultados negativos poderiam revelar similaridade enganosa ou viés das bases. Por enquanto HierHGT-DTI prioriza candidatos, não substitui docking, bioquímica, células, toxicologia ou avaliação clínica. Seus melhores benchmarks merecem reprodução, não conversão em anúncios de medicamentos descobertos.