
Le résultat le plus solide de HierHGT-DTI est un meilleur classement des composés pour des protéines exclues de l’entraînement, et non la découverte d’un médicament validé. Zhangben Chen et Yaping Wan, de l’Université de Chine du Sud, combinent structure chimique et séquence protéique dans un graphe typé multi-échelle. Leurs résultats plaident pour une évaluation plus exigeante tout en montrant ce que le « démarrage à froid » conserve de familier.
L’étude de BMC Bioinformatics, publiée le 14 septembre 2026, compare six solutions sur DrugBank, BioSNAP et BindingDB. Sa promesse pratique est la priorisation : quelles paires composé–cible méritent d’abord les rares essais biochimiques ou cellulaires ? Un score ne confirme ni liaison physique, ni mécanisme biochimique, ni efficacité clinique.
Où l’avantage existe, et où il ne suffit pas
Les chercheurs utilisent des divisions aléatoires, cold-drug et cold-protein. Une division aléatoire réserve des paires, mais peut conserver les mêmes médicaments et protéines dans l’entraînement et le test. Cold-drug exclut des identités médicamenteuses entières ; cold-protein exclut les séquences test de l’entraînement et de la validation. Cette dernière configuration ressemble davantage à une nouvelle cible dépourvue de données établies sur ses ligands.
HierHGT-DTI domine les six configurations DrugBank/BioSNAP. MolTrans, TransformerCPI, DrugBAN, DO-GMA, GeNNius et HiGraphDTI utilisent les mêmes divisions et cinq graines aléatoires, plutôt que des scores repris d’autres publications. Répéter les graines réduit la dépendance à une initialisation favorable.
Sur DrugBank cold-protein, l’AUROC atteint 0,864 et l’AUPR 0,878. La meilleure référence obtient une AUROC de 0,776, soit 8,8 points d’écart ; l’avantage AUPR vaut 7,9 points. BioSNAP atteint 0,863 et 0,866, contre une meilleure AUROC de référence de 0,805, soit 5,8 points. Ces différences principales résistent à la correction pour comparaisons multiples de la famille DrugBank/BioSNAP.
BindingDB interdit de conclure à une supériorité universelle. HierHGT-DTI arrive premier en AUPR cold-protein avec 0,681, mais HiGraphDTI obtient une meilleure AUROC, 0,835 contre 0,831. HiGraphDTI domine aussi les divisions aléatoire et cold-drug de BindingDB. Ses AUROC/AUPR aléatoires sont 0,934/0,837, contre 0,932/0,829.
Les données préparées diffèrent : DrugBank compte 34 748 paires et 17 250 positifs ; BioSNAP, 27 457 et 13 830 ; BindingDB, 24 743 et 5 784. BindingDB présente 23,4% de positifs, les autres près de 50%. L’AUROC résume le classement positif/négatif sur plusieurs seuils. L’AUPR privilégie précision et rappel des positifs récupérés, mais dépend de leur prévalence : ses valeurs brutes ne se comparent pas directement entre ces ensembles.
Une identité inédite n’est pas forcément une biologie inconnue
La génétique, les maladies, les résistances ou les voies biologiques peuvent faire émerger des cibles sans fournir assez de ligands testés pour l’apprentissage supervisé classique. Les travaux sur les cibles thérapeutiques inexplorées montrent l’importance des historiques rares. La recherche sur la mémorisation des benchmarks avertit toutefois que la ressemblance chimique peut faciliter artificiellement l’évaluation.
Dans les divisions cold-drug classiques de DrugBank et BioSNAP, plus de la moitié des composés test partagent un squelette Bemis–Murcko avec ceux d’entraînement ou de validation. Ce squelette représente les cycles centraux et leur armature de liaison : pas une identité moléculaire, mais une familiarité structurelle potentiellement importante.
Dans des tests supplémentaires sans squelette commun, l’AUROC de HierHGT-DTI baisse de 2,5 points sur BioSNAP, 2,1 sur DrugBank et 1,4 sur BindingDB. Seul ce modèle subit ce protocole renforcé ; il ne permet donc pas de rétablir un classement relatif face aux six références.
Cold-protein possède une limite parallèle. Les séquences identiques sont exclues, mais pas les familles regroupées selon leur séquence. Des homologues proches peuvent rester des deux côtés. Les résultats montrent un transfert au-delà des protéines identiques, pas un transfert démontré vers des familles éloignées.
Comment les détails moléculaires deviennent un score
Les entrées sont des chaînes SMILES décrivant la structure des médicaments et les séquences d’acides aminés des cibles. Aucune structure tridimensionnelle résolue expérimentalement n’est nécessaire. Le petit ESM-2 de huit millions de paramètres fournit une représentation à 320 dimensions par résidu et des cartes de contacts prédites. Cela ouvre l’analyse aux cibles connues uniquement par séquence, mais laisse incertaine la contribution respective du préentraînement et du graphe.
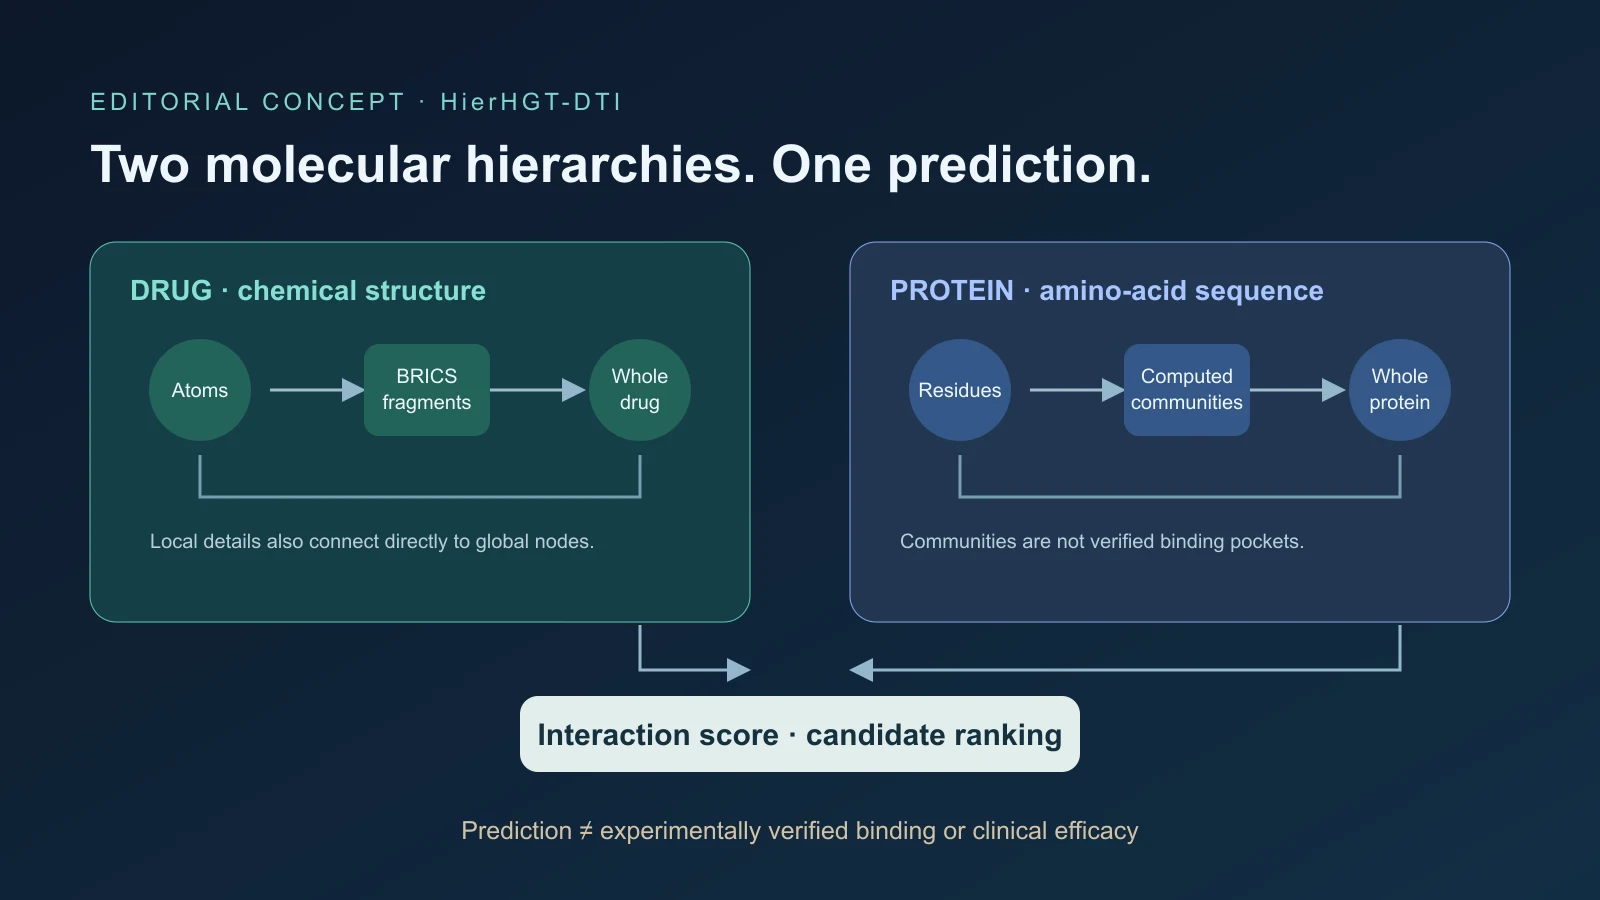
Chaque paire devient un graphe hétérogène à six types de nœuds. Côté médicament : atomes, sous-structures et super-nœud global. Côté protéine : résidus, communautés et super-nœud global. Les descripteurs atomiques ont 74 dimensions, dont élément, valence, charge, aromaticité, hybridation et chiralité. La fragmentation BRICS à règles de RDKit crée les sous-structures chimiquement pertinentes.
Les protéines longues ne sont pas tronquées ; des fenêtres chevauchantes prédisent les contacts lorsqu’un passage unique ne suffit pas. Proximité séquentielle, contacts prédits et similarité des représentations relient les résidus, puis Louvain forme des communautés. Le code les appelle « pockets », mais ce sont des groupes calculés, pas des poches de liaison mesurées expérimentalement.
Les niveaux adjacents sont reliés dans les deux sens : atome–sous-structure–médicament et résidu–communauté–protéine. Des raccourcis directs atome–médicament et résidu–protéine transportent aussi les détails vers le niveau global. L’arête bidirectionnelle entre super-nœuds existe pour les paires positives et non étiquetées : elle ne révèle pas la réponse.
Le graphe comprend 18 relations dirigées. Deux couches de transformeur hétérogène utilisent quatre têtes d’attention et une dimension cachée de 128 en distinguant les relations. Chaque nœud rassemble les messages par relation entrante ; une allocation apprise les combine selon les préférences relationnelles et le nombre de voisins. Le prédicteur associe vecteurs médicament/protéine, produits élémentaires et différences absolues pour calculer le score.
La hiérarchie n’est pas une cause démontrée du gain
Retirer la hiérarchie intermédiaire ne modifie l’AUPR que de −0,0042 à +0,0041 dans six configurations DrugBank/BioSNAP. Aucune comparaison hiérarchique n’est significative ; la version bilatérale complète ne domine les variantes apparentées que trois fois. Retirer les raccourcis directs diminue l’AUPR moyenne dans les six cas, de 0,0002 à 0,0109.
Ce motif ne prouve toutefois pas la causalité. Aucune ablation ne reste significative après correction sur les 96 tests. Supprimer ensemble les deux familles de raccourcis empêche aussi d’attribuer l’effet au médicament ou à la protéine.
Dans un point de contrôle BioSNAP, une suppression après entraînement réduit l’AUROC de 0,239 pour les raccourcis, 0,069 pour les relations internes aux protéines et 0,038 pour la hiérarchie. Ces diagnostics montrent les dépendances d’un modèle donné, pas la cause de son avantage général. L’interprétation défendable est celle d’un système intégré efficace : les chemins directs semblent utiles, le bénéfice mesuré des niveaux intermédiaires reste irrégulier.
Des négatifs inconnus et une petite étude d’interprétation
Les positifs sont des interactions enregistrées, mais beaucoup de négatifs supposés ne sont que des paires non observées. « Non enregistré » peut vouloir dire non testé, pas biologiquement impossible. Après déduplication, DrugBank comprend 17 250 positifs et 17 498 candidats négatifs. Les métadonnées initiales ne décrivent pas entièrement univers des candidats, graine, pondération par degré, contrôles de squelette et de similarité protéique.
La construction des candidats influence les résultats. Un échantillonnage tenant compte du degré des extrémités abaisse l’AUPR de 0,040–0,067 par rapport à l’uniforme dans certains tests. Trois candidats négatifs pour un positif donnent une AUPR de 0,680–0,878. La performance absolue dépend donc du pool de criblage.
Comme l’explique la recherche sur l’évaluation précision-rappel, l’AUROC peut rassurer quand les négatifs abondent, alors que la précision en tête de liste importe davantage en pratique. Les classements contradictoires de BindingDB l’illustrent. Aucun indicateur n’estime le taux de succès en laboratoire sans test prospectif.
Un exercice externe examine cinq interactions positives enregistrées avec les sous-unités alpha du récepteur GABAA, notamment clonazépam, isoflurane et desflurane. L’accord entre les cinq résidus les mieux classés et les régions générales attendues va de zéro à cinq. Une permutation non corrigée atteint 0,050, une autre 0,077 ; les autres sont moins probantes. Cela ne valide ni sites physiques ni mécanismes. L’attention peut identifier des entrées influentes sans révéler une causalité biochimique.
Reproduire maintenant, tester prospectivement ensuite
Les choix fixes comprennent seuil de contact 0,5, résolution Louvain 1,0 et trois résidus minimum par communauté. Ils n’ont pas été systématiquement optimisés. D’autres seuils, regroupements ou versions ESM-2 plus grandes pourraient modifier les résultats. Un prédicteur simple avec les mêmes représentations reste nécessaire pour isoler la contribution du graphe typé.
Les exécutions utilisent une Nvidia RTX 4090 avec entrées moléculaires et protéiques précalculées. Sur neuf combinaisons principales données/division, l’entraînement prend 26,8–43,6 minutes par graine. L’inférence test moyenne dure 5,3–11,1 secondes, environ 592–890 exemples par seconde, avec 1,53–2,54GiB de mémoire GPU maximale allouée. Le précalcul des séquences s’ajoute à ces durées.
Le package de reproduction inclut code, configurations, divisions traitées, manifestes, résumés et instructions. Les archives expérimentales comptent aussi ; l’article connexe sur une base de connaissances techniques traite de conserver des hypothèses consultables, pas de prouver la précision du modèle.
Les prochaines épreuves décisives sont des exclusions de familles protéiques avec références, candidats, graines, métriques et budgets identiques ; un modèle figé classant une bibliothèque pour une nouvelle cible avant essais en aveugle ; et des ablations contrôlées par représentation, séparant les raccourcis médicament/protéine. L’apprentissage positif-non étiqueté éviterait d’assimiler toute paire inconnue à un négatif. Des divisions temporelles entraîneraient avant une date limite pour prédire les découvertes ultérieures, sans fuite de connaissances futures dans le prétraitement.
Une étude prospective devrait rapporter liaison confirmée, activité fonctionnelle, faux positifs et enrichissement face aux alternatives pratiques. Des résultats négatifs pourraient révéler similarité trompeuse ou biais des bases. Pour l’instant, HierHGT-DTI priorise des candidats ; il ne remplace ni docking, ni biochimie, ni cellules, ni toxicologie, ni clinique. Ses meilleurs benchmarks méritent reproduction, pas transformation en annonce de médicaments découverts.