
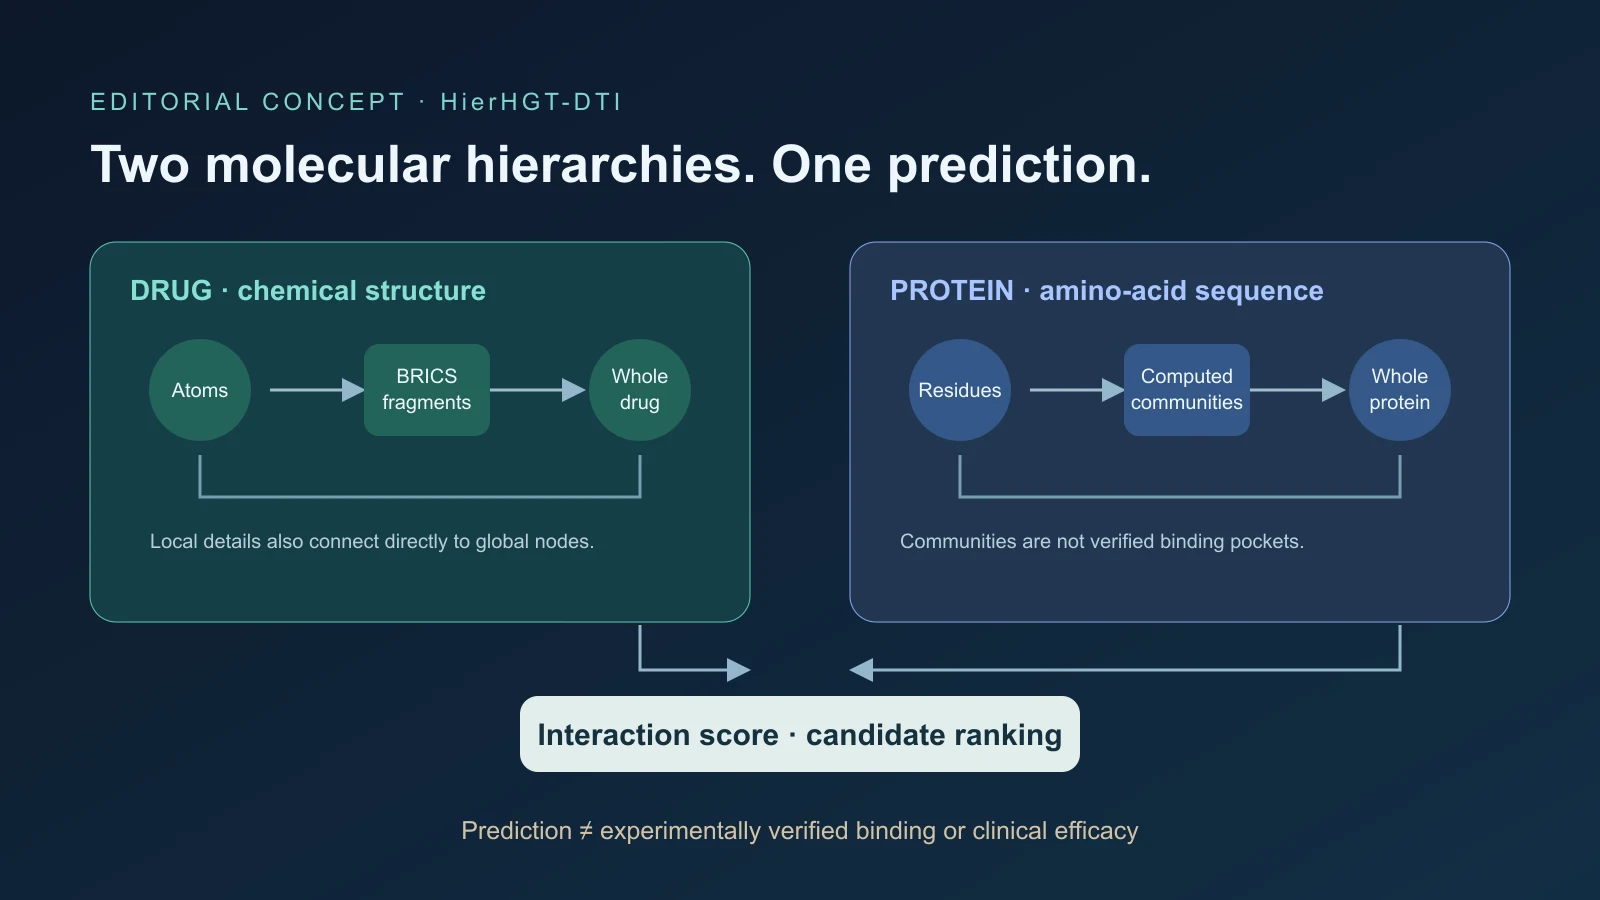
HierHGT-DTI 最有力的结果,是更好地为训练时未见的蛋白质靶标排列候选化合物,而不是发现了经过验证的药物。南华大学的 Zhangben Chen 和 Yaping Wan 将化学结构与蛋白质序列整合进类型化多尺度图。结果支持采用更严格的评估,也暴露了“冷启动”测试中仍然保留多少熟悉信息。
这项发表于 2026 年 9 月 14 日的 BMC Bioinformatics 研究,在 DrugBank、BioSNAP 和 BindingDB 上比较了六种替代模型。实际用途是安排实验优先级:决定哪些化合物—靶标配对应先占用有限的生化或细胞实验资源。预测分数不能确认物理结合、生化机制或临床疗效。
优势在哪里成立,在哪里不成立
研究采用随机、冷药物和冷蛋白划分。随机划分留出样本对,但训练与测试可能保留相同药物和蛋白质。冷药物划分留出完整药物身份;冷蛋白划分则将测试蛋白序列排除在训练与验证之外。后者更接近新发现关联、尚无成熟配体数据的靶标。
HierHGT-DTI 在 DrugBank 和 BioSNAP 的全部六种设置中领先。对照模型 MolTrans、TransformerCPI、DrugBAN、DO-GMA、GeNNius 和 HiGraphDTI 使用相同划分与五个随机种子,而不是从不同论文摘取分数。重复种子减少了对有利初始化的依赖。
DrugBank 冷蛋白 AUROC 为 0.864,AUPR 为 0.878。最强基线 AUROC 为 0.776,差距为 8.8 个百分点;AUPR 优势为 7.9 个百分点。BioSNAP 对应值为 0.863 和 0.866,最强基线 AUROC 为 0.805,差距 5.8 个百分点。这些主要差异通过了研究对 DrugBank/BioSNAP 基准组的多重比较校正。
BindingDB 不支持普遍优越的说法。HierHGT-DTI 以 0.681 领先冷蛋白 AUPR,但 HiGraphDTI 的 AUROC 略高,为 0.835 对 0.831。HiGraphDTI 也领先该数据集的随机与冷药物设置。随机划分中,它的 AUROC/AUPR 为 0.934/0.837,HierHGT-DTI 则为 0.932/0.829。
预处理数据规模不同:DrugBank 有 34,748 对、17,250 个正样本;BioSNAP 有 27,457 对、13,830 个正样本;BindingDB 有 24,743 对、5,784 个正样本。BindingDB 正样本比例为 23.4%,另两者接近 50%。AUROC 概括不同阈值下的正负排序,AUPR 强调检索正样本时的精确率与召回率,但随正样本比例而变,因此不能直接跨这些数据集比较其原始数值。
未见身份不等于陌生生物学
遗传学、疾病生物学、耐药研究或通路证据可以提出新靶标,却不一定提供足够已测试配体来训练常规监督模型。有关未探索治疗靶标的既有工作说明了相互作用记录稀缺的重要性。但基准记忆研究提醒,与熟悉化合物相似,可能让测试比部署容易。
常规 DrugBank 和 BioSNAP 冷药物划分中,超过一半测试化合物与训练或验证化合物共享 Bemis–Murcko 骨架。该骨架描述核心环及其连接框架:不是同一分子,却可能保留大量结构熟悉性。
增加骨架不重叠测试后,HierHGT-DTI 的 AUROC 在 BioSNAP 下降 2.5 个百分点、DrugBank 下降 2.1 点、BindingDB 下降 1.4 点。更严格的协议只测试了这一模型,因此不能据此重新排列它与六个基线的相对名次。
冷蛋白评估有类似限制。精确序列虽被排除,但没有按序列家族聚类后分离蛋白质,近缘同源蛋白仍可能分布在划分两侧。因此证据支持超越完全相同蛋白质的迁移,而不是已经证明跨远缘家族迁移。
分子细节如何形成配对分数
输入是编码药物化学结构的 SMILES 字符串,以及靶标氨基酸序列;不要求实验解析的三维结构。800 万参数的紧凑 ESM-2 蛋白语言模型提供每残基 320 维嵌入和预测接触图。这使只有序列的靶标也能使用,但仍需区分增益来自预训练特征还是图组织方式。
每个候选对形成一个异构图,含六类节点。药物侧为原子、化学子结构、完整药物超级节点;蛋白侧为残基、残基社区、完整蛋白超级节点。原子描述为 74 维,包括元素、价态、电荷、芳香性、杂化与手性。RDKit 的规则式 BRICS 片段化生成有化学意义的子结构。
蛋白分支保留完整记录序列,不截断长蛋白;太长而不能一次处理时,通过重叠窗口获得预测接触。序列邻近、预测接触和嵌入相似性连接残基,再由 Louvain 聚类形成社区。代码称其为“pockets”,但它们是计算分组,不是实验测得的配体结合口袋。
相邻尺度双向连接:原子—子结构—药物,以及残基—社区—蛋白。原子到药物、残基到蛋白的直接捷径,也将细节送至全局节点。药物—蛋白超级节点之间的双向边同时存在于正样本与未标记样本,其存在不会泄露相互作用标签。
图包含 18 类有向关系。两层异构图 Transformer 使用四个注意力头和 128 维隐藏层,区别处理不同关系。每个节点先按入边关系分别聚合消息,再由学习分配机制结合关系偏好和邻居数量。最终预测器组合药物与蛋白向量、逐元素乘积及绝对差,生成相互作用分数。
层级结构为何还不是增益的已证实原因
在六种 DrugBank/BioSNAP 设置中,移除中间层级只使 AUPR 变化 −0.0042 至 +0.0041。这些层级比较都未达到统计显著;完整双侧层级仅在三个设置中领先相关变体。移除细粒度到全局的直接捷径,则使六种设置的平均 AUPR 均下降,幅度为 0.0002—0.0109。
这一模式仍不是决定性因果证据。在完整的 96 项检验组校正后,没有任何消融比较仍然显著。同时移除两侧捷径,也无法将影响单独归因于药物侧或蛋白侧。
在一个 BioSNAP 检查点的推理阶段,分别移除直接捷径、蛋白内部关系和层级关系后,AUROC 分别下降 0.239、0.069 和 0.038。这说明一个已训练模型的依赖,并不证明其更广泛基准优势的原因。稳妥解读是:多路径集成系统有效,直接路径看起来有用,而中间层级的可测收益并不一致。
未知负样本与小规模解释实验
正标签来自已记录相互作用,但许多所谓负样本只是未观察到的配对。“未记录”可能意味着未测试,而不是生物学上不可能。DrugBank 去重后有 17,250 个正样本和 17,498 个候选负样本。原始采样元数据未完整说明候选总体、种子、度加权、骨架控制和蛋白相似性控制。
改变候选构建确实影响结果。部分测试中,考虑端点度数的采样相较均匀采样,使 AUPR 降低 0.040—0.067。候选负样本与正样本比例为 3:1 时,AUPR 为 0.680—0.878。因此筛选池设计会改变绝对性能。
精确率—召回率评估研究解释,负样本很多时 AUROC 可能显得令人安心,但头部候选的筛选精确率对实际操作更重要。BindingDB 上 AUROC 与 AUPR 的排名冲突说明了这种区别。没有前瞻测试,两种指标都不能估计实验室命中率。
一项外部解释练习检查了 GABAA 受体 alpha 亚基的五个已记录正相互作用,包括 clonazepam、isoflurane 和 desflurane。模型排名最高的五个残基与预期粗区域的重合,从五个中零个到五个全部都有。一个未经校正的置换检验值为 0.050,另一个为 0.077,其余更弱。这种不均衡结果没有验证物理结合位点或机制。注意力可以指示哪些输入有影响,却不能自动揭示生化因果。
现在可复现,下一步仍需前瞻证据
固定预处理包括 0.5 接触阈值、1.0 Louvain 分辨率,以及至少三个残基的社区。这些设置未系统优化。不同阈值、聚类或更大的 ESM-2 表征可能改变结果。仍需给更简单的预测器相同嵌入,以分离类型化图的贡献。
研究使用一张 Nvidia RTX 4090 和预计算的分子、蛋白输入。九种主要数据集/划分组合中,每个种子训练 26.8—43.6 分钟;平均测试推理 5.3—11.1 秒,约每秒 592—890 个样本,峰值分配显存 1.53—2.54GiB。序列表征预计算是训练时间之外的额外工作。
复现包包含代码、配置、处理后划分、清单、结果摘要及复现说明。实验记录也需要组织;相关工程知识库文章讨论的是保留可搜索的技术假设,不是本模型准确率的证据。
下一步关键测试包括:在相同基线、候选集、种子、指标和调参预算下留出蛋白家族;冻结模型,为新靶标的化合物库排序,再进行盲法检测;采用表征受控消融,并分别移除药物侧、蛋白侧捷径。正样本—未标记学习可避免将每个未记录配对都当负样本。时间划分则用截止日前知识训练、预测之后发现,防止未来知识进入预处理。
前瞻研究应报告确认结合、功能活性、假阳性及相对实用方案的富集程度;负结果也能暴露序列相似性或数据库偏差。目前 HierHGT-DTI 是候选优先级工具,不能取代对接、生化检测、细胞研究、毒理学或临床评估。它最强的基准证据值得复现,而不是被改写成发现药物的宣告。