
HierHGT-DTI의 가장 강한 결과는 학습에서 제외한 단백질 표적에 대해 화합물 순위를 더 잘 매겼다는 것이지, 검증된 약물을 발견했다는 것이 아니다. University of South China의 Zhangben Chen과 Yaping Wan은 화학 구조와 단백질 서열을 유형화된 다중 스케일 그래프에 결합했다. 결과는 더 어려운 평가의 필요성을 뒷받침하지만 ‘콜드스타트’에 여전히 익숙한 정보가 남는다는 점도 보여 준다.
2026년 9월 14일 발표된 BMC Bioinformatics 연구는 DrugBank, BioSNAP, BindingDB에서 여섯 대안을 비교한다. 실용적 목적은 제한된 생화학·세포 실험을 어떤 화합물–표적 쌍에 먼저 배정할지 결정하는 것이다. 예측 점수는 물리적 결합, 생화학적 기전, 임상 효능을 확인하지 않는다.
벤치마크 우위가 성립하는 곳과 그렇지 않은 곳
연구진은 무작위, 콜드드러그, 콜드프로틴 분할을 사용했다. 무작위 분할은 쌍을 제외해도 같은 약물과 단백질을 학습·시험에 남길 수 있다. 콜드드러그는 약물 전체를, 콜드프로틴은 시험 단백질 서열을 학습과 검증에서 제외한다. 후자는 확립된 리간드 데이터가 없는 새로운 표적에 더 가깝다.
HierHGT-DTI는 DrugBank와 BioSNAP의 여섯 설정 모두에서 앞섰다. MolTrans, TransformerCPI, DrugBAN, DO-GMA, GeNNius, HiGraphDTI는 다른 논문에서 가져온 점수가 아니라 동일한 분할과 다섯 무작위 시드를 사용했다. 시드 반복은 유리한 초기화에 대한 의존을 줄인다.
DrugBank 콜드프로틴 AUROC는 0.864, AUPR은 0.878이었다. 가장 강한 기준선 AUROC는 0.776으로 8.8%포인트 차이였고 AUPR 우위는 7.9포인트였다. BioSNAP은 0.863과 0.866이었으며 기준선 최고 AUROC 0.805와 5.8포인트 차이가 났다. 이 주요 차이는 DrugBank/BioSNAP 벤치마크 계열의 다중 비교 보정 후에도 유지됐다.
BindingDB는 보편적 우위 주장을 막는다. HierHGT-DTI는 콜드프로틴 AUPR 0.681로 선두지만 AUROC는 HiGraphDTI가 0.835 대 0.831로 더 높았다. HiGraphDTI는 무작위와 콜드드러그에서도 앞섰다. 무작위 AUROC/AUPR은 0.934/0.837이고 HierHGT-DTI는 0.932/0.829였다.
준비된 데이터도 다르다. DrugBank는 34,748쌍과 양성 17,250개, BioSNAP은 27,457쌍과 13,830개, BindingDB는 24,743쌍과 5,784개였다. 양성 비율은 BindingDB가 23.4%, 나머지는 약 50%다. AUROC는 여러 임계값의 양성·음성 순위를 요약한다. AUPR은 찾아낸 양성의 정밀도와 재현율을 강조하지만 양성 비율에 따라 달라지므로 이 데이터셋 사이 원시 값을 직접 비교하면 안 된다.
보지 못한 개체가 낯선 생물학은 아니다
유전학, 질병 생물학, 내성, 경로 증거로 새 표적을 찾더라도 일반 지도학습에 충분한 검증 리간드가 없을 수 있다. 미개척 치료 표적 연구는 상호작용 이력 부족의 중요성을 보여 준다. 그러나 벤치마크 암기 연구는 익숙한 화합물과의 유사성이 시험을 실사용보다 쉽게 만들 수 있다고 경고한다.
일반적인 DrugBank/BioSNAP 콜드드러그 분할에서는 시험 화합물의 절반 이상이 학습·검증 화합물과 Bemis–Murcko 골격을 공유했다. 중심 고리와 연결 구조를 나타내는 골격은 분자 동일성은 아니지만 상당한 구조적 친숙성을 유지할 수 있다.
골격을 공유하지 않는 추가 시험에서 HierHGT-DTI AUROC는 BioSNAP 2.5포인트, DrugBank 2.1포인트, BindingDB 1.4포인트 하락했다. 더 엄격한 프로토콜은 이 모델에만 적용됐으므로 여섯 기준선과의 새로운 상대 순위를 정할 수 없다.
콜드프로틴도 비슷하다. 동일 서열은 빠졌지만 단백질을 서열 계열별로 묶어 분리하지 않아 가까운 상동체가 양쪽에 남을 수 있다. 증거는 동일 단백질을 넘는 전이를 지지하지만 먼 계열로의 전이를 입증하지는 않는다.
분자 세부 정보가 쌍별 점수로 이어지는 과정
입력은 화학 구조를 표현한 약물 SMILES와 표적 아미노산 서열이며 실험적으로 규명한 3차원 구조는 필요하지 않다. 800만 파라미터의 소형 ESM-2가 잔기당 320차원 임베딩과 예측 접촉 지도를 제공한다. 서열만 알려진 표적도 다룰 수 있지만 개선 중 사전학습 특성과 그래프 조직의 몫은 분리되지 않았다.
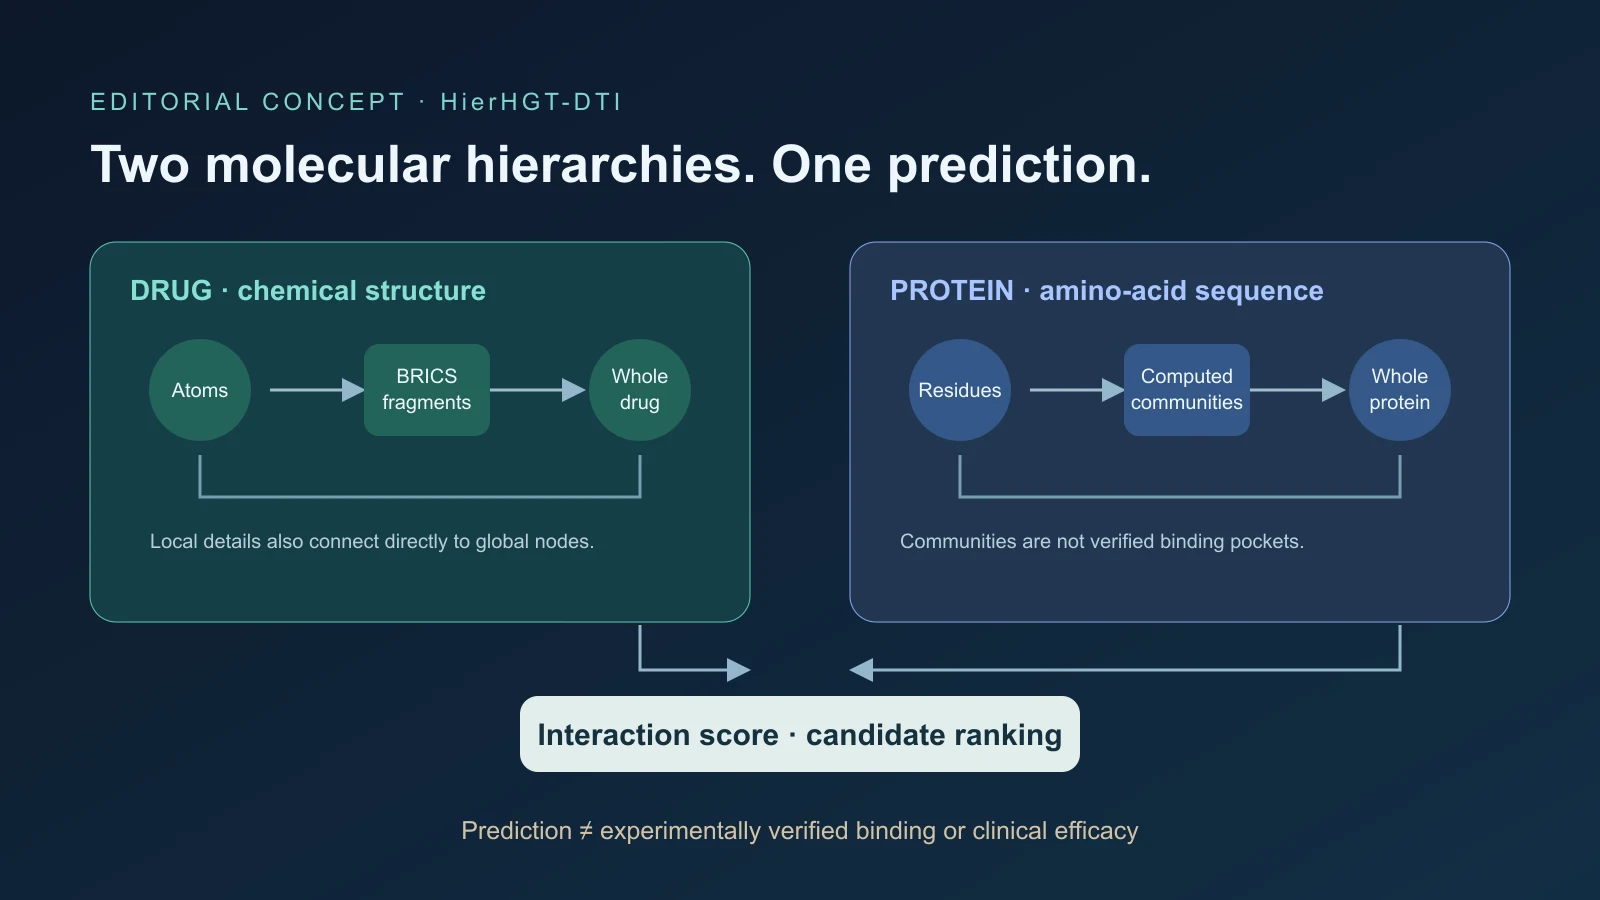
각 후보 쌍은 여섯 노드 유형의 이종 그래프가 된다. 약물 측은 원자·하위구조·전체 약물 슈퍼노드, 단백질 측은 잔기·커뮤니티·전체 단백질 슈퍼노드다. 원자 기술자는 원소, 원자가, 전하, 방향족성, 혼성화, 키랄성을 포함한 74차원이다. RDKit의 규칙 기반 BRICS 분할이 화학적으로 의미 있는 하위구조를 만든다.
단백질 분기는 긴 서열을 자르지 않고 보존하며 한 번에 처리할 수 없으면 중첩 창에서 접촉을 예측한다. 서열 근접성, 예측 접촉, 임베딩 유사성이 잔기를 연결하고 Louvain 군집화가 커뮤니티를 만든다. 코드는 이를 ‘pockets’라고 부르지만 계산된 그룹이며 실험으로 측정한 리간드 결합 포켓이 아니다.
인접 스케일은 원자–하위구조–약물, 잔기–커뮤니티–단백질을 양방향으로 연결한다. 원자–약물과 잔기–단백질 직접 지름길도 세부 정보를 전역 노드에 전달한다. 슈퍼노드 사이 양방향 간선은 양성과 미표지 쌍에 모두 있어 정답을 누설하지 않는다.
그래프는 18개 방향 관계를 사용한다. 이종 그래프 트랜스포머 두 층이 네 어텐션 헤드와 은닉 크기 128로 관계를 구별한다. 각 노드는 들어오는 관계별로 메시지를 모으고 학습된 할당이 관계 선호와 이웃 수를 고려해 결합한다. 예측기는 약물·단백질 벡터, 원소별 곱, 절대 차이를 결합해 상호작용 점수를 만든다.
계층이 성능 향상의 입증된 원인은 아닌 이유
중간 계층 제거에 따른 AUPR 변화는 여섯 DrugBank/BioSNAP 설정에서 −0.0042+0.0041뿐이었다. 계층 비교는 모두 통계적으로 유의하지 않았고 양측 전체 계층이 관련 변형을 앞선 경우는 세 설정뿐이었다. 직접 지름길을 제거하면 여섯 설정 모두 평균 AUPR이 0.00020.0109 하락했다.
그 패턴도 결정적 인과 증거는 아니다. 전체 96개 검정을 보정하면 유의한 제거 비교는 없었다. 양쪽 지름길을 함께 제거했으므로 약물 측과 단백질 측 효과도 분리할 수 없다.
한 BioSNAP 체크포인트의 추론 단계에서 직접 지름길, 단백질 내부 관계, 계층 관계를 각각 제거하자 AUROC는 차례로 0.239, 0.069, 0.038 하락했다. 이는 한 모델의 의존 관계를 진단할 뿐 일반 우위의 원인을 증명하지 않는다. 방어 가능한 해석은 여러 경로를 가진 통합 시스템의 효과다. 직접 경로는 유용해 보이지만 중간 계층의 측정 이익은 일관되지 않는다.
미확인 음성과 작은 해석 실험
양성은 기록된 상호작용이지만 많은 이른바 음성은 관찰되지 않은 쌍이다. ‘미기록’은 미시험일 수 있으며 생물학적으로 불가능하다는 뜻이 아니다. 중복 제거 DrugBank는 양성 17,250개와 후보 음성 17,498개였다. 원래 메타데이터는 후보 전체, 시드, 차수 가중치, 골격·단백질 유사성 통제를 완전히 문서화하지 않았다.
후보 구성을 바꾸면 결과도 변했다. 일부 시험에서 양 끝점 차수를 고려한 샘플링은 균일 샘플링보다 AUPR을 0.0400.067 낮췄다. 후보 음성 대 양성을 3:1로 하면 AUPR은 0.6800.878이었다. 스크리닝 풀 설계가 절대 성능에 영향을 준다.
정밀도–재현율 평가 연구가 설명하듯 음성이 많으면 AUROC가 안심할 수 있는 값이어도 상위 후보 정밀도가 실무에 더 중요할 수 있다. BindingDB의 서로 다른 순위가 이 차이를 보여 준다. 전향 시험 없이 어떤 지표도 실험실 적중률을 추정하지 못한다.
외부 해석 실험은 clonazepam, isoflurane, desflurane을 포함해 GABAA 수용체 알파 소단위체의 기록된 양성 상호작용 다섯 건을 조사했다. 상위 다섯 잔기와 예상된 대략적 영역의 겹침은 0~5개였다. 보정하지 않은 순열 값은 한 건이 0.050, 다른 건이 0.077이며 나머지는 약했다. 물리적 부위나 기전을 검증한 결과가 아니다. 어텐션은 영향을 준 입력을 보여 주지만 생화학적 원인을 자동으로 밝히지 않는다.
재현은 지금 가능하지만 다음에는 전향 증거가 필요하다
고정 전처리는 접촉 임계값 0.5, Louvain 해상도 1.0, 커뮤니티 최소 세 잔기를 포함하며 체계적으로 최적화되지 않았다. 다른 임계값·군집화·더 큰 ESM-2가 결과를 바꿀 수 있다. 같은 임베딩을 사용하는 단순 예측기로 유형화 그래프의 기여를 분리해야 한다.
실행은 사전 계산한 분자·단백질 입력과 Nvidia RTX 4090 한 대를 썼다. 아홉 주요 데이터셋·분할 조합에서 시드당 학습은 26.843.6분이었다. 평균 시험 추론은 5.311.1초, 초당 약 592890샘플이며 최대 할당 GPU 메모리는 1.532.54GiB였다. 서열 사전 계산은 이 학습 시간 밖의 추가 작업이다.
재현 패키지는 코드, 설정, 처리된 분할, 매니페스트, 결과 요약과 절차를 제공한다. 체계적 기록도 중요하다. 관련 기술 지식 베이스 글은 검색 가능한 가정을 보존하는 방법이지 이 모델 정확도의 증거가 아니다.
다음 결정적 시험은 동일 기준선·후보·시드·지표·튜닝 예산으로 단백질 계열을 제외하는 평가, 고정 모델이 새 표적 화합물 라이브러리를 순위화한 뒤 수행하는 맹검 실험, 그리고 같은 표현을 통제하며 약물·단백질 지름길을 각각 제거하는 실험이다. 양성–미표지 학습은 미기록 쌍을 모두 음성으로 두지 않는다. 시간 분할은 기준일 이전 지식으로 학습해 이후 발견을 예측하고 미래 지식이 전처리에 들어오는 것을 막는다.
전향 연구는 확인된 결합, 기능 활성, 거짓 양성, 실용적 대안 대비 농축도를 보고해야 한다. 음성 결과도 오해를 부르는 서열 유사성이나 데이터베이스 편향을 드러낼 수 있다. 현재 HierHGT-DTI는 후보 우선순위 도구이며 도킹, 생화학 실험, 세포 연구, 독성학, 임상 평가를 대체하지 않는다. 가장 강한 벤치마크 증거는 재현 대상이지 약물 발견 선언으로 바꿀 근거가 아니다.