
Nano Banana 2.1 verspricht Bildproduktionsteams zwei verschiedene Vorteile: bessere Ergebnisse in Googles Vergleichen und niedrigere Preise für erzeugte Bildtoken. Keiner davon belegt allein, dass ein veröffentlichungsfähiges Motiv günstiger wird. Entscheidend ist, ob die gemessenen Vorteile auch Anforderungen an Identität, Fakten, geschützte Produktdetails und die Gesamtkosten wiederholter Versuche erfüllen.
Diese Analyse vom 14. Oktober folgt auf Googles allgemeine Verfügbarkeit vom 6. Oktober, nicht auf einen neuen Start am selben Tag. Ihre stärksten Signale betreffen Infografikpräferenzen, die Konsistenz mehrerer Figuren und einige Bearbeitungen. Die schwächste Lesart wäre, Präferenzwerte in Genauigkeitsprozente umzudeuten, überall denselben Thinking-Nutzen anzunehmen oder jede Anfrage als halb so teuer zu bezeichnen.
Der tatsächliche Endpunkt hat engere Grenzen als die Modellkarte
Das API-Änderungsprotokoll nennt gemini-nano-banana-2.1 als stabile Kennung. Google beschreibt ein Flash-Update von Gemini 3.1 Flash Image, auch Nano Banana 2 genannt, kein neues Pro-Modell. Laut Modellkarte basiert es auf Gemini 3.6 Flash, nimmt Text und Bilder an und liefert Bilder und Text.
Implementierungsdetails sind ebenso wichtig wie diese Herkunft. Die Endpunktdokumentation nennt standardmäßig 1K und maximal 4K Ausgabe. Thinking bietet minimal, medium und high; medium ist voreingestellt. Such-Grounding wird unterstützt, Funktionsaufrufe, Codeausführung und strukturierte Ausgaben dagegen nicht. Anwendungen müssen entsprechende Orchestrierung und Prüfungen außerhalb des Bildmodells übernehmen.
Eine Kapazitätsabweichung bleibt ungeklärt. Die Karte nennt bis zu eine Million Kontexttoken und 64K Textausgabe, die Gemini-API-Seite hingegen 131.072 Eingabe- und 32.768 Ausgabetoken. Die Quellen erklären das Verhältnis nicht. Für die Bereitstellung gelten die dokumentierten Grenzen des tatsächlich verwendeten Endpunkts, nicht automatisch die größeren Architekturangaben.
Die Mehrbildfusion akzeptiert bis zu 14 Referenzbilder, darunter höchstens vier Figuren und zehn Objekte. Das sind Eingabegrenzen, keine Garantie, vier Identitäten oder sämtliche Referenzelemente zuverlässig zu erhalten.
Die Karte nennt außerdem unscharfe oder beschädigte kleine und lange Texte, Identitätsdrift, Links-rechts-Verwechslungen, unvollkommenes 3D-Denken und Faktenwissen sowie gelegentliche Verzögerungen und Timeouts. Maskenreste und beibehaltene Posen sind zusätzliche Bearbeitungsrisiken. Diese anerkannten Grenzen brauchen Fehlerkriterien und Rückfalloptionen; mehr Referenzen oder Kontext beseitigen sie nicht.
Generierungsergebnisse belegen Vorlieben, nicht Richtigkeit
Google vergleicht menschliche Präferenzen mit Elo. Gemessen wird nicht der Anteil korrekter Bilder. Die veröffentlichten ±-Bereiche bieten Orientierung, aber ihr Konfidenzniveau fehlt. Auch Stichprobengröße, Prompts, Auflösung, Wiederholungsbudget, genaue Thinking-Konfiguration und gleiche Rechenbedingungen werden nicht offengelegt.
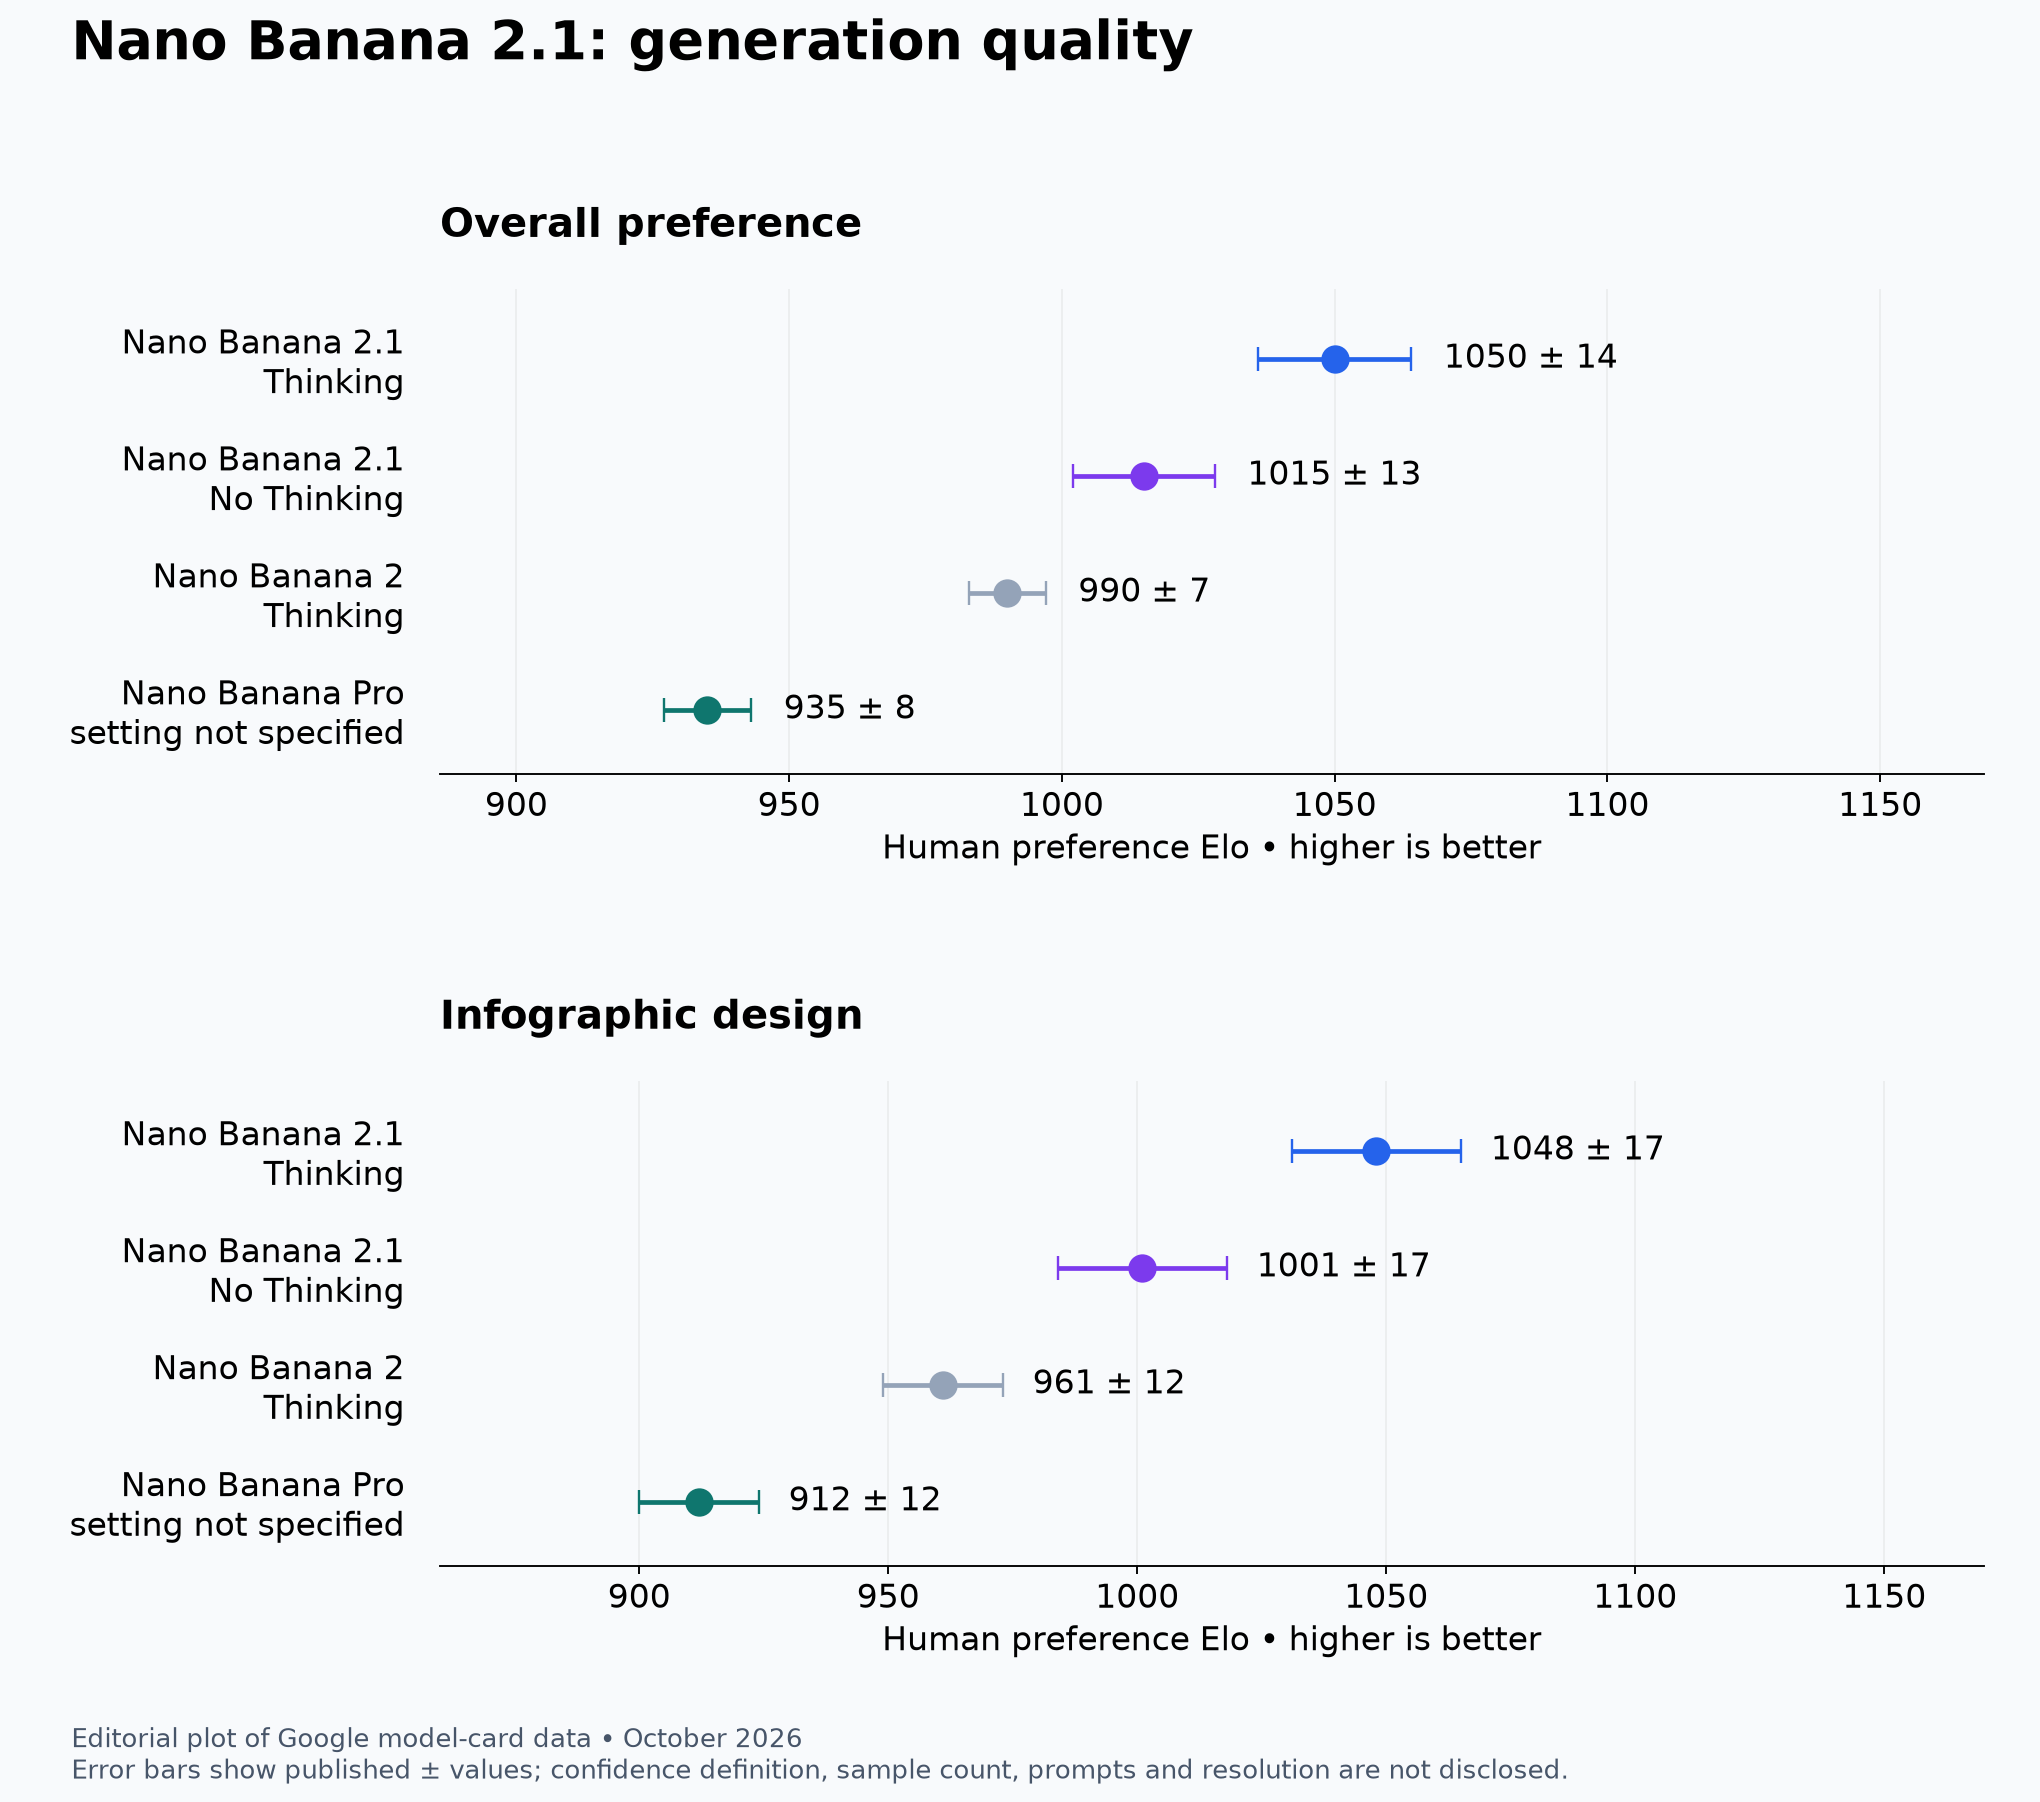
Redaktionelle Darstellung der Zahlen aus Googles Modellkarte vom Oktober 2026, kein Google-Originalbild. Die Fehlerbalken übernehmen die publizierten Bereiche; weder deren Konfidenzdefinition noch eine Produktionsgenauigkeit ist damit bestimmt.
Bei allgemeiner Generierung erzielt 2.1 Thinking 1050 ±14, ohne Thinking 1015 ±13, Nano Banana 2 Thinking 990 ±7 und Pro 935 ±8. Beim Infografikdesign lauten die Werte in derselben Reihenfolge 1048 ±17, 1001 ±17, 961 ±12 und 912 ±12. Selbst unter Berücksichtigung der dargestellten Bereiche liegen beide 2.1-Varianten bei Infografiken über Nano Banana 2.
Der allgemeine Thinking-Bereich von 1036–1064 überschneidet sich nicht mit 1002–1028 ohne Thinking. Beim Infografikdesign berühren sich die Bereiche bei 1031. Der erste Vergleich trennt deutlicher, aber keiner liefert eine Effektgröße für jeden Prompt. Die pauschale Bezeichnung „Thinking“ entspricht auch nicht zwingend der API-Stufe high: Die Testkonfiguration fehlt.
Eine operative Abkürzung folgt daraus nicht. Ein Präferenzvorsprung beweist weder weniger Wiederholungen noch geringere Latenz oder richtige Diagrammbeschriftungen. Google berichtet hier keine Benchmark-Latenz. Kreativteams haben besonders für Komposition und Layout einen Testgrund, aber keinen Beleg für universelle Beschleunigung oder erfundene Renditen.
Mehrere Figuren verändern den Wert von Thinking
Eine wiederkehrende Person und eine Szene mit mehreren Identitäten sind verschiedene Aufgaben. Die Konsistenztests machen den Unterschied sichtbar.
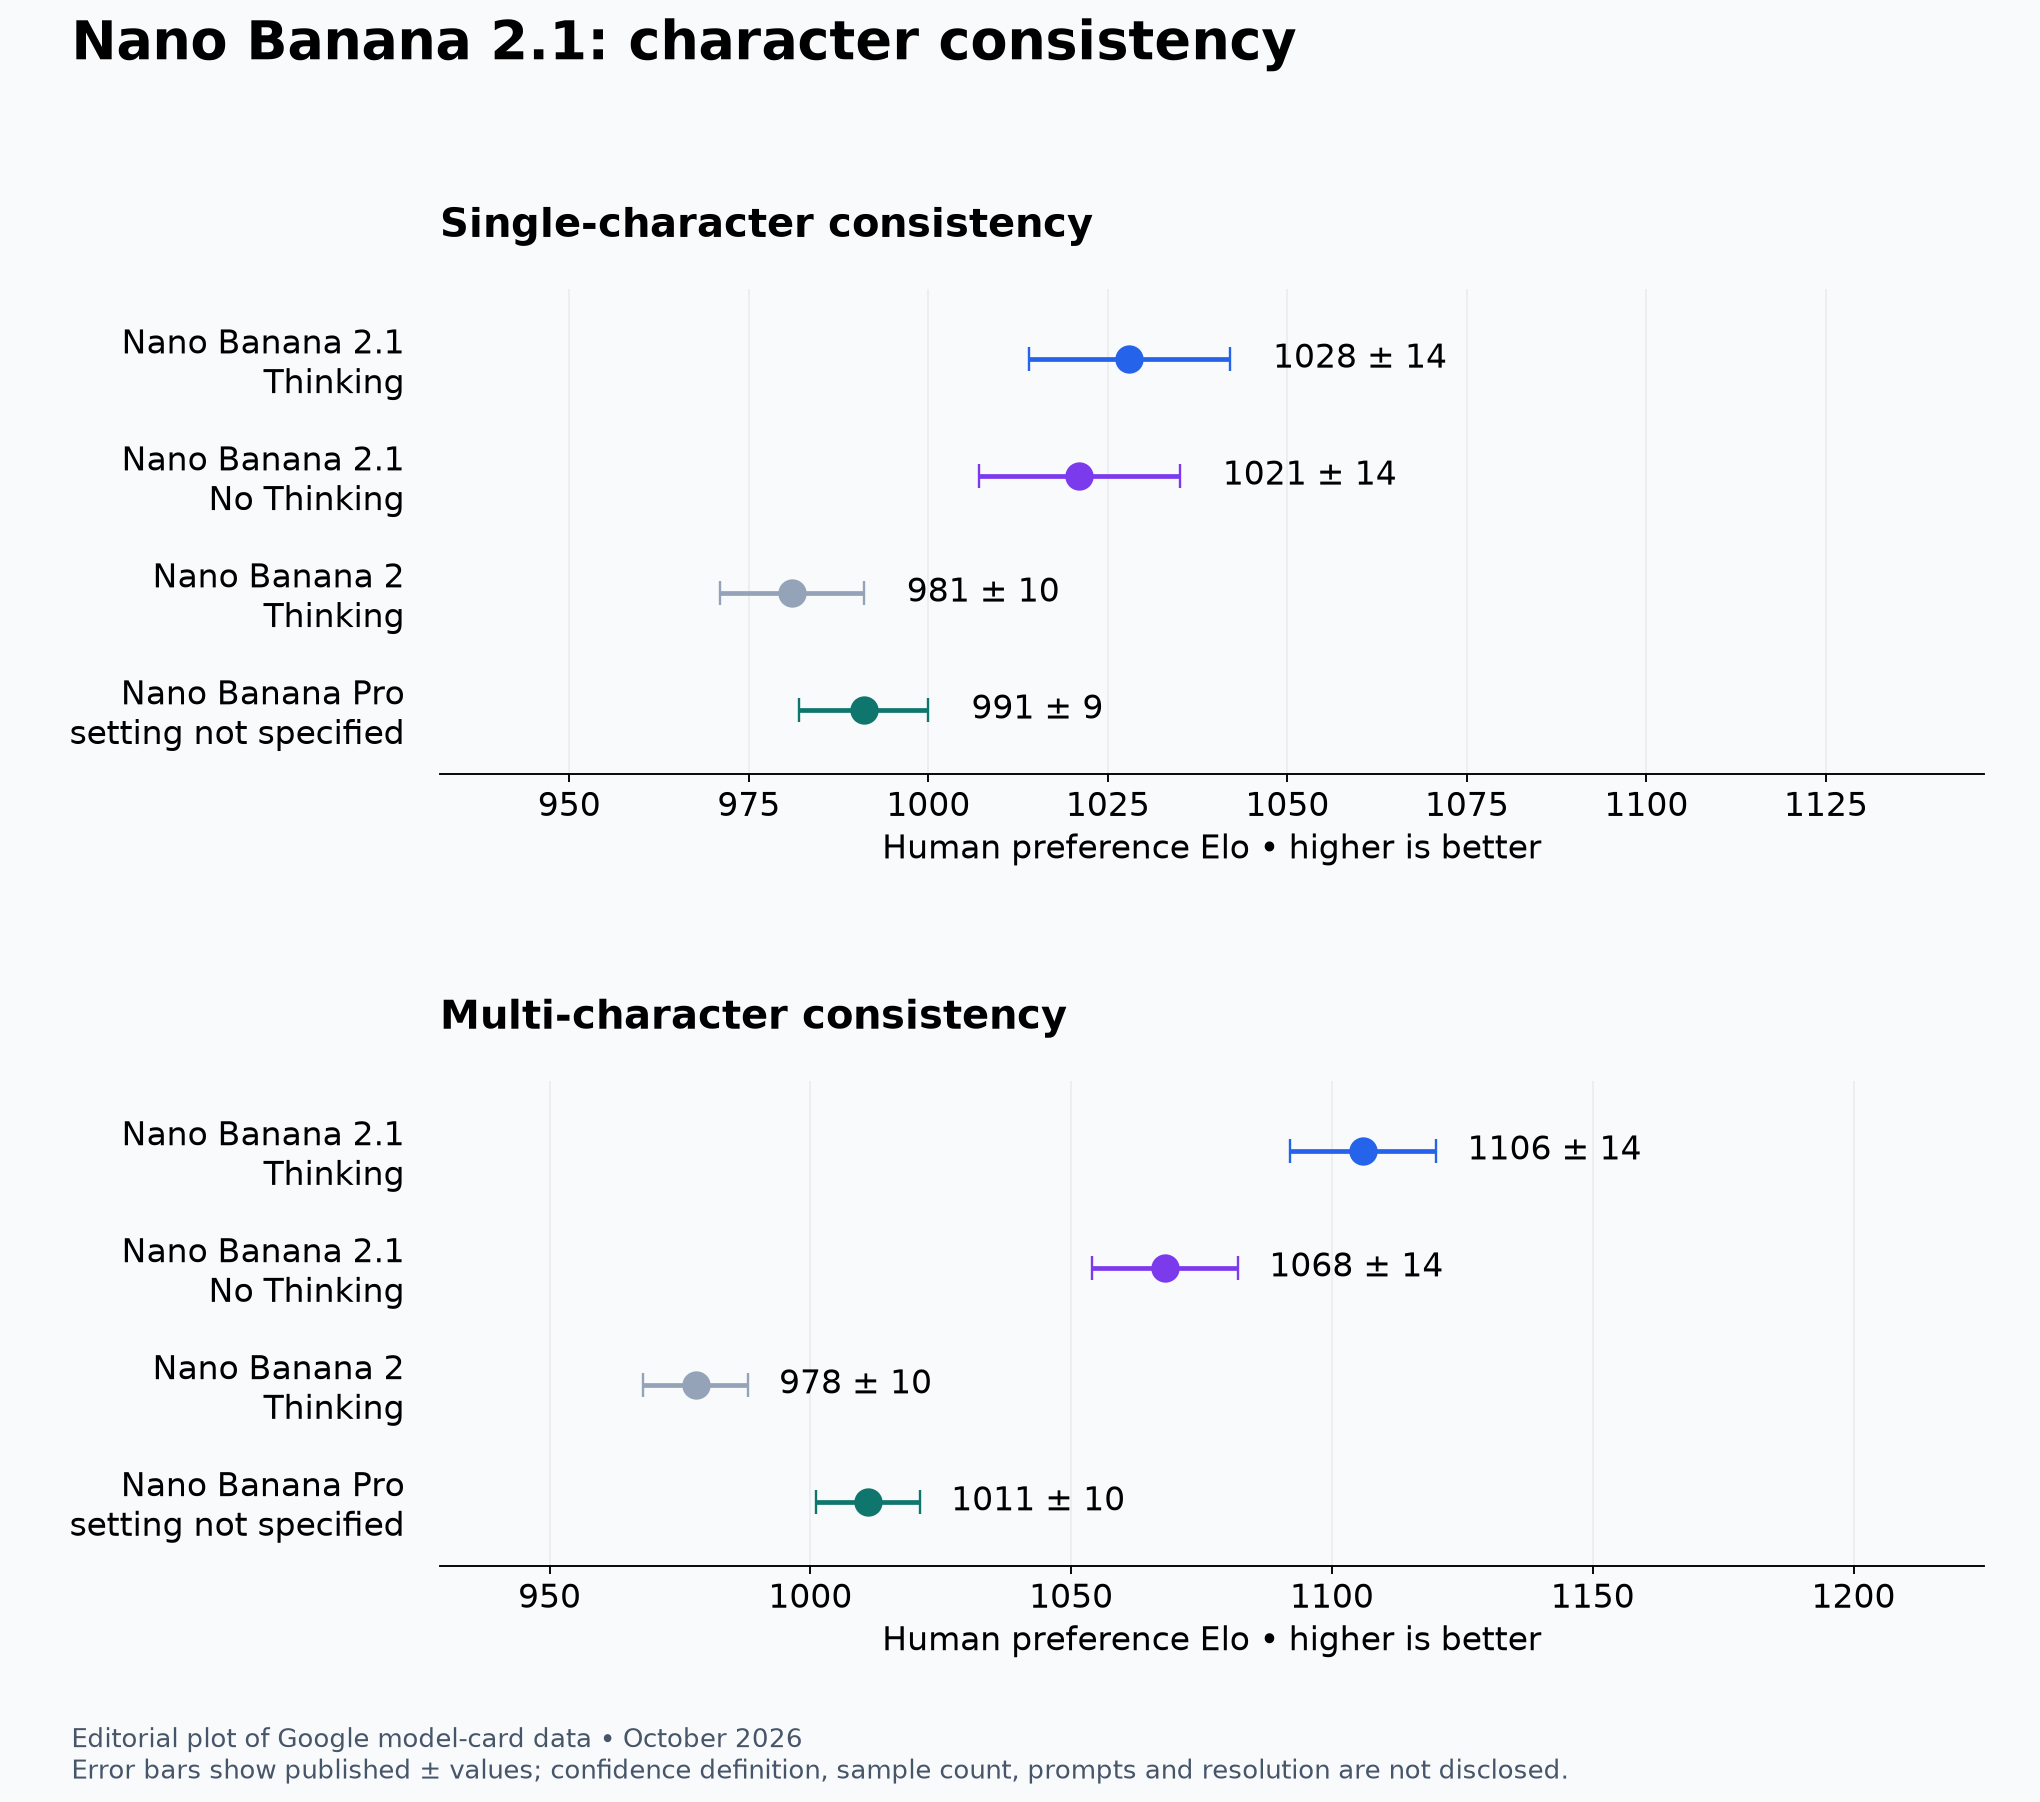
Redaktionelle Grafik desselben Google-Datensatzes. Die publizierten Bereiche besitzen keine erklärte Konfidenzdefinition; die Illustration stammt nicht von Google.
Bei einer Figur erreicht 2.1 Thinking 1028 ±14 und ohne Thinking 1021 ±14; Nano Banana 2 Thinking liegt bei 981 ±10, Pro bei 991 ±9. Die 2.1-Bereiche überschneiden sich stark. Sieben Punkte Unterschied der Zentralwerte rechtfertigen nicht, jede Einzelpersonen-Anfrage mit zusätzlichem Reasoning auszuführen.
Bei mehreren Figuren ist die Trennung größer: 1106 ±14 mit Thinking, 1068 ±14 ohne, 1011 ±10 für Pro und 978 ±10 für Nano Banana 2 Thinking. Die 2.1-Bereiche überlappen nicht. Thinking wird damit interessanter, wenn mehrere Identitäten und Beziehungen erhalten bleiben müssen; eine zuverlässige Vierpersonen-Darstellung bei jeder Referenzkombination ist trotzdem nicht bewiesen.
Ein ansprechendes Gruppenbild kann Kleidung vertauschen oder eine Person auslassen. Der Benchmark schlüsselt Gesichtsdrift, veränderte Proportionen, Kleidungsübertragung, Duplikate oder falsche relative Körpergrößen nicht auf. Die Produktionsprüfung muss Personen einzeln bewerten, besonders bei beschnittenen, widersprüchlichen, unterschiedlich beleuchteten oder ähnlich aussehenden Referenzen. Eine ästhetische Gesamtstimme kann einen unbrauchbaren Identitätsfehler verdecken.
Bearbeitung hängt davon ab, was unverändert bleiben muss
Auch die Bearbeitung erlaubt kein pauschales „Thinking gewinnt“. Masken, Produkttreue und Referenzkombination schützen unterschiedliche Bildbestandteile.
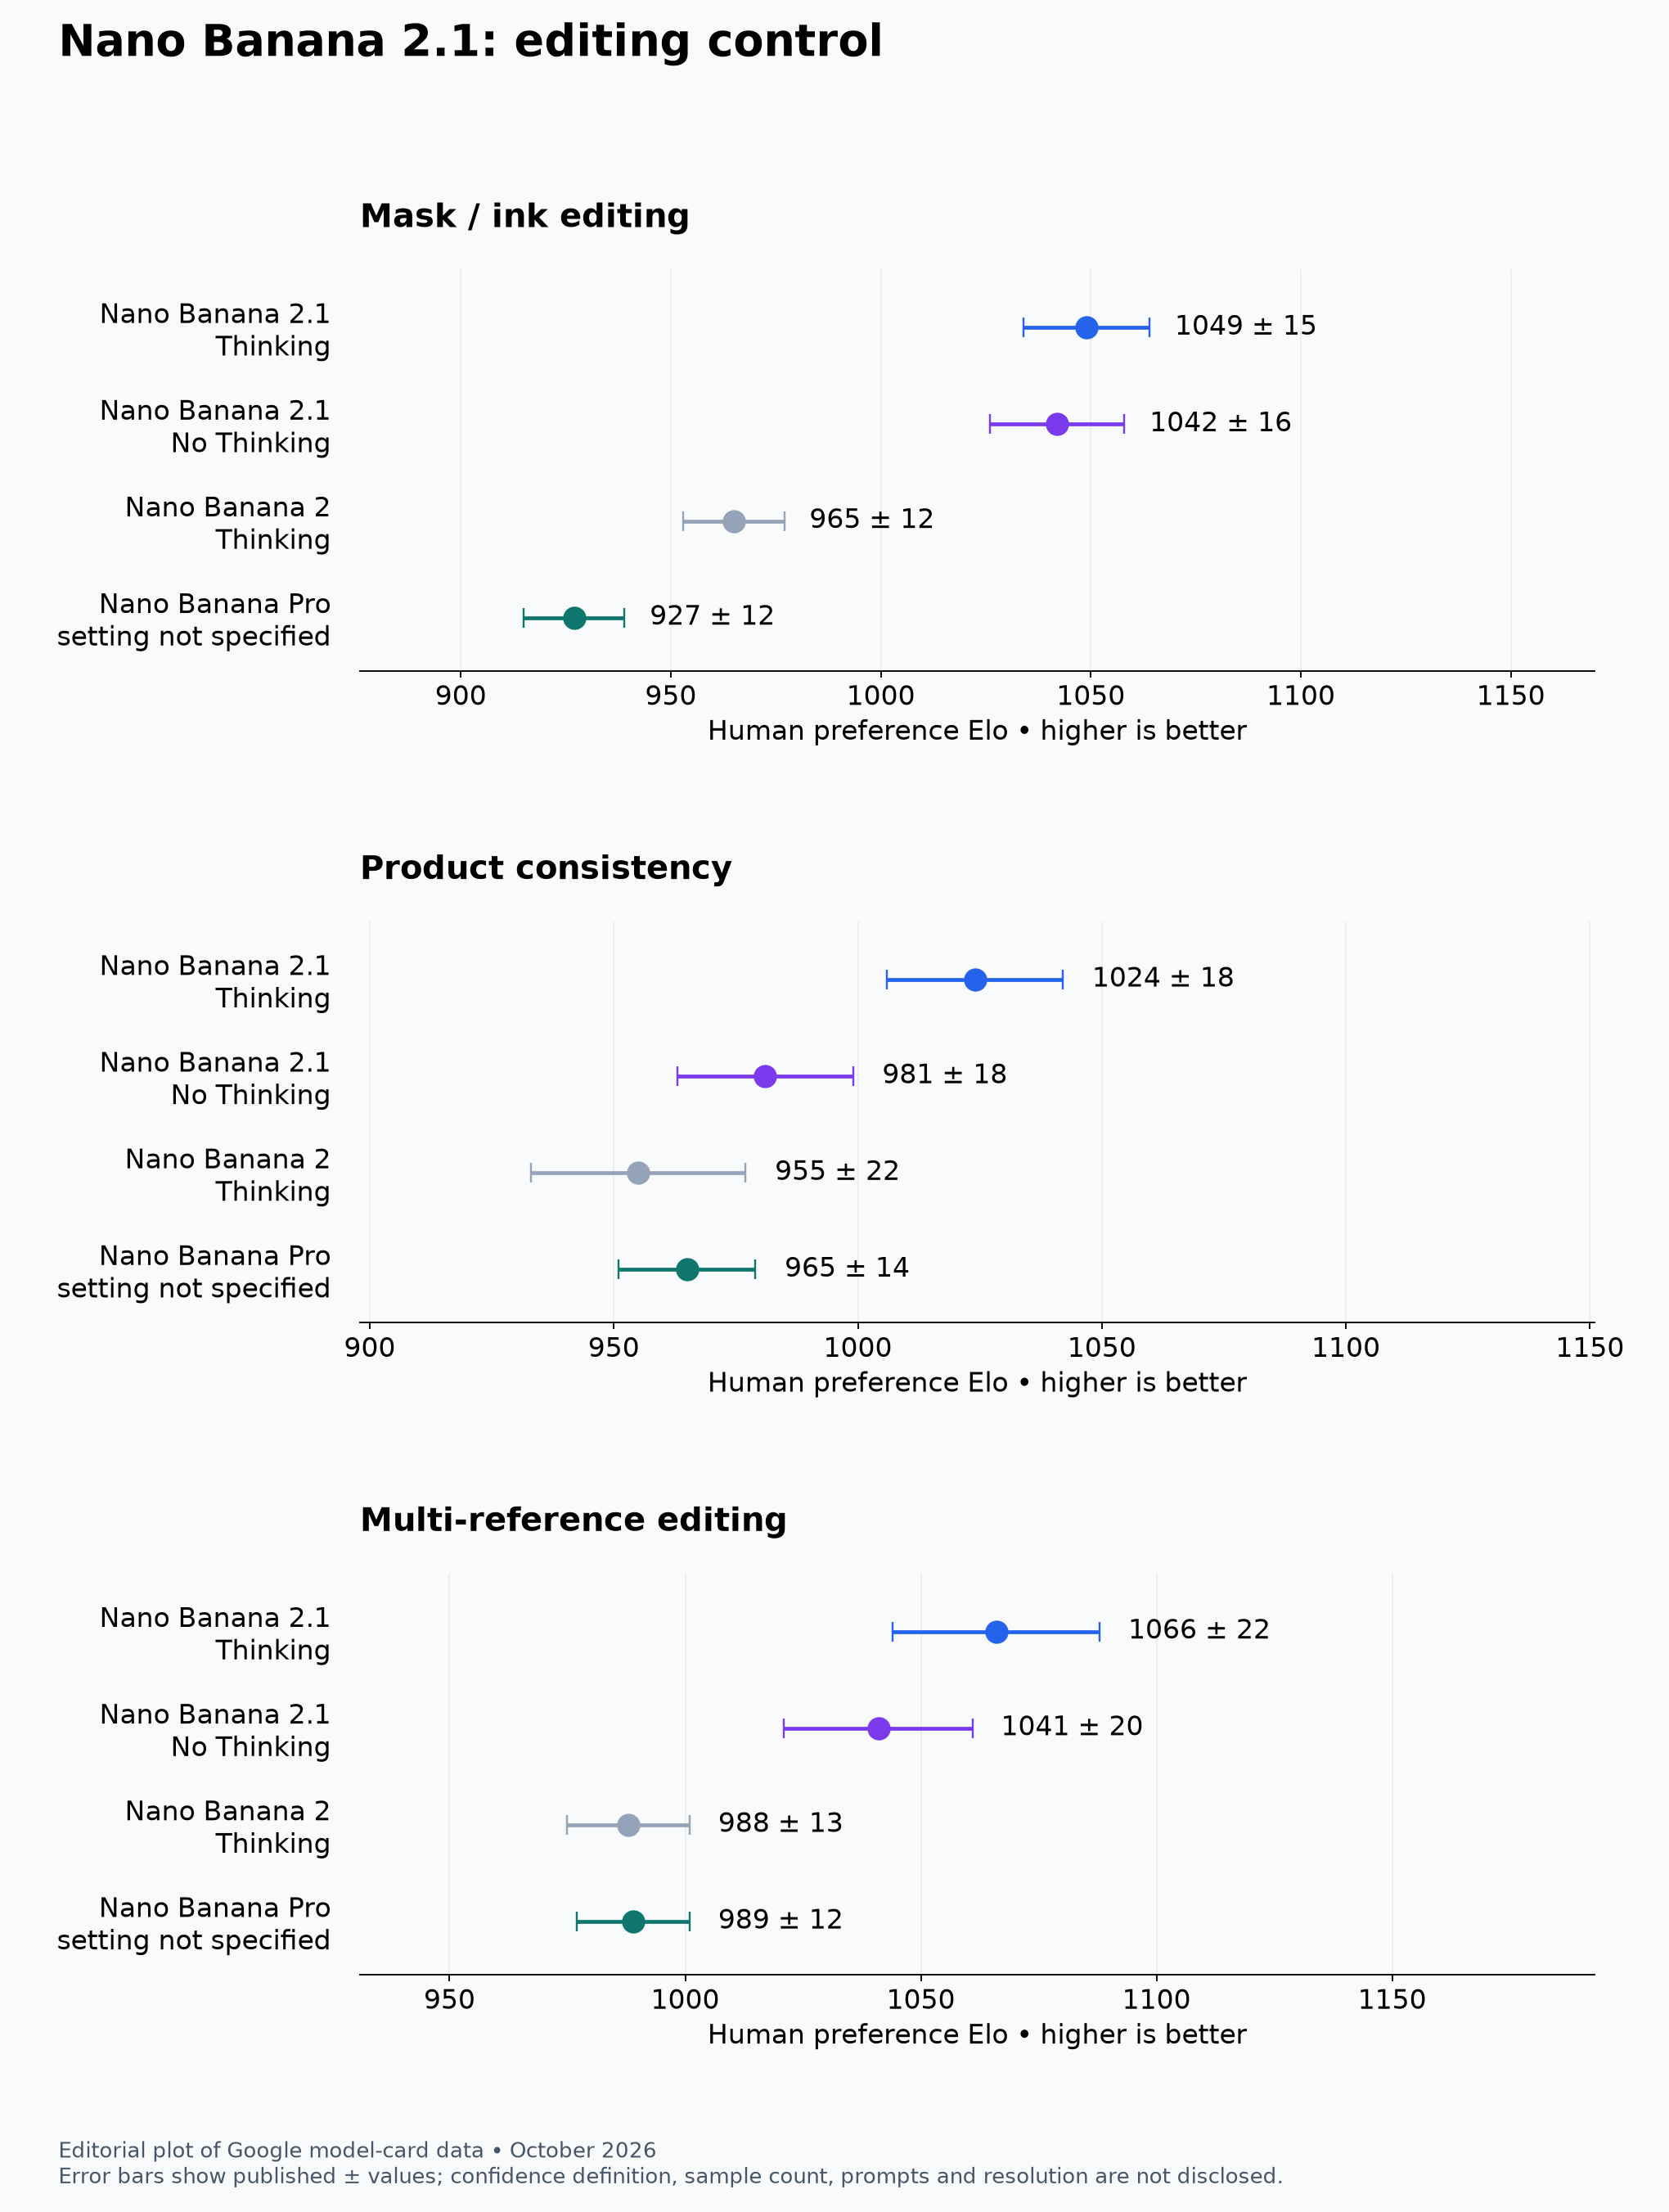
Redaktionelle Darstellung nach Googles Modellkarte, kein Originalmotiv von Google. Präferenz-Elo und ±-Bereiche messen weder exakte Anweisungsbefolgung noch unveränderte Pixel außerhalb einer Maske.
Bei Masken- oder Strichbearbeitung erzielt 2.1 Thinking 1049 ±15 und ohne Thinking 1042 ±16; die Bereiche überlappen stark. Beide liegen über Nano Banana 2 Thinking mit 965 ±12 und Pro mit 927 ±12. Das spricht für Tests beider 2.1-Modi, nicht für einen nachgewiesenen Reasoning-Vorteil aus sieben zentralen Punkten.
Produktkonsistenz ist weniger eindeutig: Thinking erreicht 1024 ±18, ohne 981 ±18, Nano Banana 2 Thinking 955 ±22 und Pro 965 ±14. Der Bereich ohne Thinking überschneidet sich mit beiden älteren Modellen. Thinking ist die stärkste Konfiguration dieses Vergleichs; eine klare Verbesserung jeder 2.1-Variante bei Produkttreue lässt sich nicht behaupten.
Bei mehreren Referenzen stehen 1066 ±22 mit Thinking und 1041 ±20 ohne den Werten 988 ±13 für Nano Banana 2 Thinking und 989 ±12 für Pro gegenüber. 2.1 ist stärker, doch seine beiden Bereiche überlappen. Die 25 zentralen Punkte ergeben keine bedingungslose Empfehlung.
Google räumt teilweise befolgte Maskenanweisungen, verbleibende Striche und unerwartet erhaltene Ausgangsposen ein. Eine bevorzugte Bearbeitung kann deshalb die Erhaltungsanforderung verfehlen. Im Handel reichen geänderte Anschlüsse, Logos, Stückzahlen, Materialien oder Verpackungstexte, um ein schönes Bild unbrauchbar zu machen. Kreative Compositings tolerieren Geometrieänderungen, die Produktdokumentation nicht akzeptiert. Das sind getrennte Abnahmeregeln, keine Details für einen gemittelten Bearbeitungswert.
0,521 Faktizität bedeutet nicht 52,1 Prozent richtig
Infografikfaktizität wird anders gemessen: durch eine einseitige automatische Bewertung statt menschlicher Präferenzvergleiche. Google nennt 0,521 für 2.1 Thinking, 0,328 ohne Thinking, 0,265 für Pro und 0,179 für Nano Banana 2 Thinking.
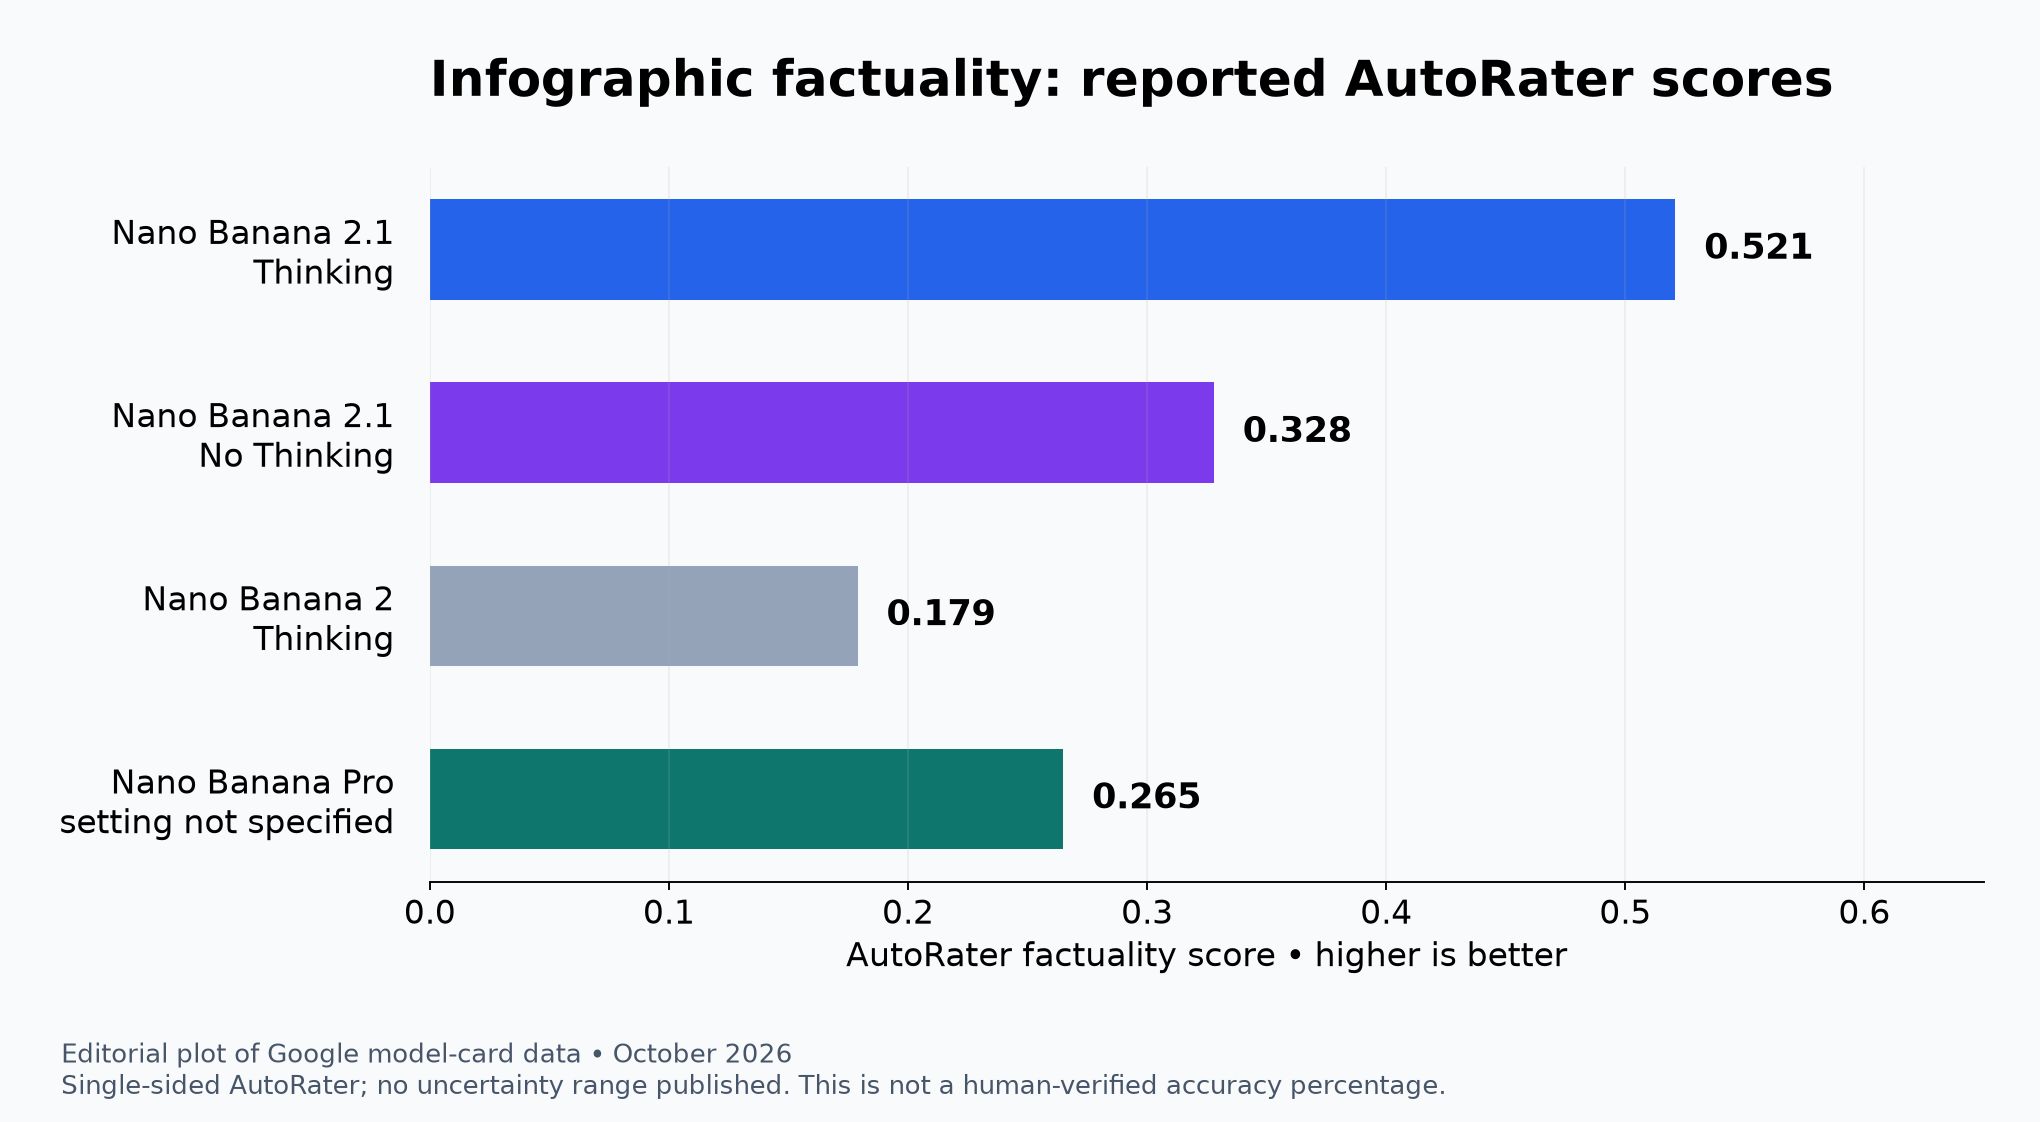
Redaktionelle Grafik der automatischen Google-Bewertung. Unsicherheitsbereiche fehlen. Sie ist weder Google-Originalgrafik noch Anteil faktisch korrekter Infografiken.
Thinking führt bei diesem Maß. Die Karte liefert aber nicht genug Methodik, Stichprobeninformation und Unsicherheit, um eine betriebliche Faktenfehlerquote zu berechnen. Ein Diagramm kann richtigen Text mit falsch geplotteten Werten verbinden, eine Zeitleiste Ereignisse umkehren, eine Karte Regionen vertauschen oder Beschriftungen falsch zuordnen. Die öffentliche Tabelle zeigt nicht, welche Fehler der automatische Bewerter zuverlässig erkennt.
Such-Grounding kann Informationen liefern, ohne ihre getreue visuelle Umsetzung zu garantieren. Die zugrunde liegende Karte nennt März 2026 als Wissensgrenze; einige Bereiche reichen möglicherweise nur bis Januar 2025, andere enthalten neuere Daten. Auch aktuell wirkende Grafiken benötigen bereitgestellte oder abgerufene Fakten und einen Vergleich mit dem fertigen Bild.
Kontrollierbar ist ein Faktenblatt: Werte, Einheiten, Daten, Beschriftungen und Quellen vorab freigeben, anschließend im Bild prüfen. Nachvollziehbare Fakten und Quellenbriefings helfen, Belege und Darstellung auseinanderzuhalten. Sie machen generierte Bilder nicht selbstprüfend. Medizinische, finanzielle, juristische, wissenschaftliche und aktuelle Grafiken dürfen den AutoRater-Wert nicht als Publikationsfreigabe verwenden.
Günstigere Bildausgabe garantiert kein günstigeres akzeptiertes Motiv
Die Standardpreise der kostenpflichtigen API nennen 30 Dollar je Million Bildausgabetoken für 2.1 und 60 Dollar für Nano Banana 2. Unterschiedliche 4K-Zuteilungen verändern die scheinbare Halbierung.
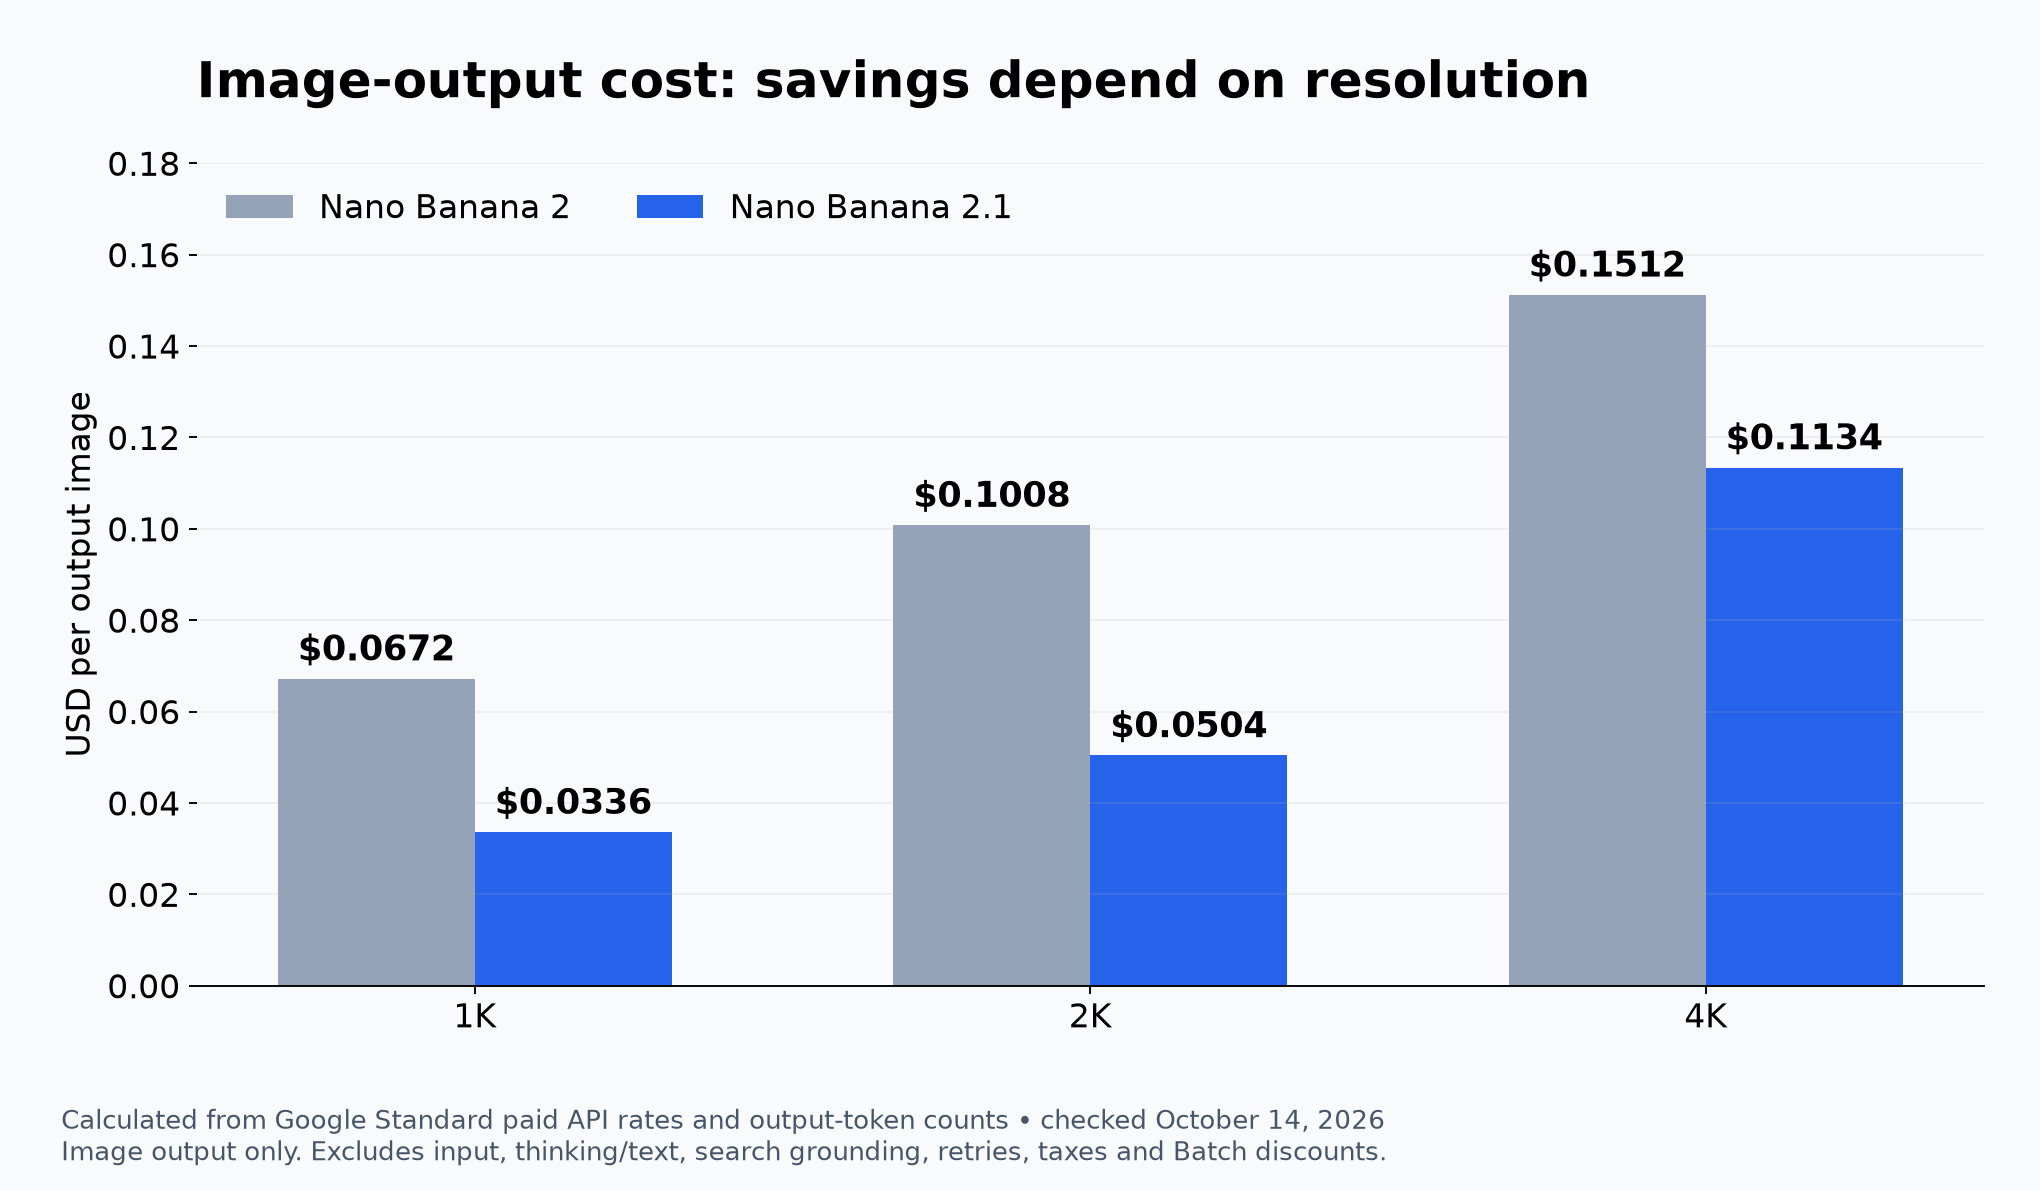
Redaktionelle Berechnung anhand der am 14. Oktober veröffentlichten Google-Preise und Zuteilungen. Das sind reine Ausgabekosten, keine gemessenen Gesamtanfragen und keine Originalgrafik von Google.
Bei 1K verwenden beide 1120 Bildtoken: 0,0336 Dollar für 2.1 gegenüber 0,0672 Dollar für Nano Banana 2. Bei 2K kosten 1680 Token 0,0504 beziehungsweise 0,1008 Dollar. Das sind jeweils 50 Prozent weniger für die Ausgabe.
Bei 4K nennt 2.1 jedoch 3780 Token und Nano Banana 2 nur 2520. Mit den jeweiligen Preisen ergeben sich 0,1134 gegenüber 0,1512 Dollar: 25 statt 50 Prozent Ersparnis. Steigende Tokenmengen verhindern, dass halbierter Tokenpreis automatisch halbierten Bildpreis bedeutet.
Andere Komponenten werden teurer. Standard-Text-, Bild- oder Videoeingabe kostet bei 2.1 1,50 Dollar je Million Token, Text- oder Bildeingabe bei Nano Banana 2 0,50 Dollar. Text- und Thinking-Ausgabe kostet 7,50 statt 3 Dollar. Grounding, Referenzen, Textausgabe, Reasoning, Wiederholungen, Steuern und mögliche Batch-Rabatte beeinflussen die Gesamtrechnung.
Ohne Mengenannahmen lässt sich kein verantwortbarer Gesamtpreis einer „typischen Anfrage“ berechnen. Höhere Erstabnahme kann Reasoning-Kosten ausgleichen, zusätzliche Versuche können die Ausgabeersparnis aufzehren. Die Entscheidungsgröße ist der Preis pro akzeptiertem Motiv zusammen mit gemessener Latenz und Timeout-Quote, nicht ein isolierter Tokenpreis.
Eine Migration braucht gepaarte Nachweise
Ein sinnvoller Test würde identische reale Prompts und Referenzdateien über das bisherige Modell und die verfügbaren 2.1-Thinking-Stufen vergleichen, bei gleichem Seitenverhältnis, gleicher Auflösung und gleichem Wiederholungsbudget. Das ist ein vorgeschlagenes Verfahren, kein von AI Tools Radar durchgeführter Test. Pro gehört nur hinein, wenn es tatsächlich bereitstellbar ist; nicht genannte Benchmark-Einstellungen sind nicht automatisch vergleichbar.
Einzel- und Mehrfigurenbilder, Produktbearbeitung, Masken, Referenzkomposition, textreiche Layouts und Faktengrafiken müssen getrennt bleiben. Exakten Text kann man transkribieren und vergleichen; Masken erfordern Prüfungen innerhalb und außerhalb des erlaubten Bereichs, Produkte die Kontrolle geschützter Merkmale. Verblindete Präferenzurteile ergänzen diese Tests, ersetzen aber keine Exaktheit bei unveränderlichen Logos oder Zahlen.
Gepaarte Ergebnisse und Unsicherheit bleiben erhalten, statt unterschiedliche Risiken zu einem Mittelwert zu verdichten. Betriebsdaten sollten Ende-zu-Ende-Latenz, Timeouts, Wiederholungen, Tokenverbrauch und Kosten pro akzeptiertem Bild erfassen. Eine Schattenphase zeigt erst, ob der Benchmark-Vorsprung tatsächlich weniger Korrekturen bedeutet.
Für einen übereilten Wechsel wegen einer angeblichen Abschaltung am 29. Oktober gibt es keinen Quellenbeleg. Die Abkündigungsreferenz führt Gemini 3.1 Flash Image als veraltet, nennt aber kein Abschaltdatum. Das ist ebenso wenig ein Versprechen unbegrenzter Verfügbarkeit.
Die stärksten ersten Einsatzfälle sind Infografiklayout, mehrere wiederkehrende Figuren, Referenzkomposition und günstigere Bildausgabe. Thinking verdient bei Mehrfiguren- und Faktizitätsaufgaben besondere Aufmerksamkeit; überlappende Ergebnisse lassen anderswo einfachere Konfigurationen zu. Sind Kleinschrift, Fakten, exakte Identität oder unveränderte Produktbereiche zwingend, bleiben externe Prüfungen und Rückfalloptionen nötig, bis der neue Endpunkt die Anforderungen erfüllt. Der veröffentlichte Vorsprung begründet den Vergleich, ersetzt ihn aber nicht.