
Nano Banana 2.1이 이미지 제작팀에 제시하는 이점은 두 가지다. Google의 비교에서 더 좋은 결과를 얻었다는 것과 생성 이미지 토큰 요금이 낮아졌다는 것이다. 하지만 어느 쪽도 그것만으로 게시 가능한 결과물의 비용이 낮아진다고 입증하지 못한다. 핵심은 측정된 개선이 인물 정체성, 사실의 정확성, 보존해야 할 제품 세부 사항, 재시도를 포함한 총비용이라는 실제 작업의 조건에서도 유지되느냐다.
이 글은 10월 6일 일반 제공된 모델을 10월 14일 기준으로 분석하며, 당일의 새 출시를 소개하는 것이 아니다. 가장 강한 신호는 인포그래픽 선호도, 여러 인물의 일관성, 일부 편집 작업에서 나타난다. 반대로 선호도 점수를 정확도로 바꾸어 읽거나, 모든 작업이 Thinking에서 같은 이득을 얻는다고 가정하거나, 모든 요청을 반값이라고 부르면 잘못된 해석이 된다.
실제 엔드포인트 한도는 모델 카드보다 좁다
API 변경 기록에 실린 안정 모델 코드는 gemini-nano-banana-2.1이다. Google은 이를 새 Pro 모델이 아니라 Nano Banana 2로도 불리는 Gemini 3.1 Flash Image의 Flash급 업데이트로 설명한다. 모델 카드에 따르면 기반은 Gemini 3.6 Flash이며 텍스트와 이미지를 받아 이미지와 텍스트를 반환한다.
구현 조건도 모델 계보만큼 중요하다. 엔드포인트 문서는 기본 출력을 1K, 최대 지원을 4K로 정한다. Thinking은 minimal, medium, high이며 기본값은 medium이다. 검색 그라운딩은 지원하지만 함수 호출, 코드 실행, 구조화된 출력은 지원하지 않는다. 이런 기능이 필요한 애플리케이션은 이미지 모델 밖에서 오케스트레이션과 검증을 수행해야 한다.
용량에도 해명되지 않은 차이가 있다. 모델 카드는 최대 100만 컨텍스트 토큰과 64K 텍스트 출력을 설명하지만 Gemini API 페이지에는 입력 131,072, 출력 32,768토큰이 적혀 있다. 원자료는 둘의 관계를 설명하지 않는다. 배포 설계는 더 큰 아키텍처 수치가 당연히 제공된다고 가정하지 말고, 실제 호출할 엔드포인트의 공개 한도를 따라야 한다.
다중 이미지 융합은 최대 14개 참조 이미지를 받으며 최대 네 인물과 열 개 물체를 포함한다. 이는 입력 상한이지, 14개 참조 요소나 네 개의 독립적인 인물 정체성을 정확히 유지한다는 보장이 아니다.
카드는 작거나 긴 글자의 흐림·깨짐, 정체성 변형, 좌우 혼동, 불완전한 3D 추론과 사실 지식, 간헐적 지연과 타임아웃도 명시한다. 마스크 잔류물과 유지되는 자세는 별도의 편집 위험이다. 이런 알려진 한계에는 실패 기준과 대체 수단이 필요하며, 참조나 컨텍스트 허용량이 늘어도 사라지지 않는다.
생성 우위는 선호도 증거이지 정확성 증거가 아니다
Google의 생성 결과는 사람의 선호를 Elo로 비교한다. 정확한 이미지의 비율을 세는 평가가 아니다. 공개된 ± 범위는 참고할 수 있지만 신뢰수준은 설명되지 않는다. 표본 수, 프롬프트, 해상도, 재시도 예산, 구체적인 Thinking 설정, 동일 연산량 조건도 공개되지 않았다.
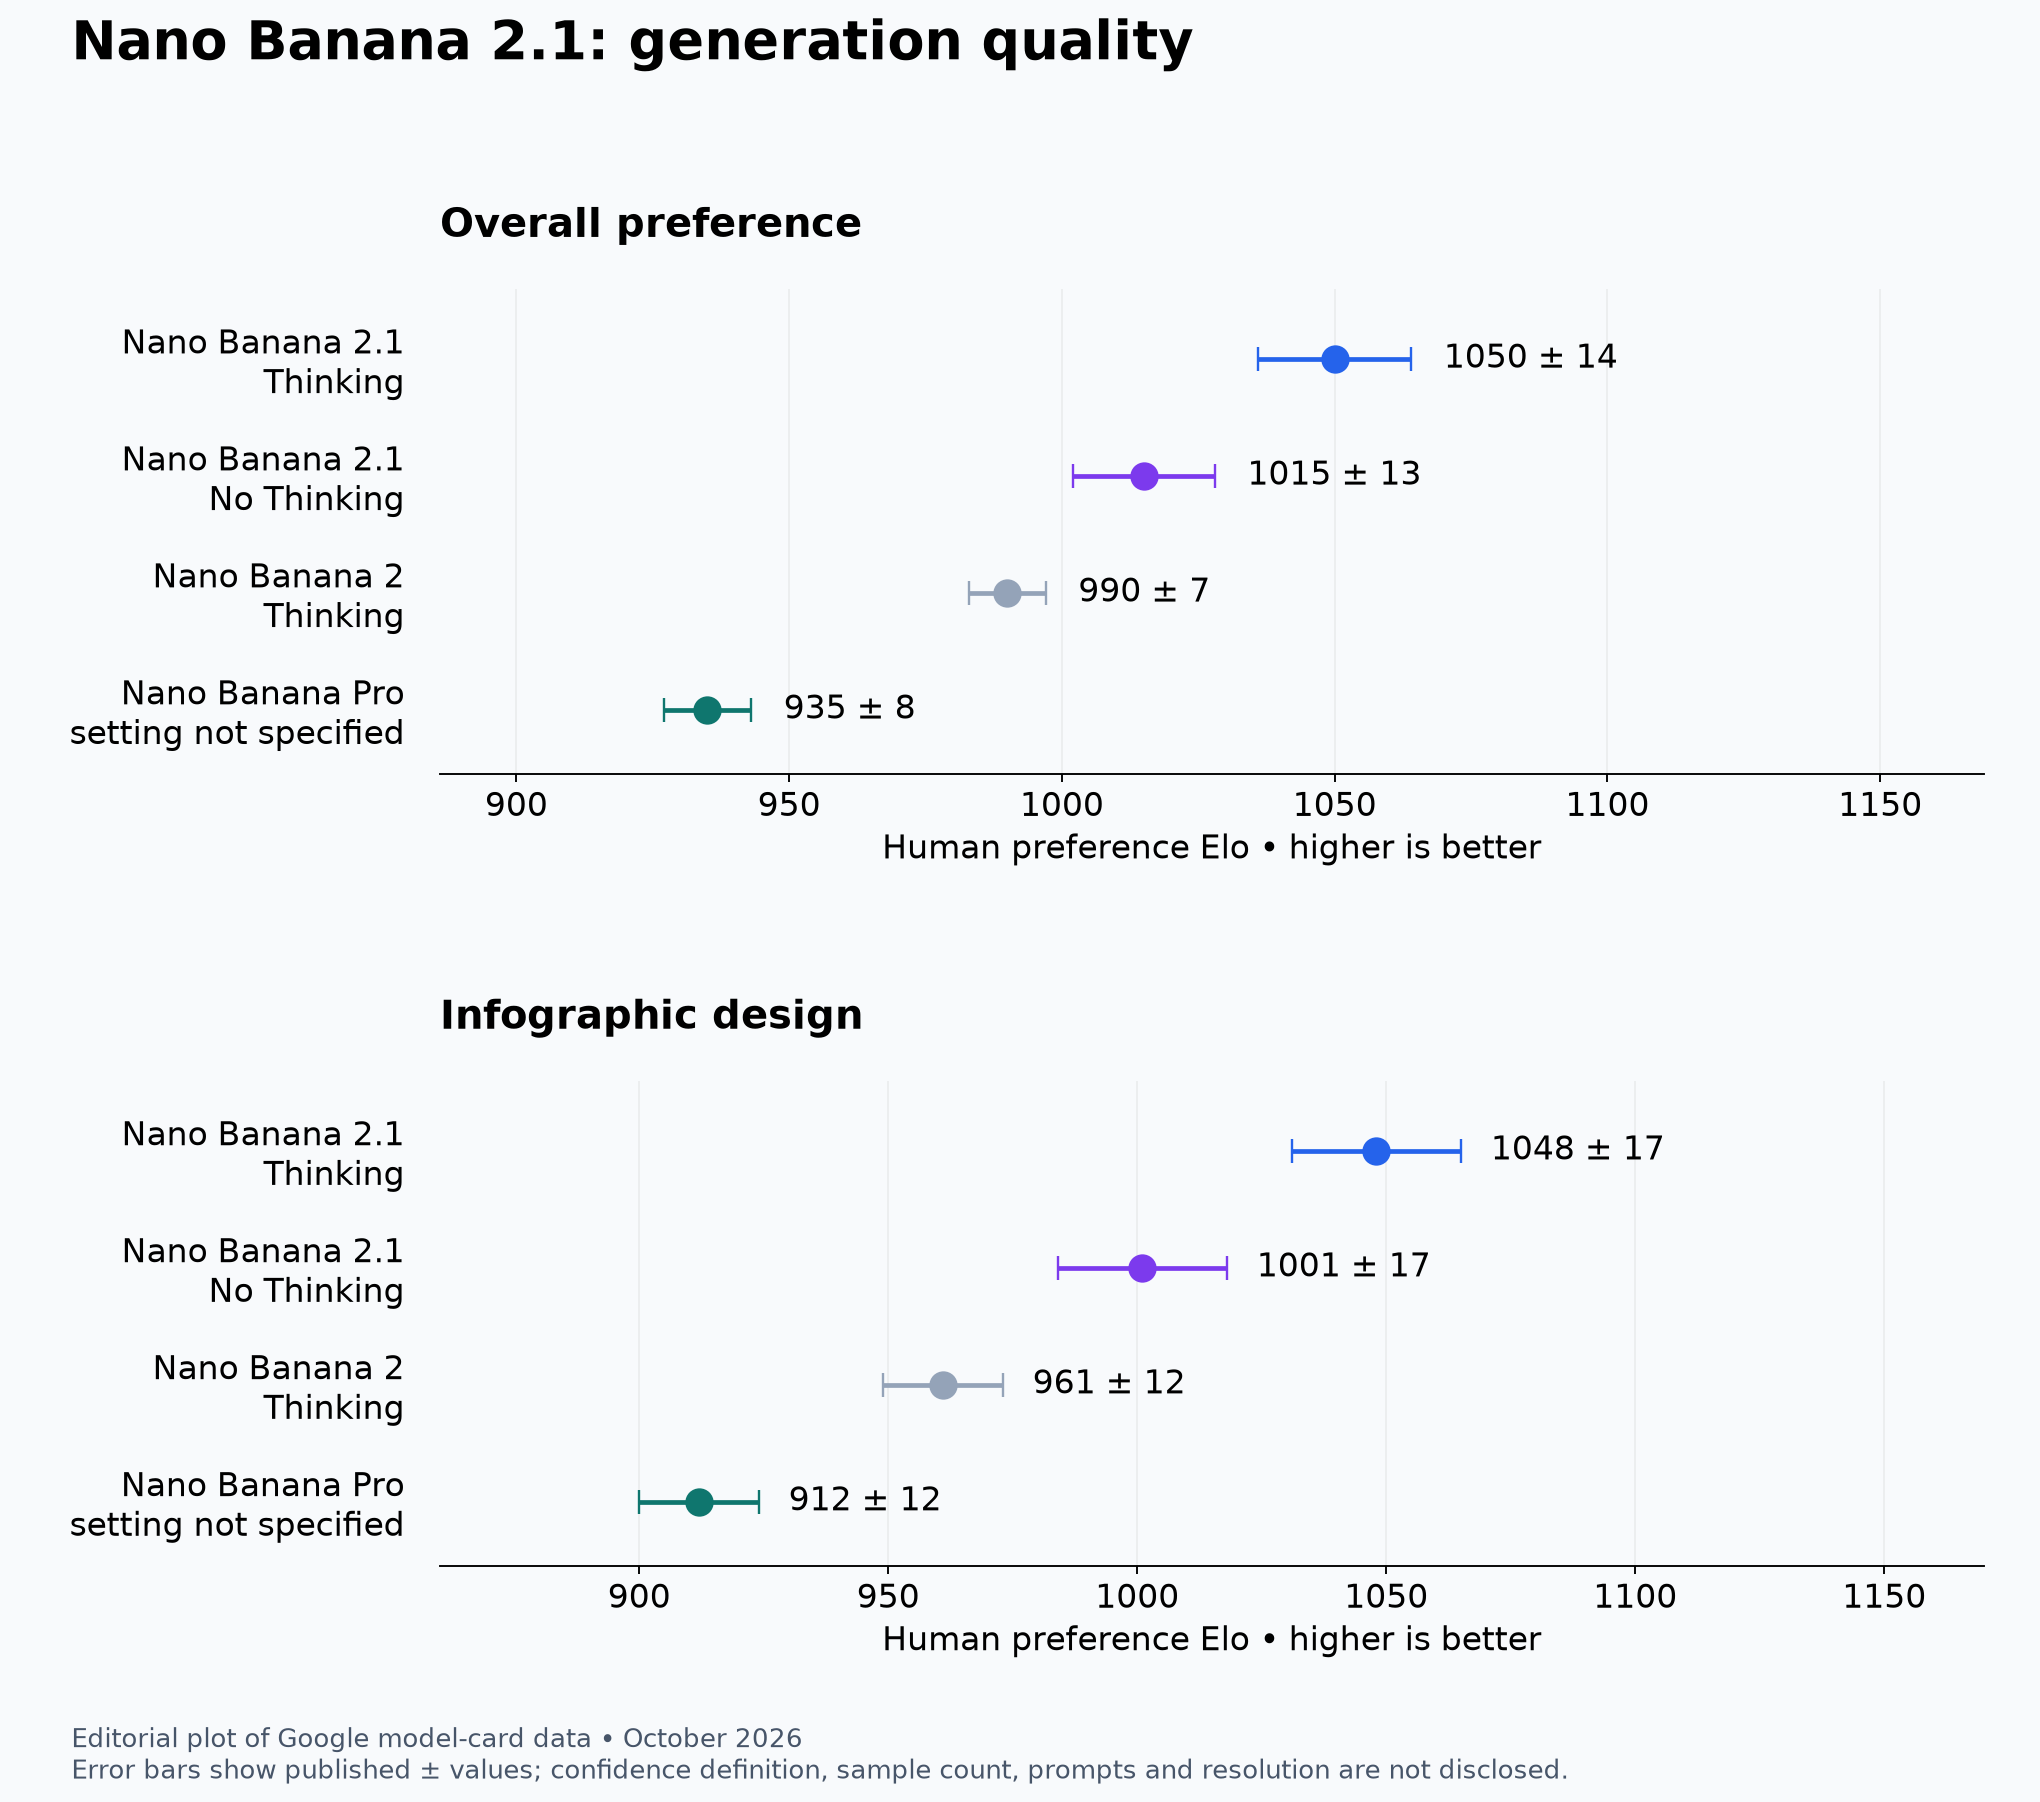
Google의 2026년 10월 모델 카드 수치로 만든 편집 그래프이며 Google 원본 이미지가 아니다. 오차 막대는 공개 범위를 재현하지만 신뢰수준이나 실무 정확도는 확정되어 있지 않다.
전체 생성에서 2.1 Thinking은 1050 ±14, Thinking 없이는 1015 ±13, Nano Banana 2 Thinking은 990 ±7, Pro는 935 ±8이다. 인포그래픽 디자인은 같은 순서로 1048 ±17, 1001 ±17, 961 ±12, 912 ±12다. 표시 범위를 고려해도 2.1 두 모드의 인포그래픽 결과는 Nano Banana 2보다 높다.
Thinking의 전체 생성 구간 1036–1064는 Thinking 없는 경우의 1002–1028과 겹치지 않는다. 인포그래픽 구간은 1031에서 맞닿는다. 앞쪽의 구분이 더 뚜렷하지만, 어느 쪽도 모든 프롬프트의 효과 크기를 입증하지 않는다. 표의 일반적인 'Thinking'을 API의 high 설정과 동일시할 수도 없다. 평가 구성이 공개되지 않았기 때문이다.
따라서 운영상의 지름길은 없다. 선호도 우위가 재시도 감소, 짧은 지연, 정확한 차트 라벨을 뜻하지 않는다. Google은 여기서 벤치마크 지연 시간을 보고하지 않았다. 구성과 레이아웃을 중시하는 제작팀에는 2.1을 시험할 이유가 있지만, 보편적인 속도 향상이나 투자 수익을 만들어 말할 근거는 없다.
인물이 여러 명이면 Thinking의 판단도 달라진다
반복 등장하는 한 인물과 여러 정체성을 유지해야 하는 장면은 다른 작업이다. 일관성 결과는 그 차이를 보여 준다.
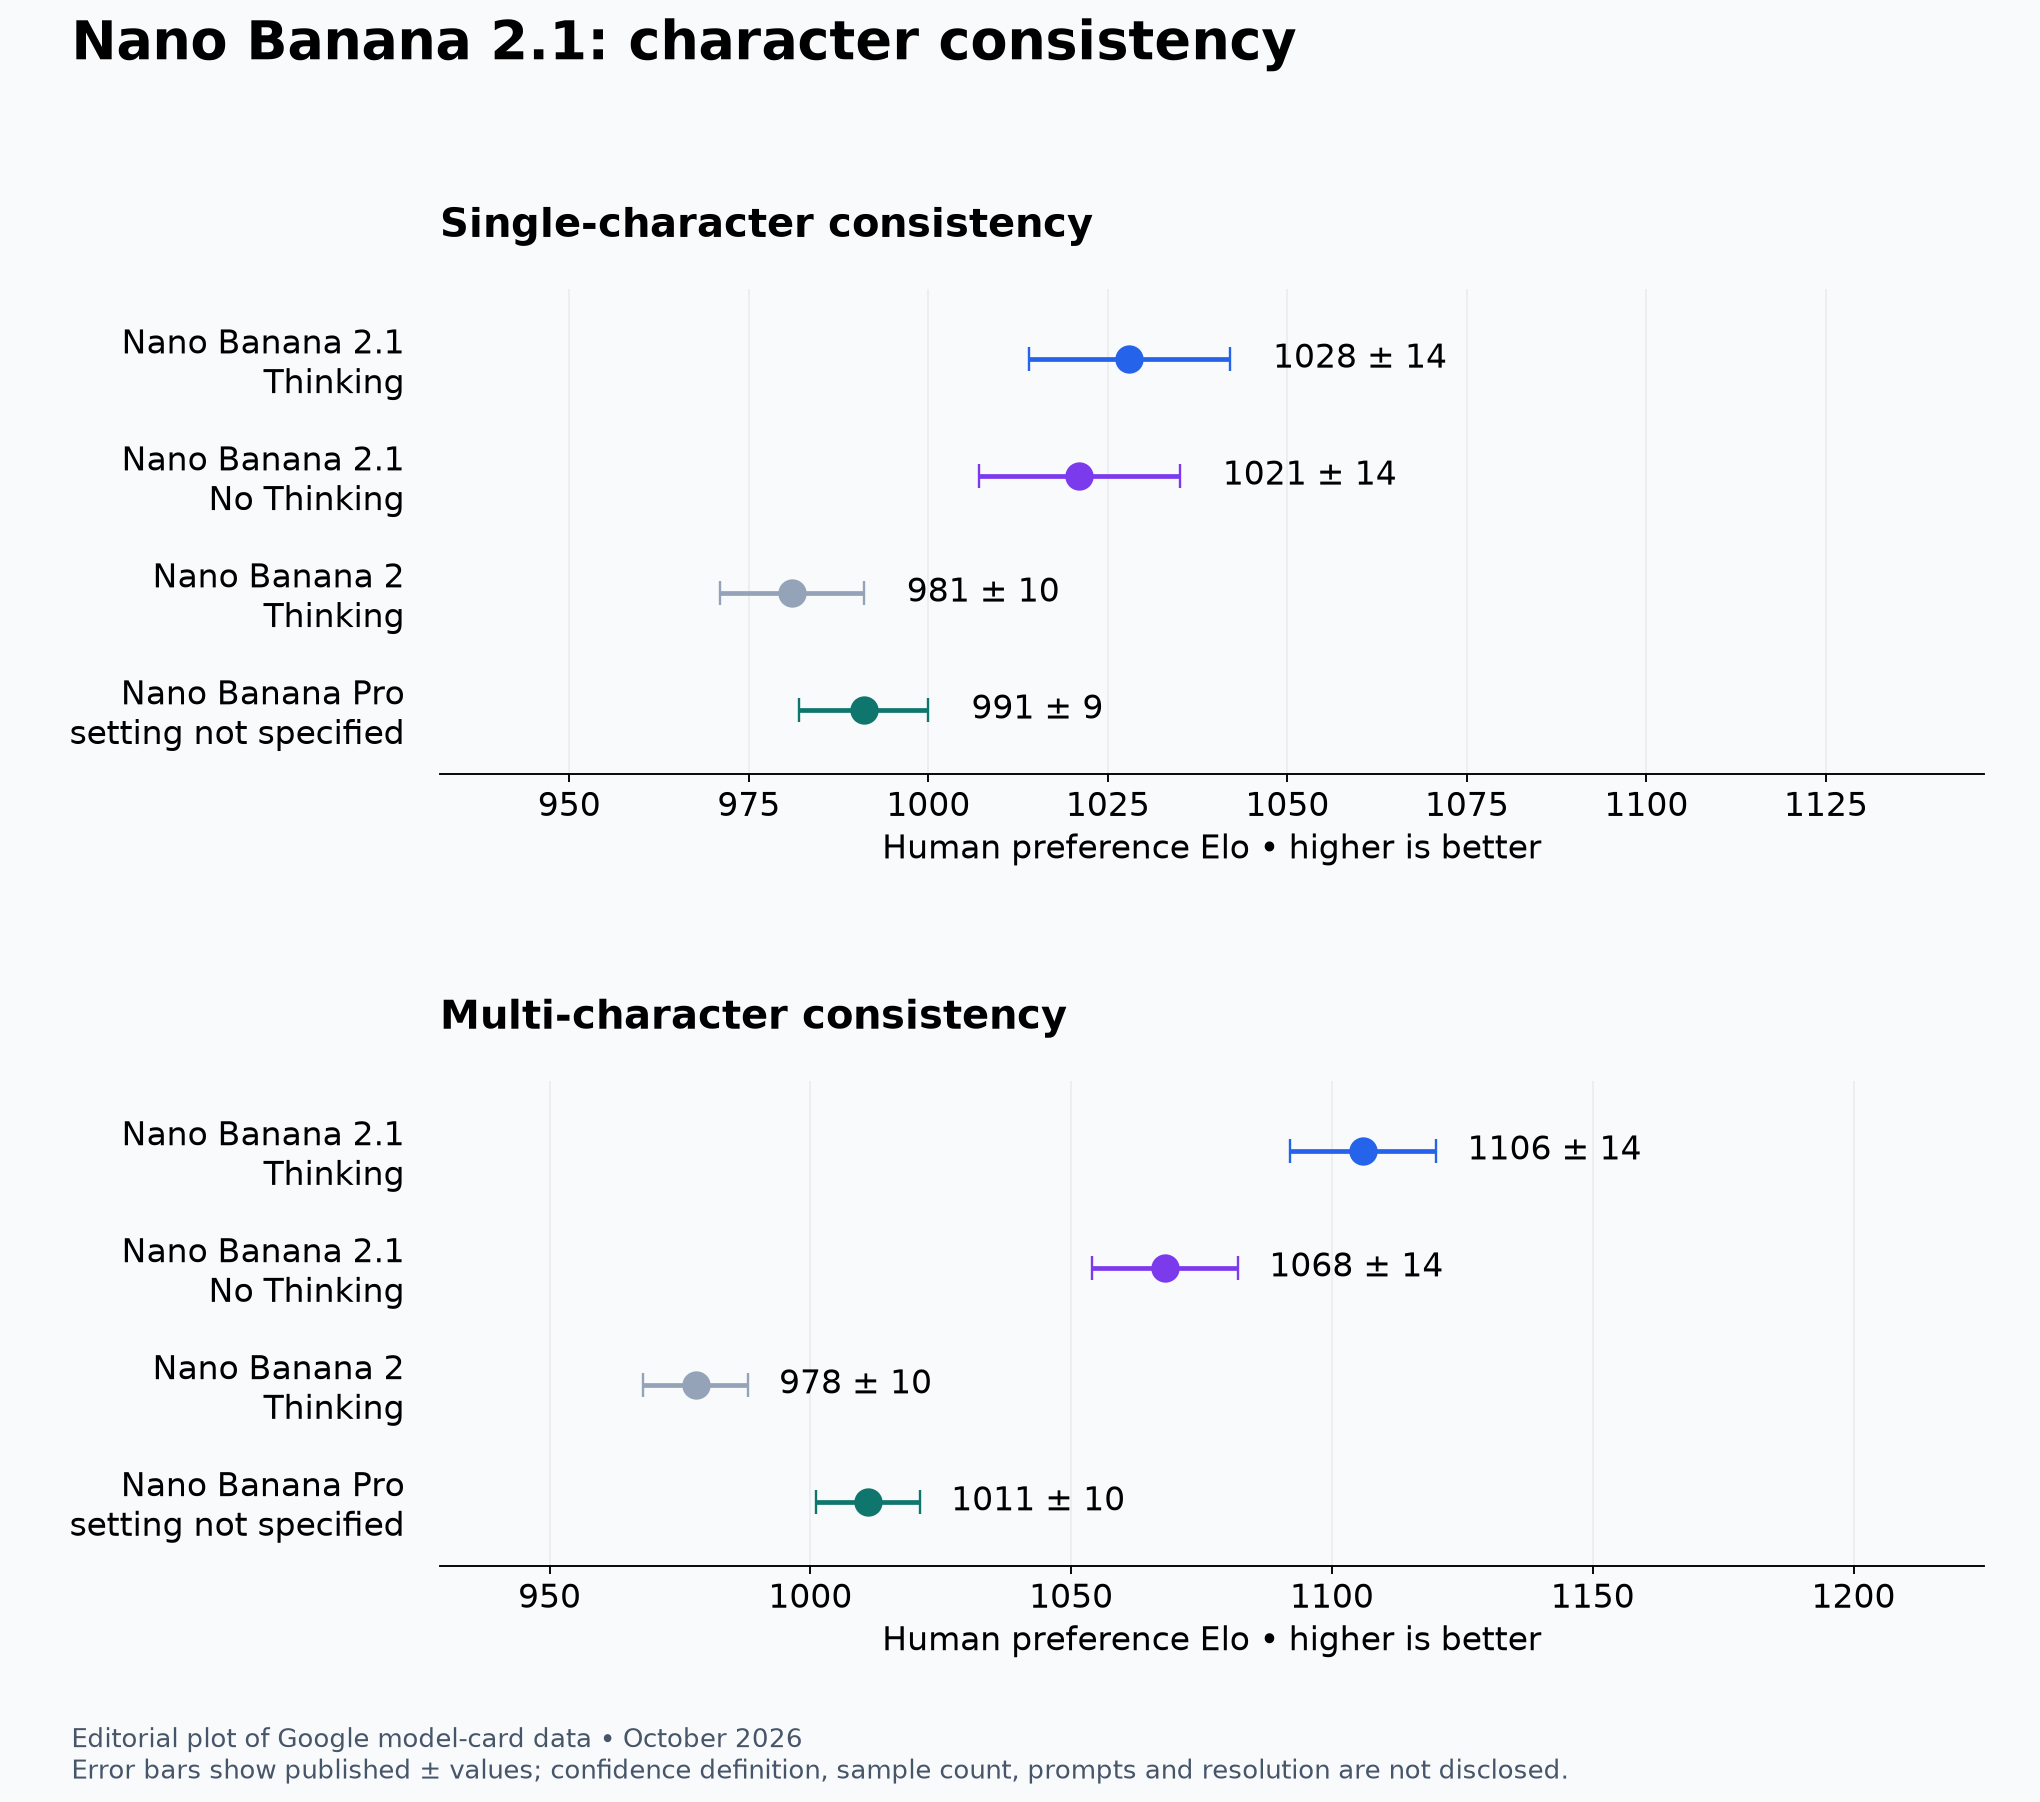
동일한 Google 모델 카드 데이터로 만든 편집 그래프다. 공개 범위의 신뢰수준은 밝혀지지 않았으며 Google이 직접 제작한 삽화가 아니다.
단일 인물 점수는 2.1 Thinking 1028 ±14, Thinking 없음 1021 ±14, Nano Banana 2 Thinking 981 ±10, Pro 991 ±9다. 2.1의 두 구간이 상당히 겹치므로 중앙값 7점 차이만으로 모든 단일 인물 요청에 추론이 필요하다고 할 수 없다.
여러 인물에서는 차이가 더 크다. Thinking은 1106 ±14, 없음은 1068 ±14, Pro는 1011 ±10, Nano Banana 2 Thinking은 978 ±10이다. 2.1 구간은 겹치지 않는다. 여러 정체성과 관계를 함께 유지해야 할 때 Thinking이 더 유망한 후보라는 뜻이지, 어떤 참조 조합에서도 네 인물을 확실히 보존한다는 증명은 아니다.
보기 좋은 단체 이미지도 한 사람의 옷을 다른 사람에게 옮기거나 인물을 빠뜨릴 수 있다. 벤치마크는 얼굴 변형, 비율 변경, 의상 전이, 인물 중복, 상대적 키 오류를 세부적으로 보고하지 않는다. 잘리거나 서로 모순되거나 조명이 다르거나 외모가 비슷한 참조일수록 사람별 검사가 필요하다. 미적 선호 한 표가 결과물을 쓸 수 없게 만드는 정체성 결함을 숨길 수 있다.
편집 성능은 무엇을 바꾸면 안 되는지에 달렸다
편집 결과 역시 'Thinking이 이긴다'는 한 문장으로 묶기 어렵다. 마스크, 제품 충실도, 여러 참조의 결합은 서로 다른 요소를 보호한다.
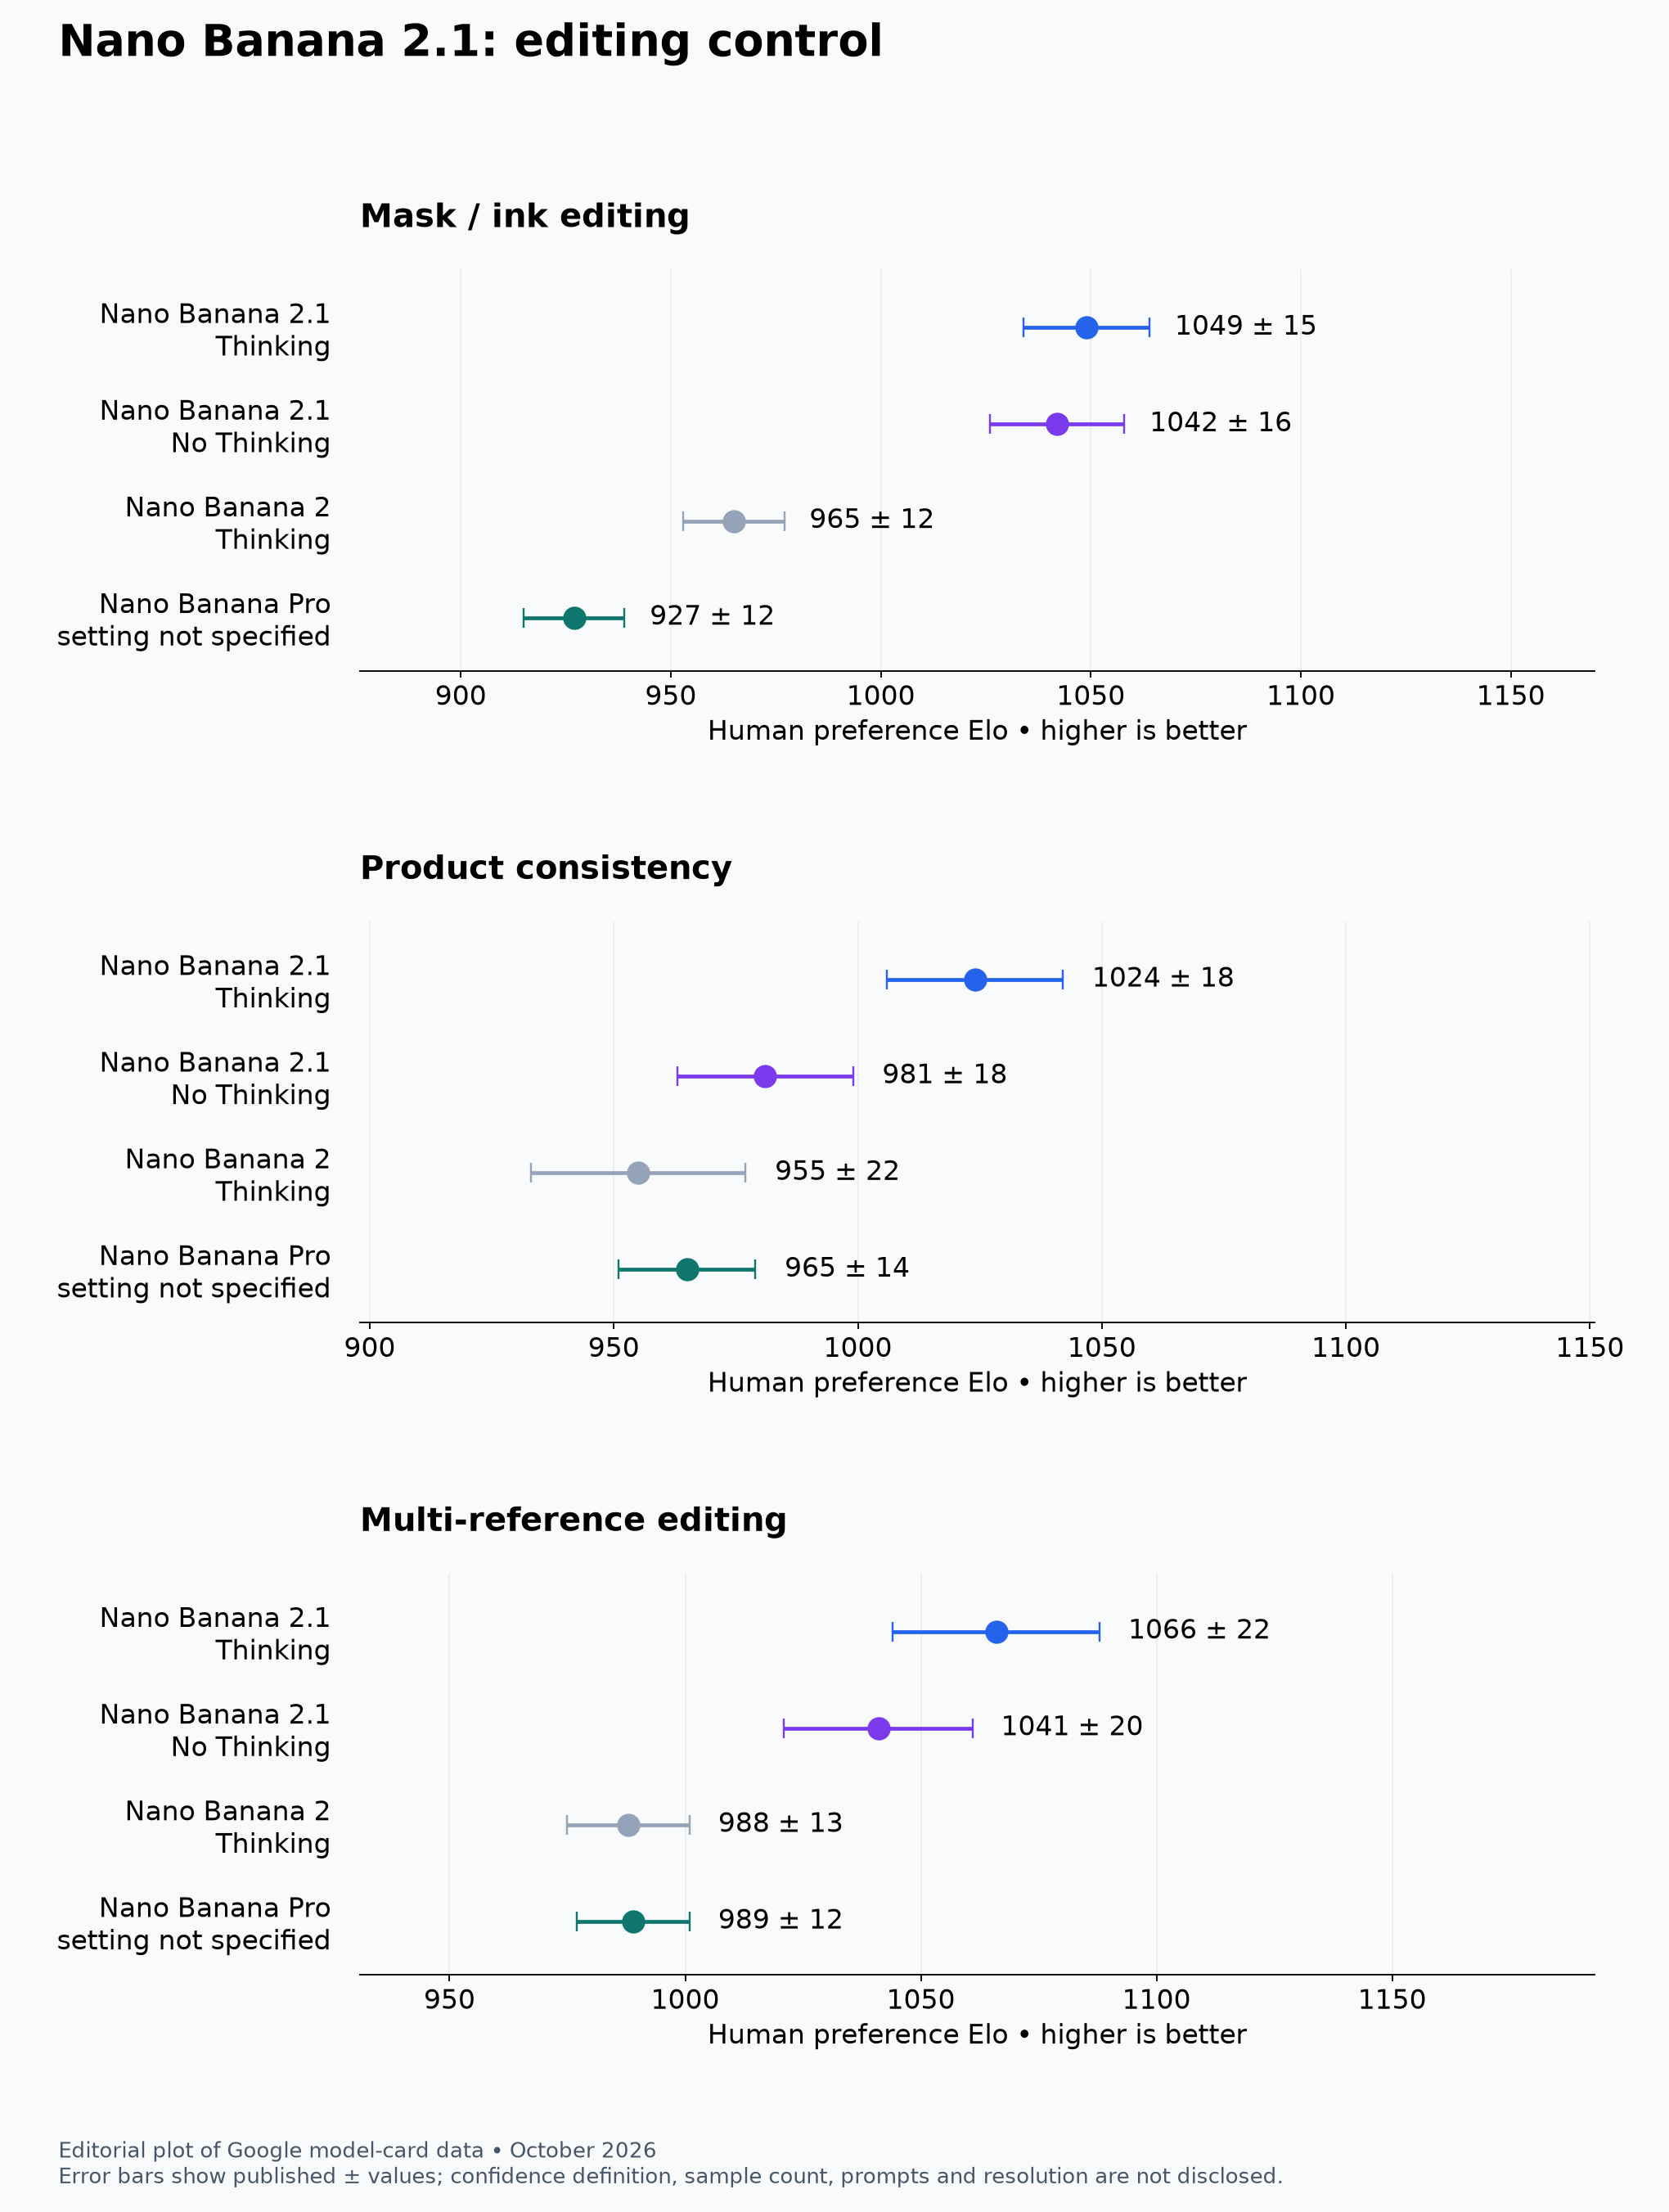
Google 모델 카드를 바탕으로 만든 편집 그래프이며 Google 원화가 아니다. 선호도 Elo와 ± 범위는 엄밀한 지시 준수나 마스크 밖 픽셀의 불변성을 측정하지 않는다.
마스크 또는 잉크 기반 편집에서 2.1 Thinking은 1049 ±15, 없음은 1042 ±16으로 구간이 크게 겹친다. 두 모드 모두 Nano Banana 2 Thinking 965 ±12, Pro 927 ±12보다 높다. 이는 두 2.1 모드를 시험할 근거이지만 중앙값 7점 차이를 확정된 추론 효과로 볼 근거는 아니다.
제품 일관성에서는 다르다. Thinking은 1024 ±18, 없음은 981 ±18, Nano Banana 2 Thinking은 955 ±22, Pro는 965 ±14다. Thinking 없는 구간은 두 구형 모델과 겹친다. 이번 비교에서 Thinking이 가장 강한 구성이라는 증거는 있지만 모든 2.1 구성이 제품 충실도를 분명히 개선한다는 뜻은 아니다.
다중 참조 편집에서 2.1 Thinking은 1066 ±22, 없음은 1041 ±20이며 Nano Banana 2 Thinking과 Pro는 각각 988 ±13, 989 ±12다. 2.1 결과는 더 강하지만 자체 두 구간은 겹치므로 중앙값 25점 차이를 무조건적인 권고로 바꿔서는 안 된다.
Google은 마스크 지시의 부분적 준수, 잉크 잔류, 원래 자세의 예상치 못한 유지를 인정한다. 더 선호되는 편집도 보존 조건에는 실패할 수 있다. 전자상거래 이미지에서는 포트, 로고, 수량, 재질, 포장 문자가 바뀌면 보기 좋아도 탈락한다. 창작 합성에서 허용되는 기하 변화가 제품 문서에서도 허용되는 것은 아니다. 하나의 편집 점수로 평균낼 사안이 아니라 별도 합격 기준이다.
사실성 0.521은 정확도 52.1%가 아니다
인포그래픽 사실성은 사람의 선호도 비교와 달리 단측 자동 평가기로 측정된다. Google이 보고한 값은 2.1 Thinking 0.521, 없음 0.328, Pro 0.265, Nano Banana 2 Thinking 0.179다.
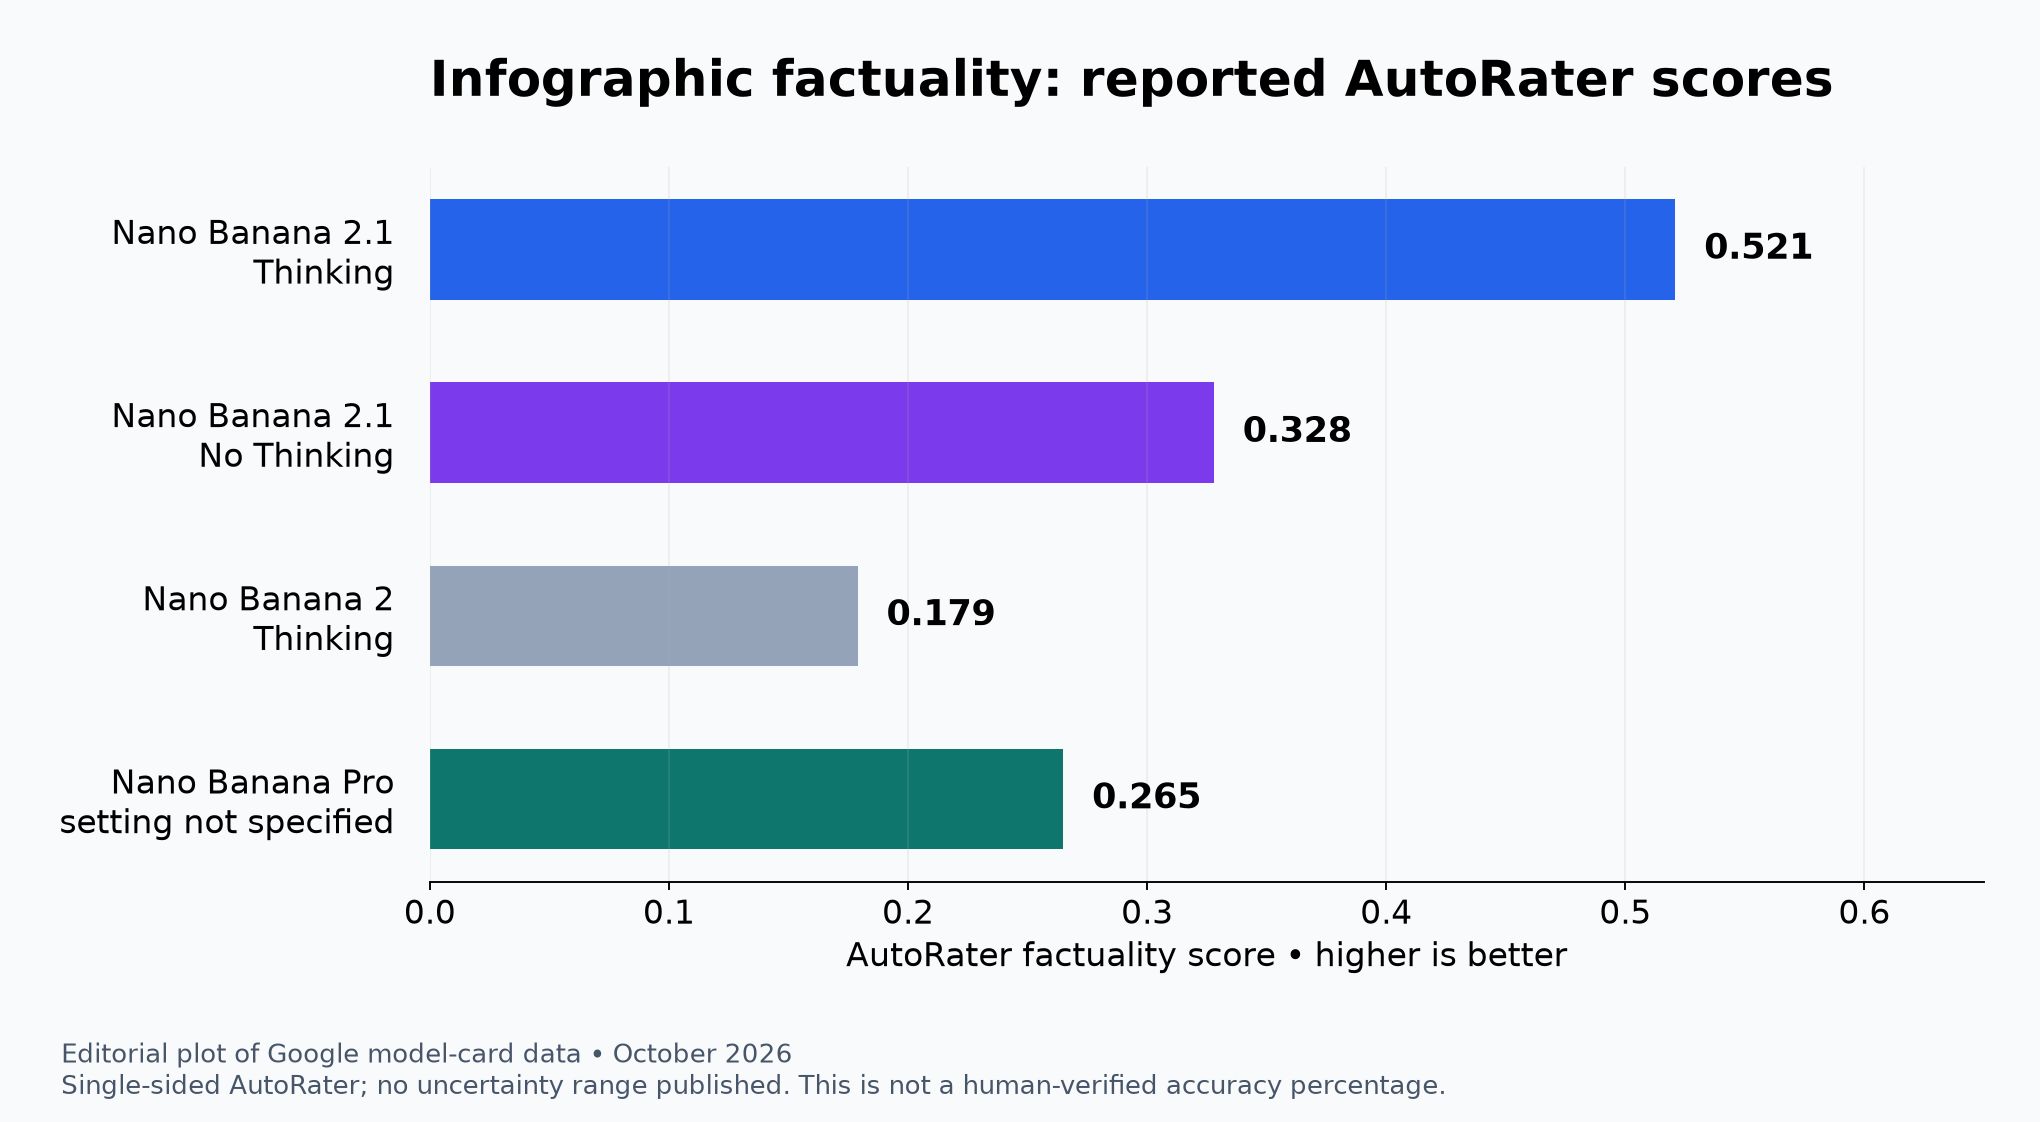
Google 자동 평가 데이터를 편집 그래프로 표시했다. 불확실성 범위는 공개되지 않았다. Google 원본 이미지도, 사실이 정확한 인포그래픽의 백분율도 아니다.
해당 지표에서는 Thinking이 앞서지만, 카드의 방법론·표본·불확실성 정보는 실무 사실 오류율을 계산하기에 부족하다. 설명문은 맞는데 값의 위치가 틀린 차트, 순서가 뒤집힌 연표, 지역이 바뀐 지도, 다른 대상을 가리키는 라벨이 있을 수 있다. 공개 표는 자동 평가기가 이런 오류 중 무엇을 안정적으로 잡는지 입증하지 않는다.
검색 그라운딩은 정보를 가져올 수 있어도 이미지에 충실히 옮긴다는 보장은 아니다. 기반 모델 카드에는 지식 기준 시점이 2026년 3월로 적혀 있고, 일부 분야는 2025년 1월에 머물며 다른 분야에는 더 최신 정보가 포함된다. 최신처럼 보이는 그래픽도 제공하거나 검색한 사실 근거와 최종 이미지를 대조해야 한다.
실제 통제 단위는 사실표다. 생성 전에 값, 단위, 날짜, 라벨, 인용을 승인하고 이미지에서 다시 확인한다. 추적 가능한 사실과 출처 브리프는 증거와 시각 표현을 분리하는 데 도움이 되지만 생성 이미지가 스스로 검증되게 하지는 않는다. 의료·금융·법률·과학·시사 그래픽에서 AutoRater 점수가 게시 허가가 될 수는 없다.
이미지 출력이 싸도 합격 결과물은 아닐 수 있다
표준 유료 API 요금은 이미지 출력 백만 토큰당 2.1을 30달러, Nano Banana 2를 60달러로 정한다. 다만 4K 토큰 배분이 달라 겉으로 보이는 절반의 의미가 변한다.
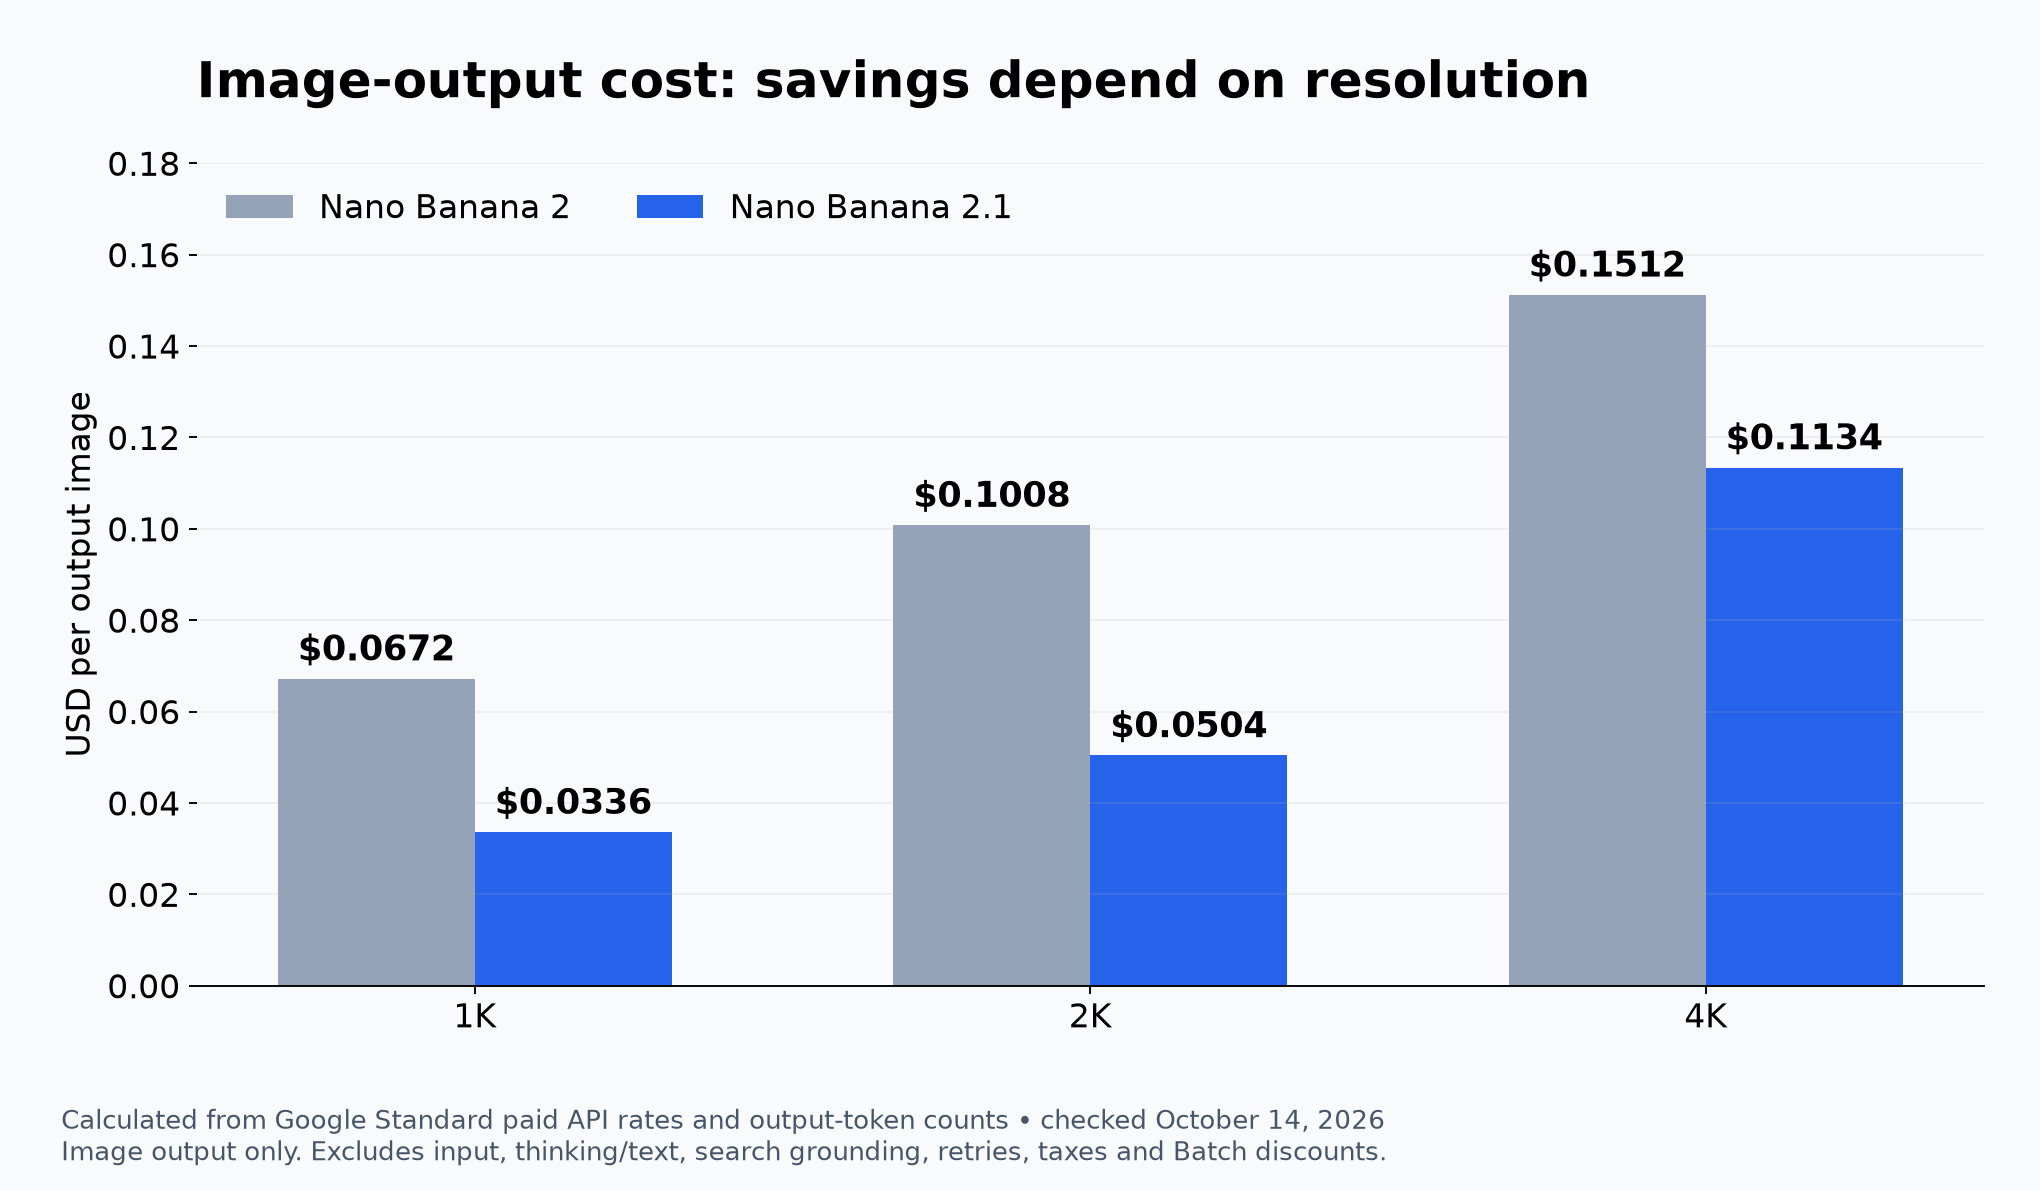
10월 14일까지 공개된 Google 요금과 토큰 할당으로 계산한 편집 그래프다. 출력 비용만이며 실측 전체 요청 요금도 Google 원본 그래프도 아니다.
1K는 두 모델 모두 1,120 이미지 토큰을 쓰며 2.1은 0.0336달러, Nano Banana 2는 0.0672달러다. 2K의 1,680토큰은 각각 0.0504달러와 0.1008달러다. 두 경우 출력 부분은 50% 줄어든다.
4K는 2.1이 3,780토큰, Nano Banana 2가 2,520토큰이다. 각 요율을 곱하면 0.1134달러와 0.1512달러로 절감은 50%가 아닌 25%다. 토큰 수가 늘면 토큰 단가 반감이 이미지 비용 반감으로 이어지지 않는다.
다른 비용은 올라간다. 2.1의 표준 텍스트·이미지·비디오 입력은 백만 토큰당 1.50달러이고 Nano Banana 2의 텍스트·이미지 입력은 0.50달러다. 텍스트와 Thinking 출력은 7.50달러 대 3달러다. 그라운딩, 참조 이미지, 텍스트 출력, 추론, 재시도, 세금, 가능한 Batch 할인 모두 총청구액에 영향을 준다.
사용량을 가정하지 않고는 '일반적 요청'의 총액을 책임 있게 계산할 수 없다. 첫 시도 합격률 개선이 추론 요금을 상쇄할 수도, 재시도 증가가 출력 절감을 지울 수도 있다. 판단 지표는 개별 출력 토큰 단가가 아니라 합격 결과물당 비용과 실측 지연·타임아웃률이다.
이전 결정에는 같은 과제의 짝지은 증거가 필요하다
유용한 시험은 현재 모델과 2.1의 각 Thinking 수준에 같은 실무 프롬프트·참조 파일을 주고 종횡비, 해상도, 재시도 예산을 고정한다. 이는 제안하는 평가이지 AI Tools Radar가 수행한 시험이 아니다. Pro는 실제 배포 가능한 대안일 때만 포함하며, 벤치마크에서 명시되지 않은 설정을 동등하다고 가정해서는 안 된다.
단일·다중 인물, 제품 편집, 마스크, 참조 합성, 글자가 많은 레이아웃, 사실 그래픽을 나눈다. 정확한 문자는 전사해 비교하고, 마스크는 허용 영역 안팎을 검사하며, 제품 작업은 보호할 특징을 확인한다. 블라인드 선호도는 보완할 수 있지만 로고나 숫자가 변하면 안 되는 경우의 정밀 검증을 대신하지 못한다.
서로 다른 위험을 평균 하나로 합치지 말고 짝지은 결과와 불확실성을 보존한다. 운영 기록에는 종단 간 지연, 타임아웃, 재시도, 토큰 소비, 합격 이미지당 비용을 담는다. 섀도 운영을 거쳐야 벤치마크 우위가 실제 작업의 수정 횟수 감소로 이어지는지 드러난다.
급하게 전환하게 만들 '10월 29일 종료' 기한에는 근거가 없다. 지원 중단 참고는 Gemini 3.1 Flash Image를 사용 중단 예정으로 나열하지만 종료일을 발표하지 않는다. 물론 무기한 제공을 약속하는 증거도 아니다.
2.1을 우선 시험할 이유가 강한 분야는 인포그래픽 레이아웃, 반복되는 여러 인물, 참조 합성, 낮은 이미지 출력 요금이다. Thinking은 다중 인물과 사실성 작업에서 우선 검토할 만하고, 결과가 겹치는 작업에는 간단한 구성의 여지도 있다. 작은 글자, 사실, 정확한 정체성, 변경 없는 제품 영역이 필수라면 새 엔드포인트가 조건을 충족할 때까지 외부 검증과 대체 수단을 유지해야 한다. 공개된 우위는 비교를 시작할 이유이지 비교 자체의 대체물이 아니다.