
O Nano Banana 2.1 apresenta duas vantagens diferentes para equipes de produção visual: resultados melhores nas comparações do Google e tarifas menores para tokens de imagem gerada. Nenhuma delas, isoladamente, demonstra que um material pronto para publicar fica mais barato. A questão é se os ganhos medidos resistem às exigências reais de identidade, correção factual, detalhes protegidos do produto e custo total das novas tentativas.
Esta análise de 14 de outubro acompanha a disponibilidade geral de 6 de outubro, não um novo lançamento no mesmo dia. Seus sinais mais fortes estão na preferência por infográficos, na consistência de vários personagens e em certas edições. A leitura mais fraca seria transformar preferência em porcentagem de acerto, supor que Thinking beneficia igualmente todas as tarefas ou chamar toda solicitação de metade do preço.
O endpoint implantado tem limites mais estreitos que a ficha
O histórico da API identifica gemini-nano-banana-2.1 como modelo estável. O Google o descreve como atualização de classe Flash do Gemini 3.1 Flash Image, também chamado Nano Banana 2, não como novo Pro. A ficha do modelo o baseia no Gemini 3.6 Flash: recebe texto e imagens e retorna imagens e texto.
Os detalhes de implementação importam tanto quanto essa linhagem. A documentação do endpoint prevê saída padrão 1K, até 4K. Thinking oferece minimal, medium e high, com medium como padrão. Há fundamentação por busca, mas não chamadas de função, execução de código nem saídas estruturadas. Aplicações precisam realizar essa orquestração e verificação fora do modelo de imagem.
Existe ainda uma divergência de capacidade sem explicação. A ficha descreve até um milhão de tokens de contexto e 64K de saída textual; a página Gemini API indica 131.072 tokens de entrada e 32.768 de saída. As fontes não explicam a relação. O planejamento deve seguir o limite documentado do endpoint utilizado, sem presumir disponíveis as cifras arquiteturais maiores.
A fusão aceita até 14 imagens de referência, incluindo no máximo quatro personagens e dez objetos. São tetos de entrada, não garantias de preservar fielmente catorze referências ou quatro identidades independentes.
A ficha também cita texto pequeno ou longo borrado ou defeituoso, deriva de identidade, confusão entre esquerda e direita, raciocínio 3D e conhecimento factual imperfeitos, além de lentidão e expirações ocasionais. Resíduos de máscara e poses persistentes acrescentam riscos de edição. Essas limitações reconhecidas exigem critérios de falha e alternativa; mais referências ou contexto não as eliminam.
A geração demonstra preferência, não correção
O Google compara preferências humanas com Elo. Não conta a proporção de imagens corretas. As faixas ± publicadas ajudam a interpretar, mas seu nível de confiança não é definido. Também não são divulgados tamanho da amostra, prompts, resolução, orçamento de tentativas, ajustes exatos de Thinking nem igualdade de recursos computacionais.
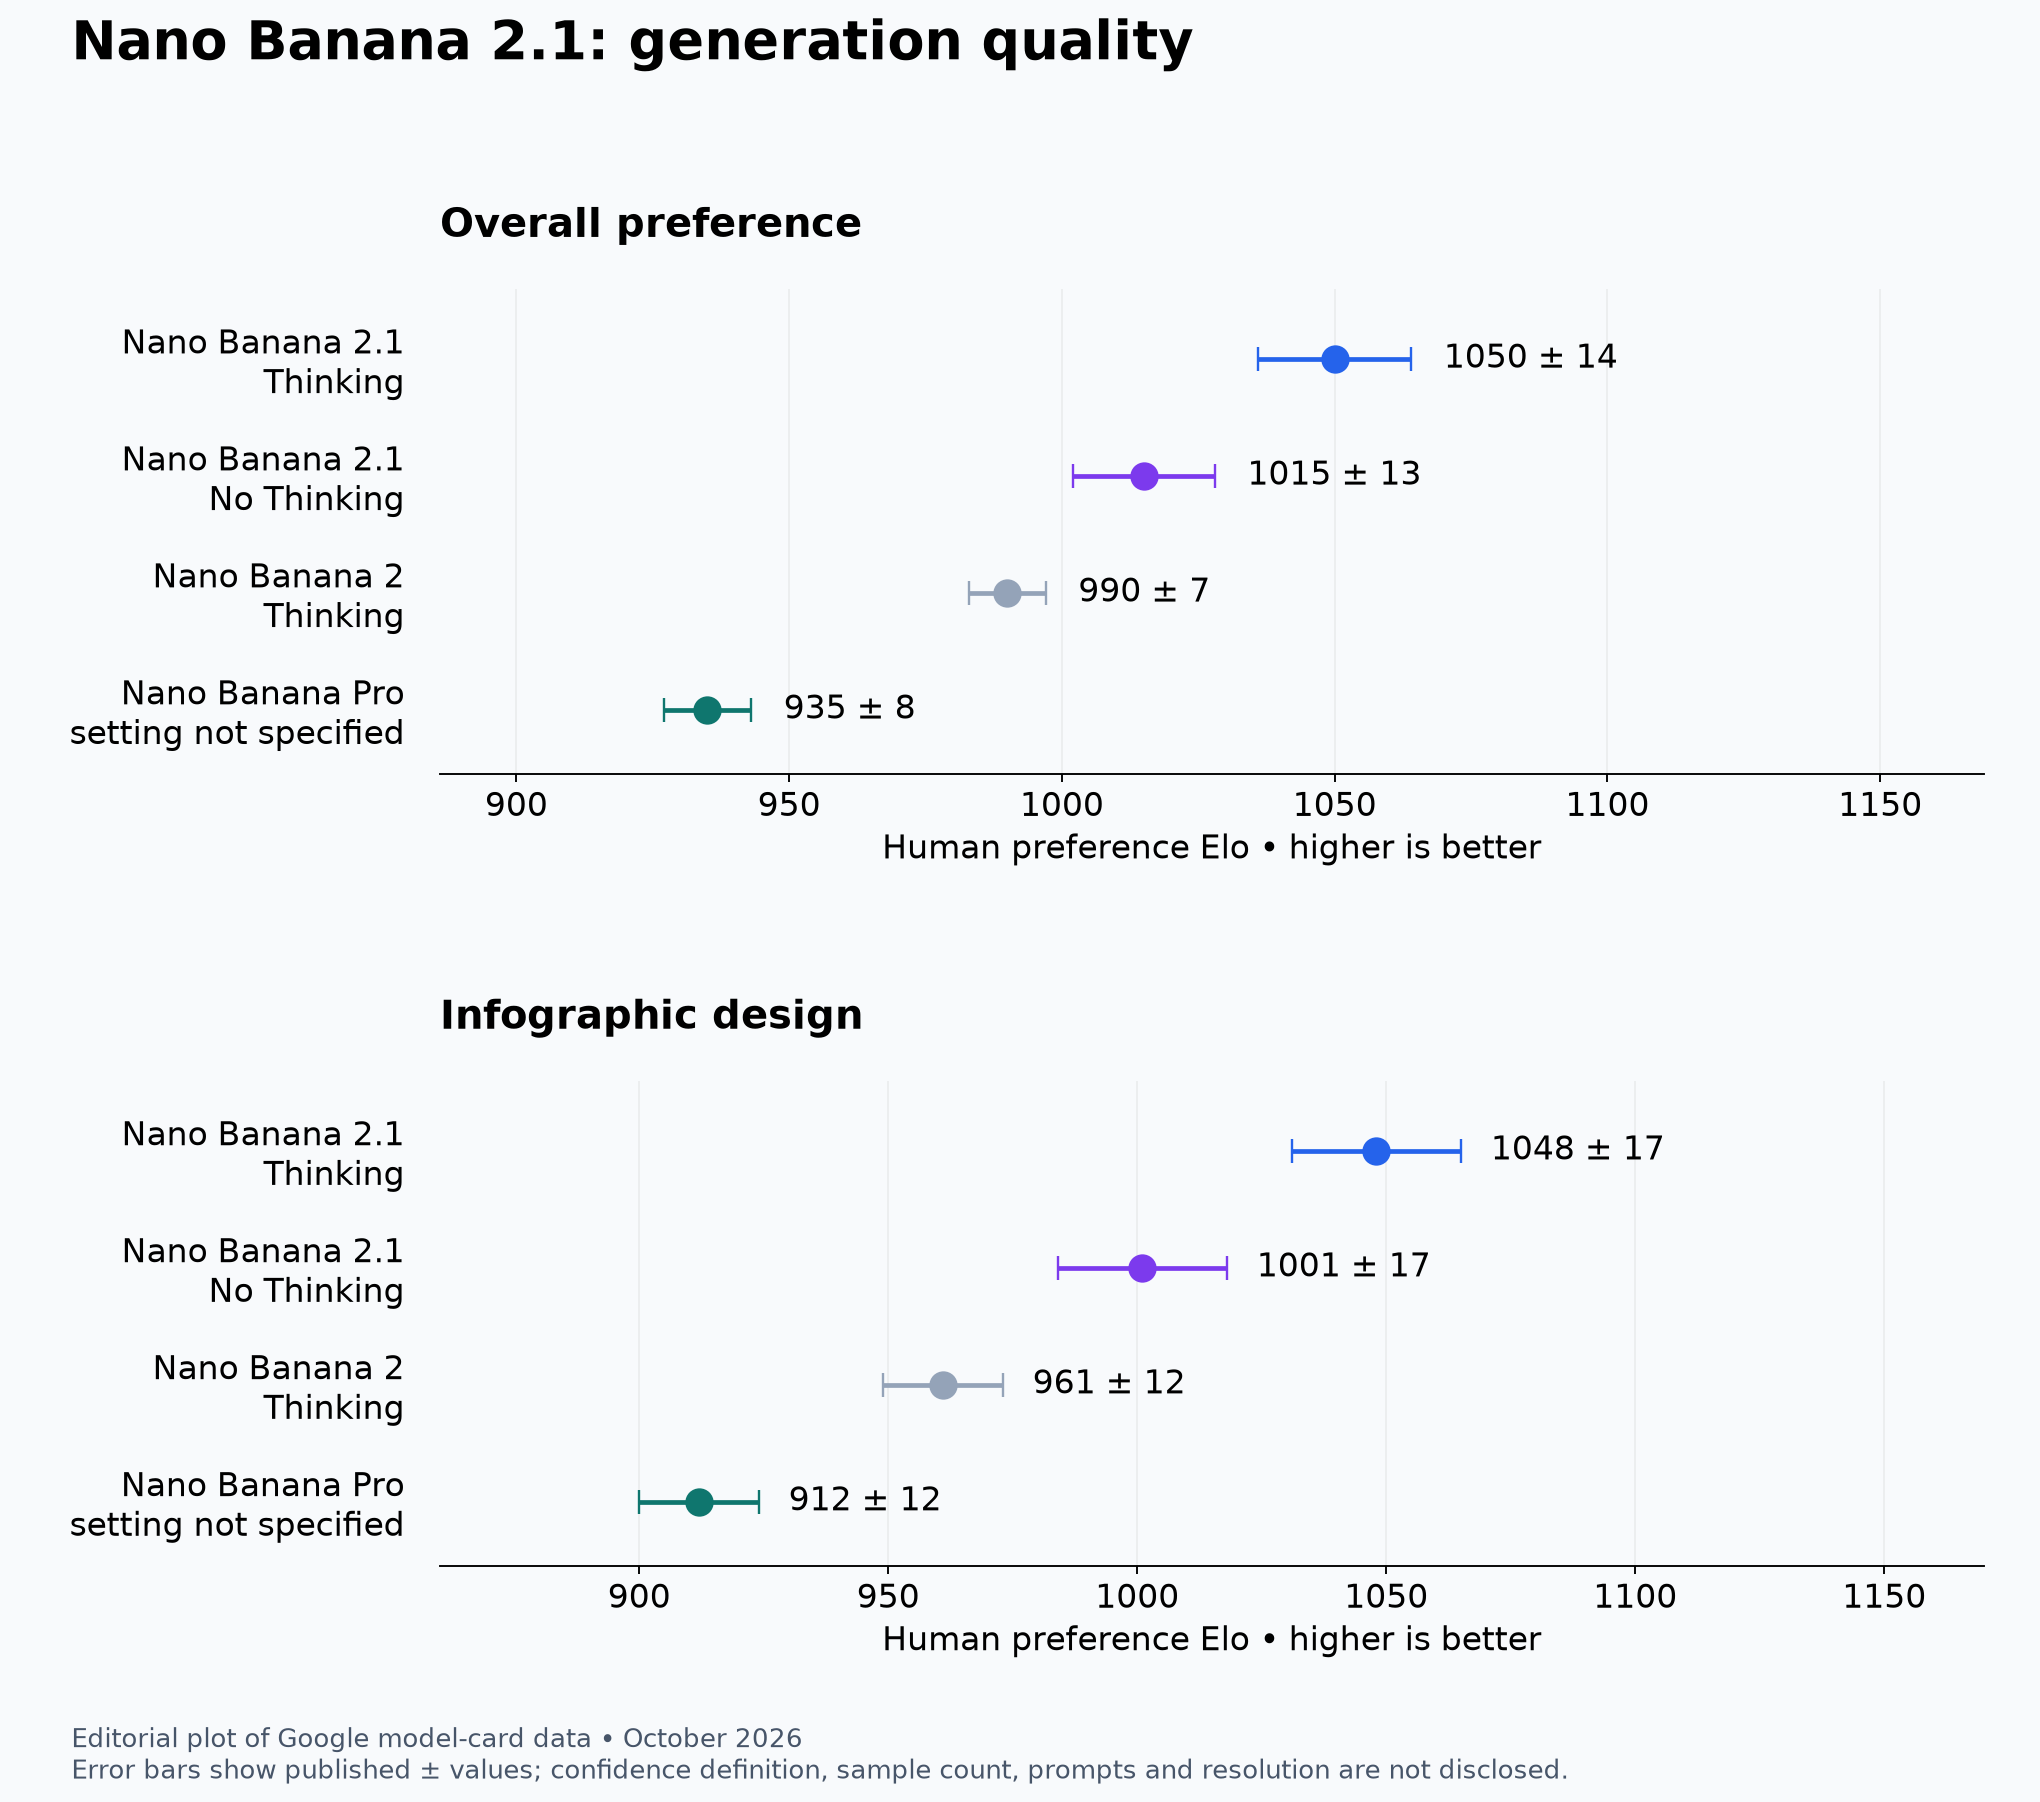
Gráfico editorial dos dados da ficha Google de outubro de 2026, não imagem original do Google. As barras reproduzem as faixas publicadas, sem estabelecer sua confiança ou uma precisão de produção.
Na geração geral, 2.1 Thinking marca 1050 ±14; sem Thinking, 1015 ±13; Nano Banana 2 Thinking, 990 ±7; e Pro, 935 ±8. Em infográficos, a mesma ordem dá 1048 ±17, 1001 ±17, 961 ±12 e 912 ±12. Mesmo considerando as faixas exibidas, as duas modalidades 2.1 superam Nano Banana 2 em infográficos.
O intervalo geral com Thinking, 1036–1064, não se sobrepõe ao de 1002–1028 sem ele. Nos infográficos, os intervalos se tocam em 1031. O primeiro contraste é mais nítido, mas nenhum estabelece o tamanho do ganho em todo prompt. A indicação genérica “Thinking” tampouco equivale necessariamente ao high da API: a configuração avaliada não é divulgada.
Isso impede um atalho operacional. Preferência maior não prova menos tentativas, menor latência ou rótulos corretos. O Google não apresenta aqui latência do benchmark. Equipes criativas têm motivo para testar 2.1, principalmente composição e layout, mas não para inventar aceleração ou retorno universal.
Vários personagens mudam o cálculo do Thinking
Um personagem recorrente e uma cena com várias identidades são cargas distintas. Os testes de consistência mostram essa diferença.
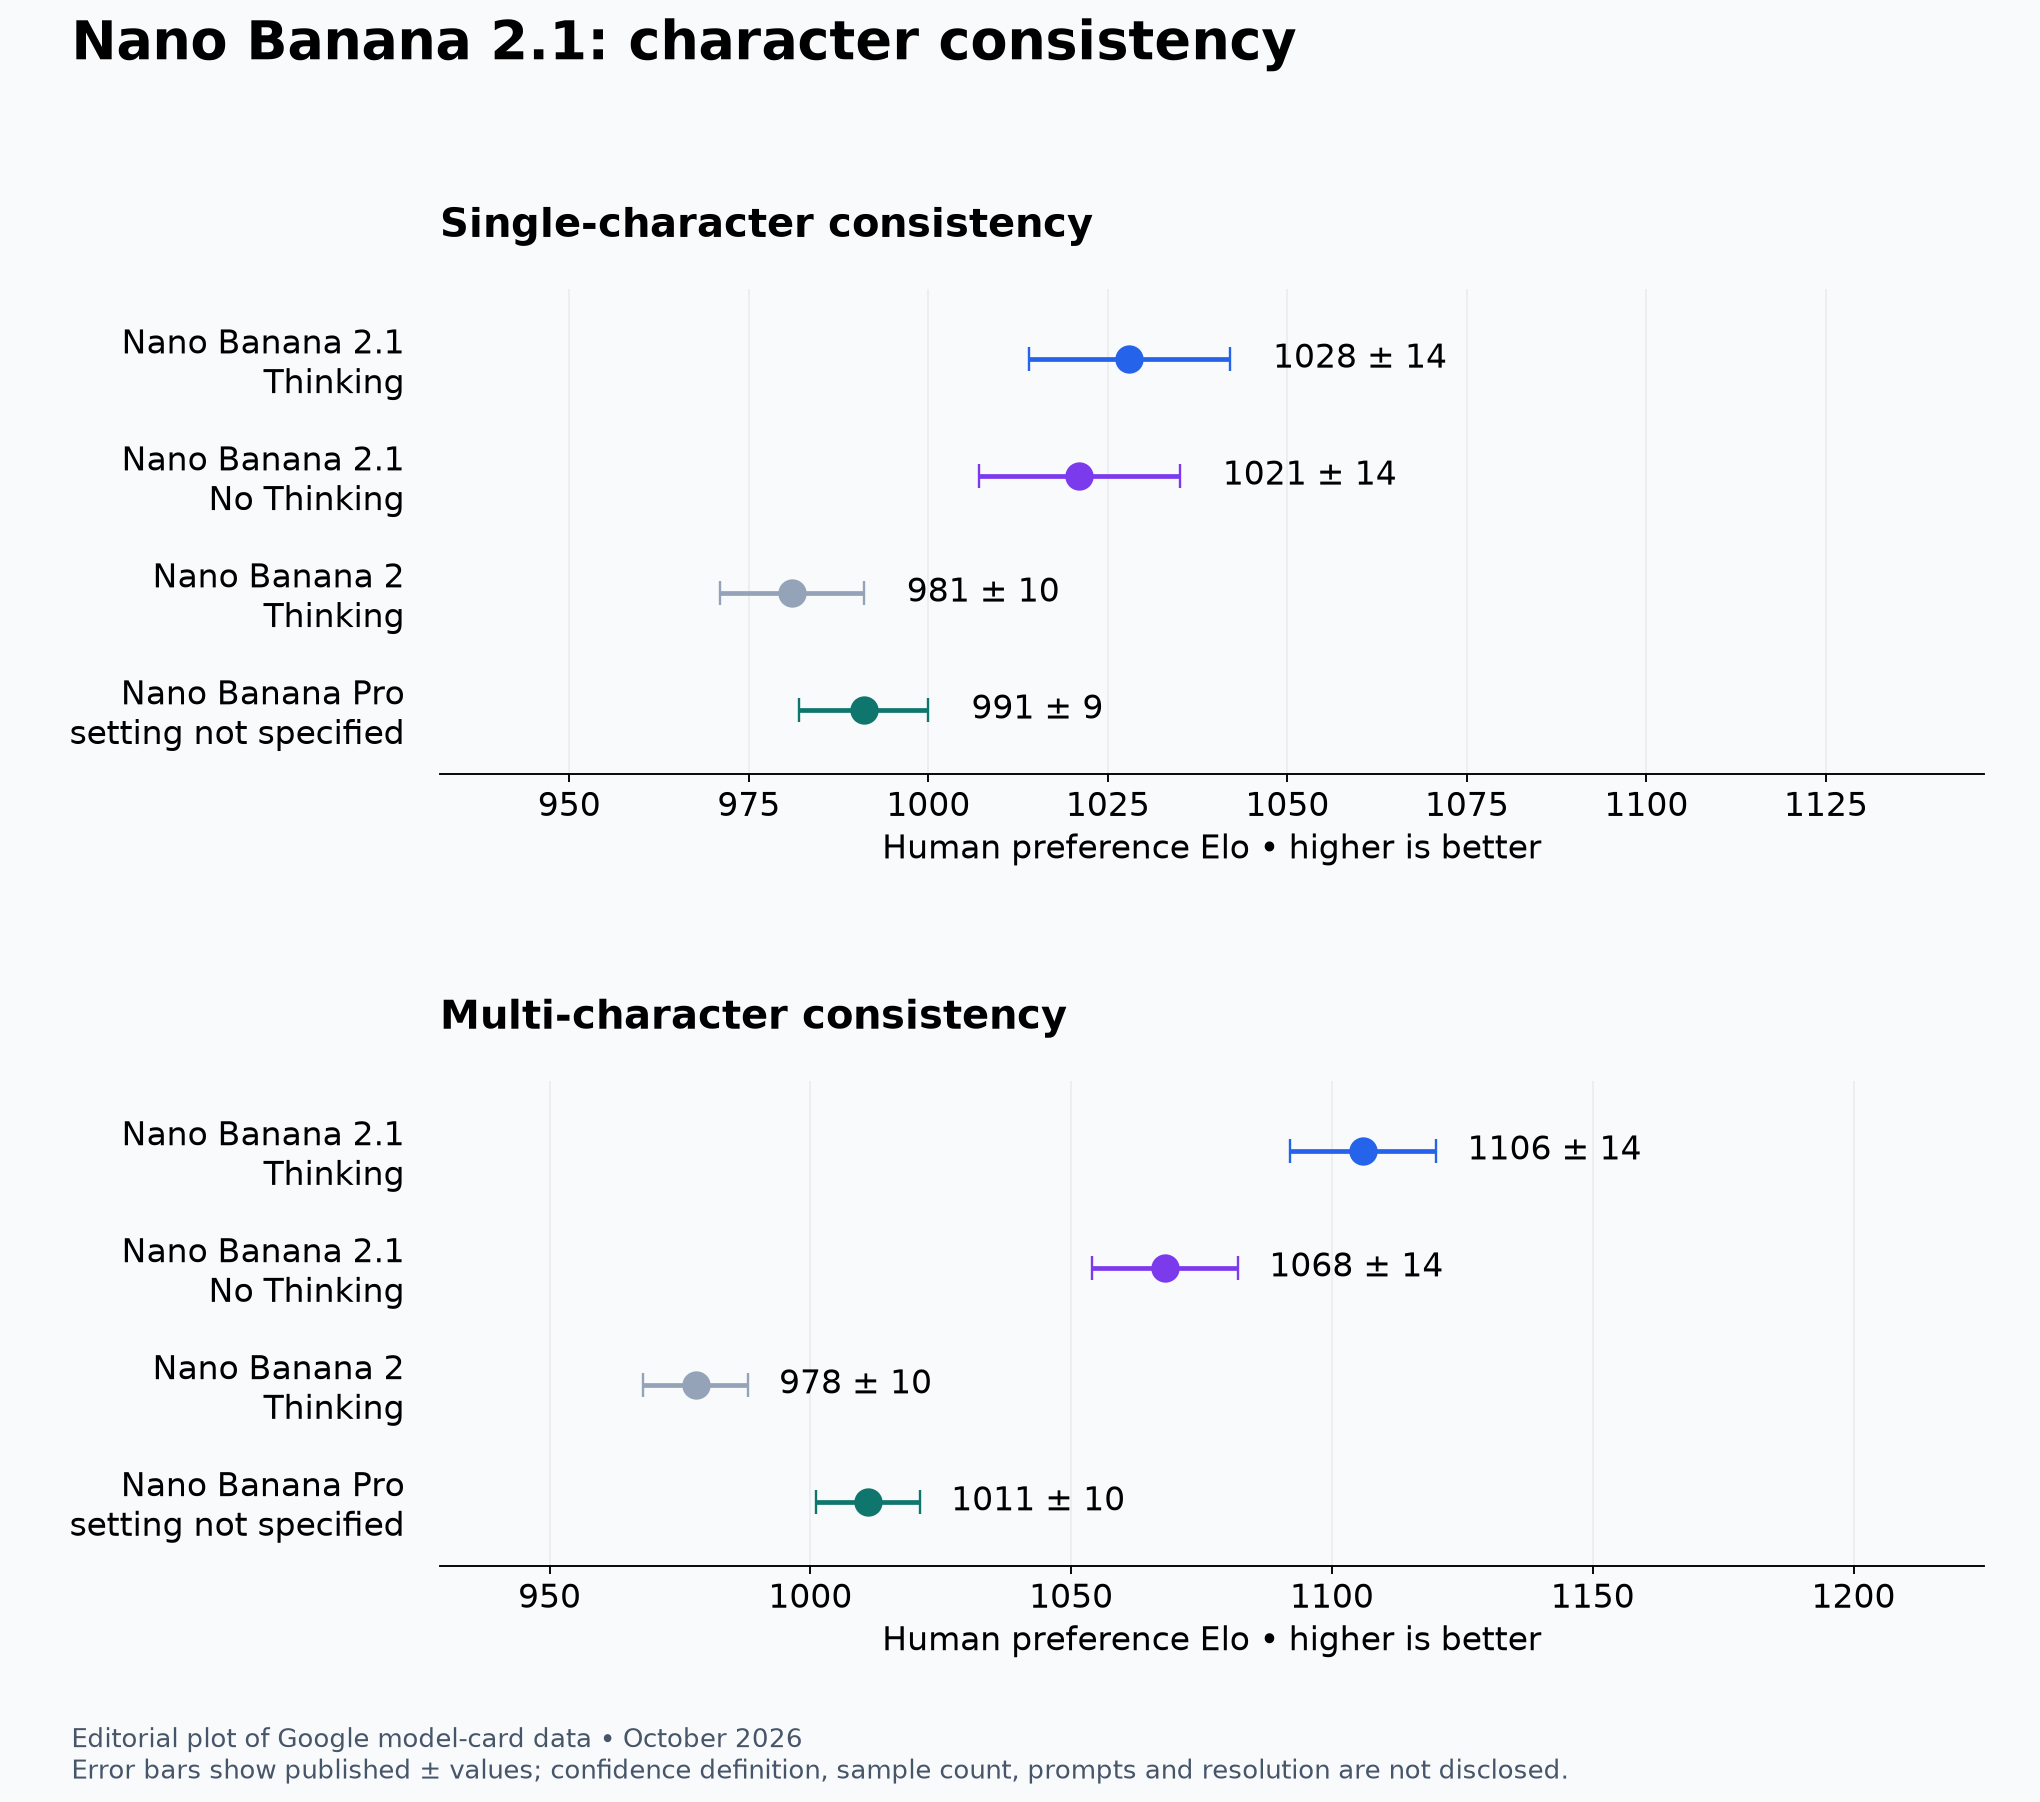
Representação editorial do mesmo conjunto de dados Google. As faixas publicadas não têm definição de confiança informada; a ilustração não é original do Google.
Com um personagem, 2.1 Thinking chega a 1028 ±14 e sem Thinking a 1021 ±14, contra 981 ±10 do Nano Banana 2 Thinking e 991 ±9 do Pro. As faixas de 2.1 se sobrepõem bastante. Sete pontos nos valores centrais não justificam exigir raciocínio em toda solicitação de um sujeito.
Com vários personagens, a separação aumenta: 1106 ±14 com Thinking, 1068 ±14 sem, 1011 ±10 no Pro e 978 ±10 no Nano Banana 2 Thinking. As faixas de 2.1 não se sobrepõem. Thinking torna-se mais promissor para manter identidades e relações, sem provar confiabilidade para quatro pessoas em qualquer combinação de referências.
Uma bela imagem de grupo pode trocar roupas ou omitir alguém. O benchmark não detalha mudanças de rosto, proporções, transferência de vestuário, duplicações ou erros de altura relativa. A revisão precisa avaliar cada sujeito, especialmente com referências cortadas, contraditórias, de iluminação desigual ou visualmente semelhantes. Um voto estético global pode esconder uma falha de identidade que inutilize o material.
A edição depende do que não pode mudar
A edição também não cabe em “Thinking vence”. Máscaras, fidelidade do produto e combinação de referências protegem elementos diferentes.
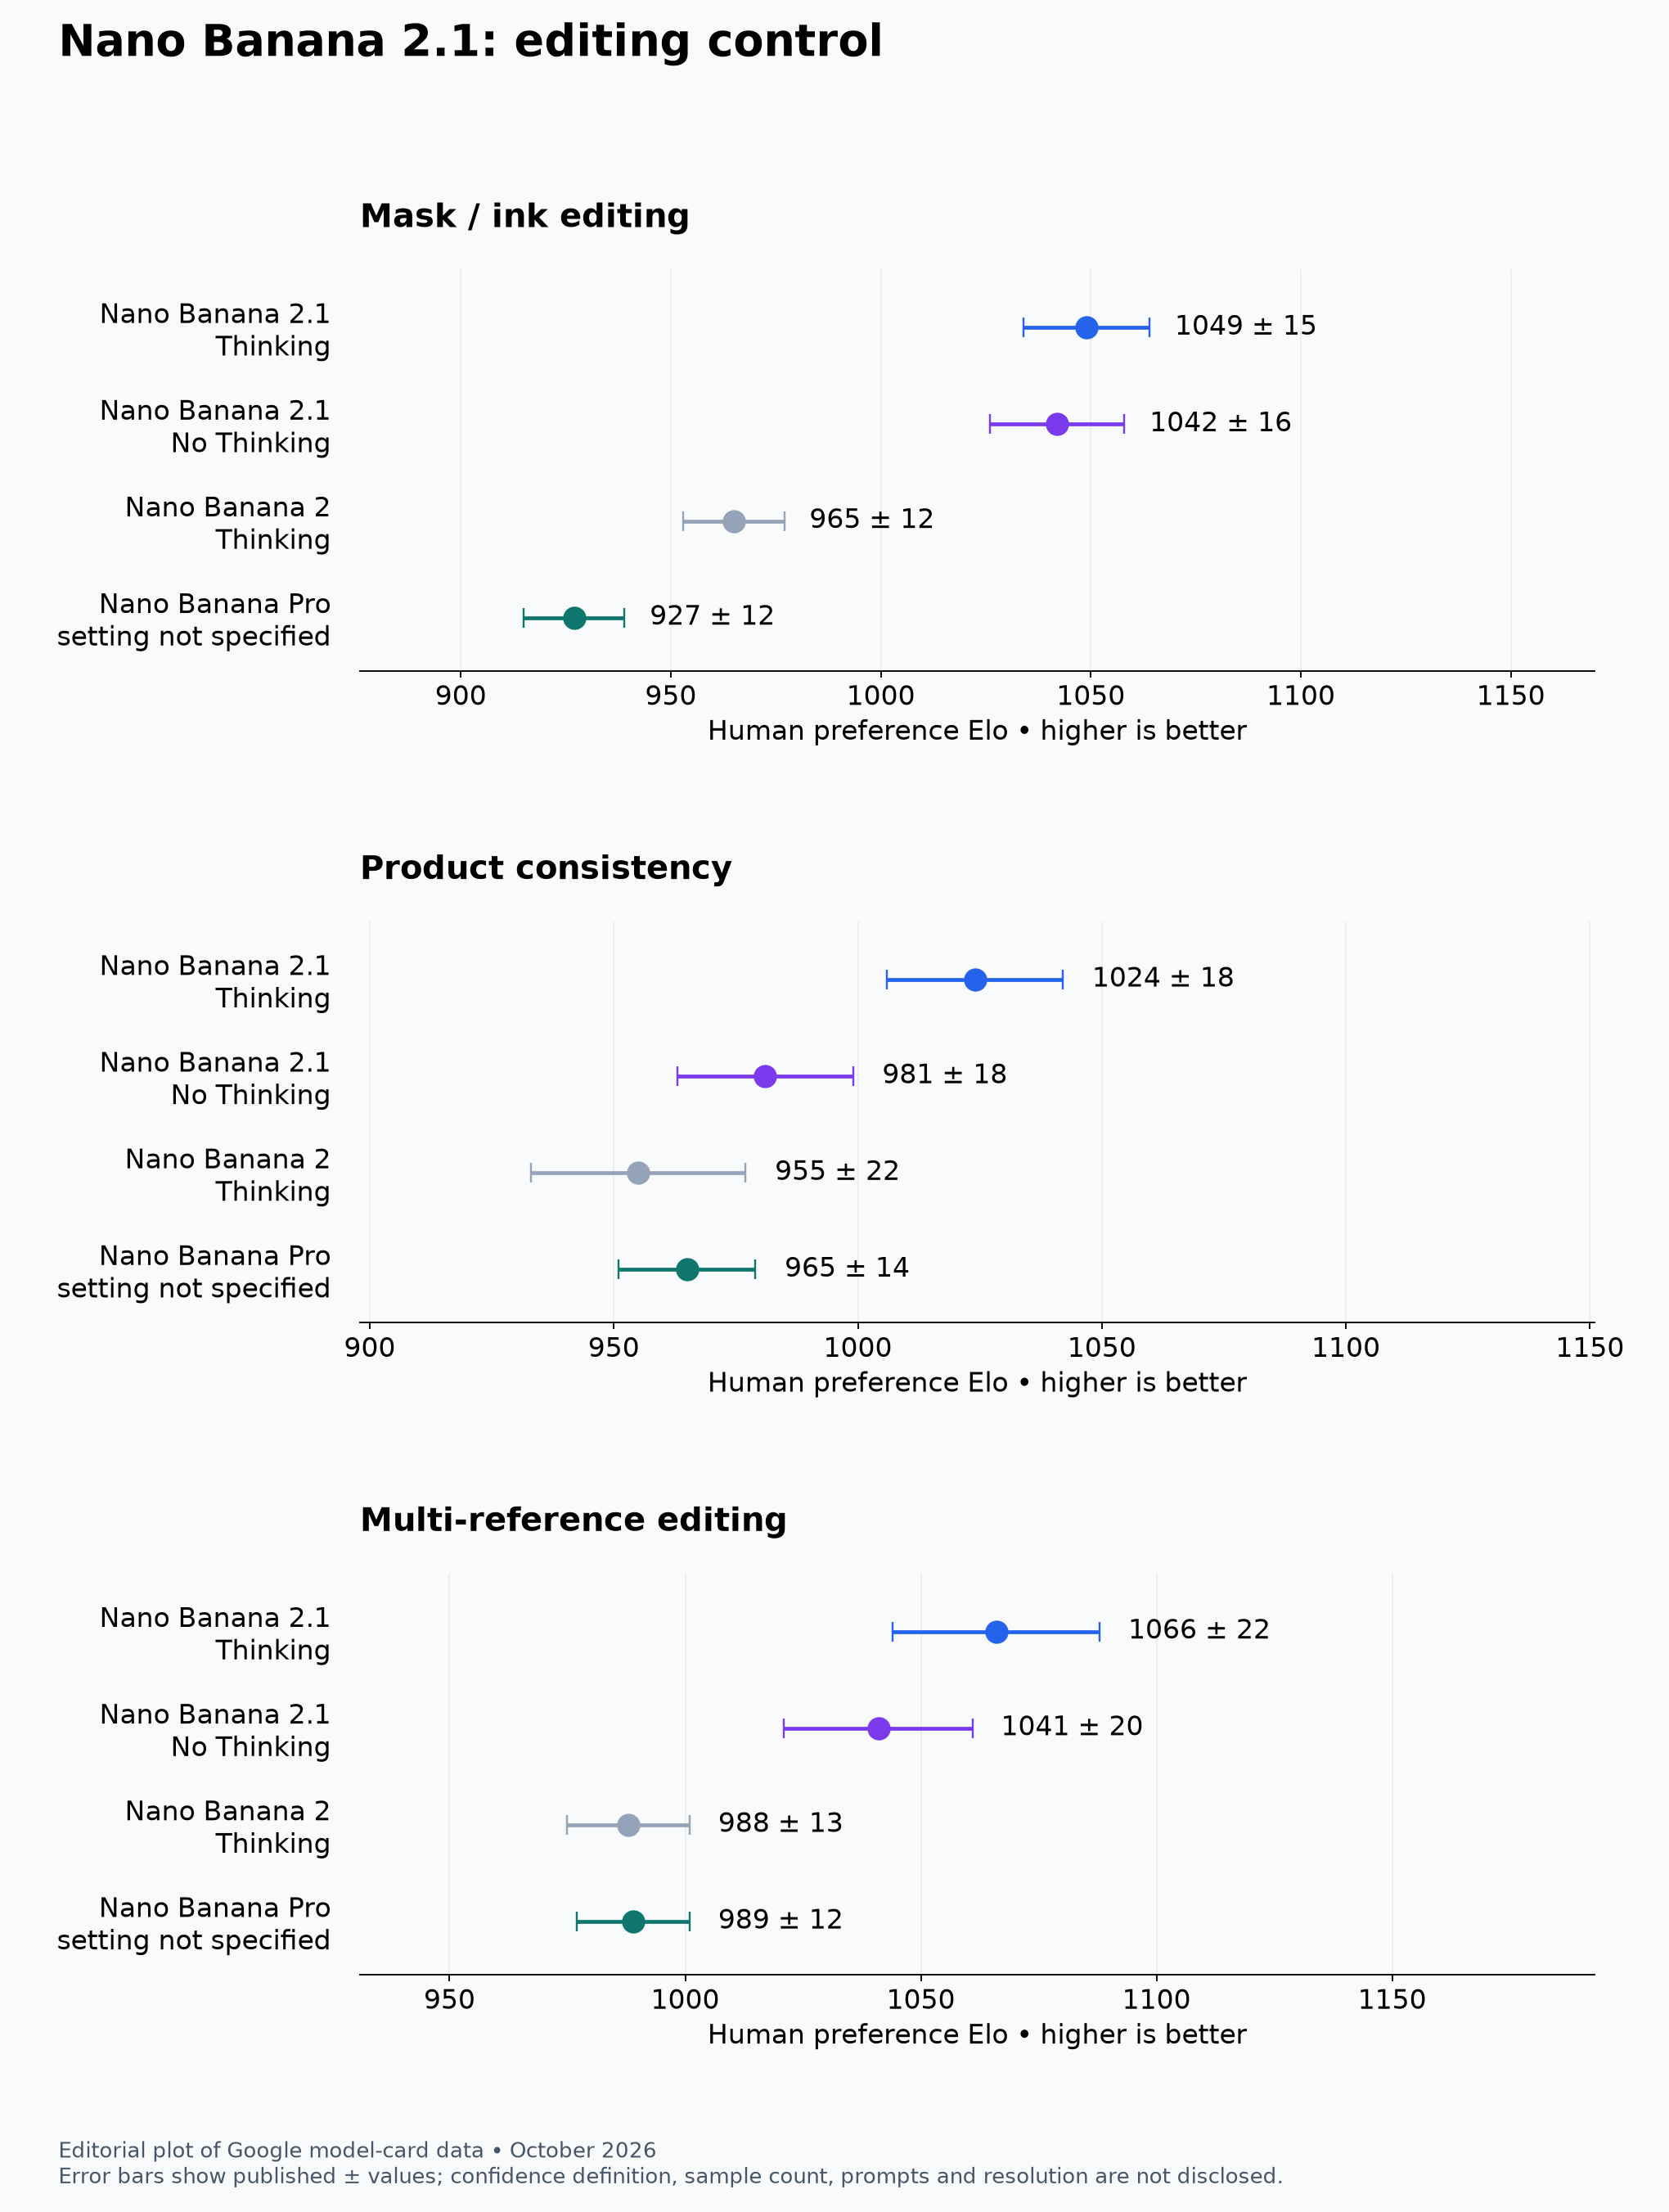
Gráfico editorial baseado na ficha Google, não criação original sua. Elo e faixas ± não medem cumprimento exato das instruções nem pixels preservados fora da máscara.
Em edição por máscara ou traços, 2.1 Thinking obtém 1049 ±15 e sem Thinking 1042 ±16, com forte sobreposição. Ambos superam Nano Banana 2 Thinking a 965 ±12 e Pro a 927 ±12. Isso sustenta testar as duas modalidades 2.1, não transformar sete pontos centrais em benefício comprovado de raciocínio.
Na consistência de produto, Thinking atinge 1024 ±18; sem ele, 981 ±18; Nano Banana 2 Thinking, 955 ±22; Pro, 965 ±14. A faixa sem Thinking cruza as dos dois modelos antigos. Thinking é a configuração mais forte nesse contraste, mas não está demonstrado que toda configuração 2.1 melhora claramente a fidelidade.
Na edição multirreferência, 2.1 Thinking marca 1066 ±22 e sem ele 1041 ±20, contra 988 ±13 do Nano Banana 2 Thinking e 989 ±12 do Pro. 2.1 é mais forte, porém suas próprias faixas se sobrepõem. Os 25 pontos centrais não fundamentam recomendação incondicional.
O Google reconhece instruções de máscara atendidas só em parte, restos de tinta e manutenção inesperada da pose original. Uma edição preferida pode falhar na preservação. No comércio eletrônico, alterar porta, logotipo, quantidade, material ou texto da embalagem pode invalidar uma imagem bonita. Montagens criativas toleram mudanças geométricas que documentação de produto não aceita. São critérios separados, não detalhes para diluir numa nota média.
Factualidade de 0,521 não significa 52,1% correto
A factualidade de infográficos usa outra medida: avaliador automático unilateral, não preferências humanas de geração. O Google informa 0,521 para 2.1 Thinking, 0,328 sem ele, 0,265 para Pro e 0,179 para Nano Banana 2 Thinking.
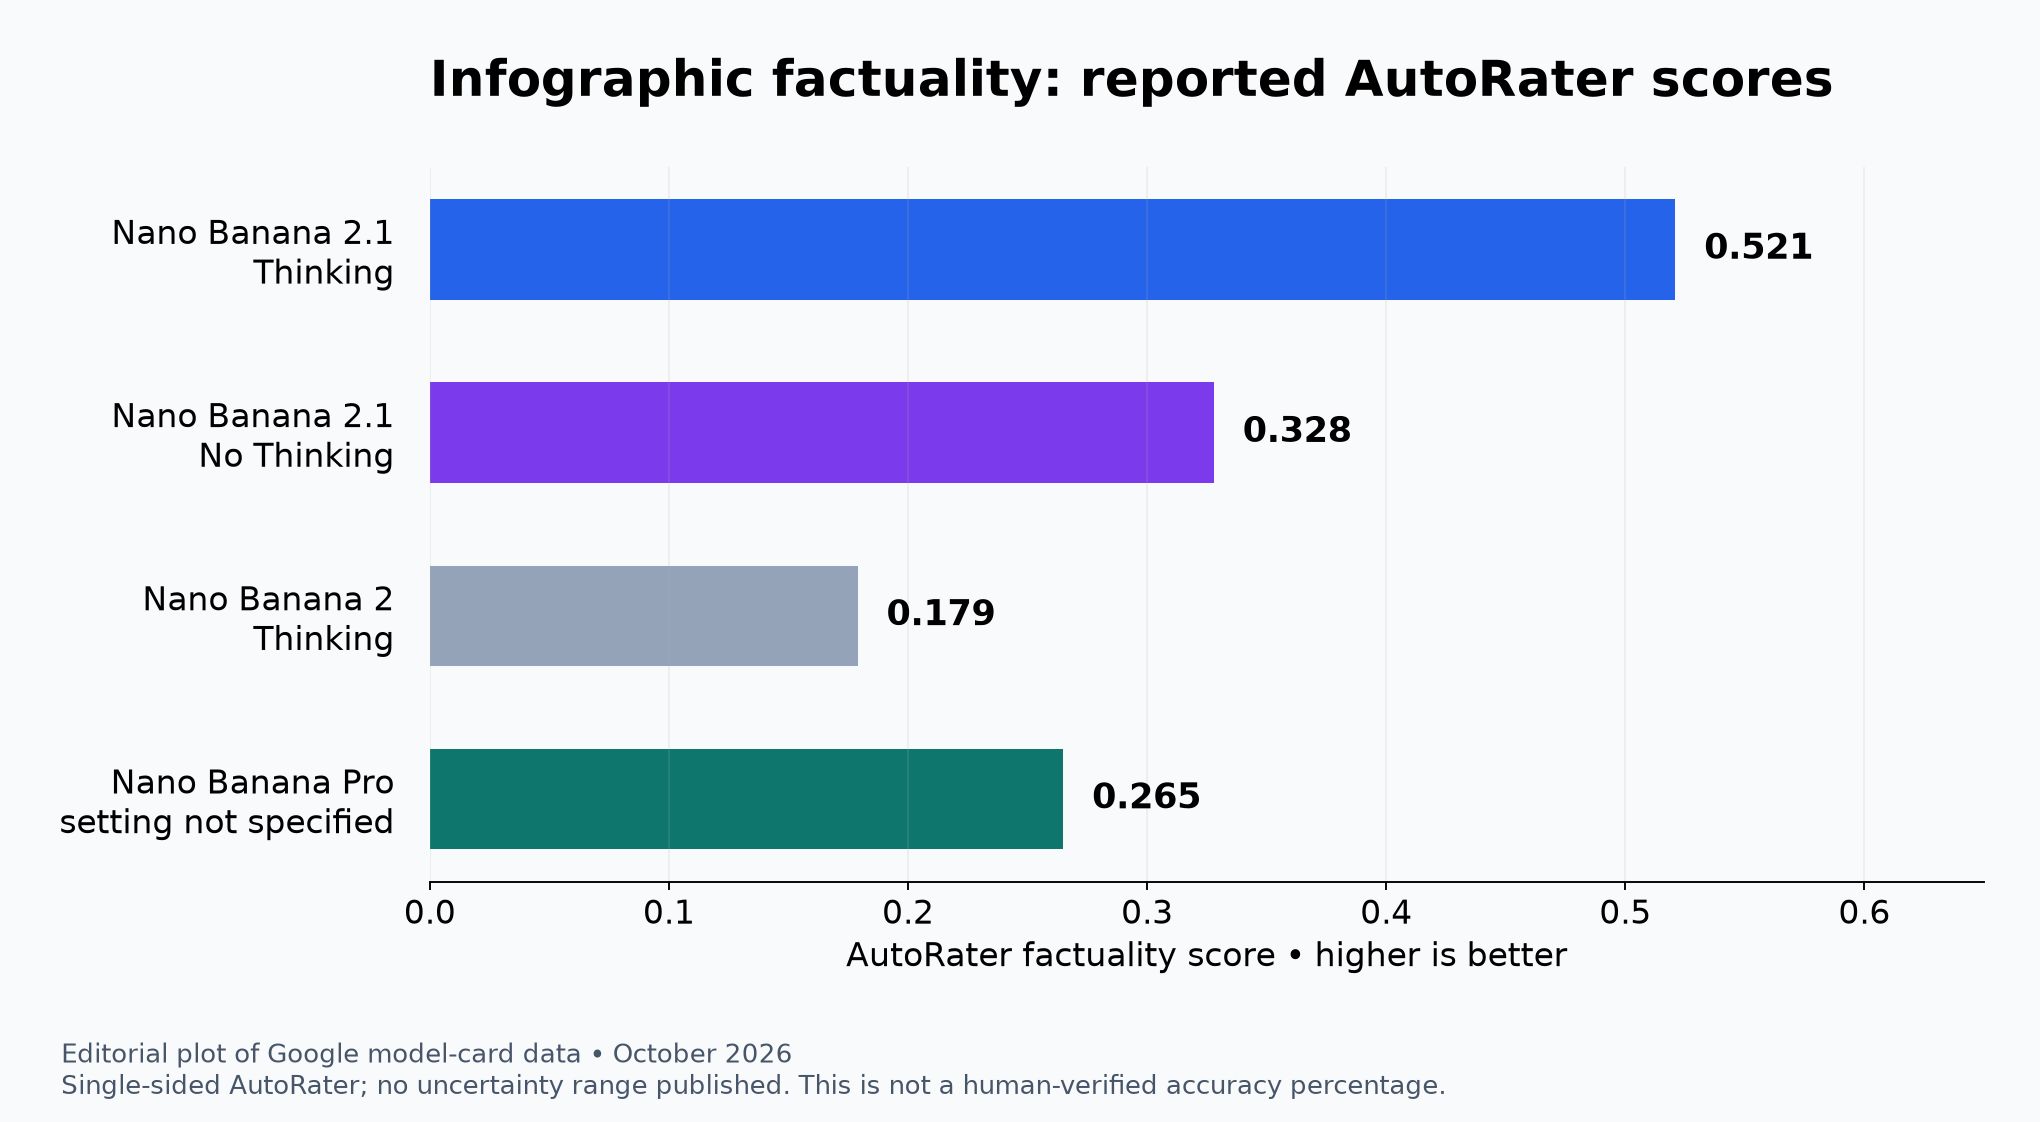
Gráfico editorial da avaliação automática Google. Não são publicadas faixas de incerteza. Não é imagem original do Google nem porcentagem de infográficos factualmente corretos.
Thinking lidera o indicador, mas metodologia, amostras e incerteza informadas não bastam para calcular a taxa operacional de erro factual. Um gráfico pode ter prosa correta e valores desenhados errados; uma cronologia pode inverter fatos; um mapa, trocar regiões; um rótulo, apontar para o objeto errado. A tabela pública não estabelece quais falhas o avaliador detecta com confiabilidade.
A busca pode recuperar informação sem garantir transcrição visual fiel. A ficha subjacente dá março de 2026 como corte de conhecimento, com alguns domínios possivelmente limitados a janeiro de 2025 e outros com informação posterior. Um gráfico de aparência atual continua exigindo fatos fornecidos ou recuperados e comparação com a imagem final.
A unidade controlável é uma ficha factual: valores, unidades, datas, rótulos e citações aprovados antes da geração e conferidos depois na imagem. Fatos rastreáveis e dossiês de fontes ajudam a separar evidência de apresentação, mas não tornam a imagem autoverificável. Em medicina, finanças, direito, ciência e atualidades, AutoRater não pode autorizar a publicação.
Saída mais barata não garante material aceito mais barato
Os preços padrão da API paga fixam a saída de imagem em 30 dólares por milhão de tokens para 2.1, contra 60 para Nano Banana 2. A alocação diferente em 4K altera essa aparente metade.
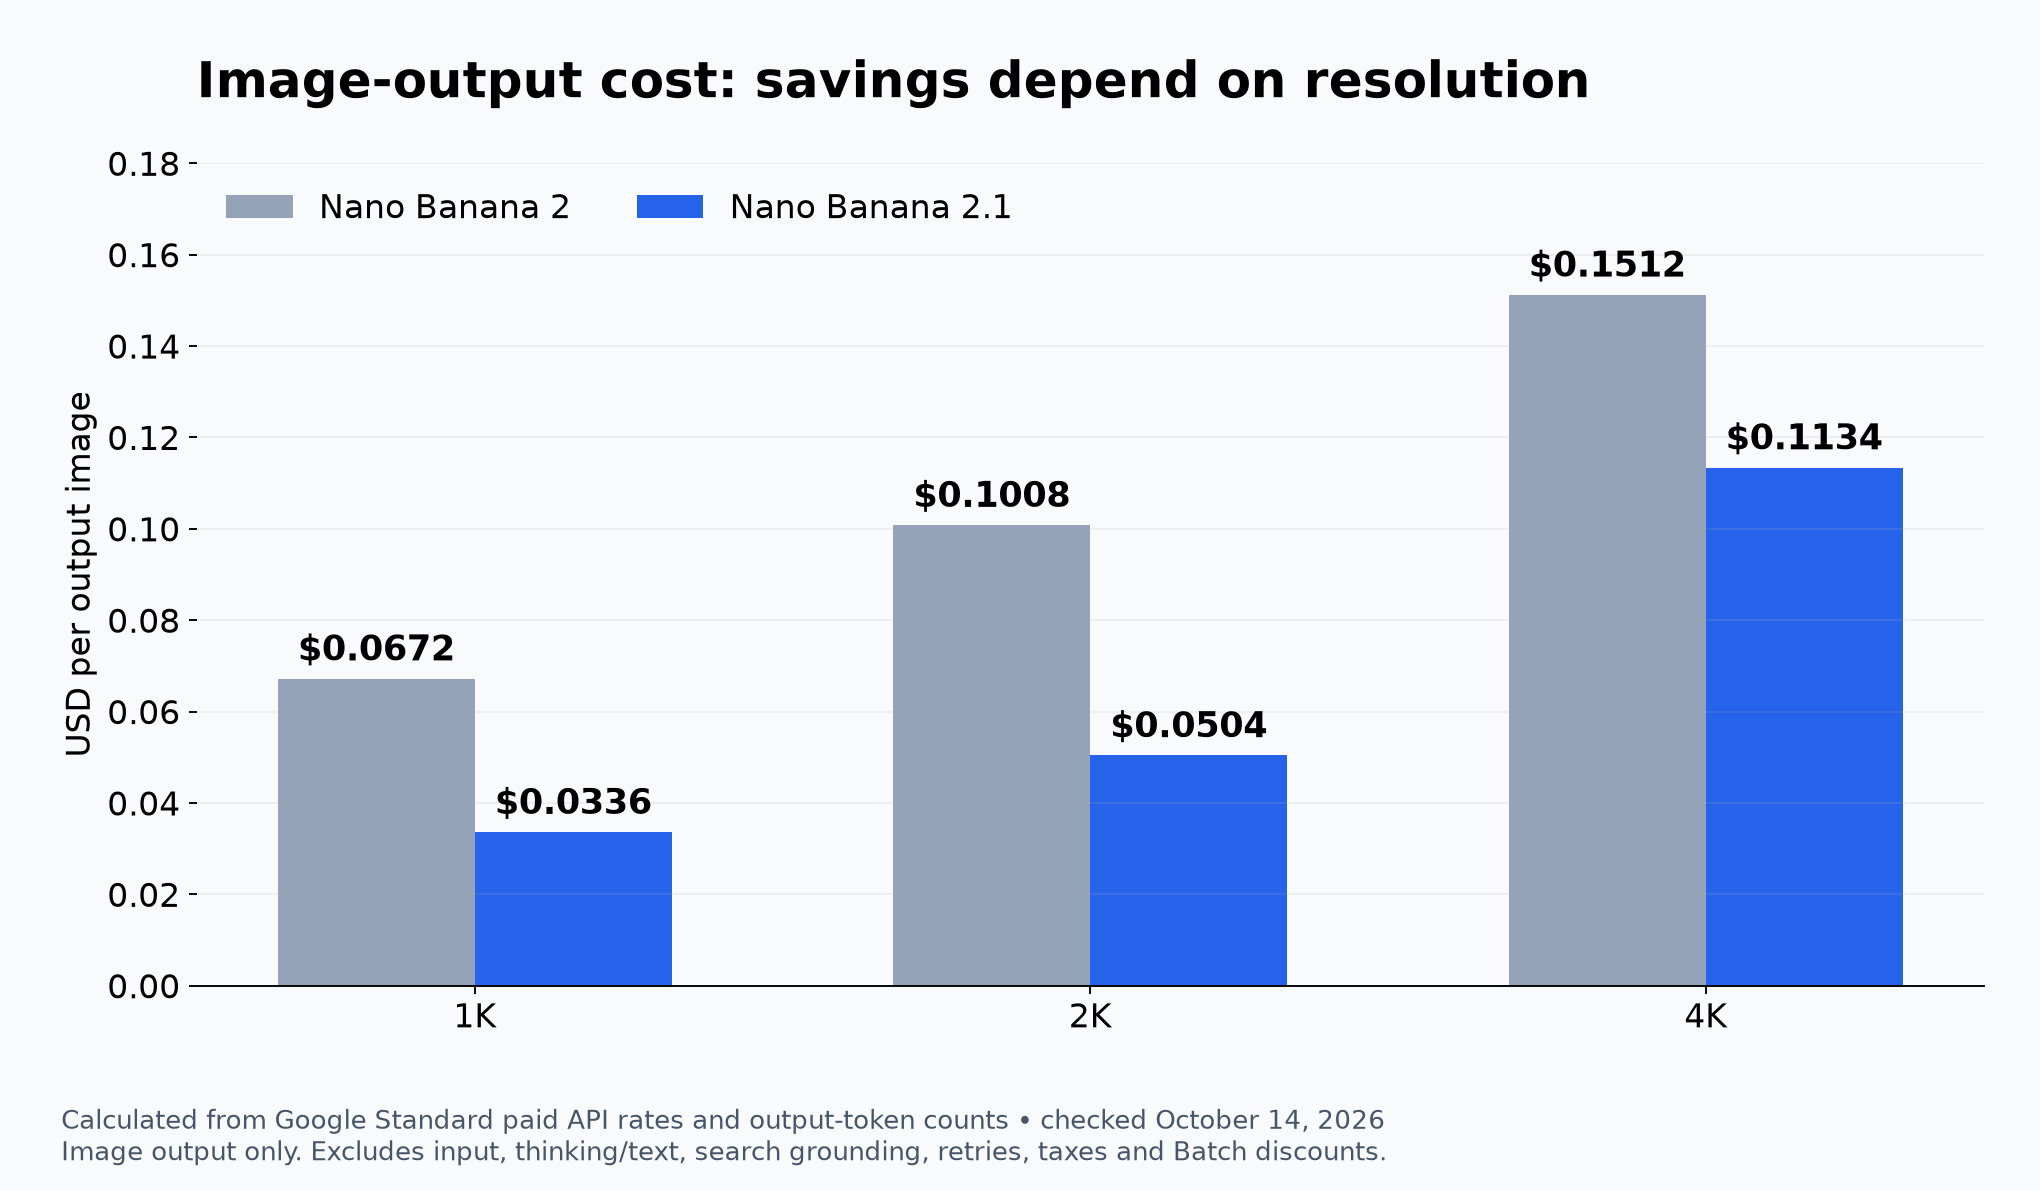
Cálculo editorial com tarifas e alocações Google publicadas até 14 de outubro. São custos só de saída, não totais medidos, e não é gráfico original do Google.
Em 1K, ambos usam 1120 tokens de imagem: 0,0336 dólar no 2.1 e 0,0672 no Nano Banana 2. Em 2K, 1680 tokens custam 0,0504 e 0,1008 dólar. Nos dois casos a saída cai 50%.
Em 4K, 2.1 lista 3780 tokens e Nano Banana 2, 2520. Multiplicando pelas respectivas tarifas, são 0,1134 contra 0,1512 dólar: economia de 25%, não 50%. Com mais tokens, metade do preço unitário não significa metade do preço da imagem.
Outros componentes sobem. A entrada padrão de texto, imagem ou vídeo no 2.1 custa 1,50 dólar por milhão de tokens, contra 0,50 para texto ou imagem no Nano Banana 2. A saída de texto e Thinking custa 7,50 contra 3 dólares. Fundamentação, referências, texto, raciocínio, novas tentativas, impostos e possíveis descontos Batch afetam a fatura completa.
Sem hipóteses sobre os volumes, não há total “típico” defensável. Melhor aceitação na primeira tentativa pode compensar raciocínio; mais repetições podem consumir a economia. A métrica é custo por material aceito, junto com latência e expiração medidas, não tarifa isolada de saída.
Migrar exige evidências pareadas
Um teste útil daria os mesmos prompts reais e referências ao modelo atual e aos níveis disponíveis de Thinking do 2.1, mantendo proporção, resolução e orçamento de tentativas. É uma proposta de avaliação, não teste realizado pelo AI Tools Radar. Pro só entra se for opção real de implantação; seus ajustes não especificados no benchmark não podem ser presumidos equivalentes.
Separe um ou vários personagens, produto, máscaras, composição de referências, layouts com texto e gráficos factuais. Texto exato pode ser transcrito e comparado; máscaras exigem revisão dentro e fora da área permitida; produtos, das características protegidas. Preferência cega complementa, mas não substitui precisão onde logotipos ou números devem ficar intactos.
Preservar pares e incerteza evita comprimir riscos distintos em uma média. Registros operacionais precisam incluir latência completa, expirações, tentativas, tokens e custo por imagem aceita. Uma fase em paralelo à produção mostra se a vantagem do benchmark realmente reduz revisões.
Não há fonte que sustente encerramento em 29 de outubro para forçar uma troca apressada. A referência de descontinuação lista Gemini 3.1 Flash Image como obsoleto, mas sem data anunciada de desligamento. Isso tampouco promete disponibilidade indefinida.
Os primeiros casos mais fortes são infográficos, vários personagens recorrentes, composição de referências e saída mais barata. Thinking merece atenção especial para múltiplas identidades e factualidade; resultados sobrepostos deixam espaço para configurações simples em outras tarefas. Se letras pequenas, fatos, identidade exata ou regiões intactas de produto forem obrigatórios, mantenha validação externa e alternativa até o endpoint cumprir as exigências. A liderança publicada motiva comparar; não substitui a comparação.