
Nano Banana 2.1 avance deux avantages distincts pour les équipes de production visuelle : de meilleurs résultats dans les comparaisons de Google et un tarif inférieur pour les jetons d’image générée. Aucun ne démontre à lui seul qu’un visuel publiable coûte moins cher. La question est de savoir si les gains mesurés résistent aux contraintes réelles : identité, exactitude factuelle, détails protégés d’un produit et coût total des tentatives.
Cette analyse du 14 octobre fait suite à la disponibilité générale du 6 octobre, pas à un nouveau lancement le même jour. Les signaux les plus forts concernent la préférence pour les infographies, la cohérence de plusieurs personnages et certaines retouches. La lecture la plus fragile consisterait à transformer une préférence en taux d’exactitude, à supposer un bénéfice identique de Thinking partout ou à qualifier toute requête de moitié moins chère.
Le point d’accès déployé est plus limité que la fiche du modèle
Le journal de l’API donne gemini-nano-banana-2.1 comme identifiant stable. Google décrit une mise à jour de classe Flash de Gemini 3.1 Flash Image, aussi appelé Nano Banana 2, et non un nouveau Pro. Selon la fiche du modèle, il repose sur Gemini 3.6 Flash, reçoit du texte et des images et renvoie des images et du texte.
Les conditions d’implémentation comptent autant que cette filiation. La documentation du point d’accès prévoit une sortie 1K par défaut et jusqu’à 4K. Thinking propose minimal, medium et high, avec medium par défaut. L’ancrage par recherche est disponible, mais pas les appels de fonctions, l’exécution de code ni les sorties structurées. Les applications doivent donc assurer ces orchestrations et contrôles hors du modèle d’image.
Une divergence de capacité reste inexpliquée. La fiche annonce jusqu’à un million de jetons de contexte et 64K de sortie textuelle ; la page Gemini API indique 131 072 jetons d’entrée et 32 768 de sortie. Les sources n’expliquent pas leur articulation. Un déploiement doit respecter les plafonds documentés de son point d’accès, sans considérer automatiquement disponibles les chiffres architecturaux supérieurs.
La fusion accepte jusqu’à 14 images de référence, dont au plus quatre personnages et dix objets. Ce sont des limites d’entrée, pas une garantie de préserver fidèlement quatorze références ou quatre identités indépendantes.
La fiche cite aussi les petits textes ou passages longs flous ou dégradés, la dérive d’identité, la confusion gauche-droite, un raisonnement 3D et des connaissances factuelles imparfaits, ainsi que lenteurs et expirations occasionnelles. Résidus de masque et poses persistantes ajoutent des risques de retouche. Ces limites reconnues exigent critères d’échec et solution de repli ; davantage de références ou de contexte ne les élimine pas.
La génération mesure une préférence, pas la justesse
Google compare les préférences humaines avec Elo, sans compter la proportion d’images correctes. Les marges ± publiées donnent un contexte, mais leur niveau de confiance n’est pas défini. Le nombre d’échantillons, les prompts, les résolutions, les budgets de nouvelles tentatives, les réglages précis de Thinking et l’égalité des ressources de calcul ne sont pas révélés non plus.
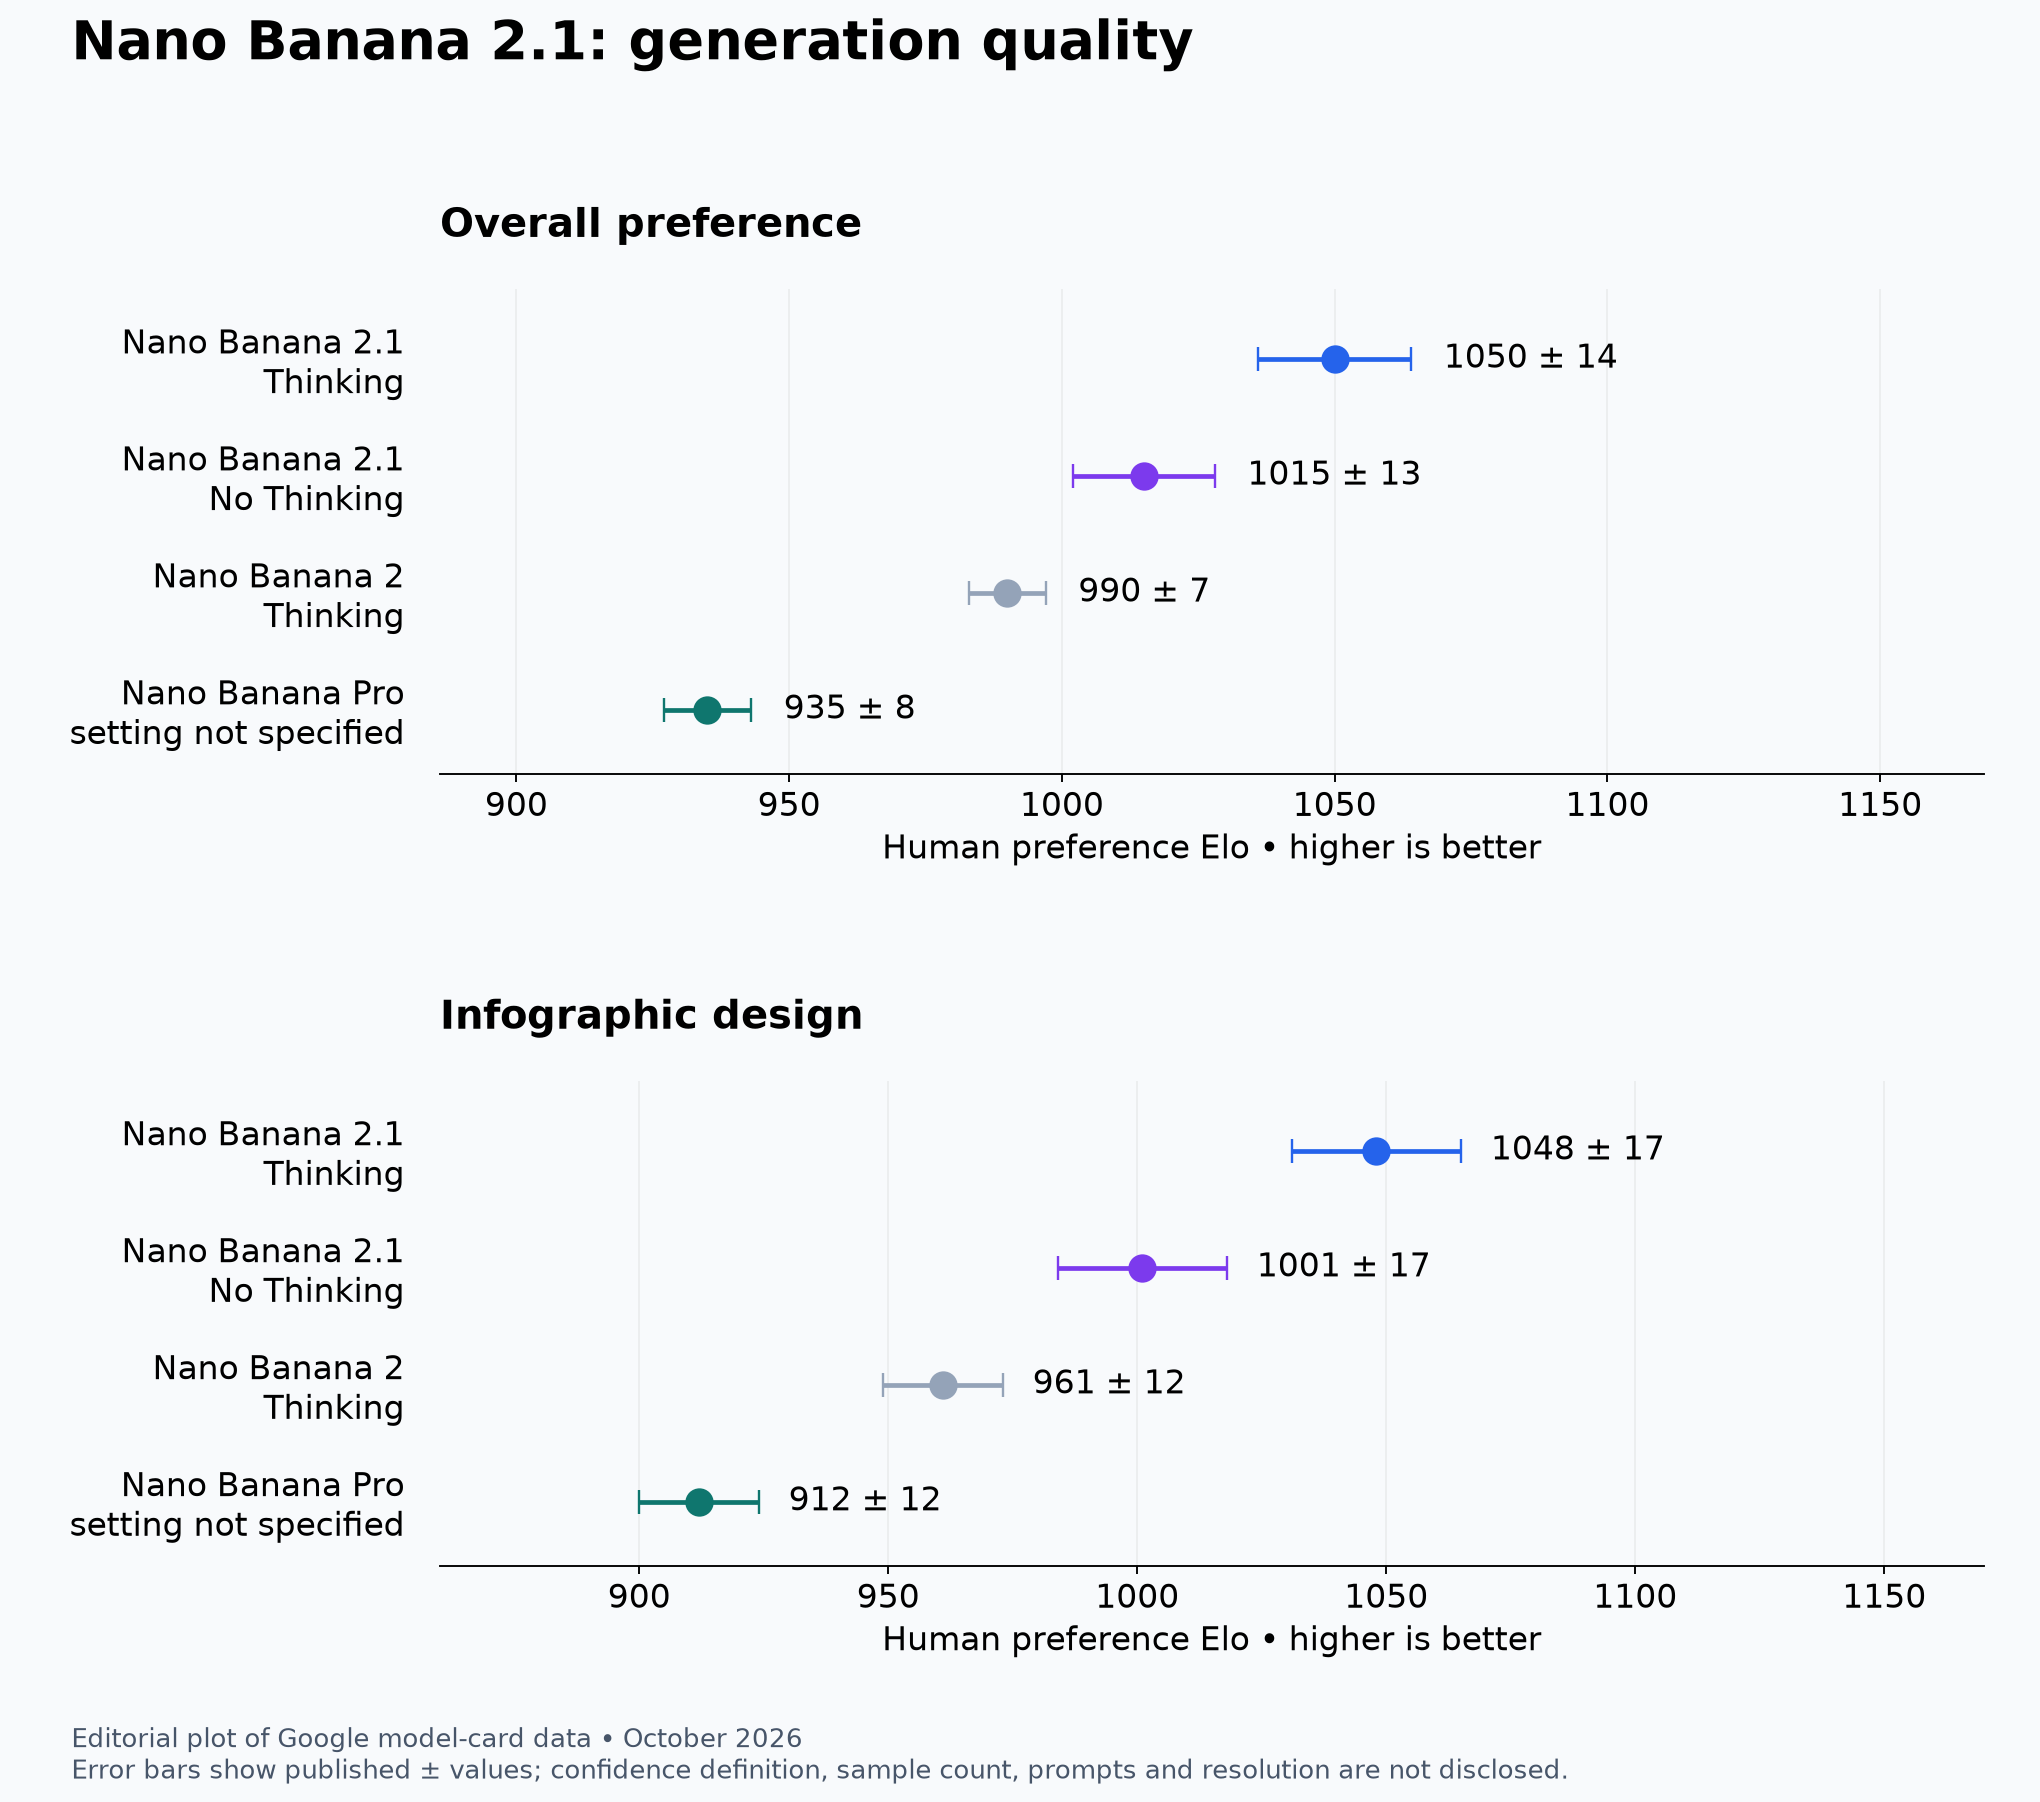
Graphique éditorial tiré des données de la fiche Google d’octobre 2026, et non image originale de Google. Les barres reproduisent les marges publiées ; elles n’établissent ni leur définition de confiance ni une exactitude en production.
Pour la génération générale, 2.1 Thinking atteint 1050 ±14, sans Thinking 1015 ±13, Nano Banana 2 Thinking 990 ±7 et Pro 935 ±8. En infographie, le même ordre donne 1048 ±17, 1001 ±17, 961 ±12 et 912 ±12. Même en tenant compte des plages affichées, les deux modes 2.1 dépassent Nano Banana 2 en infographie.
L’intervalle général de Thinking, 1036–1064, ne recoupe pas celui sans Thinking, 1002–1028. En infographie, les intervalles se touchent à 1031. Le premier résultat est plus différencié, mais aucun n’établit l’ampleur du gain pour chaque prompt. L’étiquette générique « Thinking » ne peut pas davantage être assimilée au niveau high de l’API, puisque la configuration d’évaluation est inconnue.
Cela interdit un raccourci opérationnel. Une préférence supérieure ne prouve ni moins de tentatives, ni une latence réduite, ni des étiquettes correctes. Google ne fournit ici aucune mesure de latence du benchmark. Les équipes créatives ont une raison de tester 2.1, notamment pour composition et mise en page, mais pas d’inventer une accélération ou une rentabilité universelle.
Plusieurs personnages changent l’intérêt de Thinking
Un personnage récurrent et une scène comportant plusieurs identités ne sont pas la même charge de travail. Les tests de cohérence rendent cette différence visible.
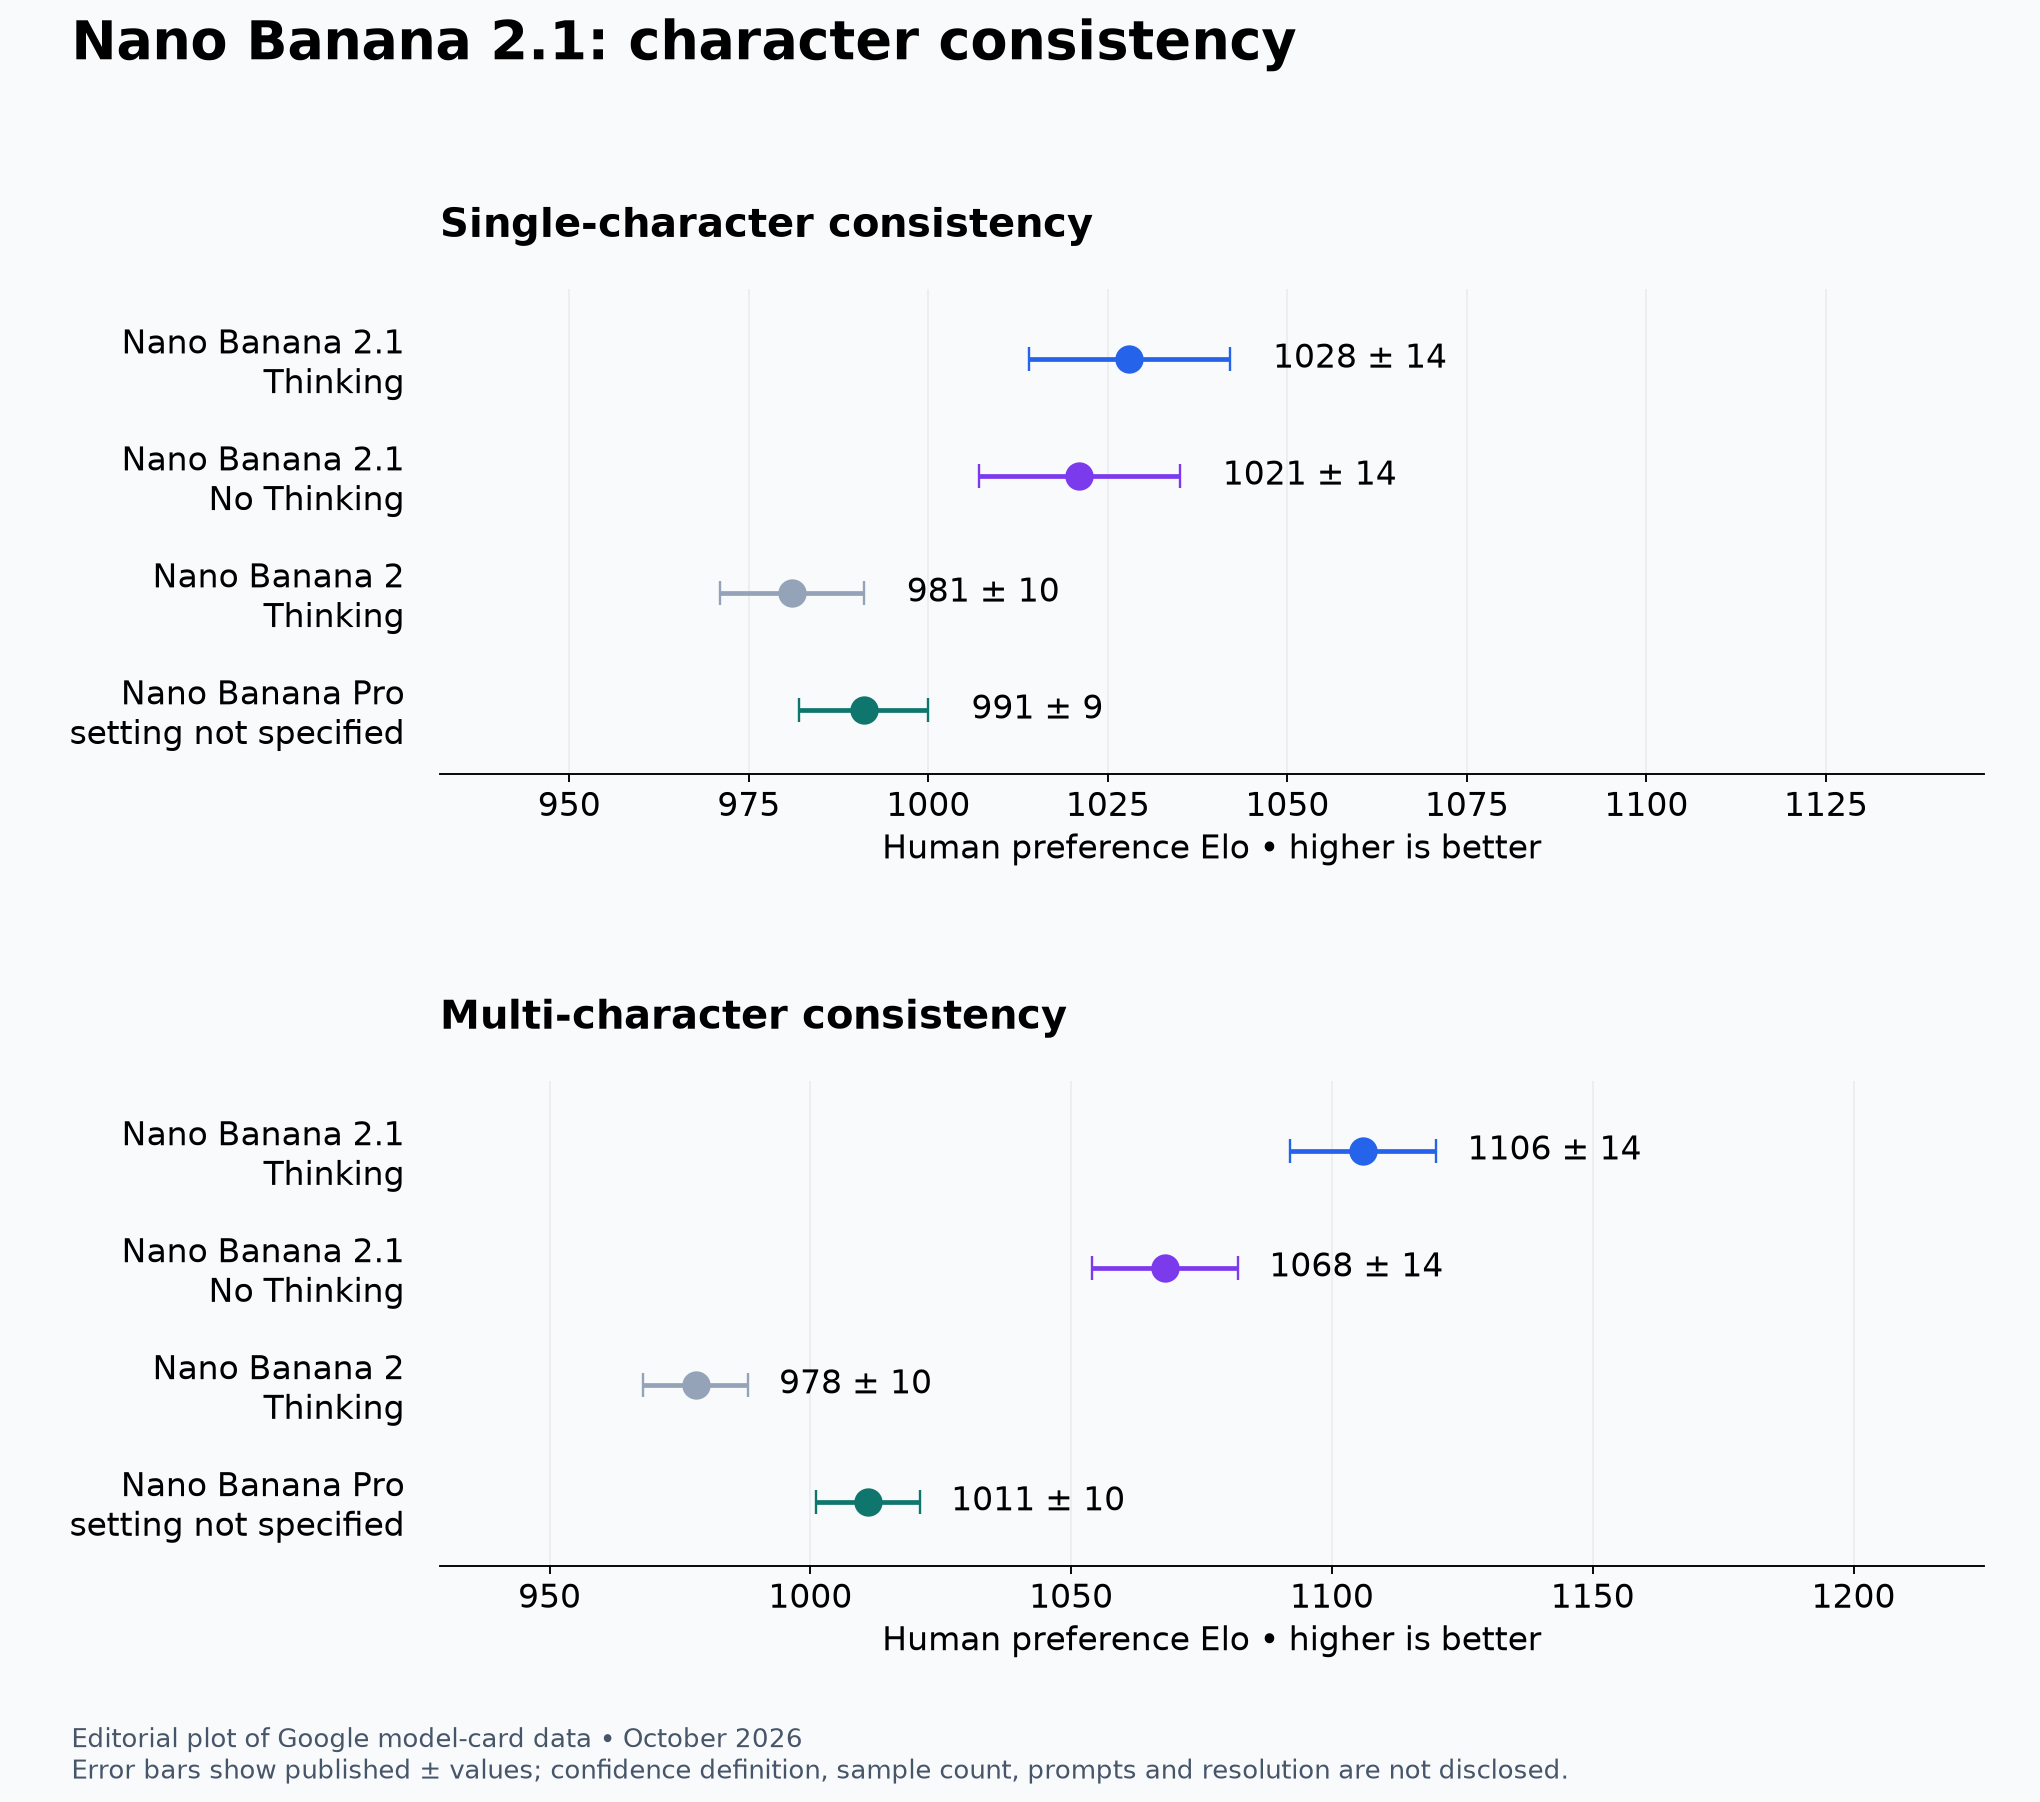
Représentation éditoriale du même jeu de données Google. Les marges publiées n’ont pas de définition de confiance précisée ; l’illustration n’est pas un original de Google.
Avec un seul personnage, 2.1 Thinking obtient 1028 ±14 et sans Thinking 1021 ±14, contre 981 ±10 pour Nano Banana 2 Thinking et 991 ±9 pour Pro. Les intervalles de 2.1 se chevauchent largement. Les sept points entre valeurs centrales ne justifient pas d’imposer le raisonnement à toute requête de ce type.
Avec plusieurs personnages, l’écart est plus marqué : 1106 ±14 avec Thinking, 1068 ±14 sans, 1011 ±10 pour Pro et 978 ±10 pour Nano Banana 2 Thinking. Les plages de 2.1 ne se superposent pas. Thinking devient un candidat plus intéressant pour maintenir plusieurs identités et leurs relations, sans garantir quatre personnages fiables pour toute combinaison de références.
Une belle image de groupe peut échanger des vêtements ou oublier quelqu’un. Le benchmark ne détaille pas dérive des visages, proportions modifiées, transfert de tenue, doublons ou erreurs de taille relative. La validation doit noter chaque sujet, surtout avec des références recadrées, contradictoires, inégalement éclairées ou visuellement proches. Un vote esthétique global peut masquer un défaut d’identité qui rend le visuel inutilisable.
La qualité d’une retouche dépend de ce qui doit rester intact
La retouche ne se résume pas non plus à « Thinking gagne ». Masques, fidélité du produit et combinaison de références protègent des éléments différents.
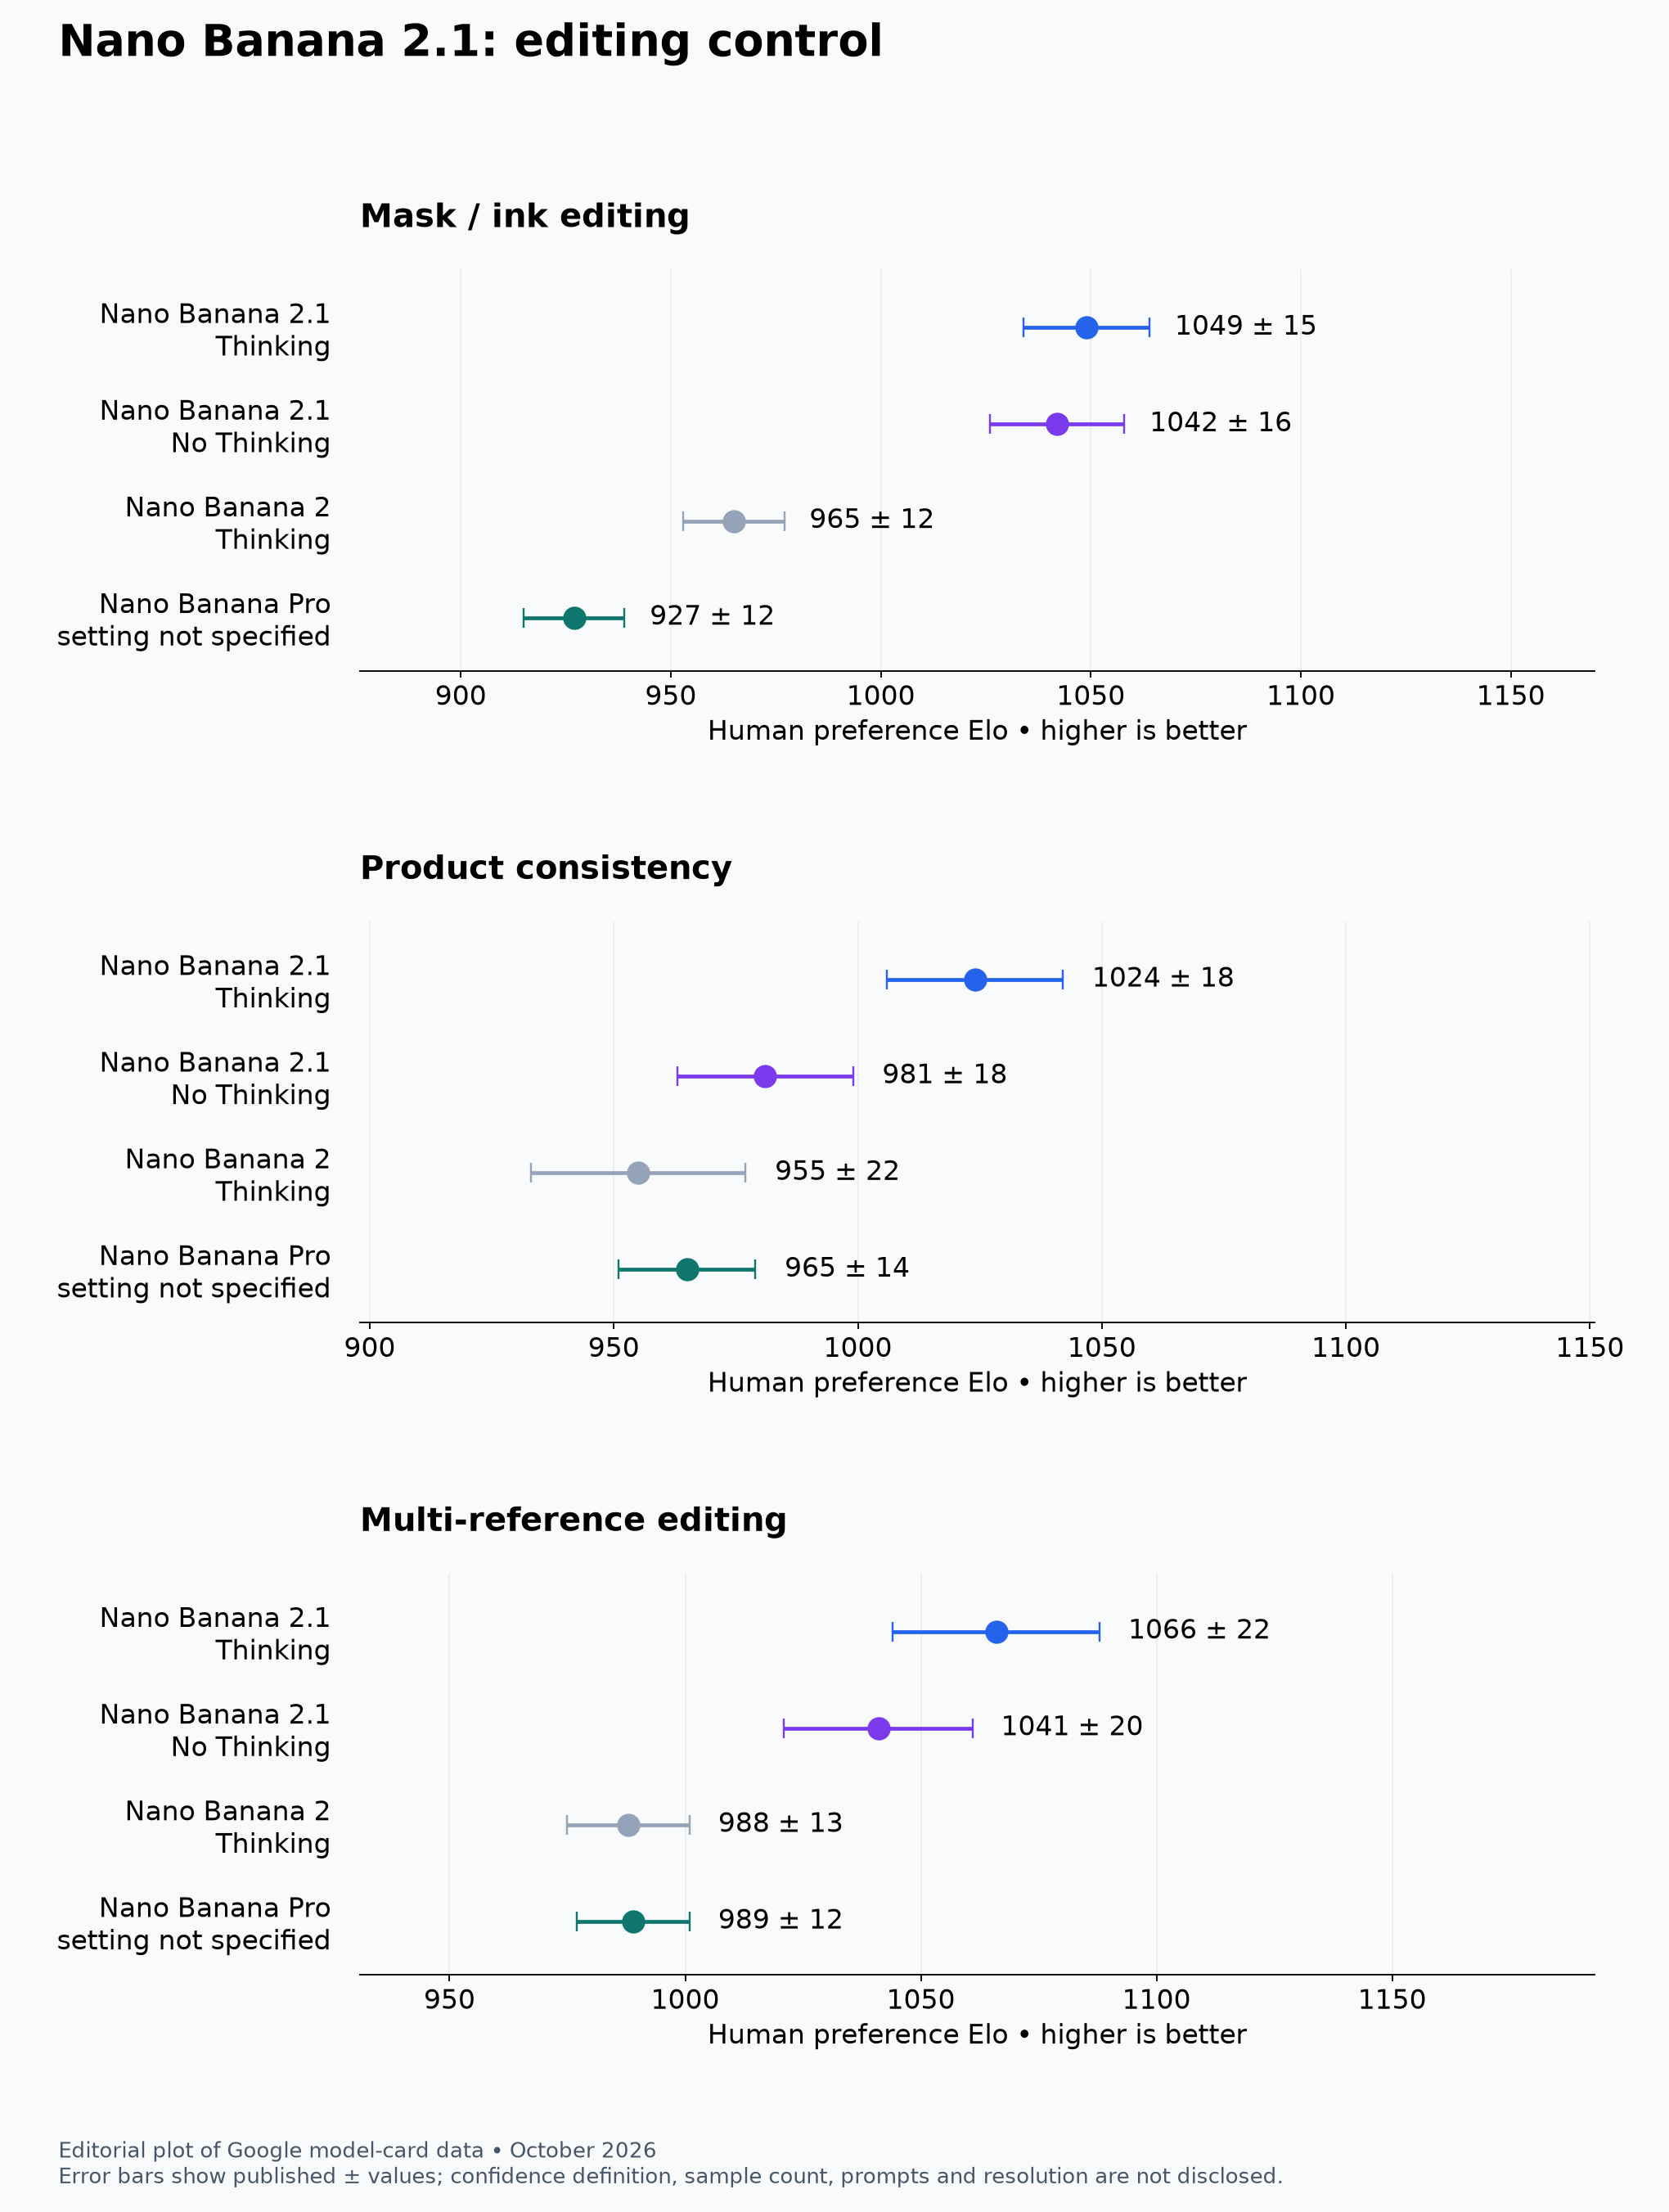
Graphique éditorial fondé sur la fiche Google, pas une création originale de Google. Elo et les marges ± ne mesurent ni l’obéissance exacte aux consignes ni l’immuabilité des pixels hors masque.
Pour les masques ou tracés, 2.1 Thinking atteint 1049 ±15 et sans Thinking 1042 ±16, avec un fort chevauchement. Les deux dépassent Nano Banana 2 Thinking à 965 ±12 et Pro à 927 ±12. Cela justifie de tester les deux modes 2.1, pas de transformer sept points centraux en avantage démontré du raisonnement.
La cohérence du produit est différente : Thinking obtient 1024 ±18, sans Thinking 981 ±18, Nano Banana 2 Thinking 955 ±22 et Pro 965 ±14. La plage sans Thinking croise les deux anciens modèles. Thinking est la configuration la plus forte de cette comparaison, mais toute configuration 2.1 n’améliore pas clairement la fidélité.
En multiréférence, 2.1 Thinking atteint 1066 ±22 et sans Thinking 1041 ±20, contre 988 ±13 et 989 ±12 pour Nano Banana 2 Thinking et Pro. 2.1 est plus fort, mais ses deux intervalles se recoupent ; l’écart central de 25 points ne vaut pas recommandation inconditionnelle.
Google reconnaît une application parfois partielle des masques, des résidus de tracés et le maintien inattendu de la pose initiale. Une retouche préférée peut échouer à préserver le contenu. En commerce, changer un port, un logo, une quantité, une matière ou un texte d’emballage peut invalider une belle image. Un montage créatif tolère des modifications géométriques interdites dans une documentation produit. Ce sont des critères d’acceptation distincts, pas des détails à noyer dans une moyenne.
Un score factuel de 0,521 ne signifie pas 52,1 % de justesse
La factualité des infographies utilise une autre mesure : un évaluateur automatique unilatéral, non les préférences humaines de génération. Google annonce 0,521 pour 2.1 Thinking, 0,328 sans Thinking, 0,265 pour Pro et 0,179 pour Nano Banana 2 Thinking.
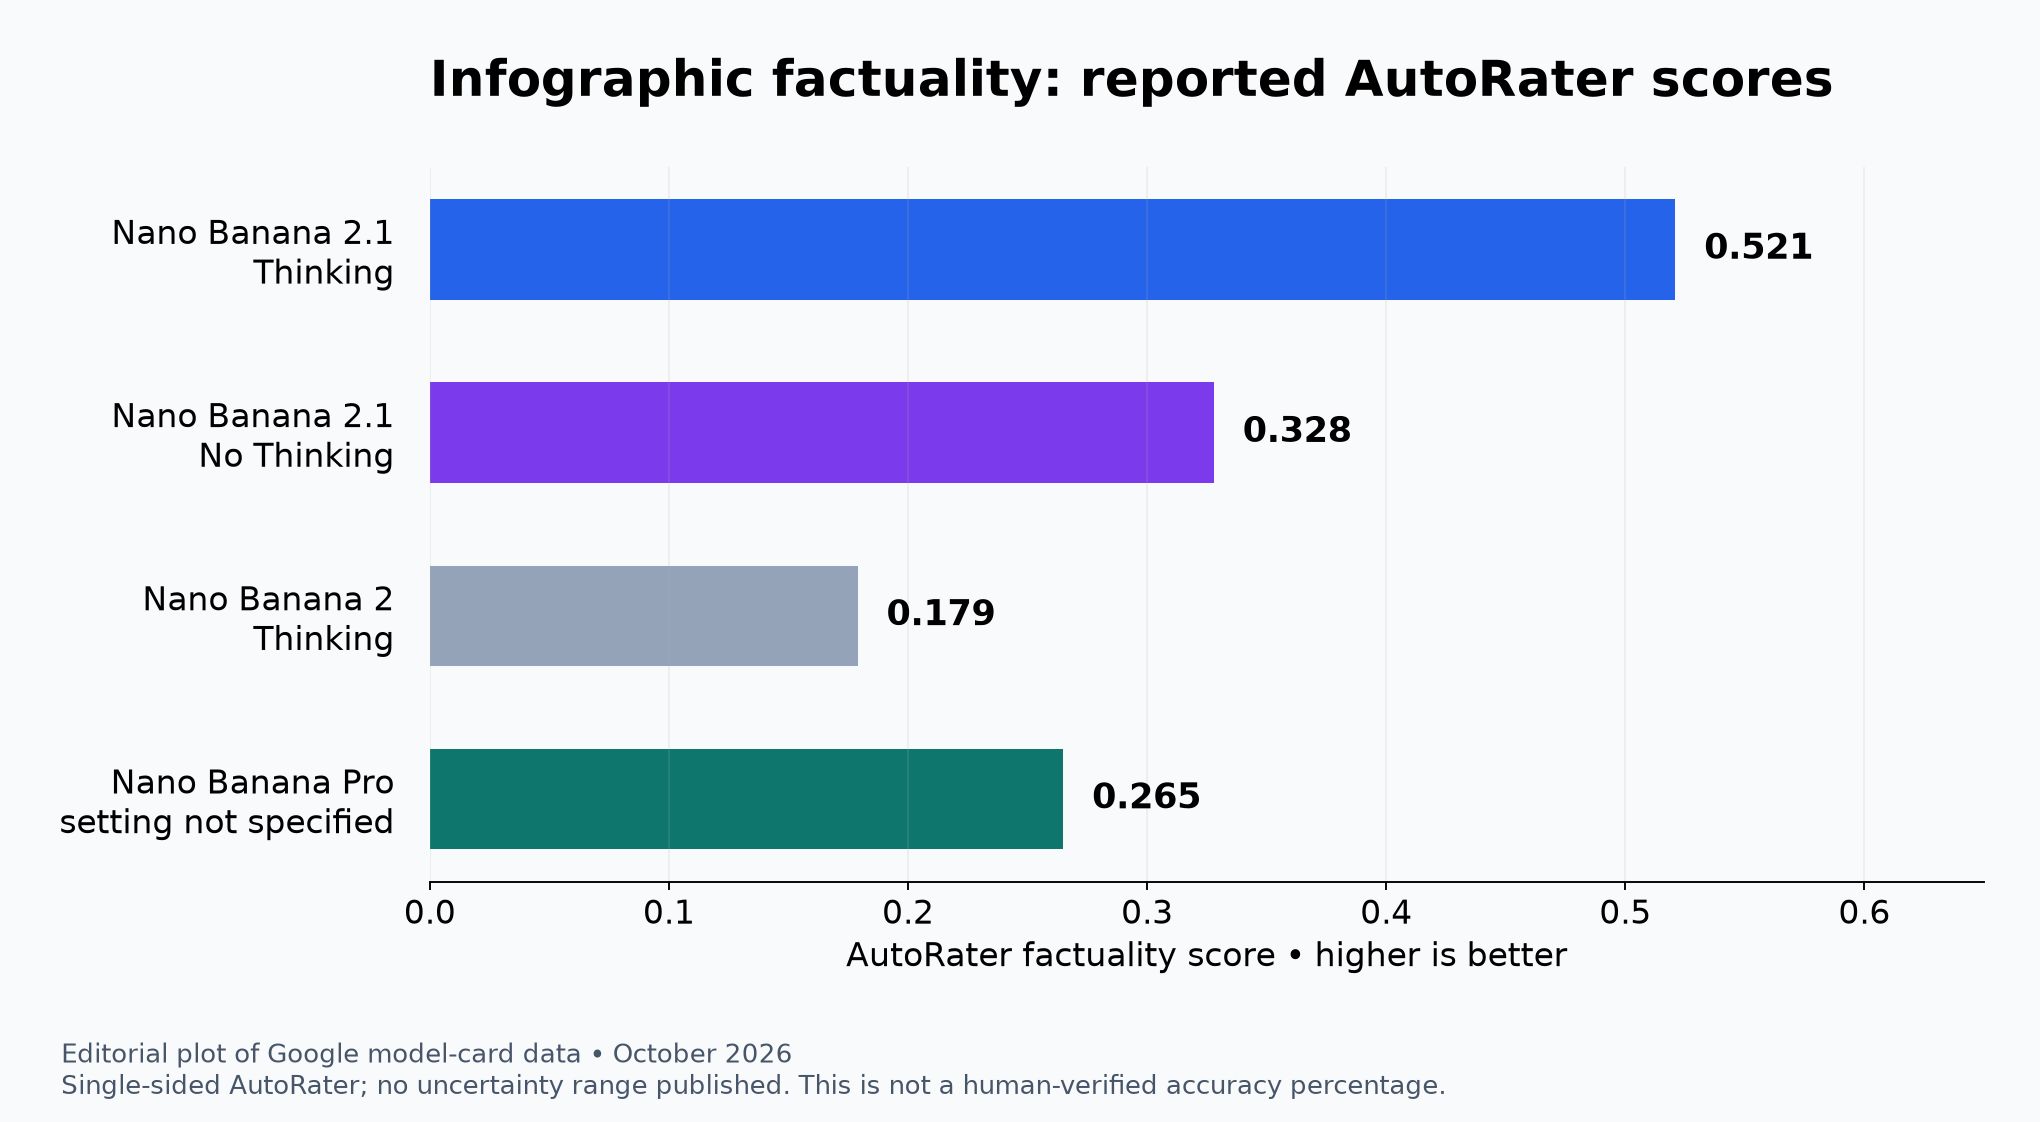
Graphique éditorial des évaluations automatiques de Google. Aucun intervalle d’incertitude n’est publié. Il ne s’agit ni d’un original Google ni de la proportion d’infographies factuellement correctes.
Thinking domine cet indicateur, mais la méthodologie, les échantillons et l’incertitude documentés ne permettent pas de calculer un taux d’erreur factuelle en production. Un graphique peut avoir un texte correct et tracer de mauvaises valeurs, une chronologie inverser des événements, une carte permuter des régions ou une étiquette désigner le mauvais objet. Le tableau public n’établit pas quels défauts l’évaluateur détecte de façon fiable.
L’ancrage par recherche peut fournir des informations sans garantir leur transcription visuelle. La fiche sous-jacente donne mars 2026 comme limite de connaissances, certains domaines pouvant s’arrêter à janvier 2025 et d’autres intégrer des informations plus récentes. Un visuel apparemment actuel exige toujours des faits fournis ou recherchés, puis une confrontation avec l’image finale.
L’unité de contrôle est une fiche factuelle : valeurs, unités, dates, étiquettes et citations approuvées avant génération, puis vérifiées dans le rendu. Les faits traçables et les dossiers de sources aident à distinguer preuve et présentation. Ils ne rendent pas l’image auto-vérifiante. Pour la médecine, la finance, le droit, les sciences et l’actualité, AutoRater ne doit pas devenir une autorisation de publier.
Une sortie moins chère ne garantit pas un visuel accepté moins cher
Les tarifs standard de l’API payante fixent la sortie image à 30 dollars par million de jetons pour 2.1 contre 60 pour Nano Banana 2. Les allocations différentes en 4K changent cette apparente division par deux.
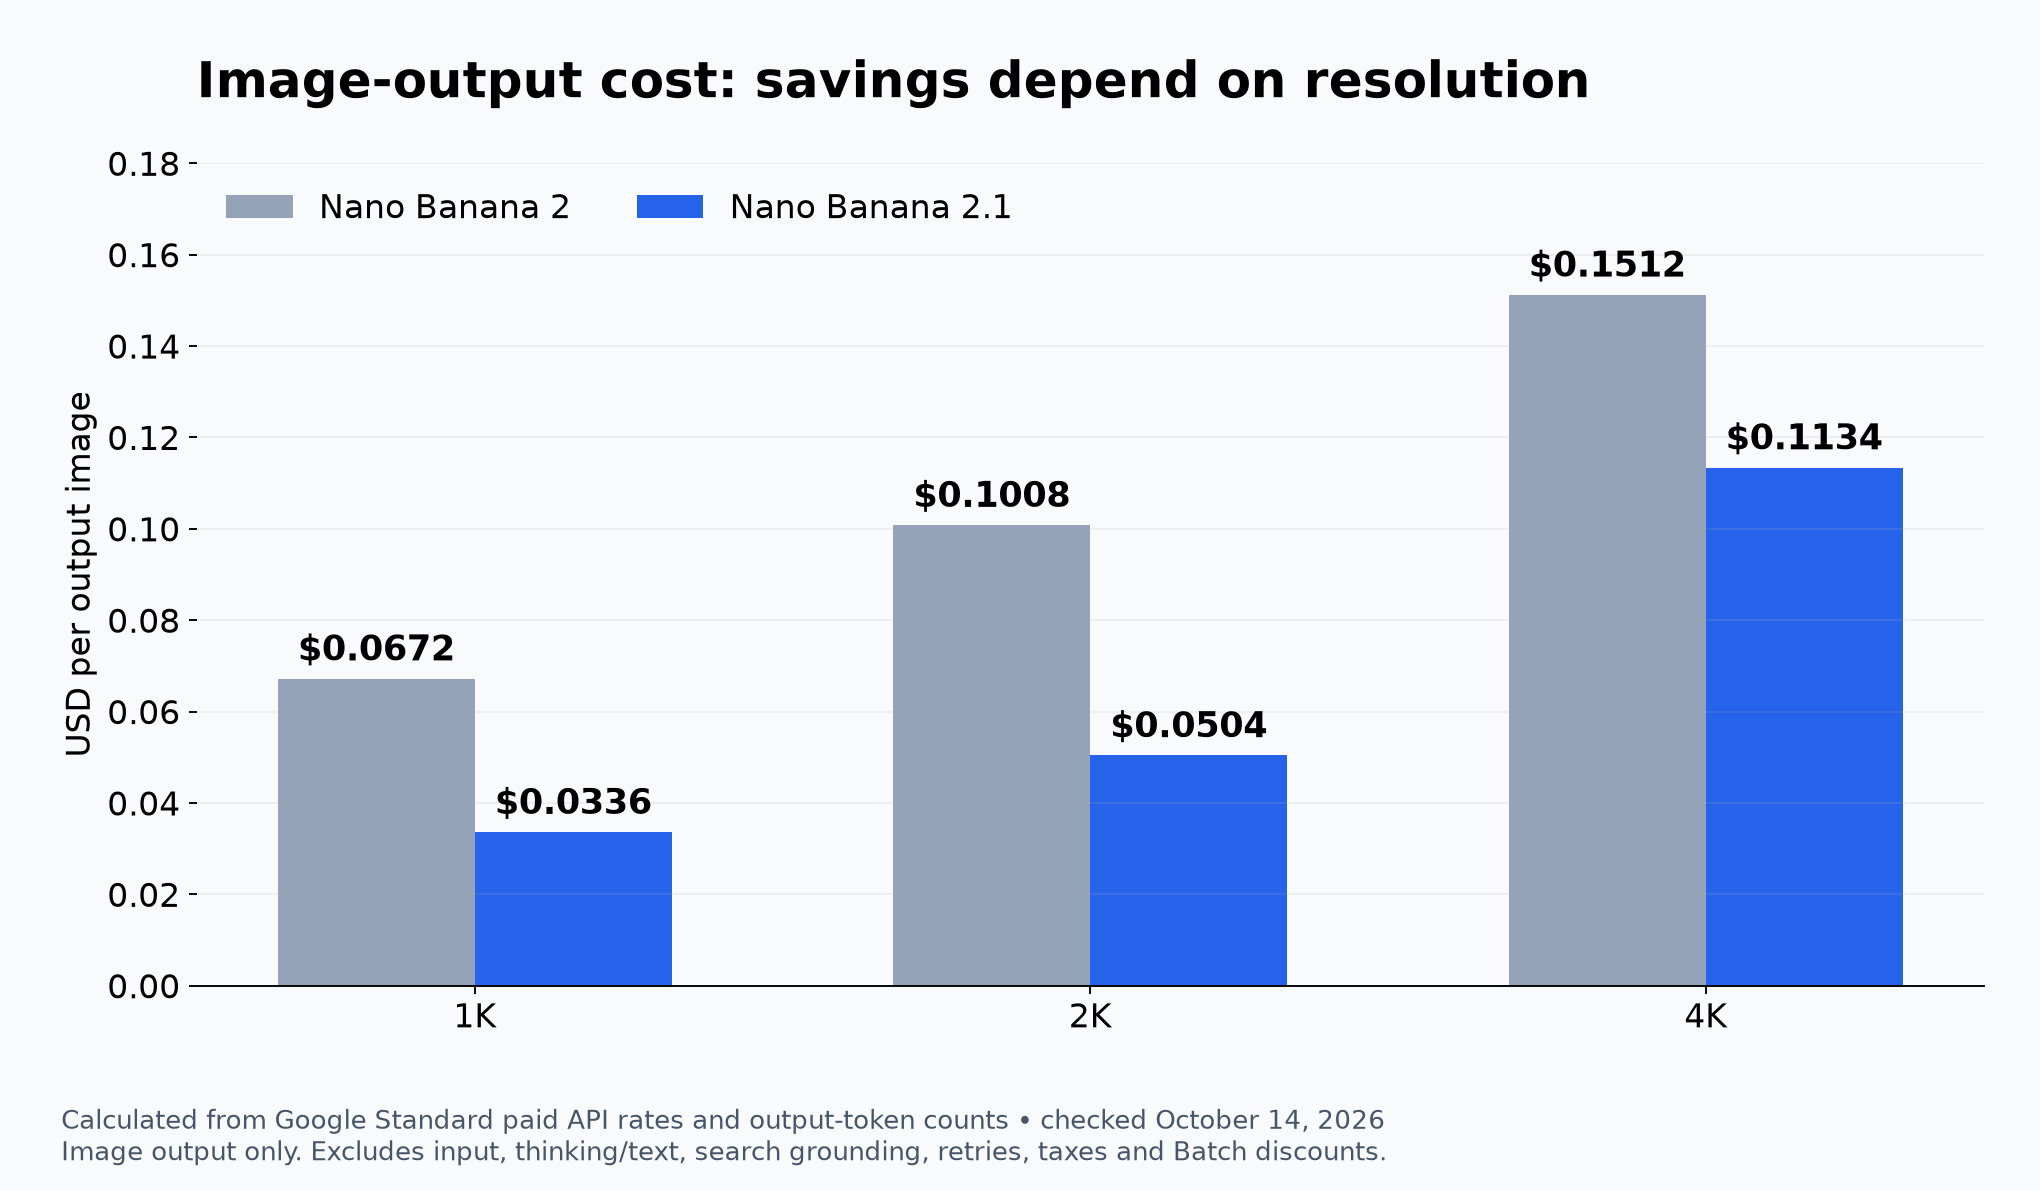
Calcul éditorial à partir des tarifs et allocations de Google publiés au 14 octobre. Ce ne sont pas des coûts totaux mesurés ni un graphique original de Google.
À 1K, les deux utilisent 1120 jetons image : 0,0336 dollar pour 2.1, contre 0,0672 pour Nano Banana 2. À 2K, 1680 jetons reviennent à 0,0504 contre 0,1008 dollar. La sortie seule baisse bien de 50 %.
À 4K, 2.1 indique 3780 jetons, Nano Banana 2 seulement 2520. Avec les tarifs respectifs, on obtient 0,1134 contre 0,1512 dollar : 25 %, et non 50 %, d’économie. Une hausse du nombre de jetons empêche le prix unitaire divisé par deux de diviser le prix de l’image par deux.
D’autres postes augmentent. L’entrée standard texte, image ou vidéo de 2.1 coûte 1,50 dollar par million de jetons, contre 0,50 pour texte ou image dans Nano Banana 2. La sortie texte et Thinking coûte 7,50 contre 3 dollars. Ancrage, références, texte, raisonnement, nouvelles tentatives, taxes et éventuelles remises Batch modifient la facture totale.
Sans hypothèses sur ces volumes, aucun total « typique » n’est défendable. Un meilleur taux d’acceptation au premier essai peut compenser le raisonnement ; davantage d’essais peuvent absorber les économies. La bonne mesure est le coût par visuel accepté, avec latence et taux d’expiration mesurés, non un tarif de sortie isolé.
Migrer exige des comparaisons appariées
Un test utile donnerait les mêmes prompts réels et fichiers de référence au modèle actuel et aux niveaux Thinking disponibles de 2.1, à ratio, résolution et budget d’essais constants. C’est une proposition d’évaluation, pas un test réalisé par AI Tools Radar. Pro ne doit être inclus que s’il est réellement déployable ; ses paramètres non précisés dans le benchmark ne peuvent être supposés équivalents.
Il faut distinguer un ou plusieurs personnages, produits, masques, compositions de références, mises en page textuelles et graphiques factuels. Le texte exact peut être transcrit et comparé ; les masques nécessitent des contrôles dans et hors zone autorisée ; les produits, des caractéristiques protégées. Des préférences en aveugle complètent ces tests, sans remplacer l’exactitude d’un logo ou d’un chiffre invariable.
Conserver résultats appariés et incertitude évite de réduire des risques différents à une moyenne. Les relevés doivent inclure latence de bout en bout, expirations, essais, jetons consommés et coût par image acceptée. Une phase en parallèle de la production montre si l’avantage du benchmark réduit effectivement les corrections.
Aucune source n’étaye un arrêt le 29 octobre qui imposerait une bascule précipitée. La référence de dépréciation classe Gemini 3.1 Flash Image comme déprécié, sans date de fermeture annoncée. Elle ne promet pas non plus une disponibilité illimitée.
Les premiers cas les plus solides sont les infographies, plusieurs personnages récurrents, les compositions de références et le moindre tarif de sortie. Thinking mérite une attention particulière pour les multiples identités et les faits ; les résultats qui se recoupent laissent ailleurs une place aux configurations simples. Si petits caractères, faits, identité exacte ou zones produit intactes sont obligatoires, garder validation externe et solution de repli jusqu’à satisfaction des exigences. La première place publiée invite à comparer ; elle ne remplace pas cette comparaison.