
Nano Banana 2.1 ofrece dos ventajas distintas a los equipos de producción visual: mejores resultados en las comparaciones de Google y menores tarifas para los tokens de imagen generada. Ninguna demuestra por sí sola que un recurso listo para publicar resulte más barato. La cuestión es si las ventajas medidas sobreviven a las exigencias reales de identidad, exactitud factual, detalles protegidos del producto y coste total de los reintentos.
Este análisis del 14 de octubre sigue al lanzamiento general de Google del 6 de octubre, no a un nuevo estreno ese mismo día. Sus señales más fuertes aparecen en preferencia por infografías, consistencia de varios personajes y algunas ediciones. La lectura más débil sería convertir una puntuación de preferencia en precisión, suponer que Thinking beneficia por igual a todas las tareas o describir cualquier solicitud como de mitad de precio.
El endpoint real tiene límites más estrechos que la ficha
El registro de cambios de la API identifica gemini-nano-banana-2.1 como modelo estable. Google lo describe como una actualización de clase Flash de Gemini 3.1 Flash Image, también llamado Nano Banana 2, no como un nuevo Pro. La ficha del modelo lo sitúa sobre Gemini 3.6 Flash: recibe texto e imágenes y devuelve imágenes y texto.
Las condiciones de implementación importan tanto como ese parentesco. La documentación del endpoint establece salida 1K por defecto y hasta 4K. Thinking ofrece minimal, medium y high, con medium preseleccionado. Admite fundamentación mediante búsqueda, pero no llamadas a funciones, ejecución de código ni salidas estructuradas. Las aplicaciones que necesiten esas capacidades deben aportar orquestación y comprobaciones fuera del modelo visual.
Hay además una discrepancia de capacidad sin explicar. La ficha describe hasta un millón de tokens de contexto y 64K de salida textual, mientras que la página de Gemini API indica 131.072 de entrada y 32.768 de salida. Las fuentes no explican la relación. Un despliegue debe planificarse según el límite publicado de su endpoint concreto, sin asumir disponibles las cifras arquitectónicas superiores.
La fusión admite hasta 14 imágenes de referencia, incluidas hasta cuatro personas o personajes y diez objetos. Son techos de entrada, no garantías de conservar con fidelidad catorce referencias o cuatro identidades independientes.
La ficha también enumera texto pequeño o largo borroso o defectuoso, deriva de identidad, confusión izquierda-derecha, razonamiento 3D y conocimiento factual imperfectos, además de lentitud y tiempos de espera agotados ocasionales. Residuos de máscara y poses persistentes añaden riesgos de edición. Estas limitaciones reconocidas necesitan criterios de fallo y alternativa; más referencias o contexto no las eliminan.
La ventaja de generación mide preferencia, no corrección
Google compara preferencias humanas con Elo. No cuenta el porcentaje de imágenes correctas. Los intervalos ± publicados orientan, pero no se define su nivel de confianza. Tampoco se revelan muestras, prompts, resoluciones, presupuestos de reintento, configuración exacta de Thinking ni condiciones de cómputo equivalente.
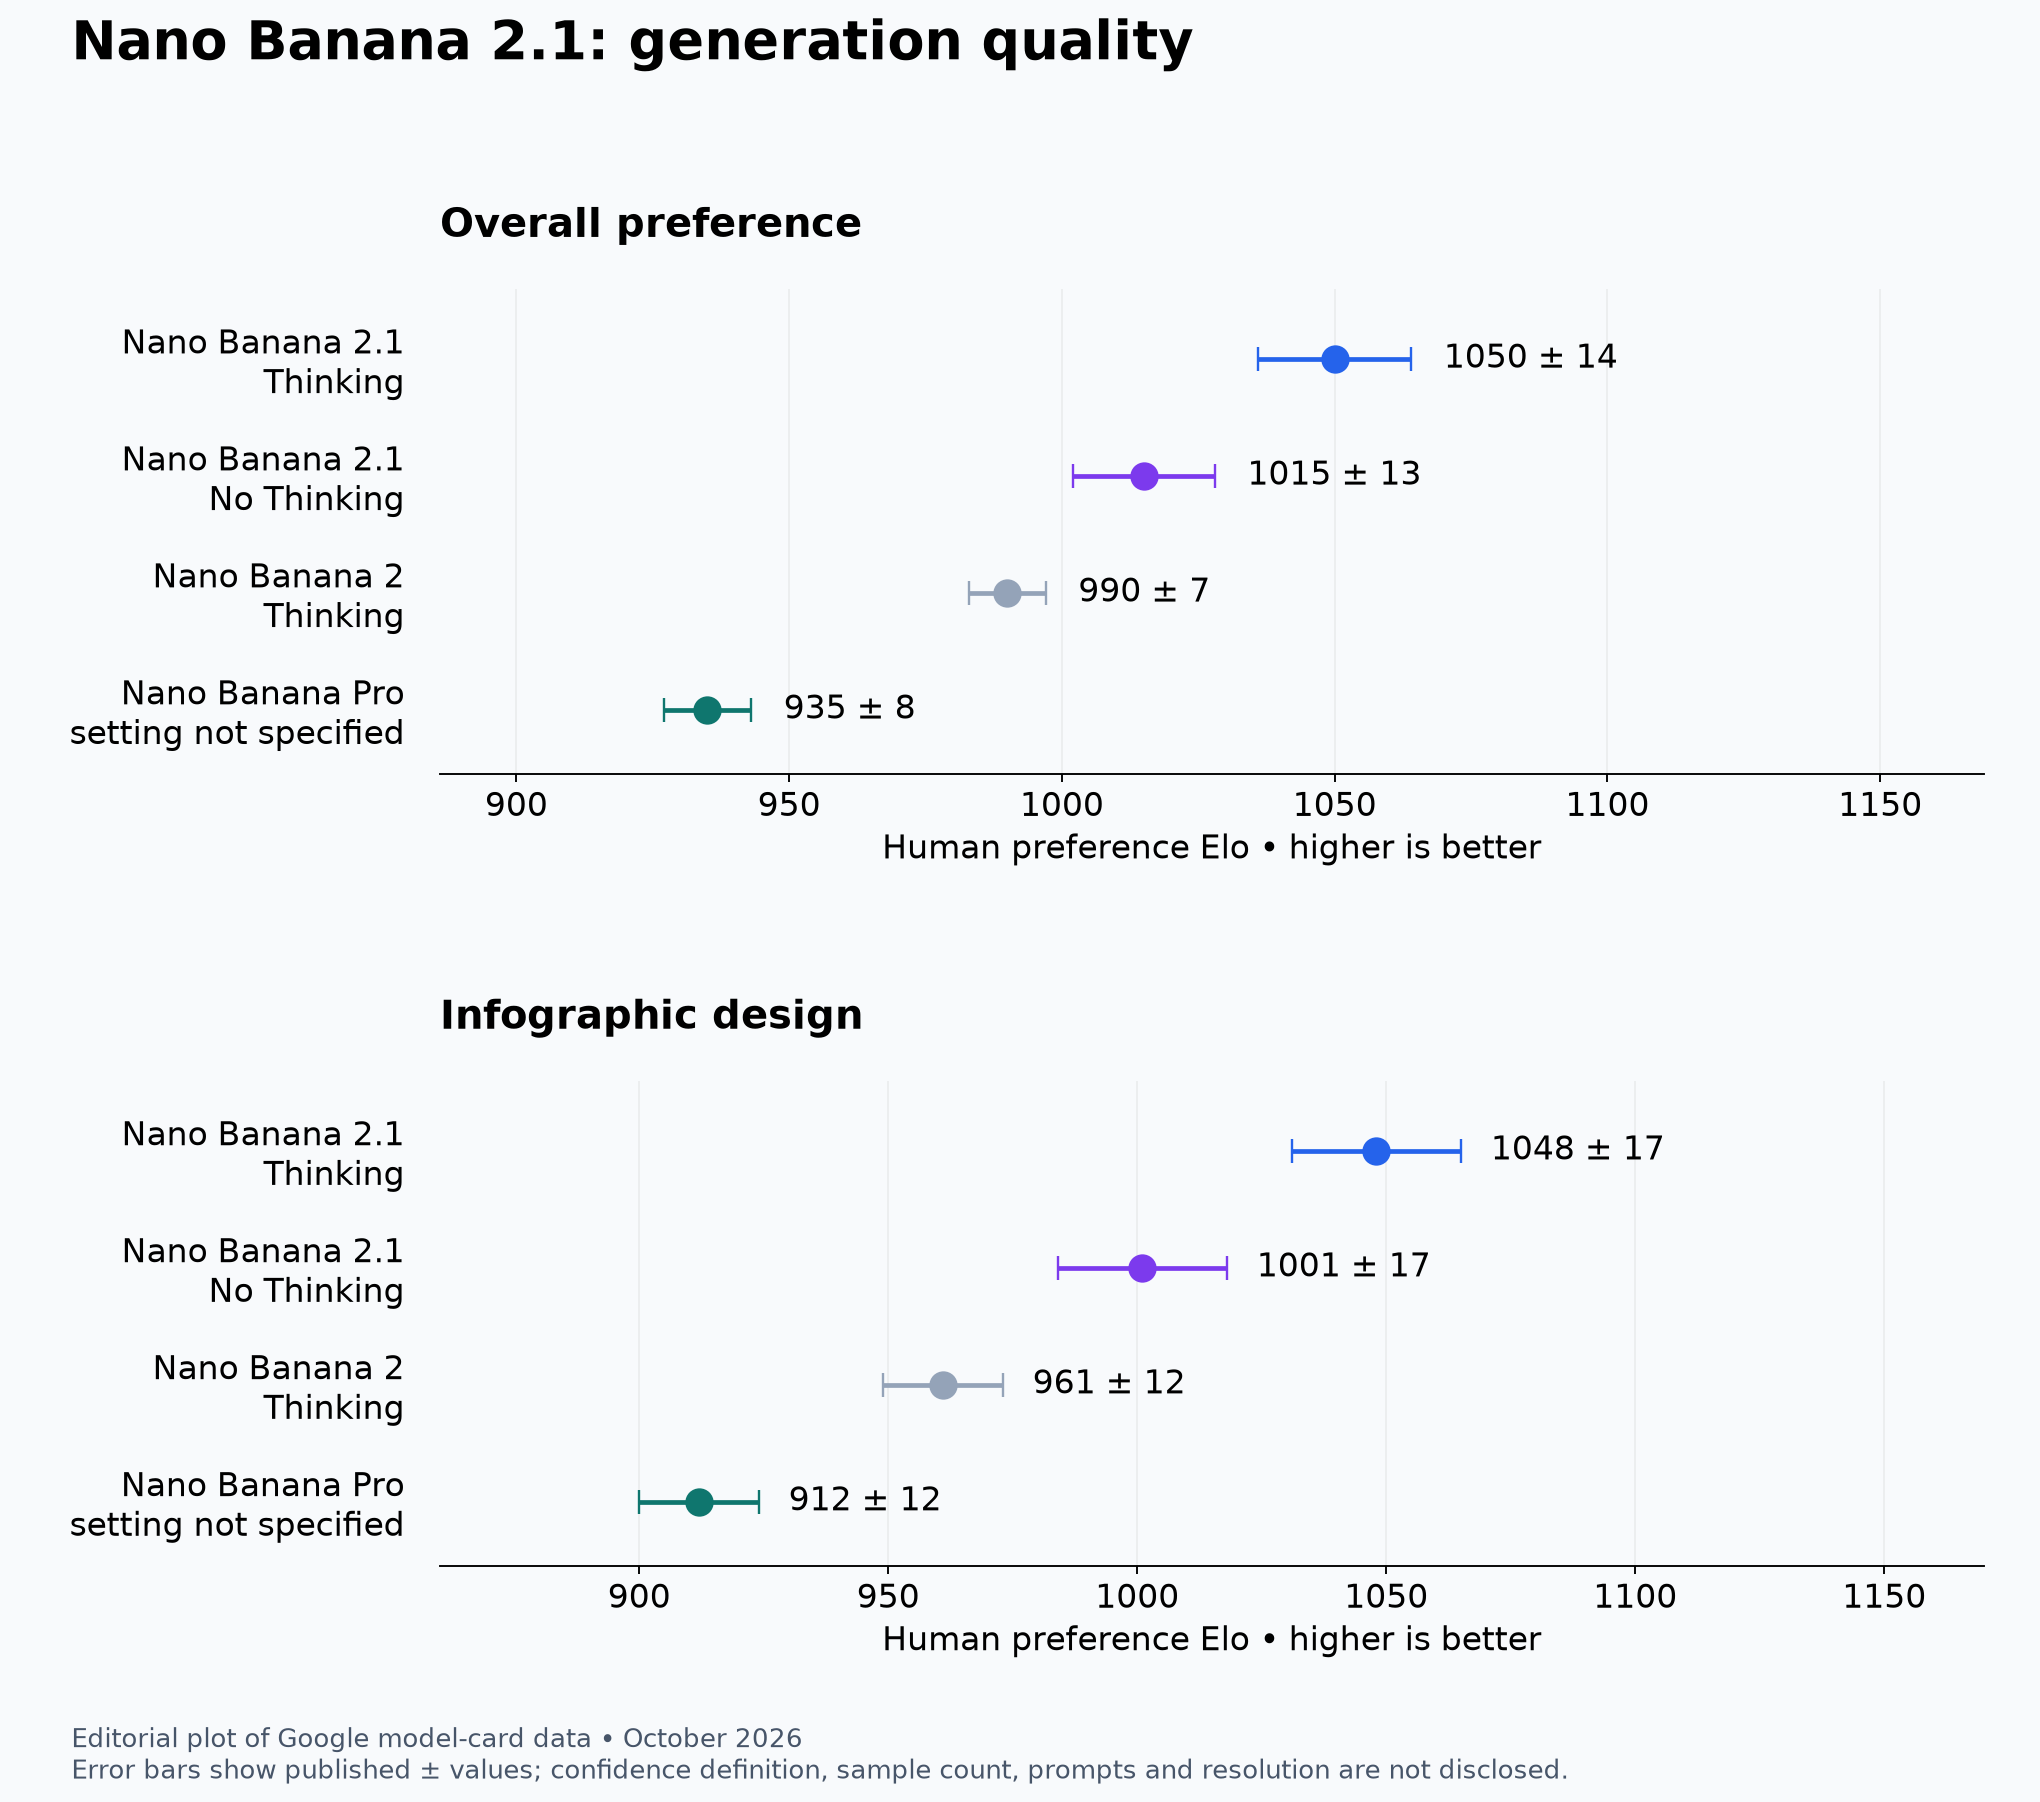
Gráfico editorial de los datos de la ficha de Google de octubre de 2026, no una imagen original de Google. Las barras reproducen los intervalos publicados, sin establecer su confianza ni una precisión de producción.
En generación general, 2.1 Thinking obtiene 1050 ±14; sin Thinking, 1015 ±13; Nano Banana 2 Thinking, 990 ±7; y Pro, 935 ±8. En diseño de infografías, el mismo orden da 1048 ±17, 1001 ±17, 961 ±12 y 912 ±12. Incluso considerando los intervalos mostrados, ambas modalidades 2.1 superan el resultado de Nano Banana 2 en infografías.
El intervalo general con Thinking, 1036–1064, no se solapa con 1002–1028 sin él. En infografías se tocan en 1031. La primera comparación distingue más, pero ninguna demuestra un efecto de igual tamaño para cada prompt. La etiqueta genérica «Thinking» tampoco equivale necesariamente al nivel high de la API: no se publica la configuración evaluada.
Esto impide un atajo operativo. Liderar en preferencia no prueba menos reintentos, menor latencia ni etiquetas correctas. Google no presenta aquí latencias del benchmark. Los equipos creativos tienen motivos para probar 2.1, sobre todo en composición y diseño, pero no para inventar una mejora universal de velocidad o rentabilidad.
Varios personajes cambian el cálculo de Thinking
Una persona recurrente y una escena con varias identidades son cargas diferentes. Los resultados de consistencia muestran esa diferencia.
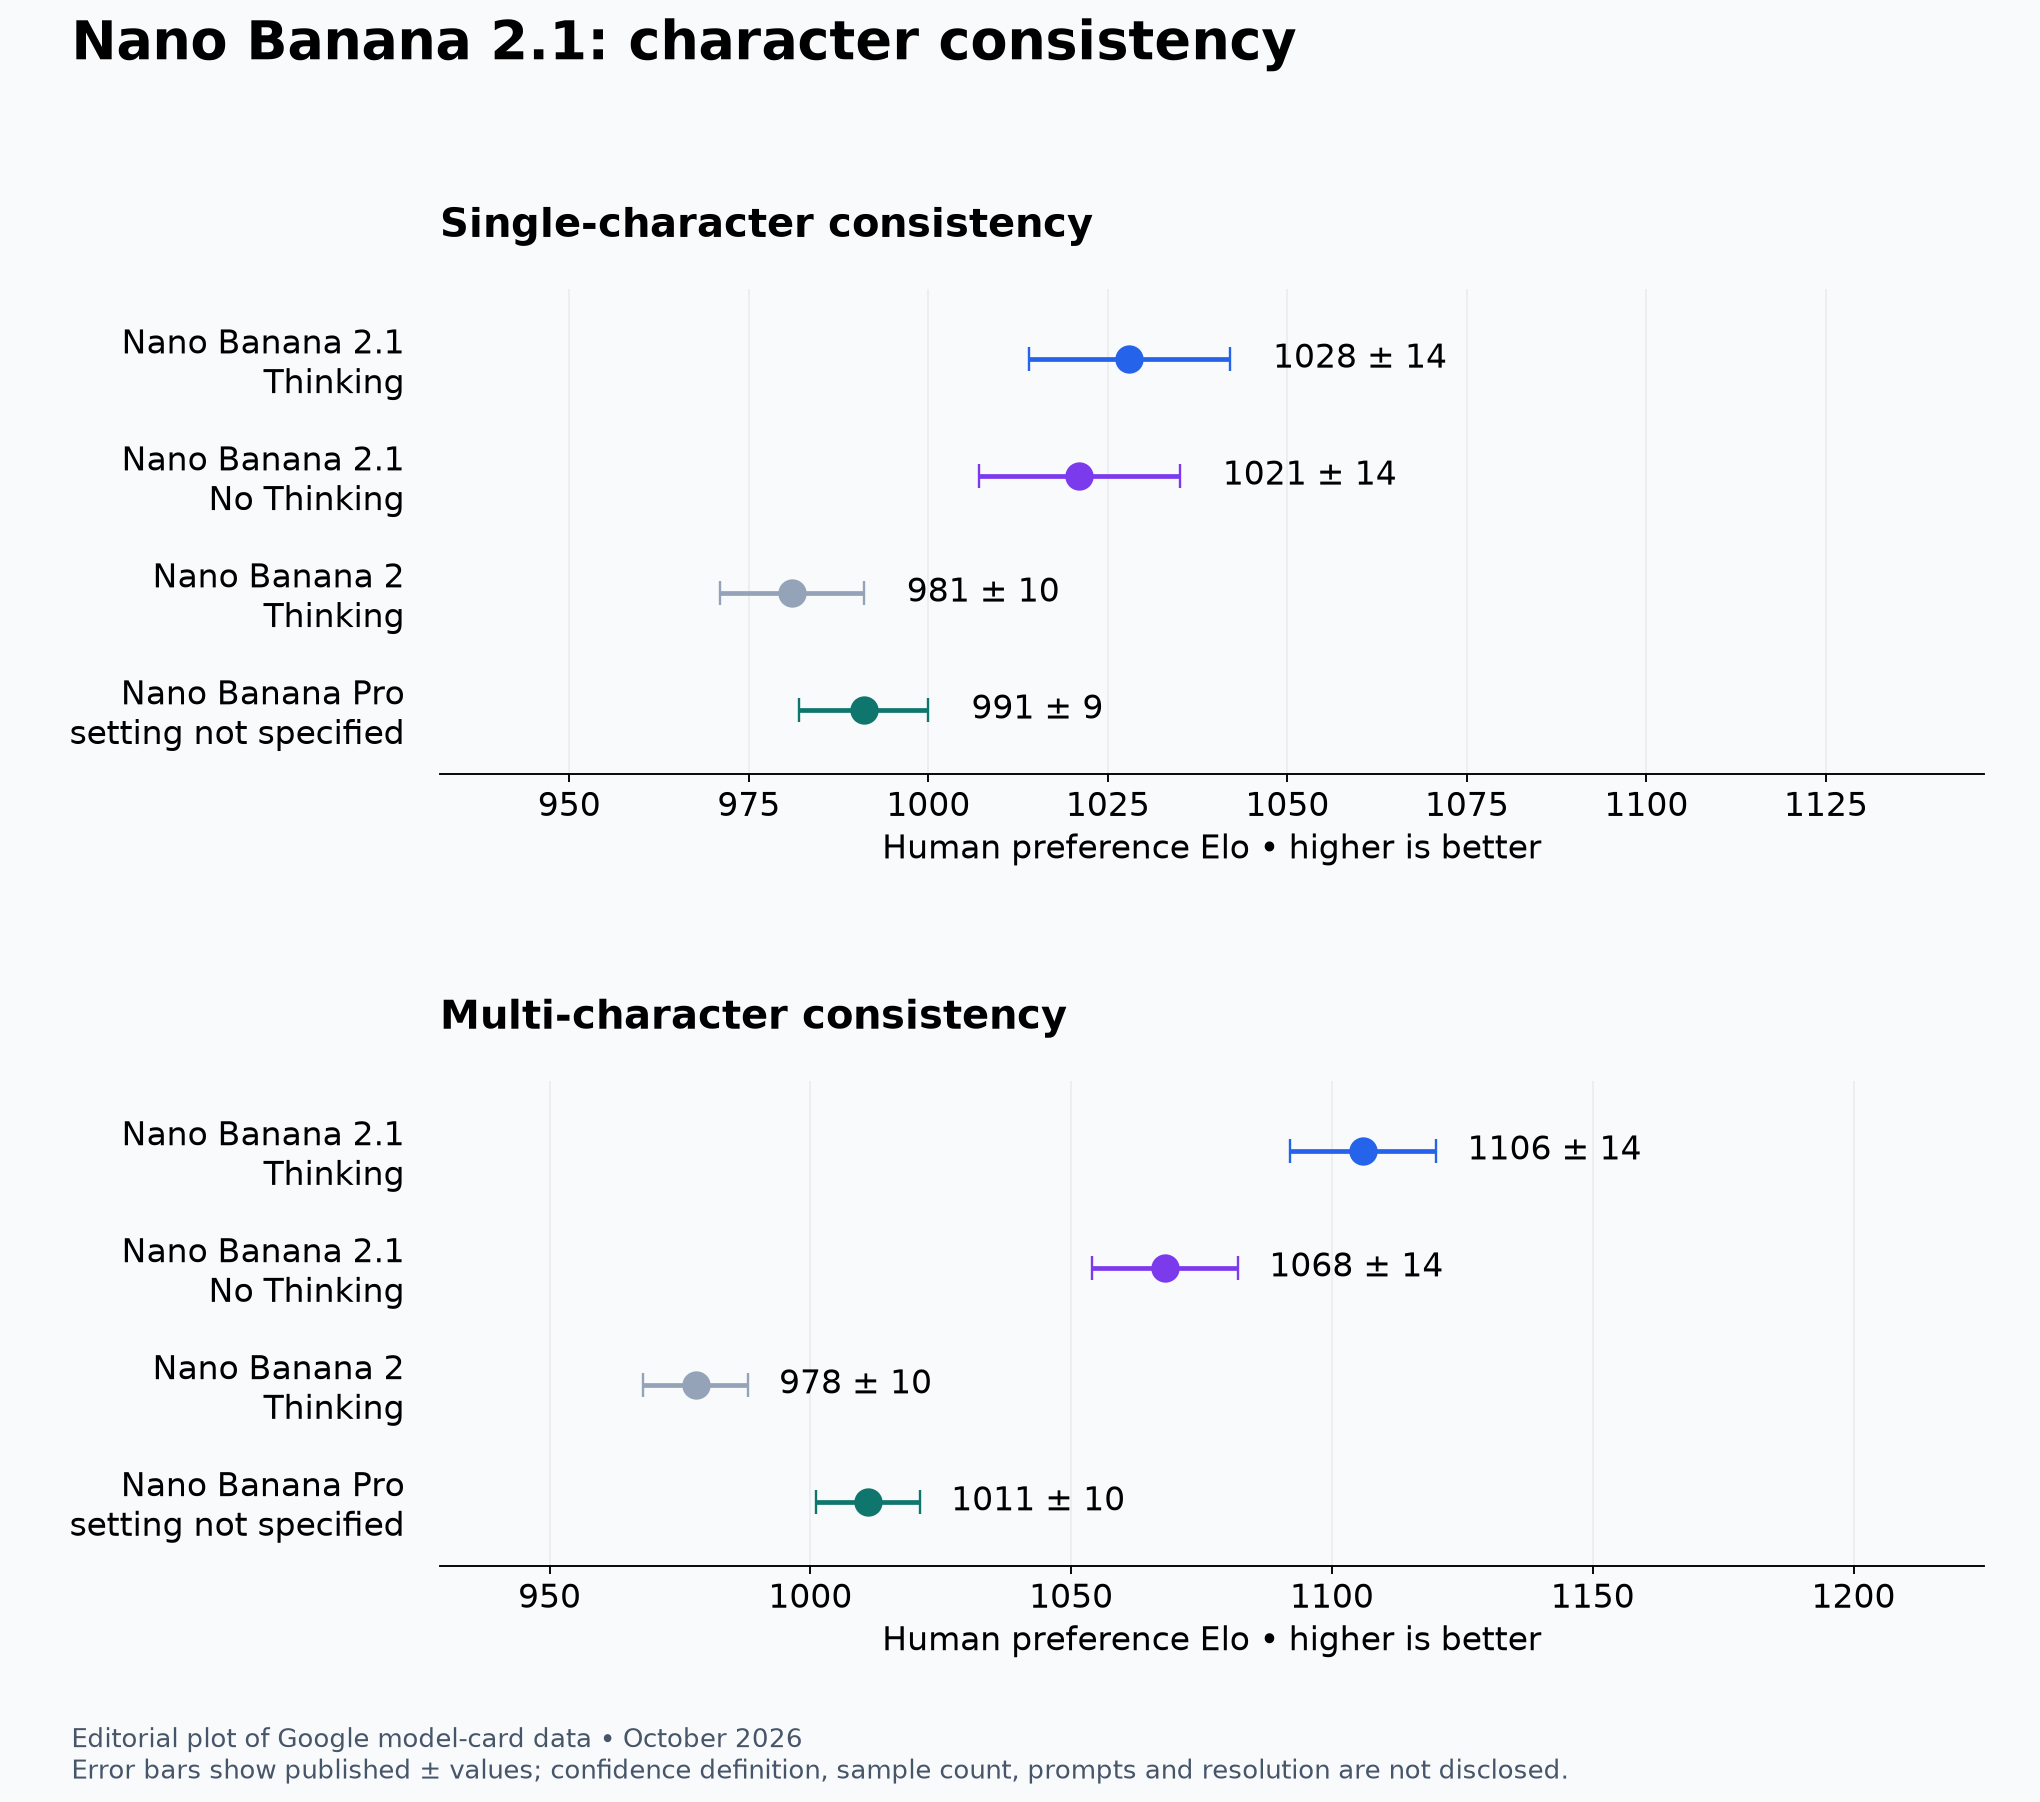
Representación editorial del mismo conjunto de datos de Google. Los intervalos publicados carecen de definición de confianza y la ilustración no es original de Google.
Para un personaje, 2.1 Thinking alcanza 1028 ±14 y sin Thinking 1021 ±14, frente a 981 ±10 de Nano Banana 2 Thinking y 991 ±9 de Pro. Los intervalos de 2.1 se solapan ampliamente. Siete puntos entre valores centrales no justifican exigir razonamiento en toda solicitud de un solo personaje.
Con varios personajes, la distancia es mayor: 1106 ±14 con Thinking, 1068 ±14 sin él, 1011 ±10 de Pro y 978 ±10 de Nano Banana 2 Thinking. Los intervalos de 2.1 no se solapan. Thinking resulta más prometedor cuando deben mantenerse varias identidades y sus relaciones, pero eso no demuestra fiabilidad para cuatro personas con cualquier combinación de referencias.
Una imagen grupal atractiva puede intercambiar vestuario u omitir a alguien. El benchmark no desglosa cambios de rostro o proporciones, transferencia de ropa, duplicaciones ni errores de estatura relativa. La revisión debe valorar cada sujeto, especialmente con referencias recortadas, contradictorias, de iluminación desigual o de personas parecidas. Un voto estético global puede ocultar un fallo de identidad que invalide el recurso.
La edición depende de lo que no debe cambiar
Tampoco cabe resumir la edición en «Thinking gana». Máscaras, fidelidad de producto y combinación de referencias protegen elementos distintos.
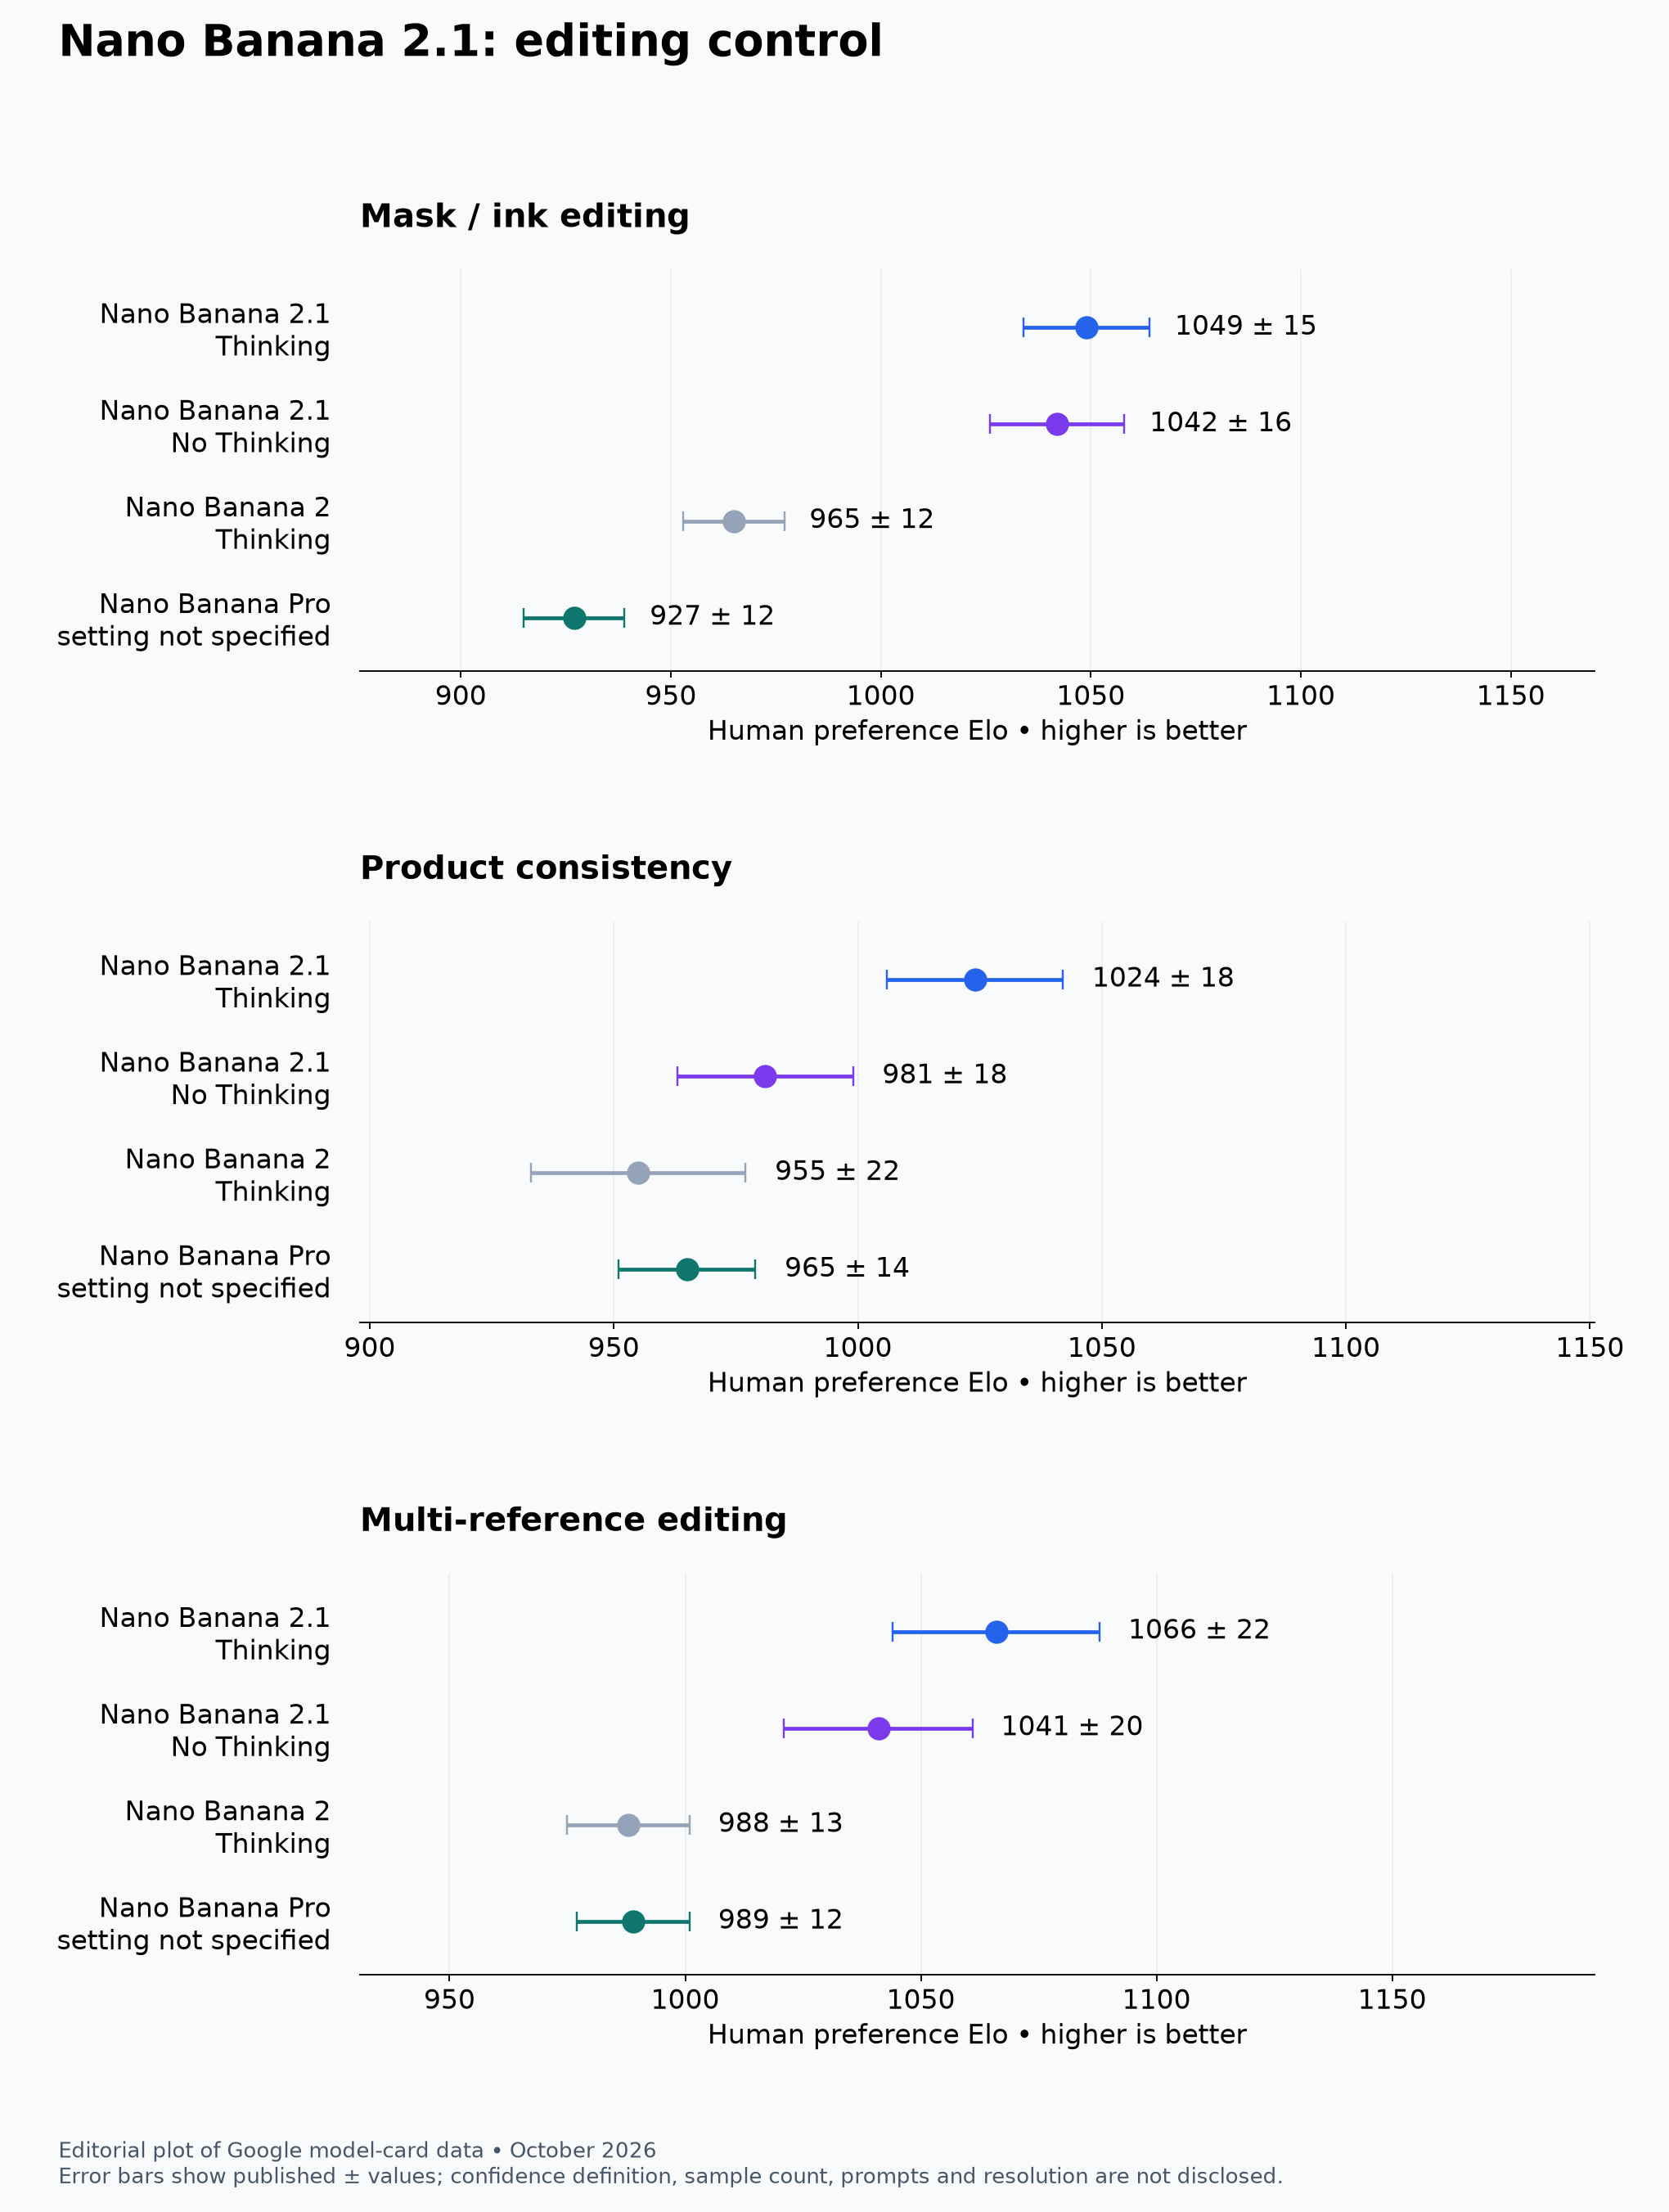
Gráfico editorial basado en la ficha de Google, no una obra original suya. Elo y los intervalos ± no miden cumplimiento exacto de instrucciones ni píxeles intactos fuera de una máscara.
En edición por máscara o trazos, 2.1 Thinking marca 1049 ±15 y sin Thinking 1042 ±16, con gran solapamiento. Ambos superan 965 ±12 de Nano Banana 2 Thinking y 927 ±12 de Pro. La evidencia aconseja probar las dos opciones 2.1, no convertir siete puntos centrales en una ventaja demostrada del razonamiento.
En consistencia de producto, Thinking alcanza 1024 ±18; sin él, 981 ±18; Nano Banana 2 Thinking, 955 ±22; y Pro, 965 ±14. El intervalo sin Thinking se cruza con los dos anteriores. Thinking es la configuración más fuerte de esta comparación, pero no está probado que toda configuración 2.1 mejore claramente la fidelidad.
En edición multirreferencia, 2.1 Thinking obtiene 1066 ±22 y sin él 1041 ±20, frente a 988 ±13 de Nano Banana 2 Thinking y 989 ±12 de Pro. 2.1 destaca, pero sus propios intervalos se solapan: los 25 puntos centrales no sustentan una recomendación incondicional.
Google reconoce instrucciones de máscara seguidas solo parcialmente, restos de tinta y conservación inesperada de la pose original. Una edición preferida puede incumplir la preservación. En comercio electrónico, cambiar un puerto, logotipo, cantidad, material o texto del envase puede invalidar una imagen atractiva. Una composición creativa admite alteraciones geométricas que la documentación de producto no permite. Son criterios de aceptación separados, no detalles que promediar en una nota de edición.
Una factualidad de 0,521 no significa un 52,1% correcto
La factualidad de infografías se mide de otro modo: con un evaluador automático unilateral, no con las preferencias humanas de generación. Google comunica 0,521 para 2.1 Thinking, 0,328 sin él, 0,265 para Pro y 0,179 para Nano Banana 2 Thinking.
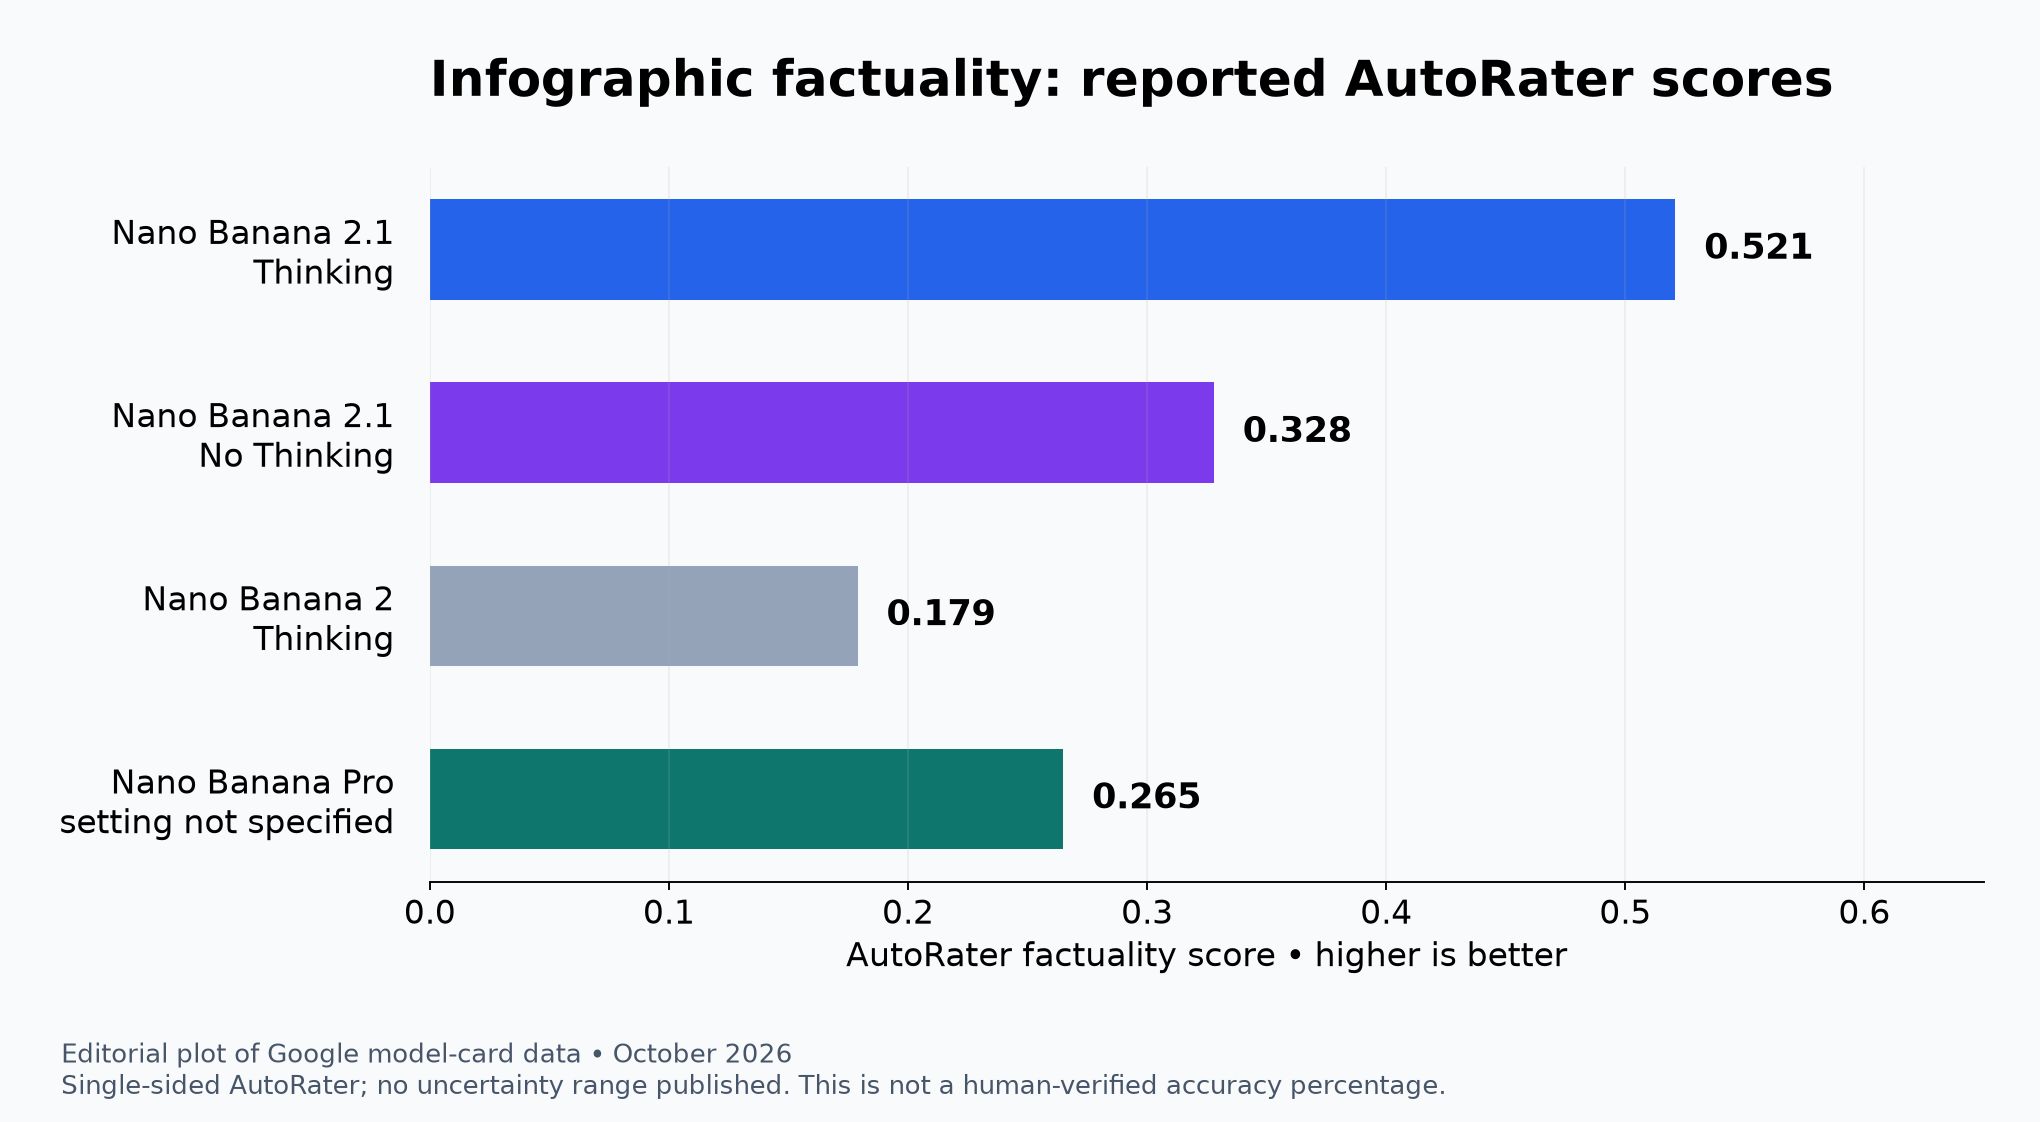
Gráfico editorial de la evaluación automática de Google. No se publican intervalos de incertidumbre. No es una imagen original de Google ni el porcentaje de infografías factualmente correctas.
Thinking lidera ese indicador, pero la ficha no aporta metodología, muestras e incertidumbre suficientes para calcular una tasa real de error factual. Un gráfico puede tener prosa correcta y valores mal representados; una cronología, acontecimientos invertidos; un mapa, regiones intercambiadas; o una etiqueta, el objeto equivocado. La tabla pública no establece cuáles de esos errores detecta el evaluador con fiabilidad.
La búsqueda puede aportar información sin garantizar su transcripción visual fiel. La ficha subyacente fija el corte de conocimiento en marzo de 2026, con algunos dominios posiblemente limitados a enero de 2025 y otros con información posterior. Incluso un gráfico de apariencia actual requiere hechos suministrados o recuperados y una comparación con la imagen final.
La unidad controlable es una hoja factual: valores, unidades, fechas, etiquetas y citas aprobados antes de generar y revisados después en la imagen. Los hechos trazables y los dosieres de fuentes ayudan a separar evidencia de presentación, pero no hacen que una imagen se verifique sola. En medicina, finanzas, derecho, ciencia y actualidad, AutoRater no puede autorizar la publicación.
Una salida barata no garantiza un recurso aceptado barato
Los precios estándar de la API de pago sitúan la salida de imágenes de 2.1 en 30 dólares por millón de tokens y la de Nano Banana 2 en 60. Las asignaciones diferentes a 4K modifican esa aparente reducción a la mitad.
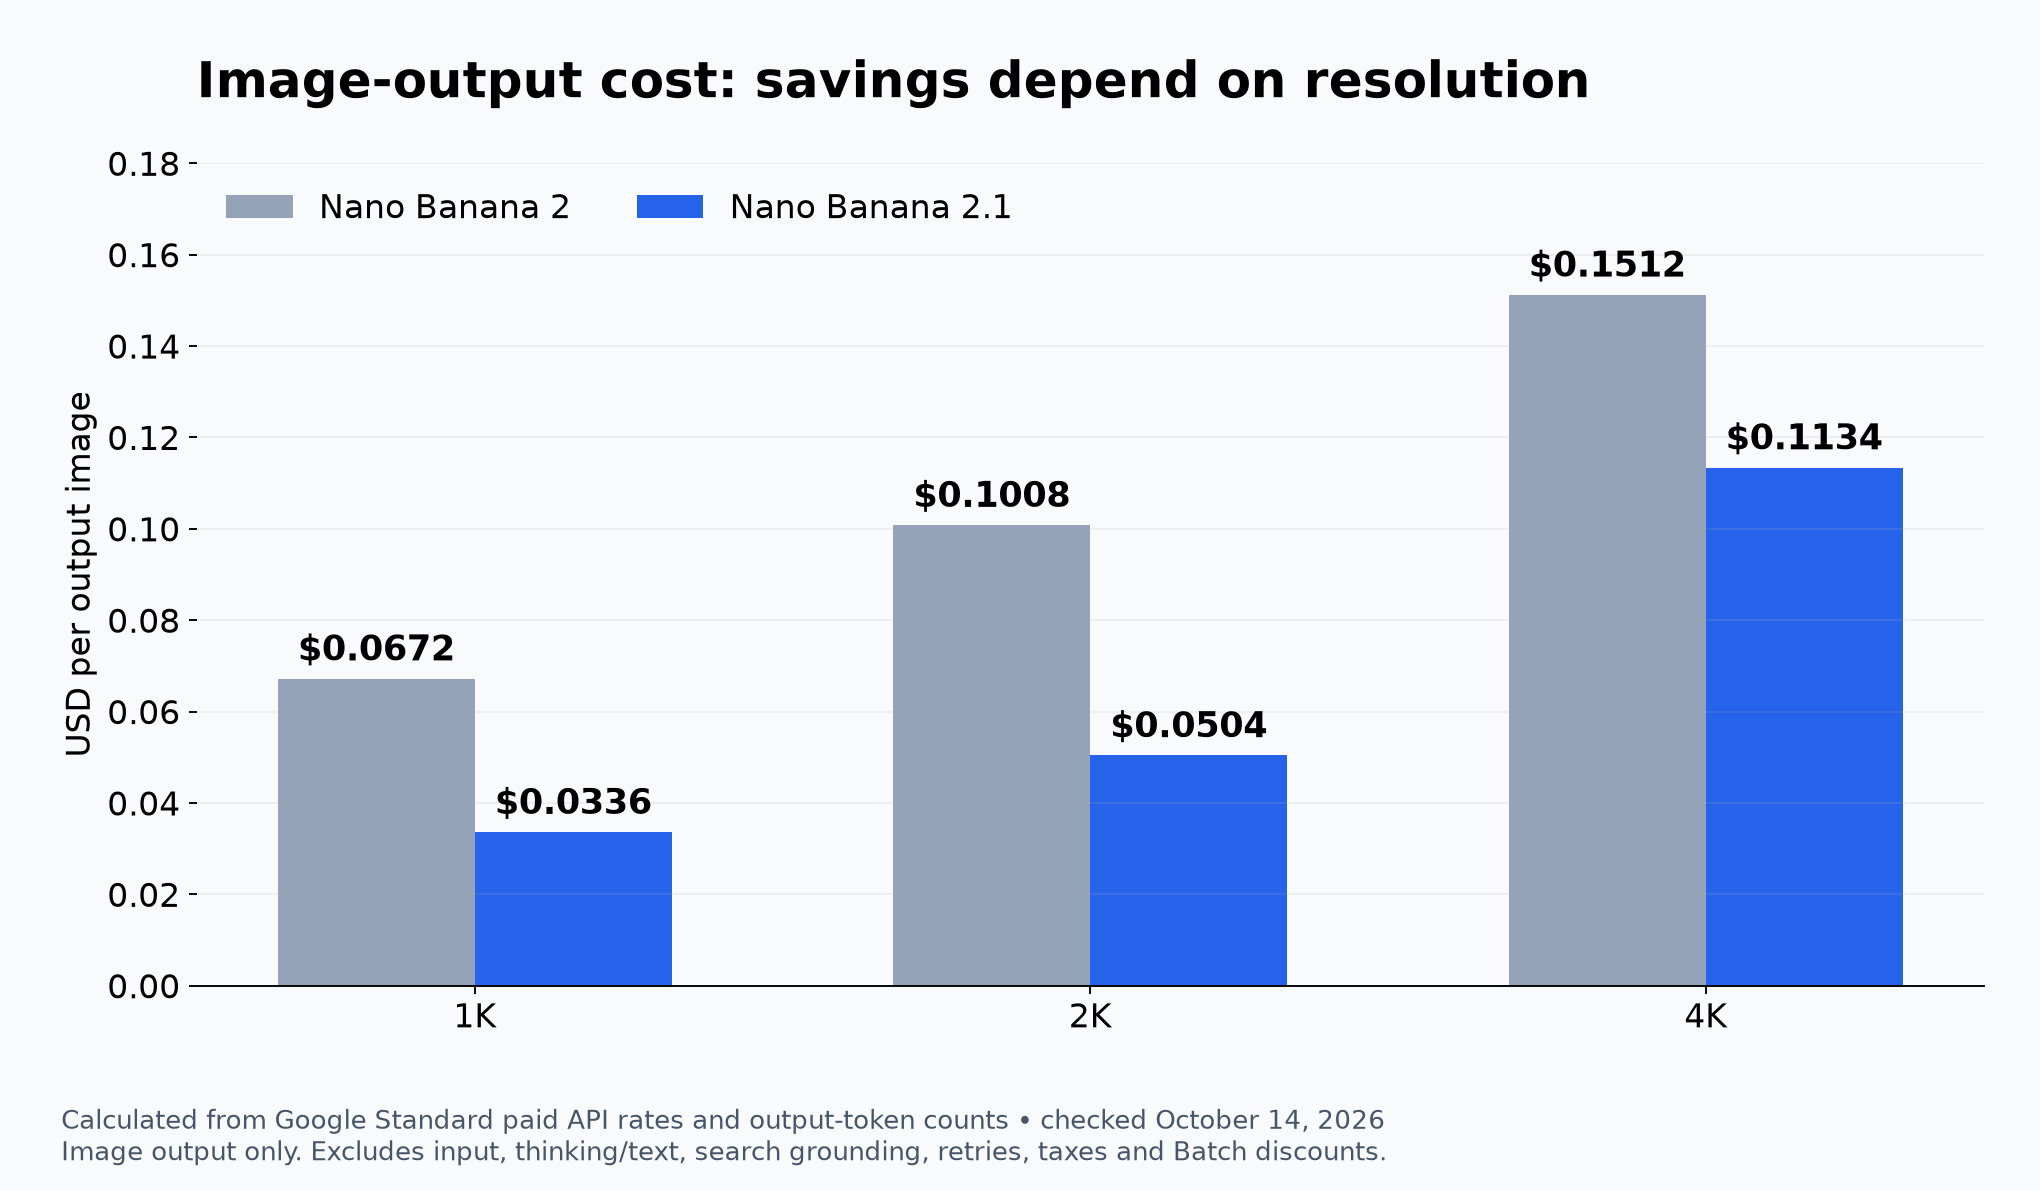
Cálculo editorial con tarifas y asignaciones de Google publicadas hasta el 14 de octubre. Son costes de salida, no totales medidos de solicitudes; el gráfico no es original de Google.
A 1K, ambos usan 1120 tokens de imagen: 0,0336 dólares en 2.1 frente a 0,0672 en Nano Banana 2. A 2K, 1680 tokens cuestan 0,0504 y 0,1008 dólares. En ambos casos la salida baja un 50%.
A 4K, 2.1 asigna 3780 tokens y Nano Banana 2, 2520. Multiplicados por sus respectivas tarifas resultan 0,1134 y 0,1512 dólares: ahorro del 25%, no del 50%. Si aumenta la cantidad de tokens, reducir a la mitad su tarifa no reduce a la mitad la imagen.
Otros componentes suben. La entrada estándar de texto, imagen o vídeo de 2.1 cuesta 1,50 dólares por millón de tokens, frente a 0,50 de texto o imagen en Nano Banana 2. La salida de texto y Thinking cuesta 7,50 frente a 3 dólares. Fundamentación, referencias, texto, razonamiento, reintentos, impuestos y posibles descuentos Batch afectan la factura completa.
Sin hipótesis sobre esas cantidades no puede calcularse responsablemente una solicitud «típica». Una mayor aceptación al primer intento puede compensar el razonamiento; más reintentos pueden consumir el ahorro. La métrica es el coste por recurso aceptado, junto con latencia y tiempos de espera agotados medidos, no una tarifa aislada de salida.
Migrar requiere comparar las mismas tareas por pares
Una prueba útil compararía los mismos prompts reales y archivos de referencia en el modelo actual y los niveles disponibles de Thinking de 2.1, manteniendo proporción, resolución y reintentos. Es una propuesta de evaluación, no una prueba realizada por AI Tools Radar. Pro solo debe entrar si es una opción de despliegue real; no cabe suponer equivalentes sus ajustes no especificados en el benchmark.
Conviene separar uno o varios personajes, producto, máscaras, composiciones de referencias, diseños con mucho texto y gráficos factuales. El texto exacto puede transcribirse y compararse; las máscaras requieren revisar dentro y fuera del área permitida; el producto, sus rasgos protegidos. La preferencia a ciegas complementa estas pruebas, pero no sustituye la exactitud cuando un número o logotipo debe permanecer intacto.
Hay que conservar resultados emparejados e incertidumbre en lugar de comprimir riesgos distintos en una media. Los registros operativos deben incluir latencia completa, tiempos de espera agotados, reintentos, consumo de tokens y coste por imagen aceptada. Una fase en sombra muestra si la ventaja del benchmark reduce realmente las revisiones.
No existe en las fuentes un cierre el 29 de octubre que obligue a migrar precipitadamente. La referencia sobre obsolescencia enumera Gemini 3.1 Flash Image como obsoleto, pero sin fecha anunciada de apagado. Tampoco promete disponibilidad indefinida.
Los primeros casos más sólidos para 2.1 son diseño de infografías, varios personajes recurrentes, combinación de referencias y menor coste de salida. Thinking merece atención especial para múltiples sujetos y factualidad; donde los intervalos se solapan, quedan opciones más sencillas. Si son obligatorios el texto pequeño, los hechos, la identidad exacta o regiones de producto intactas, deben mantenerse validación externa y alternativa hasta que el endpoint cumpla. El liderazgo publicado es motivo para comparar, no un sustituto de la comparación.