
Nano Banana 2.1 przedstawia zespołom produkcji graficznej dwie różne korzyści: lepsze wyniki w porównaniach Google i niższe opłaty za tokeny wygenerowanego obrazu. Żadna sama w sobie nie dowodzi, że materiał gotowy do publikacji będzie tańszy. Pytanie brzmi, czy zmierzone przewagi przetrwają wymagania dotyczące tożsamości postaci, faktów, chronionych szczegółów produktu i pełnych kosztów ponownych prób.
Ta analiza z 14 października omawia ogólną dostępność z 6 października, nie nową premierę tego dnia. Najsilniejsze sygnały obejmują preferencje dla infografik, spójność wielu postaci i część edycji. Najsłabszą interpretacją byłoby uznanie preferencji za procent poprawności, założenie jednakowej korzyści z Thinking we wszystkich zadaniach albo nazwanie każdego żądania o połowę tańszym.
Wdrożony endpoint ma węższe limity niż karta modelu
Dziennik zmian API podaje stabilną nazwę gemini-nano-banana-2.1. Google opisuje aktualizację klasy Flash modelu Gemini 3.1 Flash Image, znanego też jako Nano Banana 2, a nie nowy Pro. Według karty modelu podstawą jest Gemini 3.6 Flash: przyjmuje tekst i obrazy, zwraca obrazy i tekst.
Szczegóły implementacji są równie ważne jak ta rodzina. Dokumentacja endpointu określa domyślne wyjście 1K i maksymalnie 4K. Thinking ma poziomy minimal, medium i high, z domyślnym medium. Dostępne jest ugruntowanie przez wyszukiwanie, ale nie wywoływanie funkcji, wykonywanie kodu ani wyjścia strukturalne. Potrzebne sterowanie i walidację aplikacja musi zapewnić poza modelem obrazu.
Pozostaje niewyjaśniona rozbieżność pojemności. Karta wymienia milion tokenów kontekstu i 64K tekstu wyjściowego, a strona Gemini API 131 072 tokeny wejściowe i 32 768 wyjściowych. Źródła nie wyjaśniają relacji. Wdrożenie powinno opierać się na udokumentowanych limitach konkretnego endpointu, nie automatycznie na większych liczbach architektury.
Łączenie obrazów przyjmuje do 14 referencji, w tym maksymalnie cztery postacie i dziesięć obiektów. Są to limity wejścia, nie gwarancja wiernego zachowania czternastu referencji czy czterech niezależnych tożsamości.
Karta wymienia również rozmyty lub uszkodzony drobny i długi tekst, dryf tożsamości, mylenie lewej i prawej strony, niedoskonałe rozumowanie 3D i wiedzę faktograficzną oraz okresową powolność i przekroczenia czasu. Pozostałości kresek i utrwalone pozy to kolejne ryzyka edycji. Te znane ograniczenia wymagają kryteriów błędu i alternatywy; większy limit referencji lub kontekstu ich nie usuwa.
Generowanie mierzy preferencje, nie poprawność
Google porównuje ludzkie preferencje za pomocą Elo. Nie liczy odsetka poprawnych obrazów. Opublikowane zakresy ± pomagają w interpretacji, ale nie mają zdefiniowanego poziomu ufności. Nie ujawniono też próbek, promptów, rozdzielczości, budżetu prób, konkretnych ustawień Thinking ani równych warunków obliczeniowych.
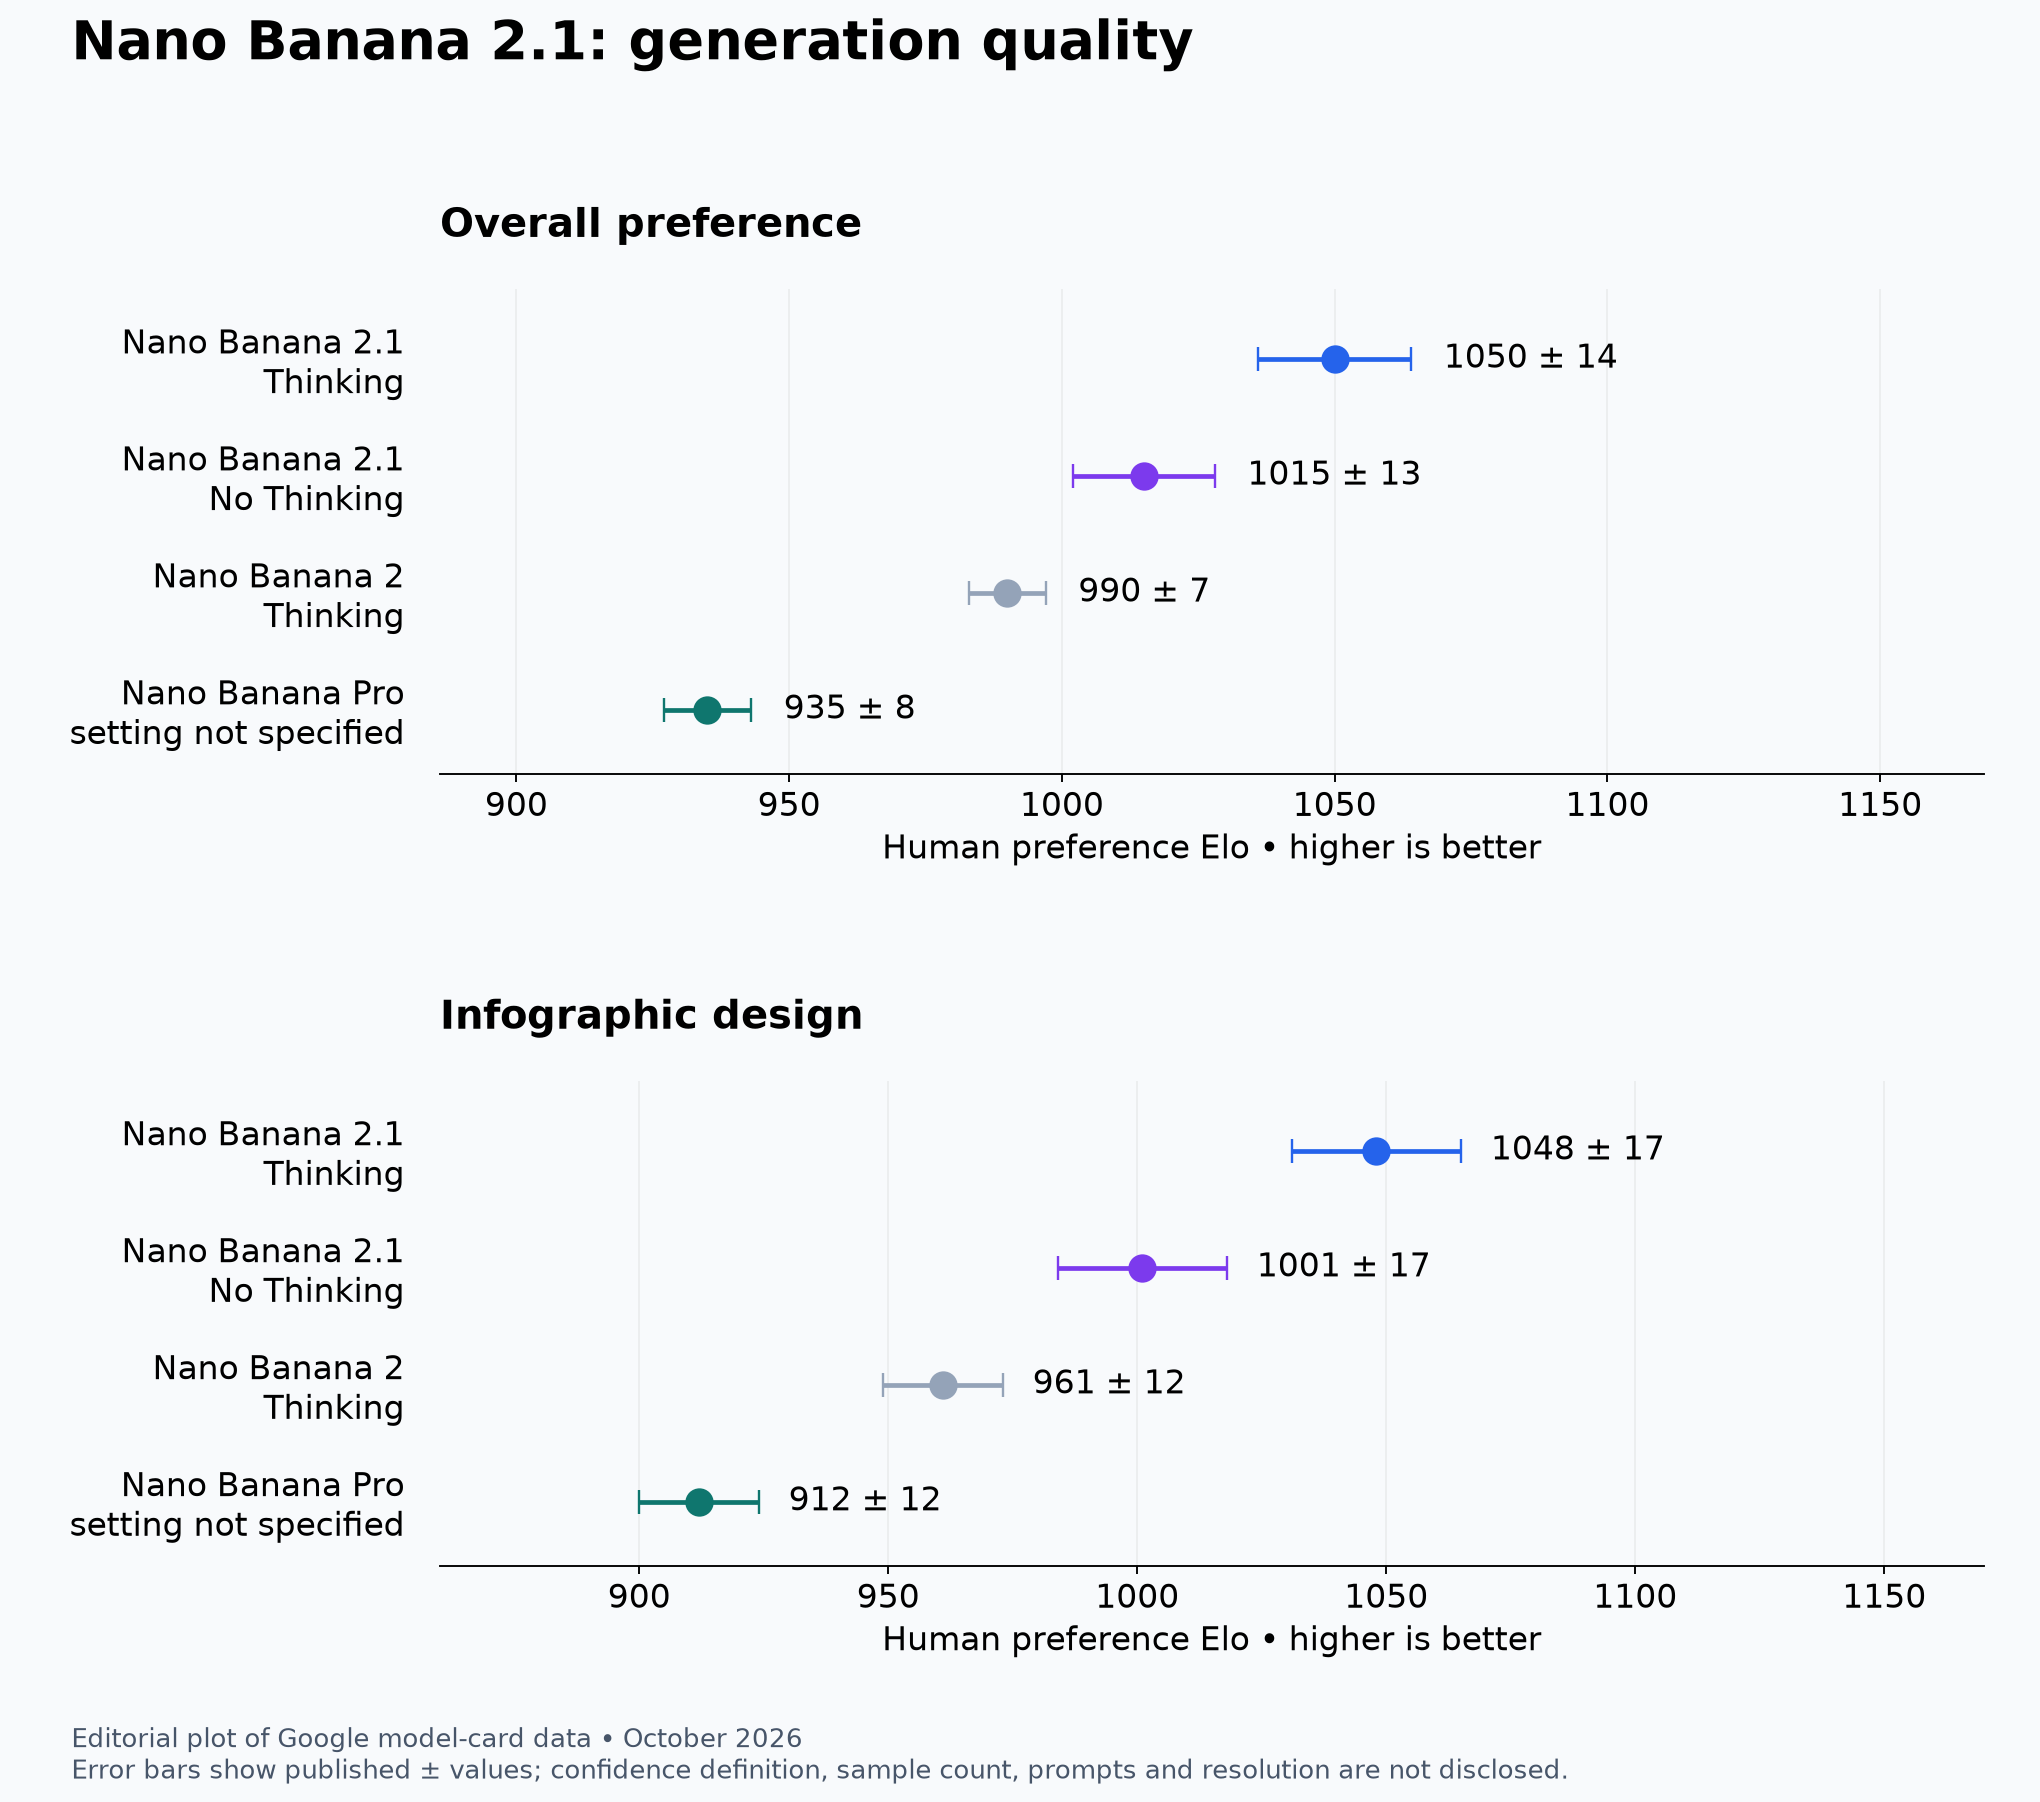
Wykres redakcyjny danych z karty Google z października 2026, nie oryginalny obraz Google. Słupki błędu odwzorowują opublikowane zakresy, nie ustalają jednak ich ufności ani dokładności produkcyjnej.
W ogólnym generowaniu 2.1 Thinking uzyskuje 1050 ±14, bez Thinking 1015 ±13, Nano Banana 2 Thinking 990 ±7, a Pro 935 ±8. Dla infografik ta sama kolejność daje 1048 ±17, 1001 ±17, 961 ±12 i 912 ±12. Nawet z uwzględnieniem zakresów oba warianty 2.1 przewyższają Nano Banana 2 w infografikach.
Ogólny przedział Thinking, 1036–1064, nie nakłada się na 1002–1028 bez niego. W infografikach przedziały stykają się przy 1031. Pierwsze rozdzielenie jest wyraźniejsze, ale żadne nie dowodzi jednakowego efektu dla każdego promptu. Ogólna etykieta „Thinking” nie musi też oznaczać poziomu high API: konfiguracji testu nie podano.
Nie wynika z tego skrót operacyjny. Lepsza preferencja nie dowodzi mniejszej liczby prób, niższego opóźnienia ani poprawnych etykiet wykresu. Google nie publikuje tu opóźnień benchmarku. Zespoły kreatywne mają powód testować 2.1, zwłaszcza kompozycję i układ, ale nie wymyślać uniwersalnego przyspieszenia czy zwrotu z inwestycji.
Wiele postaci zmienia wartość Thinking
Jedna powracająca postać i scena z kilkoma tożsamościami to różne obciążenia. Testy spójności ujawniają tę różnicę.
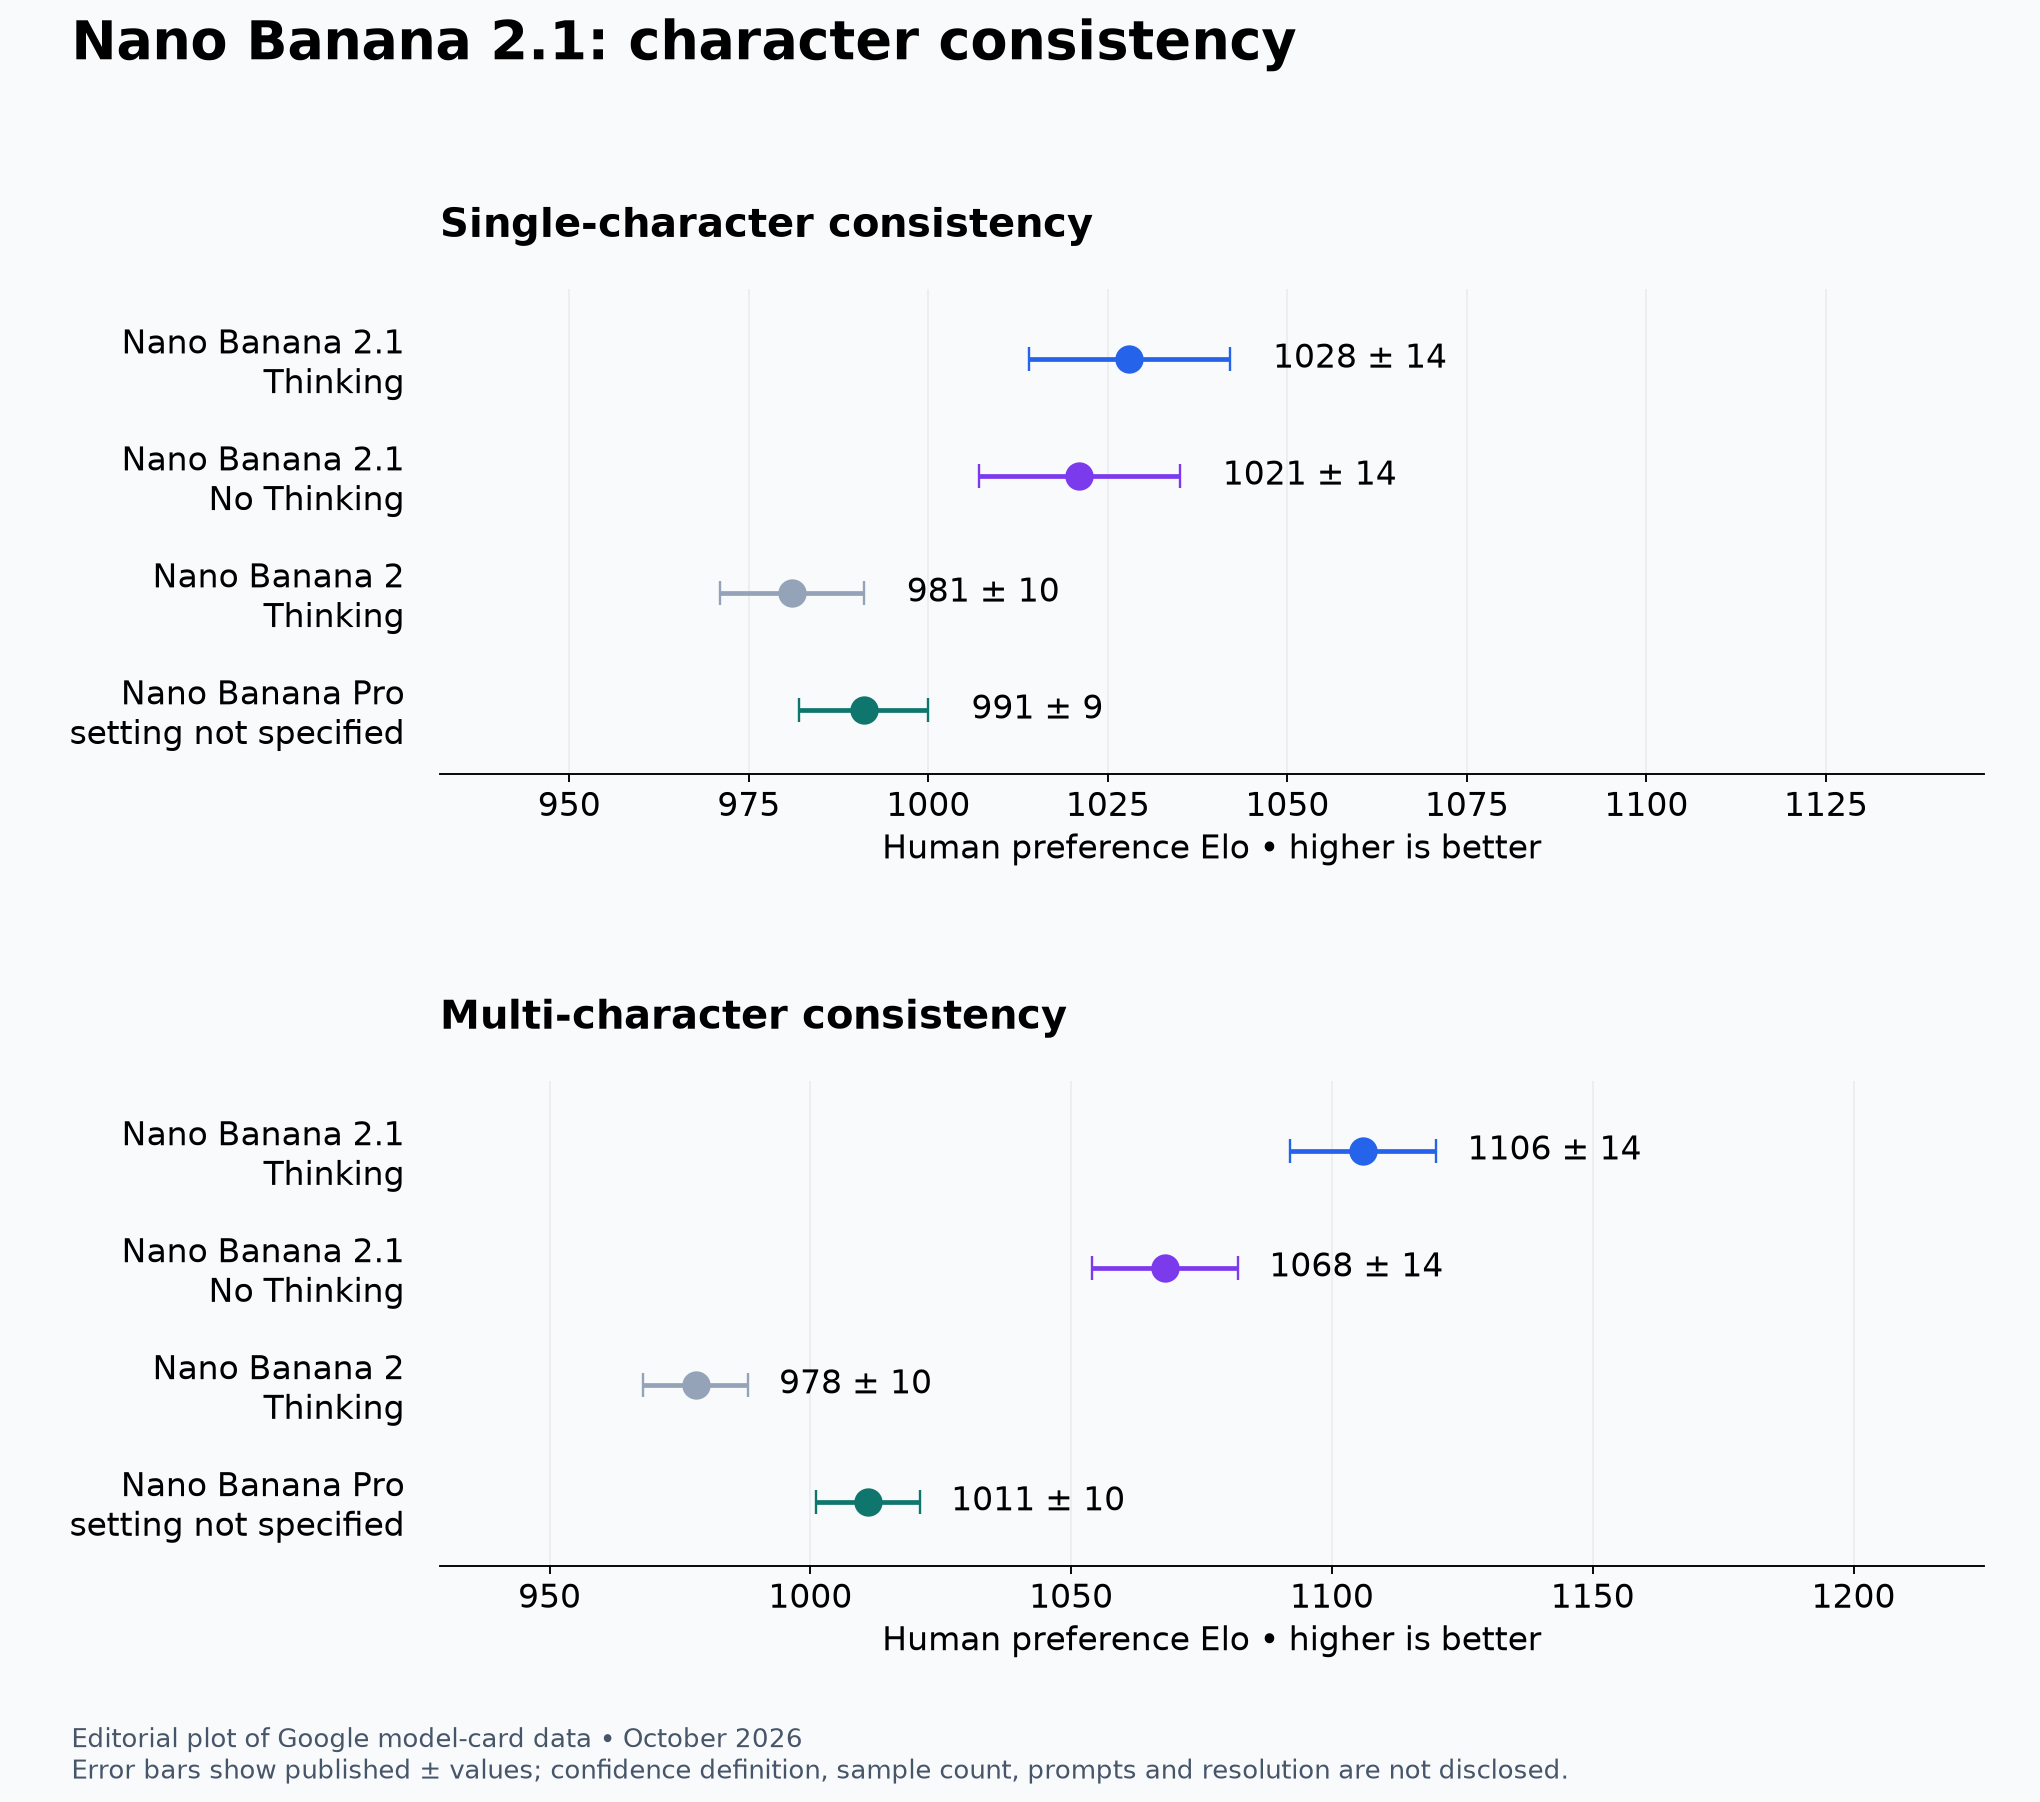
Redakcyjne przedstawienie tego samego zbioru Google. Zakresy nie mają podanej definicji ufności, a ilustracja nie jest oryginałem Google.
Dla jednej postaci 2.1 Thinking osiąga 1028 ±14, bez Thinking 1021 ±14, Nano Banana 2 Thinking 981 ±10, a Pro 991 ±9. Przedziały 2.1 silnie się nakładają. Siedem punktów między wartościami centralnymi nie uzasadnia rozumowania przy każdym żądaniu z jedną postacią.
Dla wielu postaci rozdzielenie jest większe: 1106 ±14 z Thinking, 1068 ±14 bez, 1011 ±10 dla Pro i 978 ±10 dla Nano Banana 2 Thinking. Przedziały 2.1 się nie nakładają. Thinking jest więc bardziej obiecujący przy utrzymaniu wielu tożsamości i relacji, ale nie dowodzi niezawodności czterech osób przy dowolnym zestawie referencji.
Ładny obraz grupy może zamienić ubrania albo kogoś pominąć. Benchmark nie rozbija zmian twarzy, proporcji, przenoszenia stroju, duplikatów ani błędów względnego wzrostu. Odbiór musi oceniać każdego bohatera, zwłaszcza przy referencjach przyciętych, sprzecznych, różnie oświetlonych lub podobnych wizualnie. Globalna ocena estetyczna może ukryć błąd tożsamości dyskwalifikujący materiał.
Edycja zależy od tego, co ma pozostać bez zmian
Także edycji nie da się sprowadzić do „Thinking wygrywa”. Maski, wierność produktu i łączenie referencji chronią inne elementy.
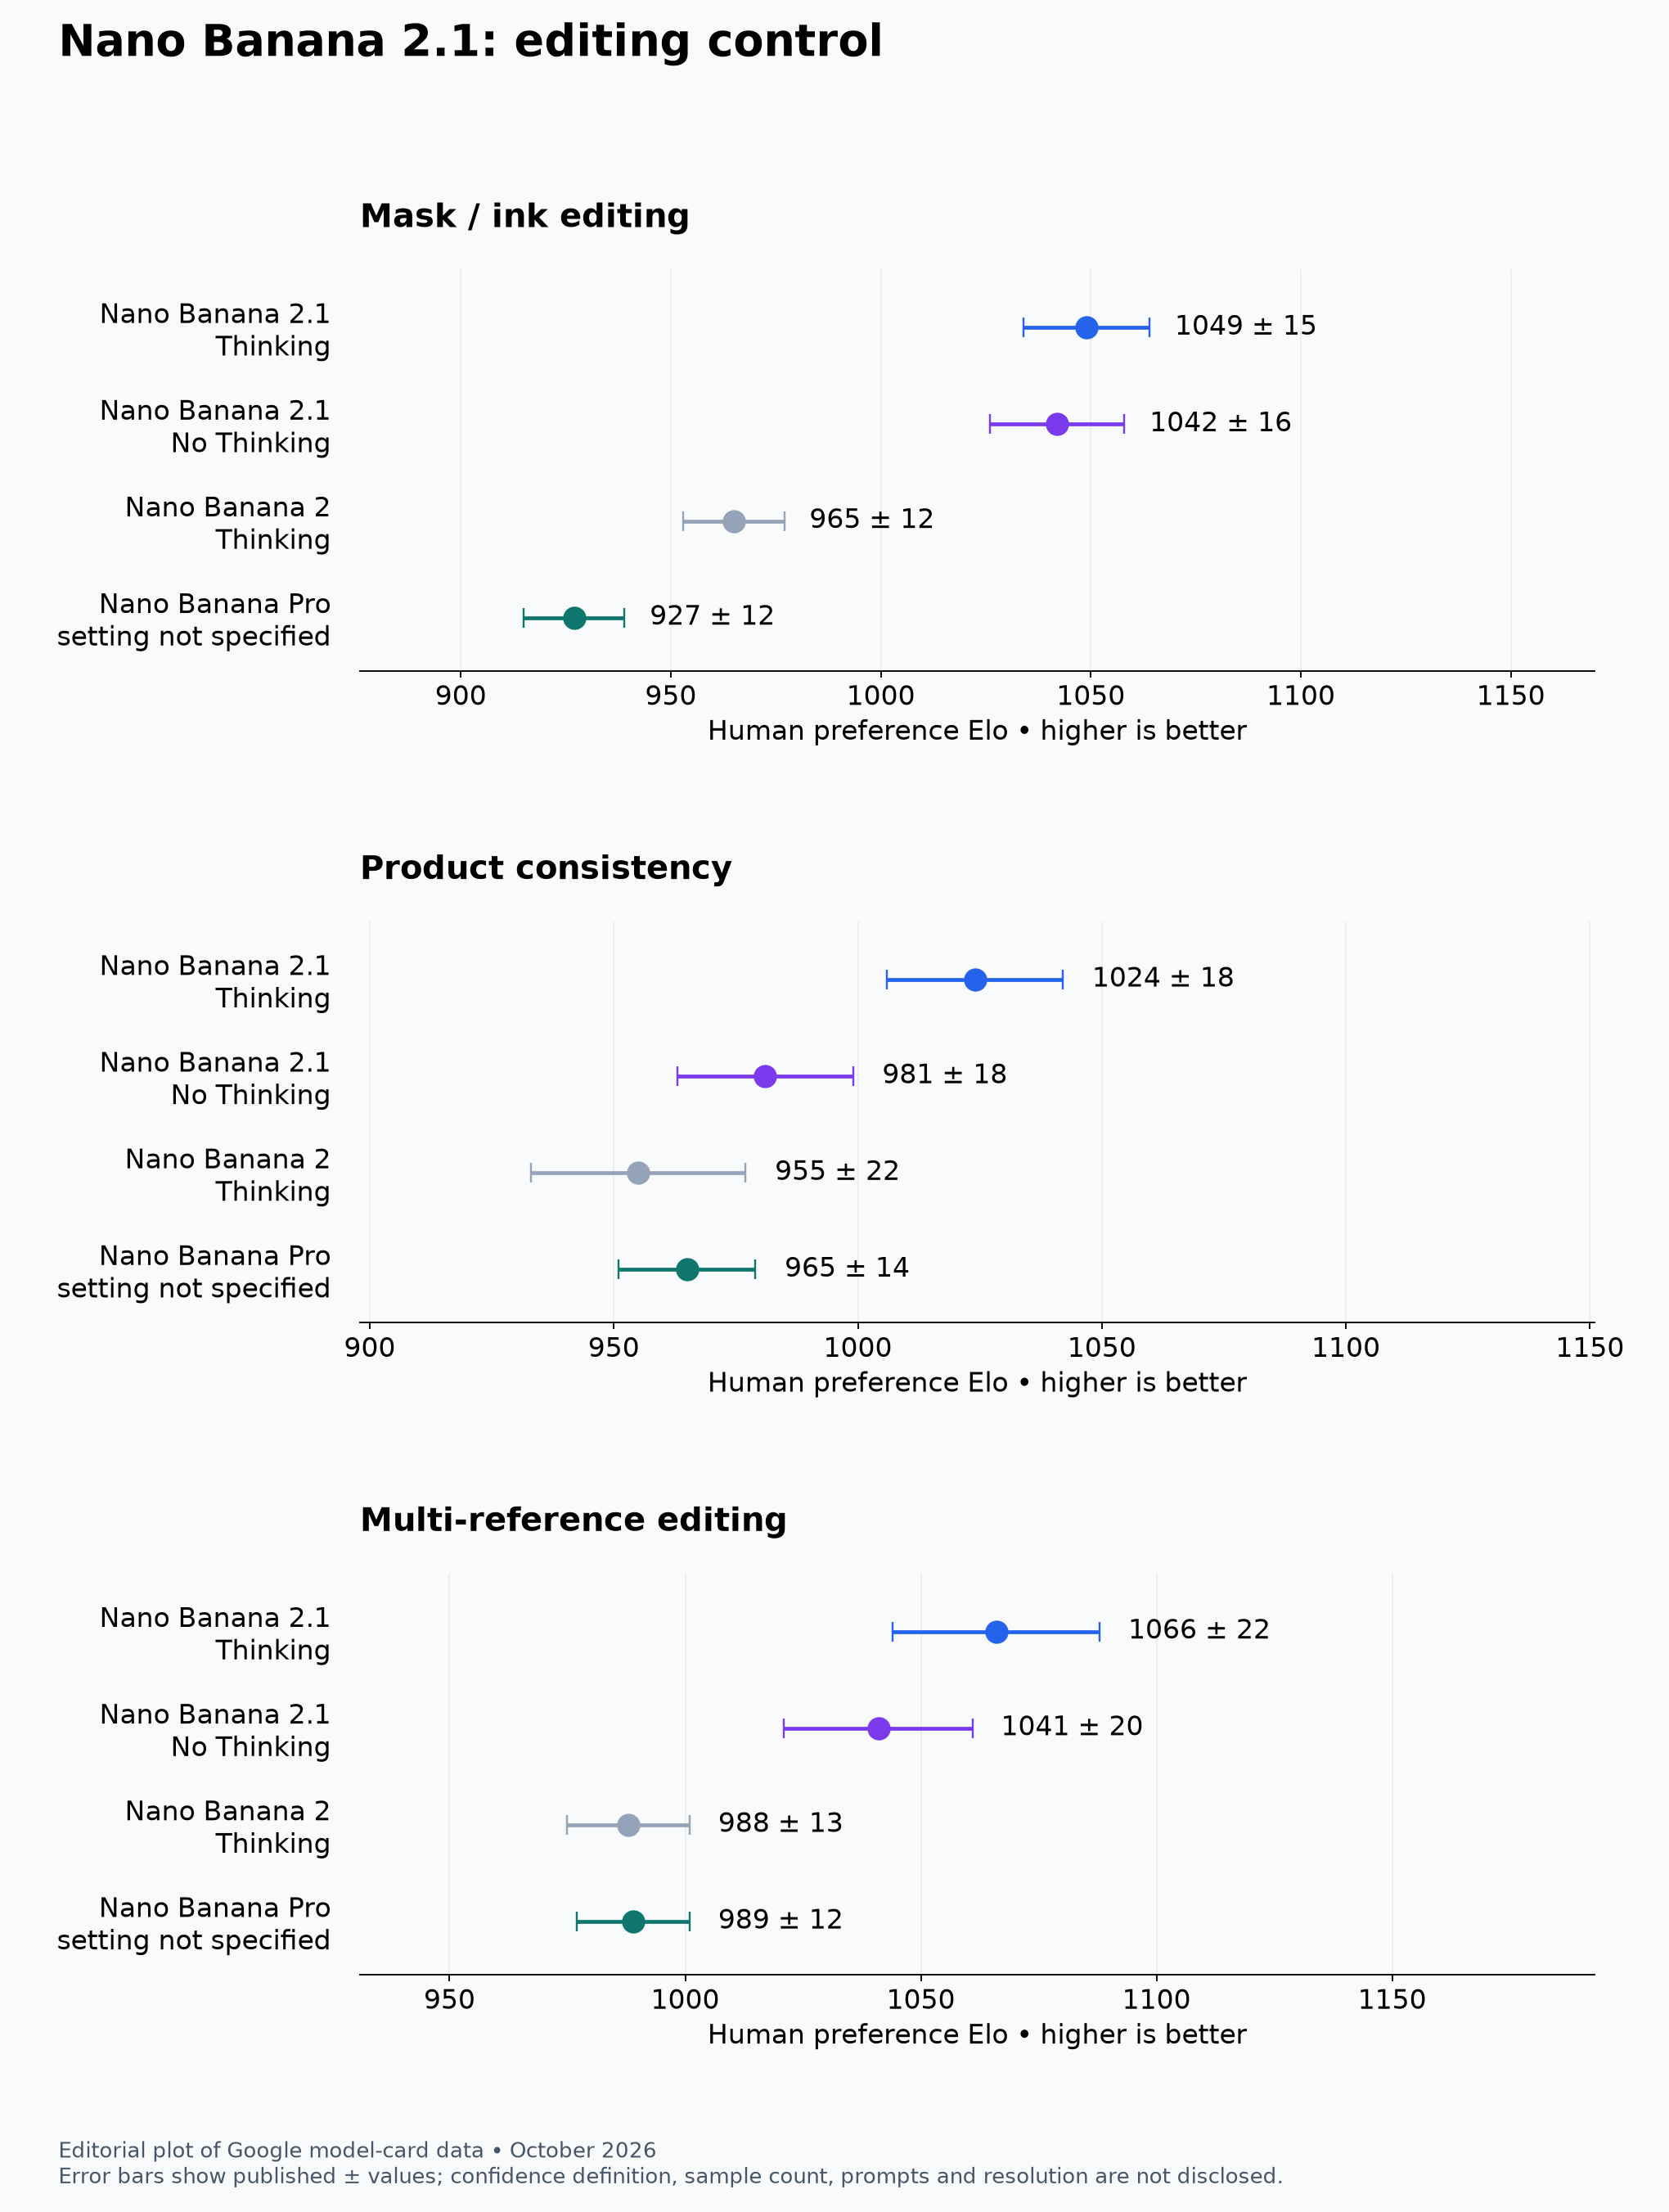
Redakcyjny wykres na podstawie karty Google, nie oryginalna grafika firmy. Elo i zakresy ± nie mierzą ścisłego wykonania poleceń ani niezmienności pikseli poza maską.
Dla masek lub narysowanych wskazówek 2.1 Thinking ma 1049 ±15, a bez Thinking 1042 ±16, z dużym nakładaniem. Oba przewyższają Nano Banana 2 Thinking z 965 ±12 i Pro z 927 ±12. Uzasadnia to testowanie obu trybów 2.1, nie uznanie siedmiu punktów centralnych za dowiedzioną korzyść rozumowania.
Wierność produktu jest mniej jednoznaczna: Thinking 1024 ±18, bez niego 981 ±18, Nano Banana 2 Thinking 955 ±22, Pro 965 ±14. Przedział bez Thinking nakłada się na oba starsze modele. Thinking jest najmocniejszą konfiguracją tego porównania, ale nie każdy wariant 2.1 wyraźnie poprawia wierność.
W edycji wieloreferencyjnej 2.1 Thinking uzyskuje 1066 ±22, bez niego 1041 ±20, wobec 988 ±13 dla Nano Banana 2 Thinking i 989 ±12 dla Pro. 2.1 wypada lepiej, ale własne przedziały zachodzą na siebie; centralne 25 punktów nie daje bezwarunkowego zalecenia.
Google przyznaje częściowe respektowanie masek, pozostałości kresek i nieoczekiwane utrzymywanie pierwotnej pozy. Preferowana edycja może więc nie spełnić wymogów zachowania. W handlu zmiana portu, logo, liczby sztuk, materiału lub tekstu opakowania potrafi unieważnić atrakcyjny obraz. Kreatywny montaż toleruje zmiany geometrii niedopuszczalne w dokumentacji produktu. To osobne kryteria odbioru, nie szczegóły do uśrednienia.
Wynik faktograficzny 0,521 nie oznacza 52,1% poprawności
Faktografia infografik jest mierzona inaczej: jednostronnym automatycznym oceniającym, nie ludzką preferencją generowania. Google podaje 0,521 dla 2.1 Thinking, 0,328 bez niego, 0,265 dla Pro i 0,179 dla Nano Banana 2 Thinking.
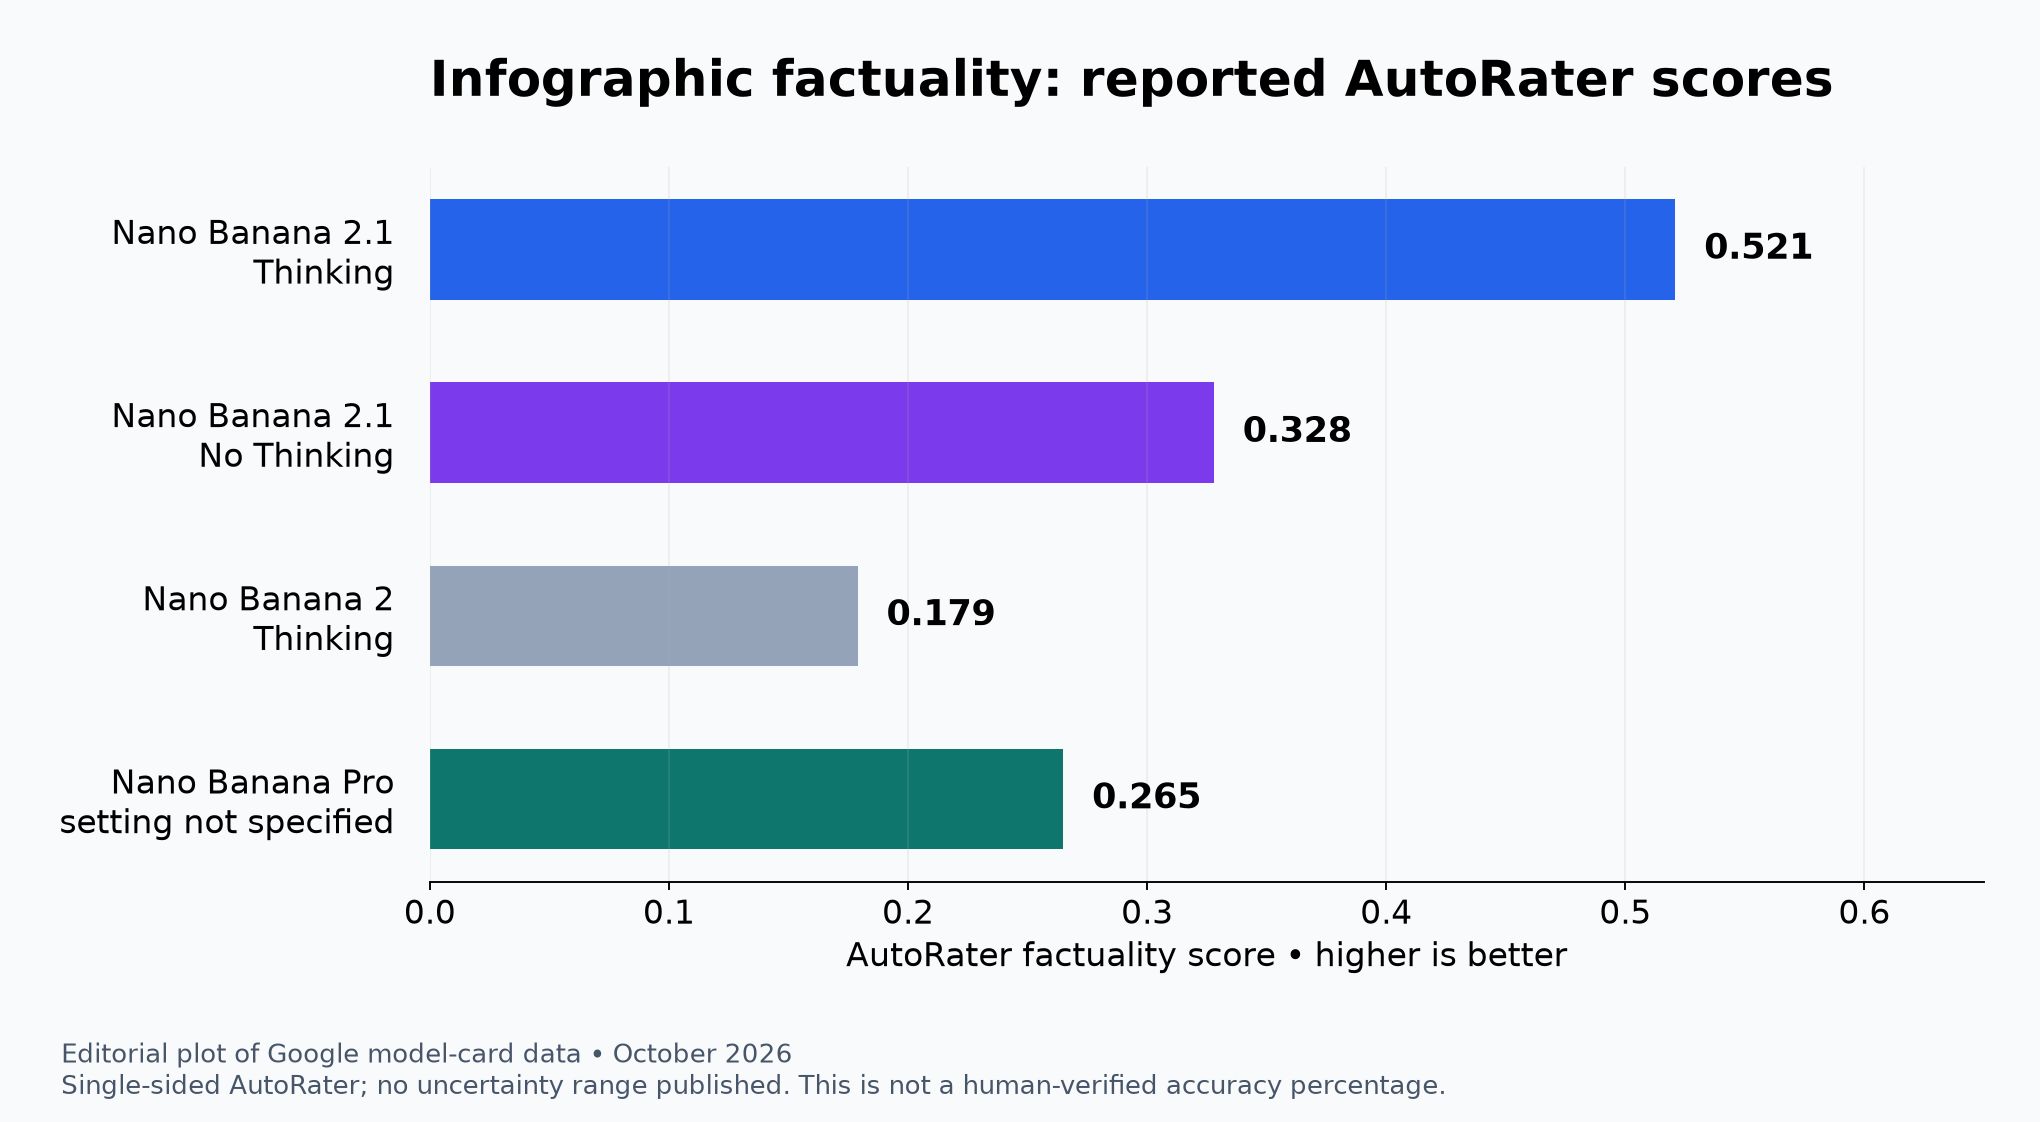
Redakcyjny wykres automatycznej oceny Google. Nie opublikowano przedziałów niepewności. To nie oryginał Google ani odsetek infografik zgodnych z faktami.
Thinking prowadzi w tym mierniku, ale opis metody, próbek i niepewności nie wystarcza do obliczenia produkcyjnego poziomu błędów. Wykres może mieć prawidłowy tekst i błędnie naniesione wartości, oś czasu odwrócone zdarzenia, mapa zamienione regiony, a etykieta niewłaściwy obiekt. Publiczna tabela nie dowodzi, które błędy oceniający wykrywa niezawodnie.
Wyszukiwanie może dostarczyć informacji bez gwarancji wiernej transkrypcji wizualnej. Karta podstawowa podaje marzec 2026 jako granicę wiedzy, przy czym niektóre dziedziny mogą kończyć się w styczniu 2025, a inne zawierać nowsze informacje. Aktualnie wyglądający wykres nadal wymaga dostarczonych lub wyszukanych faktów i porównania z końcowym obrazem.
Jednostką kontroli jest karta faktów: wartości, jednostki, daty, etykiety i cytowania zatwierdzone przed generowaniem, potem sprawdzone w obrazie. Identyfikowalne fakty i opracowania źródeł pomagają oddzielać dowody od prezentacji, lecz nie czynią grafiki samoweryfikującą. W medycynie, finansach, prawie, nauce i aktualnościach AutoRater nie może być zgodą na publikację.
Tańsze wyjście nie gwarantuje tańszego zaakceptowanego materiału
Standardowy cennik płatnej API wycenia wyjściowe tokeny obrazu na 30 dolarów za milion w 2.1 i 60 w Nano Banana 2. Różne przydziały dla 4K zmieniają pozorne obniżenie o połowę.
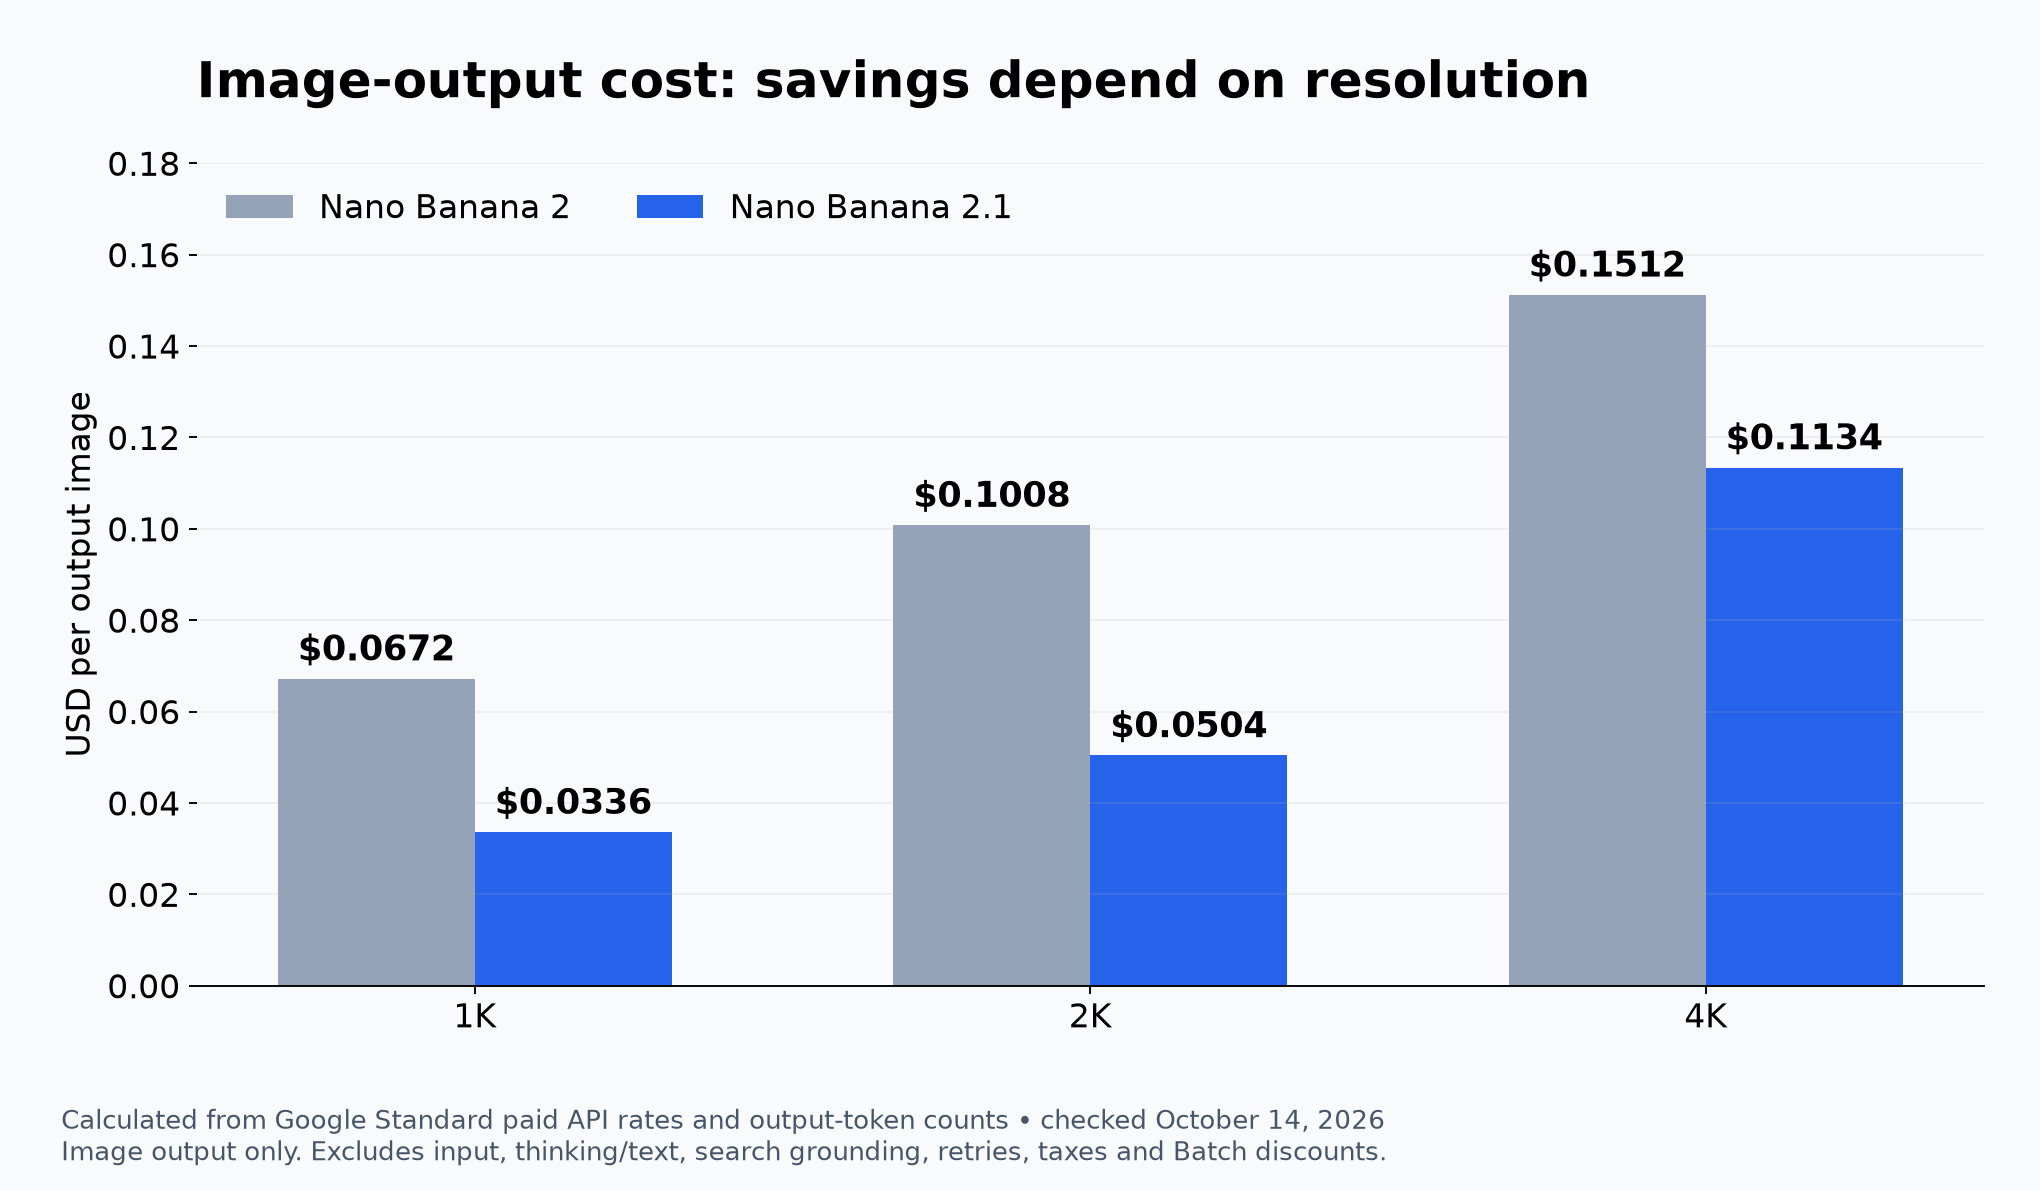
Redakcyjne obliczenie stawek i przydziałów Google opublikowanych do 14 października. To nie zmierzone koszty pełnych żądań ani oryginalny wykres Google.
Przy 1K oba modele używają 1120 tokenów obrazu: 0,0336 dolara dla 2.1 i 0,0672 dla Nano Banana 2. Przy 2K, 1680 tokenów kosztuje 0,0504 wobec 0,1008 dolara. W obu przypadkach samo wyjście tanieje o 50%.
Przy 4K, 2.1 podaje 3780 tokenów, Nano Banana 2 zaś 2520. Po zastosowaniu odpowiednich stawek wychodzi 0,1134 wobec 0,1512 dolara: oszczędność 25%, nie 50%. Więcej tokenów sprawia, że połowa stawki jednostkowej nie oznacza połowy ceny obrazu.
Inne składniki drożeją. Standardowe wejście tekstowe, obrazowe lub wideo w 2.1 kosztuje 1,50 dolara za milion tokenów, a tekstowe lub obrazowe w Nano Banana 2 0,50. Wyjście tekstowe i Thinking kosztuje 7,50 wobec 3 dolarów. Ugruntowanie, referencje, tekst, rozumowanie, próby, podatki i ewentualne zniżki Batch zmieniają pełny rachunek.
Bez założeń o tych ilościach nie da się odpowiedzialnie policzyć „typowego” żądania. Lepsza akceptacja za pierwszym razem może zrównoważyć rozumowanie; więcej prób może pochłonąć oszczędność. Miarą jest koszt zaakceptowanego materiału wraz ze zmierzonymi opóźnieniami i przekroczeniami czasu, nie pojedyncza stawka wyjścia.
Migracja wymaga porównań parami
Przydatny test dałby te same rzeczywiste prompty i pliki referencyjne dotychczasowemu modelowi oraz dostępnym poziomom Thinking 2.1, przy tej samej proporcji, rozdzielczości i liczbie prób. To propozycja oceny, nie test przeprowadzony przez AI Tools Radar. Pro należy uwzględniać tylko wtedy, gdy można go rzeczywiście wdrożyć; nie wolno zakładać równoważności nieopisanych ustawień benchmarku.
Osobno trzeba oceniać jedną i wiele postaci, produkty, maski, kompozycje referencji, układy z dużą ilością tekstu i grafiki faktograficzne. Dokładny tekst można przepisać i porównać; maski wymagają sprawdzenia wewnątrz i poza dozwolonym obszarem; produkty kontroli chronionych cech. Ślepe oceny preferencji uzupełniają te testy, ale nie zastępują ścisłości tam, gdzie logo lub liczba nie może się zmienić.
Zachowanie wyników parami i niepewności zapobiega sprowadzeniu różnych ryzyk do średniej. Rejestry operacyjne powinny obejmować pełne opóźnienie, przekroczenia czasu, próby, tokeny i koszt zaakceptowanego obrazu. Faza równoległa do produkcji pokazuje, czy przewaga benchmarku naprawdę oznacza mniej poprawek.
Źródła nie potwierdzają wyłączenia 29 października, które wymuszałoby pośpiech. Odnośnik dotyczący wycofania wymienia Gemini 3.1 Flash Image jako przestarzały, ale bez ogłoszonej daty wyłączenia. Nie obiecuje też dostępności bez końca.
Najsilniejsze pierwsze zastosowania 2.1 to układ infografik, wiele powracających postaci, kompozycje referencji i tańsze wyjście obrazu. Thinking zasługuje na szczególną uwagę przy wielu tożsamościach i faktach; nakładające się wyniki zostawiają gdzie indziej miejsce prostszym konfiguracjom. Gdy drobny tekst, fakty, dokładna tożsamość lub nienaruszone obszary produktu są obowiązkowe, trzeba zachować zewnętrzną kontrolę i alternatywę, aż endpoint spełni wymagania. Opublikowane prowadzenie uzasadnia porównanie, nie zastępuje go.