
Nano Banana 2.1 が画像制作チームに示す利点は二つある。Google の比較でよりよい結果を得たことと、生成画像トークンの料金が下がったことだ。しかし、どちらも単独では、公開に使える素材が安くなるとは証明しない。問うべきなのは、測定上の改善が、人物の同一性、事実、変更してはいけない製品の細部、再試行を含む総費用という実務の条件にも通用するかである。
本稿は 10 月 6 日に一般提供されたモデルを 10 月 14 日時点で分析したもので、同日の新規発表ではない。強い兆候はインフォグラフィックの選好、複数人物の一貫性、一部の編集にある。反対に、選好スコアを正答率に読み替え、どの作業にも Thinking が同程度に効くと考え、すべてのリクエストが半額だとする読み方は避ける必要がある。
実際のエンドポイントにはモデルカードより狭い上限がある
API の変更履歴が示す安定版の識別子は gemini-nano-banana-2.1 だ。Google はこれを、新しい Pro ではなく、Nano Banana 2 とも呼ばれる Gemini 3.1 Flash Image の Flash クラスの更新と説明する。モデルカードによる基盤は Gemini 3.6 Flash で、テキストと画像を入力し、画像とテキストを返す。
実装条件は系譜に劣らず重要だ。エンドポイントの文書では出力は標準で 1K、最大 4K。Thinking は minimal、medium、high があり、既定は medium である。検索グラウンディングは使えるが、関数呼び出し、コード実行、構造化出力には対応しない。それらを必要とするアプリケーションは、画像モデルの外で処理の制御と検証を担う必要がある。
容量にも説明されていない違いがある。カードは最大 100 万コンテキストトークンと 64K のテキスト出力を記す一方、Gemini API のページは入力 131,072、出力 32,768 トークンとする。資料は両者の関係を説明していない。導入時は、大きいアーキテクチャ上の数字を当然のように採用せず、実際に呼ぶエンドポイントの公表上限で設計すべきだ。
複数画像の融合では最大 14 枚の参照画像、うち最大四人の人物と十個の物体を扱える。これは入力の上限であり、十四枚の要素や四人の独立した同一性を正確に維持する保証ではない。
カードは小さい文字や長文のぼけ・崩れ、同一性の変化、左右の混同、不完全な3D推論と事実知識、時折の遅延やタイムアウトも挙げる。マスクの描画残りやポーズの維持は別の編集リスクだ。こうした既知の制約には失敗基準と代替策が必要で、参照枚数や文脈容量が増えても解消はしない。
生成の優位は好まれた証拠であり、正しさではない
Google の生成比較は、人間の選好を Elo で示す。「正しい画像の割合」を数えたものではない。公表された ± の範囲は手掛かりになるが、その信頼水準は不明である。サンプル数、プロンプト、解像度、再試行の割当、具体的な Thinking 設定、計算資源の同等性も開示されていない。
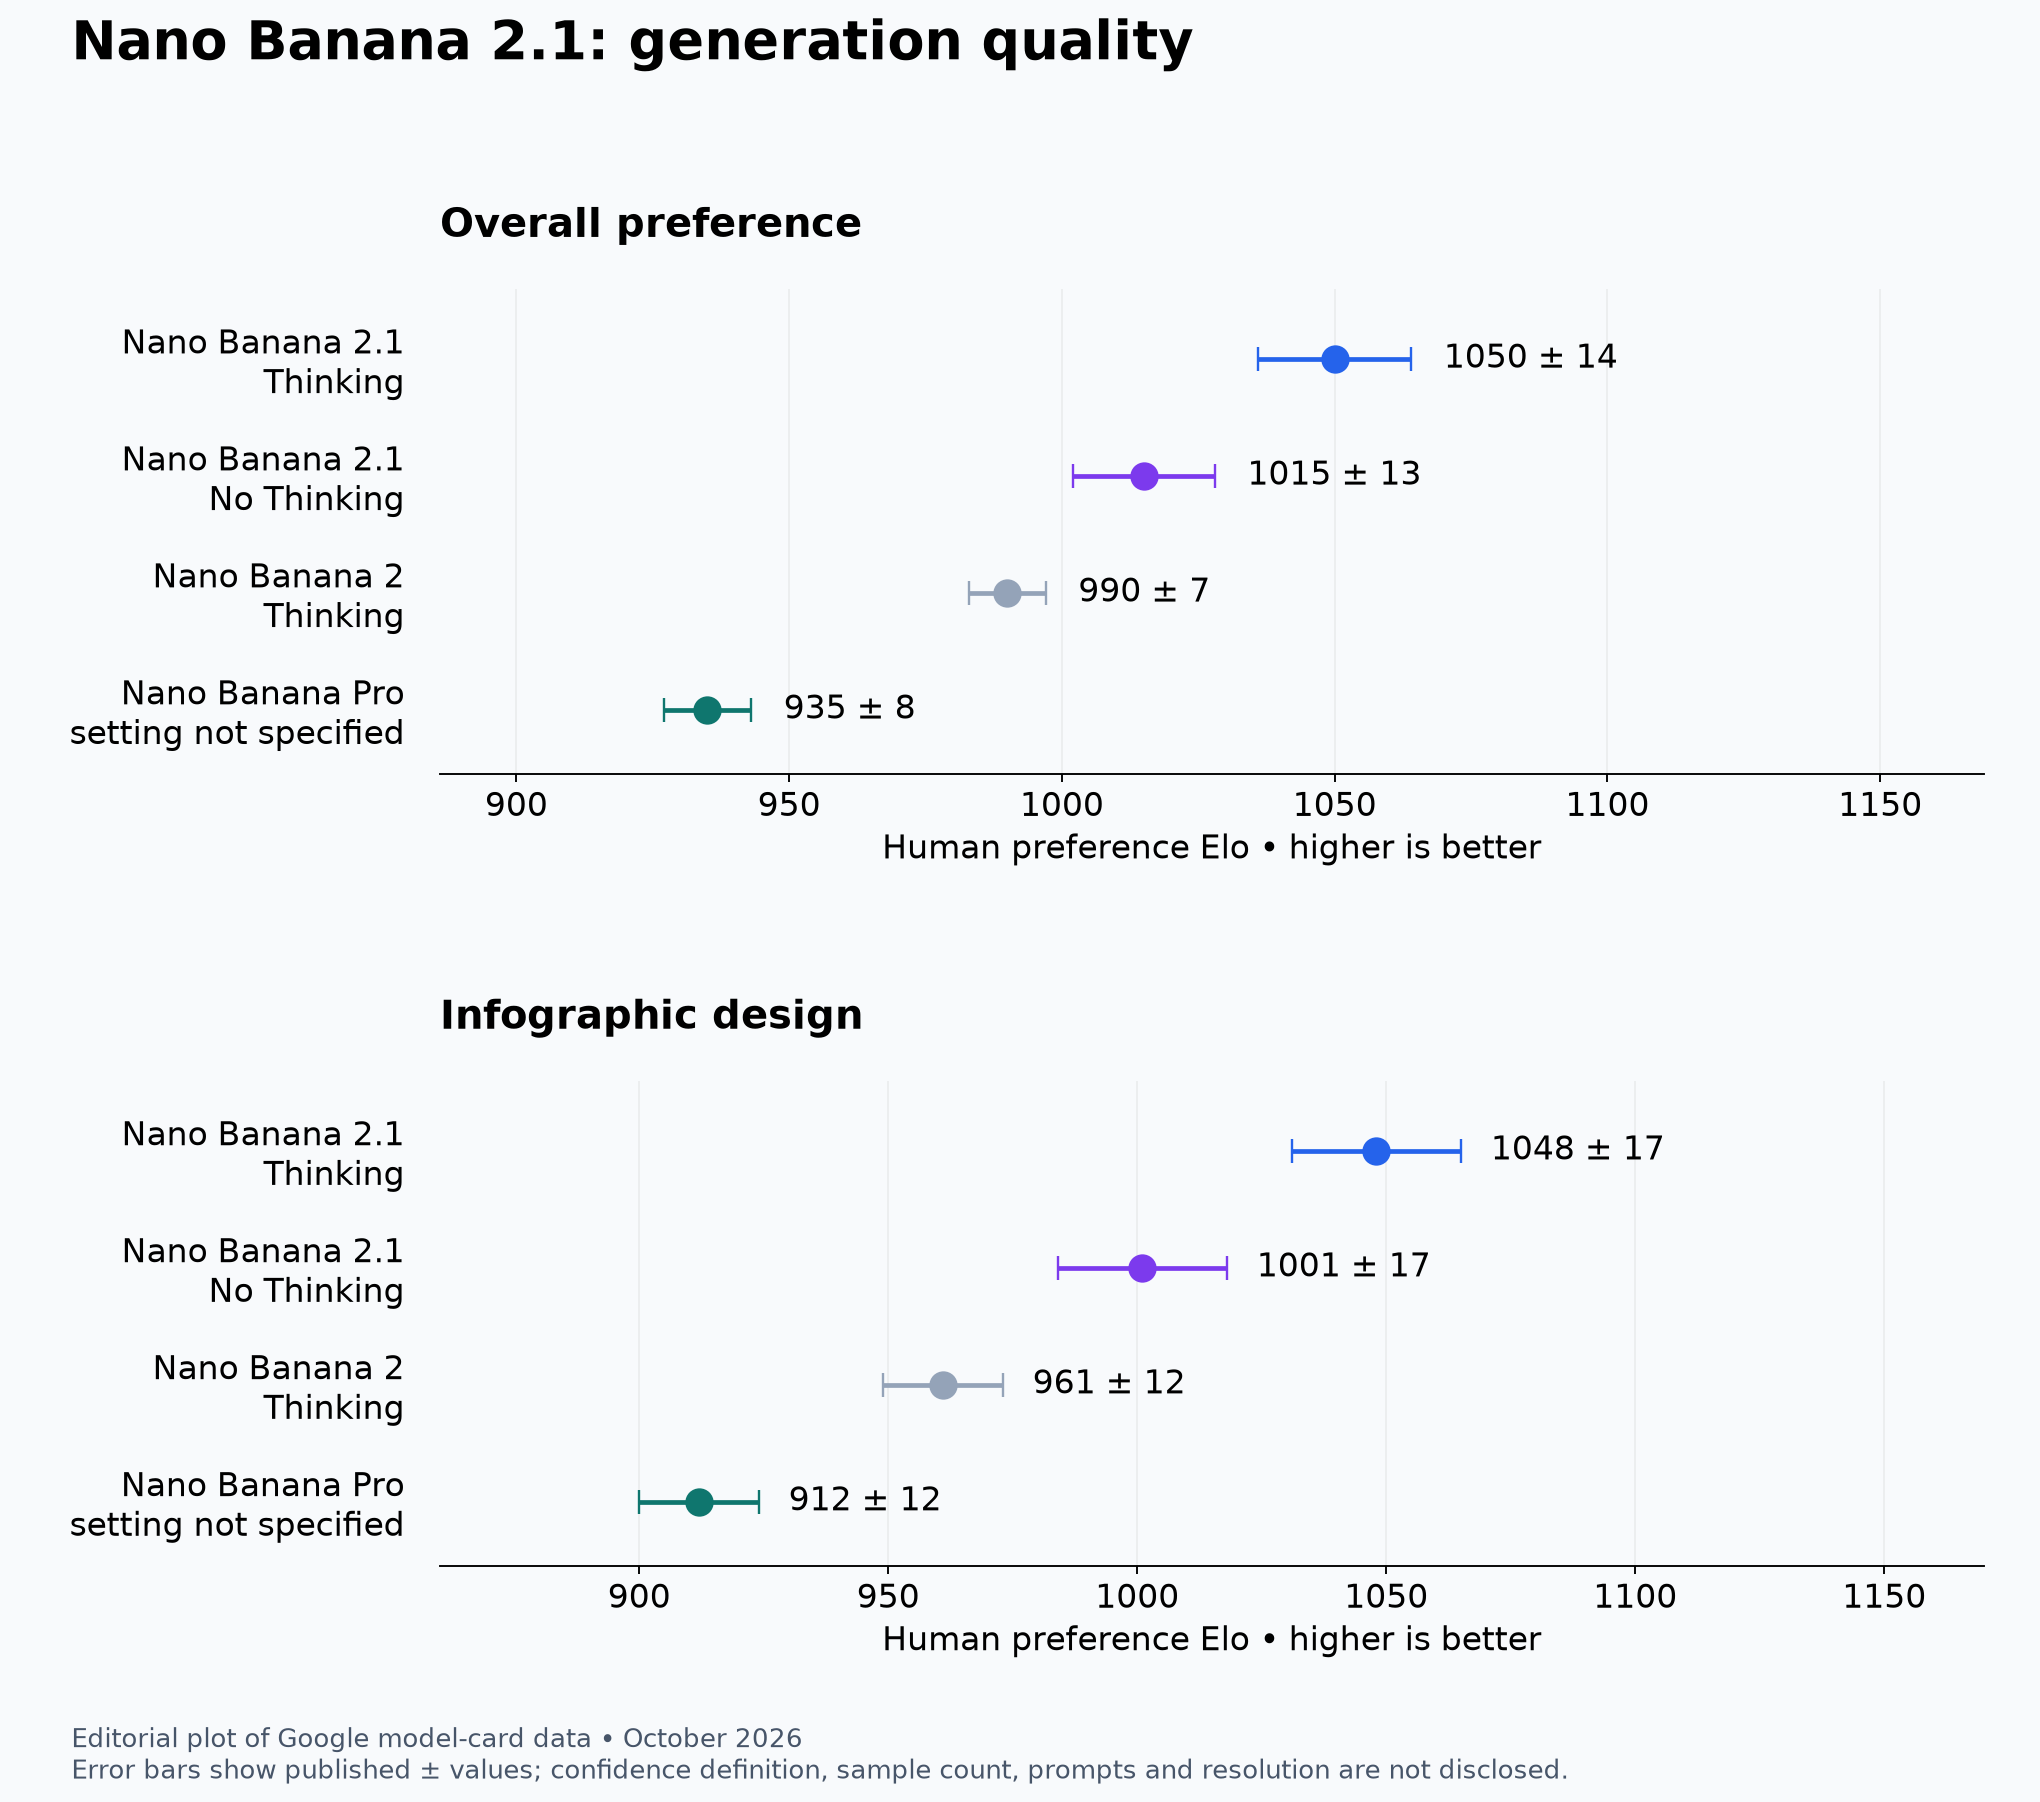
Google の 2026 年 10 月モデルカードの数値を編集部が図示したもので、Google のオリジナル画像ではない。誤差棒は公表範囲を再現しているが、信頼水準も実運用の正答率も確定していない。
全般的な生成は、2.1 Thinking が 1050 ±14、Thinking なしが 1015 ±13、Nano Banana 2 Thinking が 990 ±7、Pro が 935 ±8。インフォグラフィック設計は同じ順で 1048 ±17、1001 ±17、961 ±12、912 ±12 である。表示範囲を考慮しても、2.1 の両方式のインフォグラフィック評価は Nano Banana 2 を上回る。
Thinking の全般的な生成の区間 1036–1064 は、なしの 1002–1028 と重ならない。一方、インフォグラフィックの区間は 1031 で接する。前者の差はより明瞭だが、いずれもすべてのプロンプトでの効果量を示さない。表にある単なる「Thinking」を API の high と同一視することもできない。評価時の設定が明かされていないからだ。
ここから運用上の近道は導けない。選好で上位でも、再試行が減る、待ち時間が短くなる、図のラベルが正しいとは限らない。Google はこの評価のレイテンシを示していない。構図やレイアウトを重視する制作側には 2.1 を試す理由があるが、普遍的な高速化や投資対効果を作り出す根拠はない。
人物が増えると Thinking の判断も変わる
繰り返し登場する一人と、複数の同一性を維持する場面は異なる作業だ。一貫性の評価はその違いを可視化している。
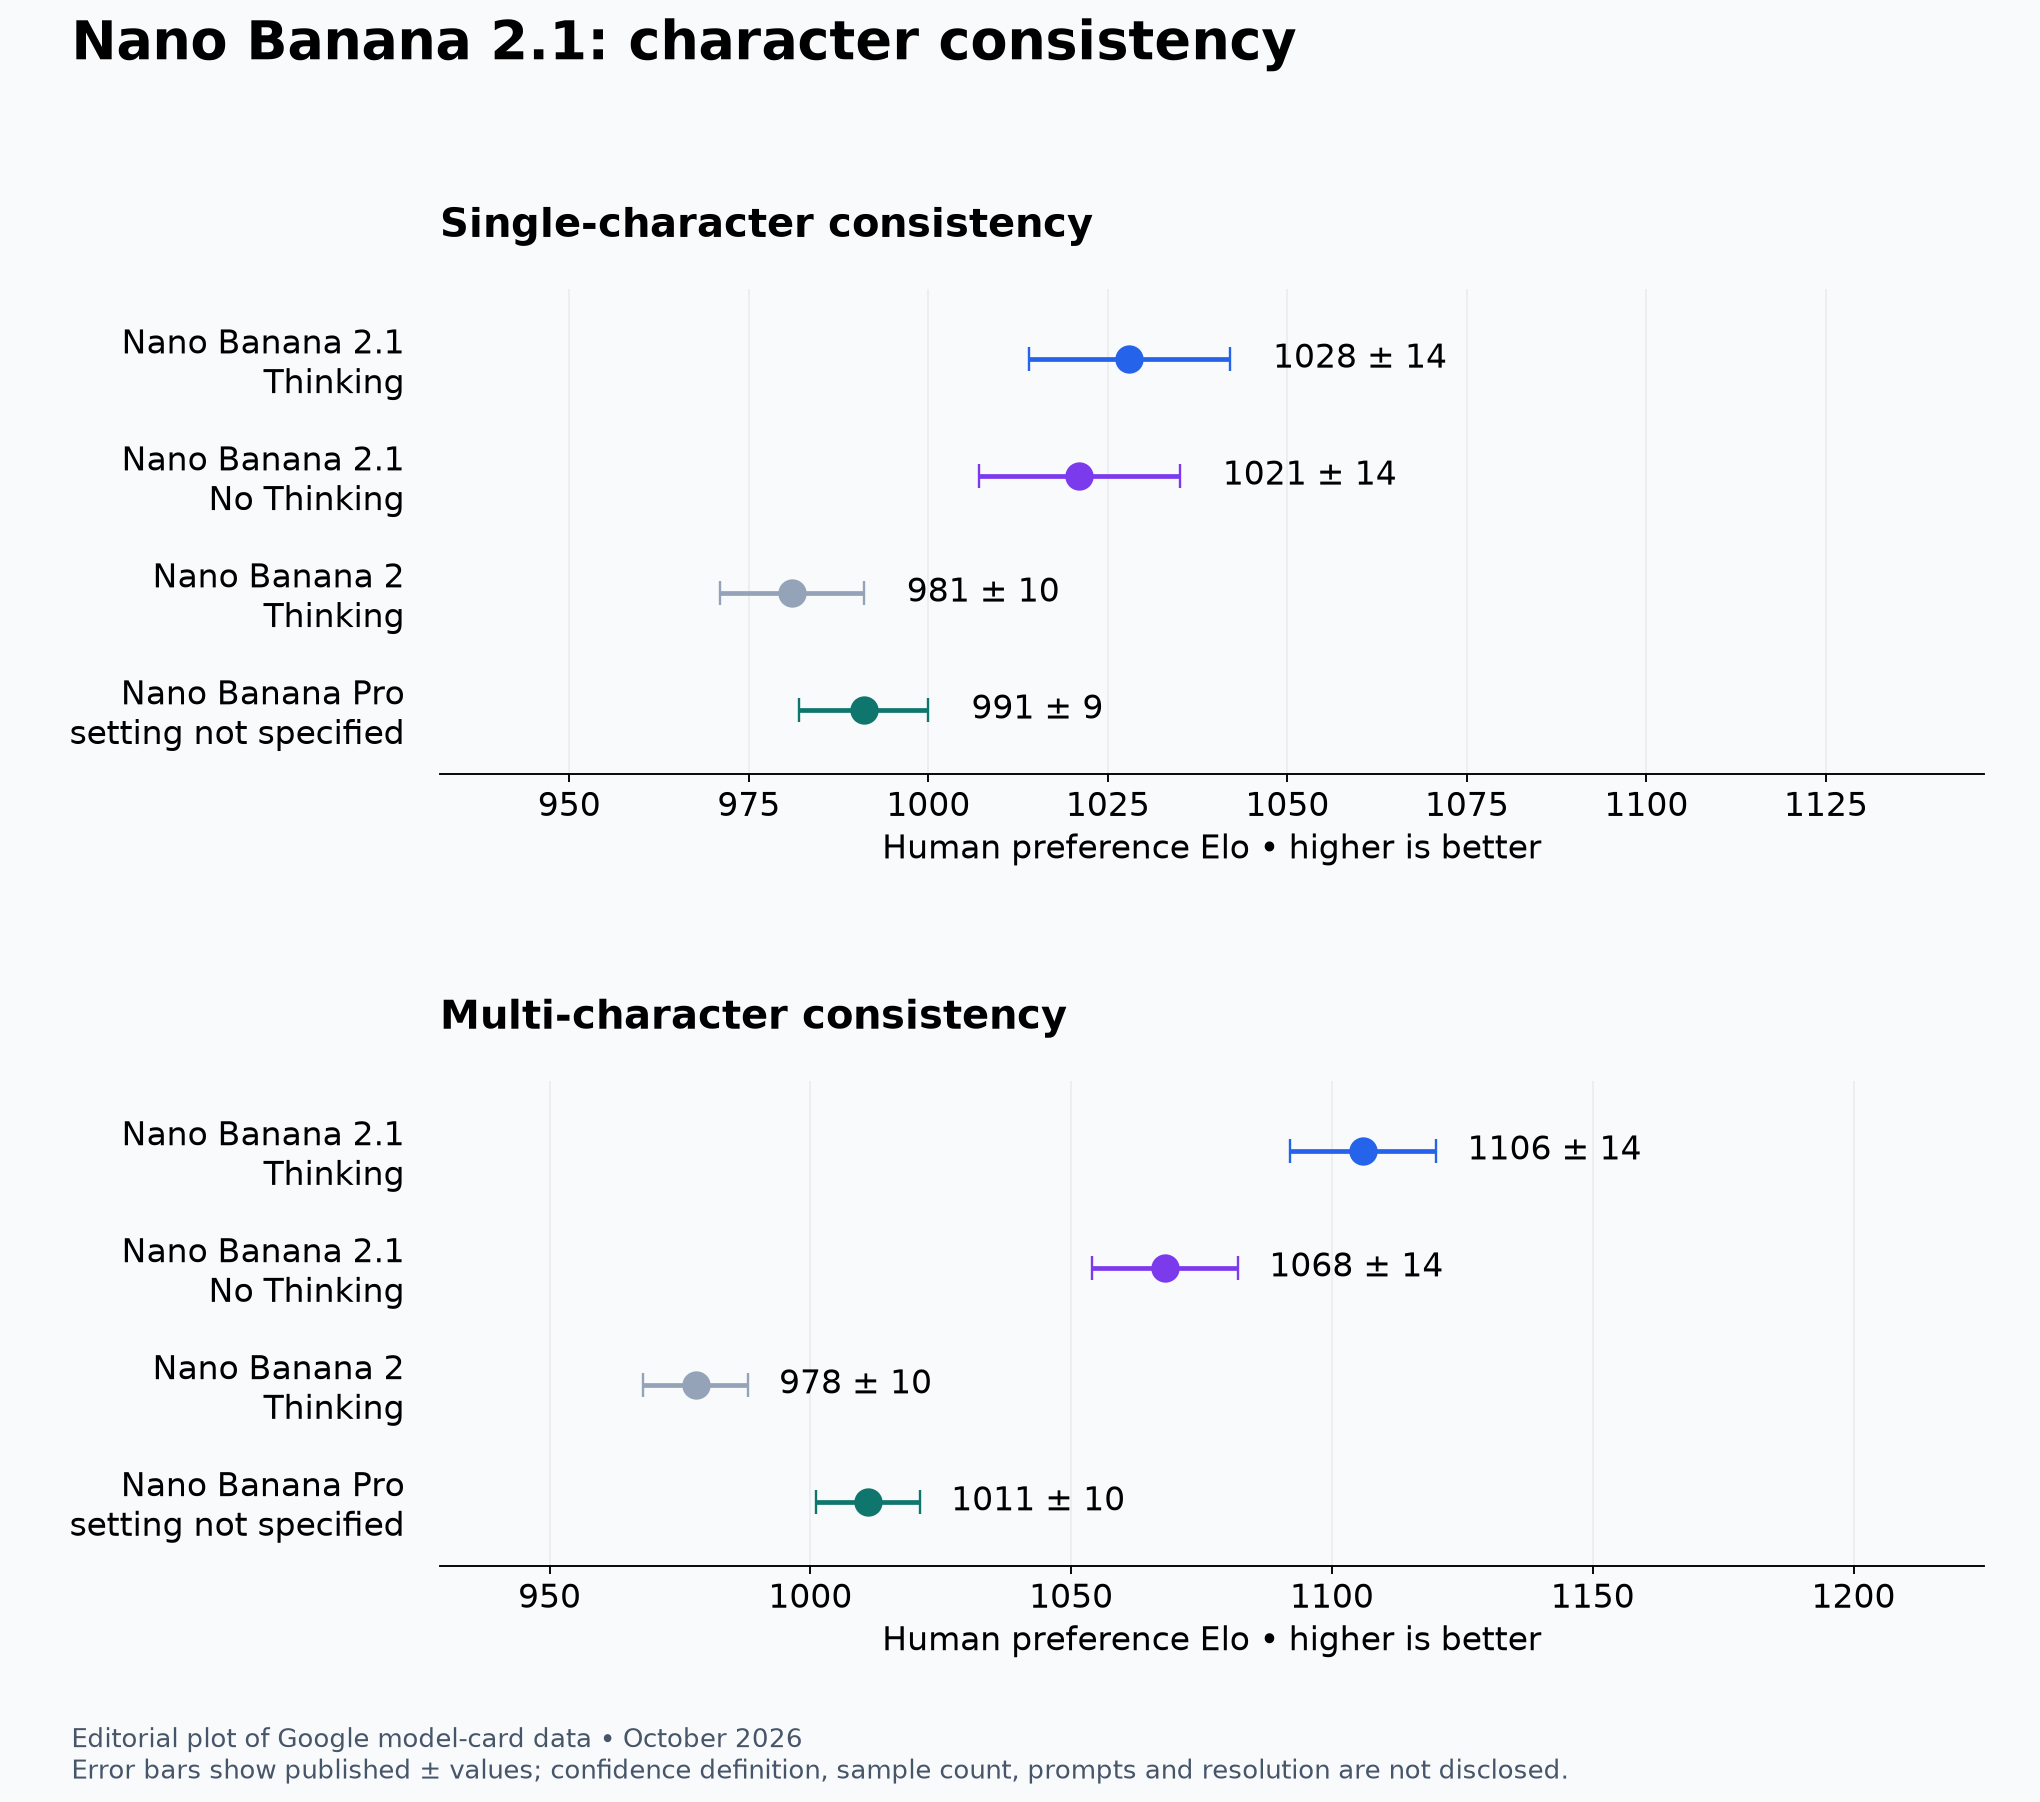
同じ Google モデルカードのデータから作成した編集図。公表範囲の信頼水準は特定されておらず、Google 自身が制作した挿絵ではない。
一人の人物では 2.1 Thinking が 1028 ±14、なしが 1021 ±14。Nano Banana 2 Thinking は 981 ±10、Pro は 991 ±9 である。2.1 の二つの範囲は大きく重なり、中心値の七点差だけでは一人のリクエストすべてに推論が必要とはいえない。
複数人物はより離れる。Thinking は 1106 ±14、なしは 1068 ±14、Pro は 1011 ±10、Nano Banana 2 Thinking は 978 ±10。2.1 の範囲は重ならない。複数の同一性と関係を同時に保つ仕事では Thinking が有望だが、どんな参照画像の組合せでも四人を確実に維持する証明ではない。
見栄えのよい集合画像でも、他人の服を着せたり、一人を消してしまったりする。評価は顔の変化、体形の変化、衣服の移転、人物の重複、相対的な身長の誤りを個別に示さない。切り抜かれた画像、矛盾する画像、照明の不揃いな画像、似た人物の参照では、特に一人ずつ確認する必要がある。美しさへの一票が、素材を使えなくする同一性の欠陥を隠す可能性がある。
編集の強さは「変えてはいけないもの」で異なる
編集にも「Thinking が勝つ」という一つの結論は当てはまらない。マスク、製品の忠実性、参照の合成は、それぞれ別の対象を保護する。
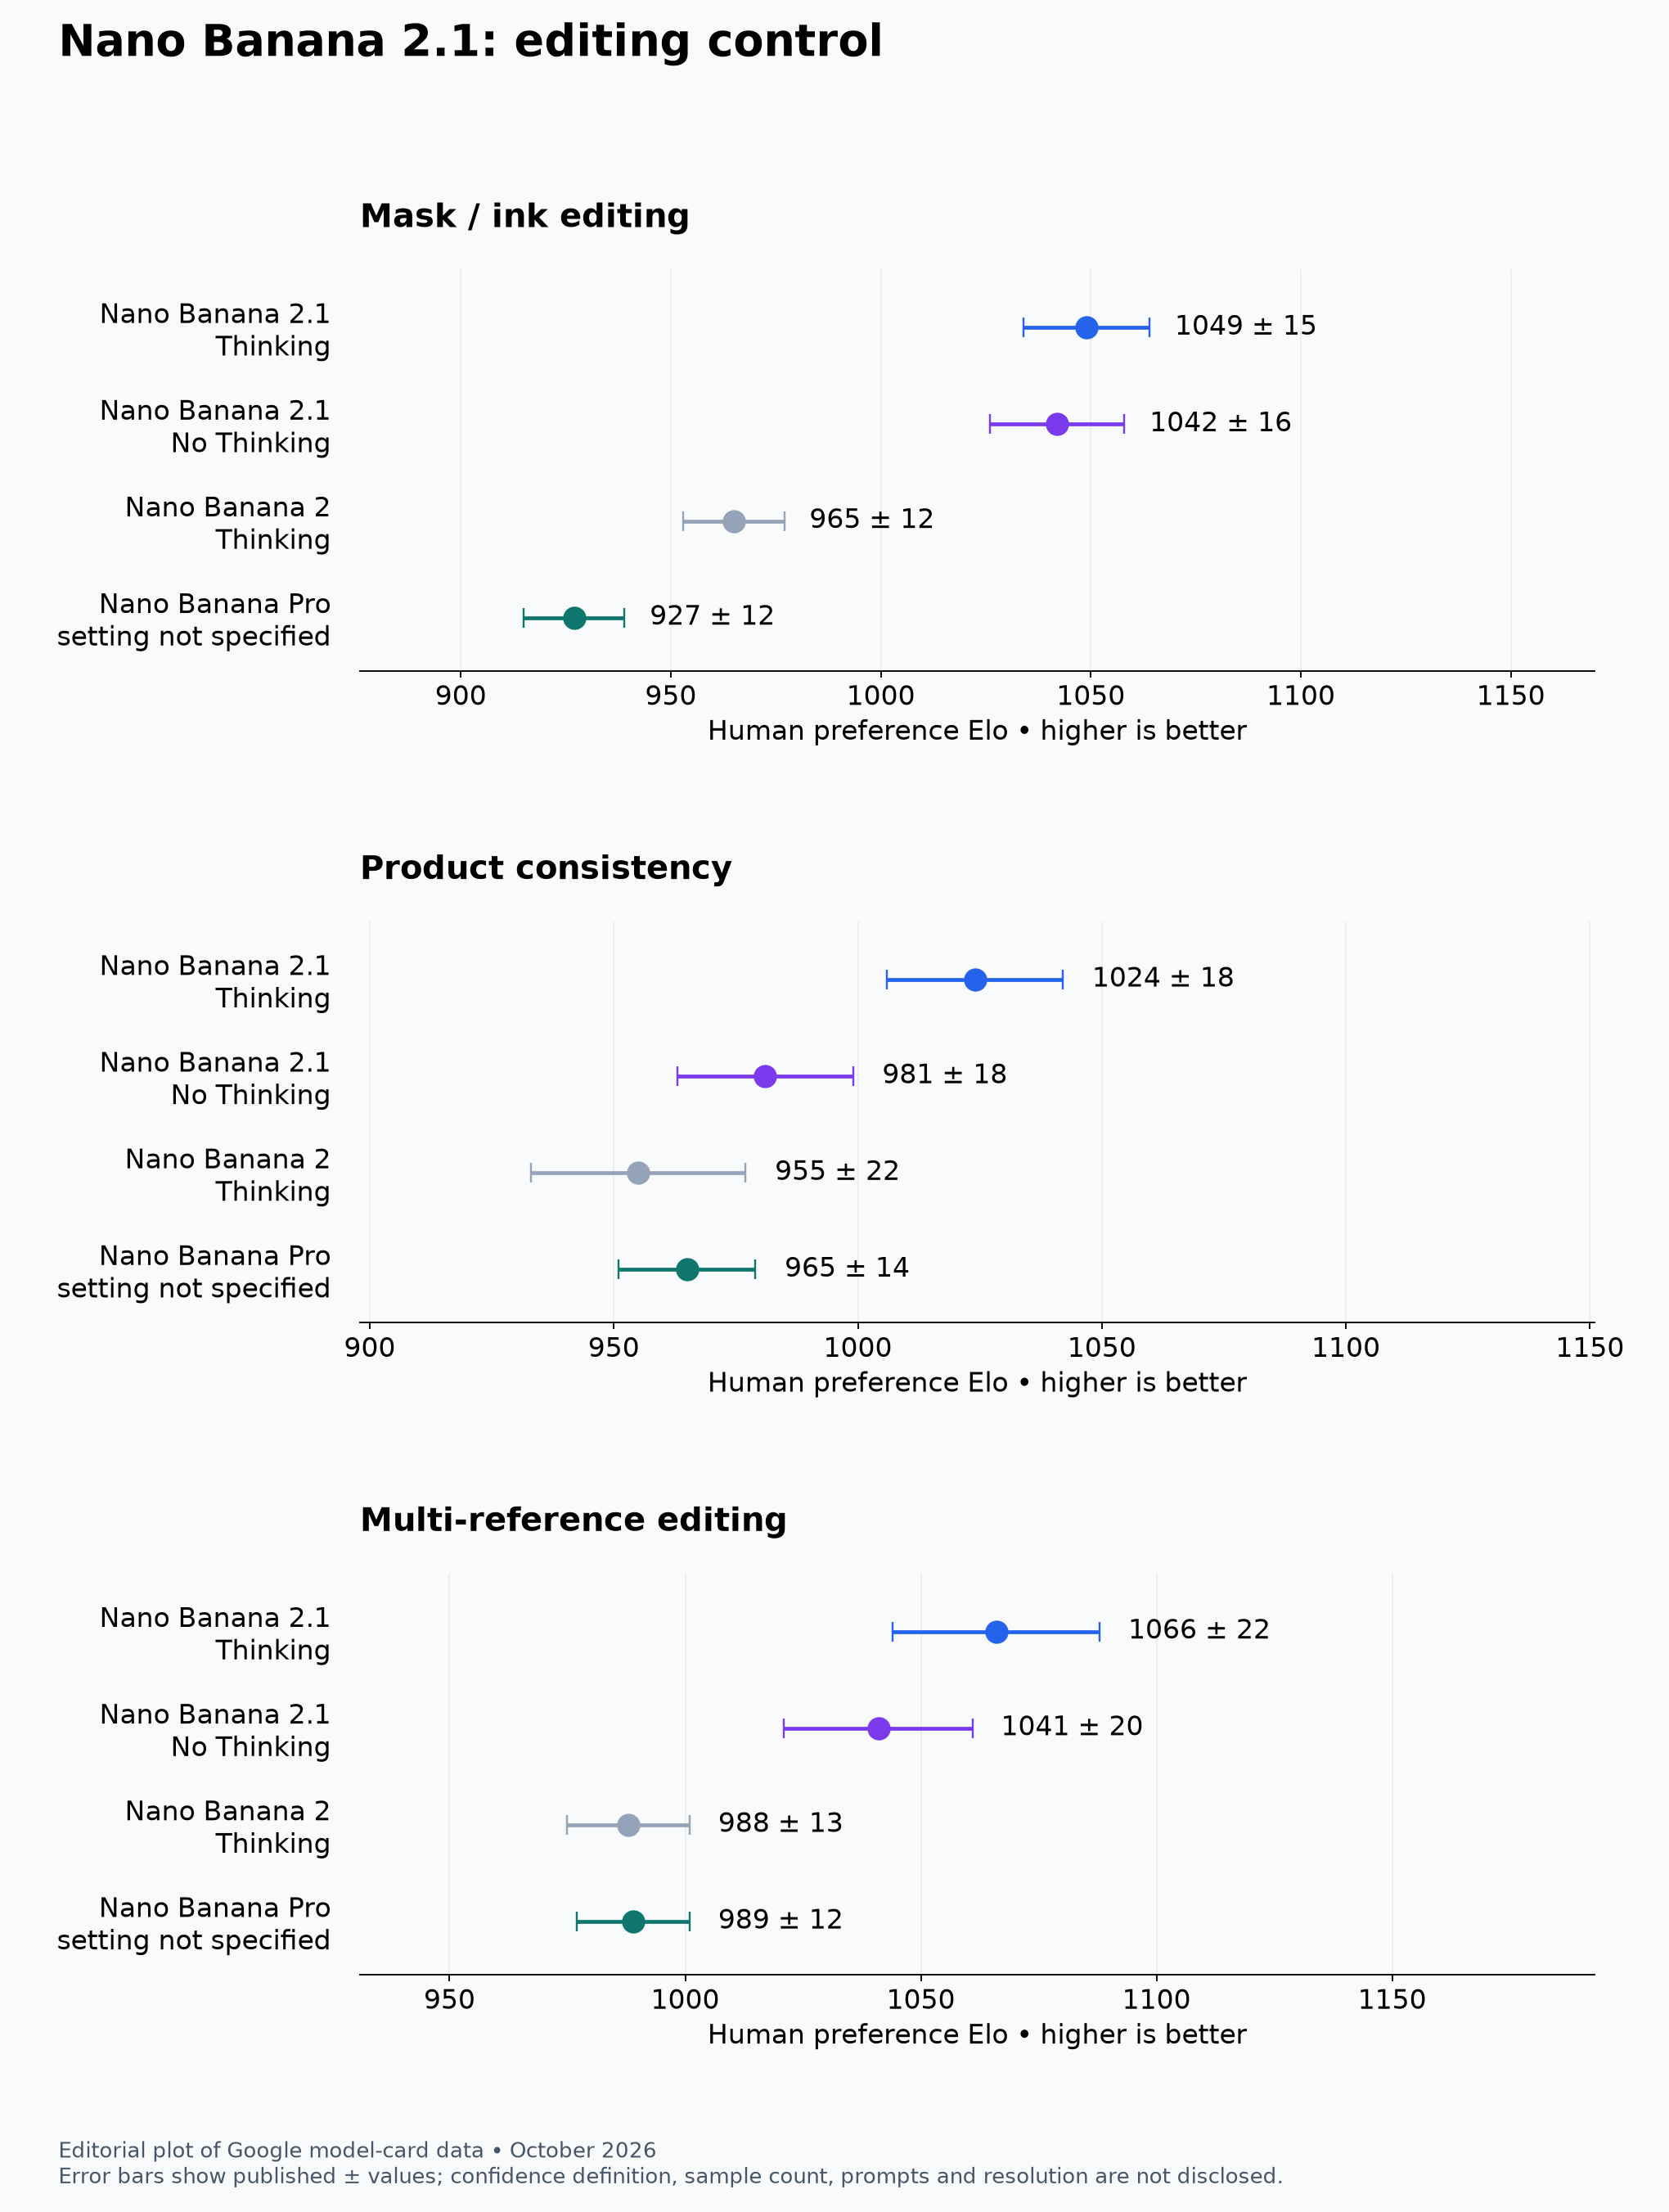
Google のモデルカードに基づく編集図であり、Google の原画ではない。選好 Elo と ± の範囲は、厳密な指示遵守やマスク外の画素が変わらないことを測る指標ではない。
マスクや描画線を使う編集では、2.1 Thinking が 1049 ±15、なしが 1042 ±16 と大幅に重なる。両方とも Nano Banana 2 Thinking の 965 ±12、Pro の 927 ±12 を上回る。この結果は両方式を試す理由にはなるが、中心値七点の差を推論の確定的な利点にするものではない。
製品の一貫性では事情が違う。Thinking は 1024 ±18、なしは 981 ±18、Nano Banana 2 Thinking は 955 ±22、Pro は 965 ±14。Thinking なしの区間は旧二モデルと重なる。今回の比較で Thinking が最良の構成という証拠はあるが、2.1 のすべての構成が製品の忠実性を明確に改善するとはいえない。
複数参照編集は 2.1 Thinking が 1066 ±22、なしが 1041 ±20、Nano Banana 2 Thinking が 988 ±13、Pro が 989 ±12。2.1 は強い結果だが、その二つの範囲は重なるため、中心値の 25 点差を無条件の推奨にしてはいけない。
Google はマスク指示への部分的な対応、インクの残留、元のポーズの意図しない維持を認めている。好まれた編集でも保存条件には失敗し得る。通販素材ではポート、ロゴ、数量、材質、包装の文字が変われば、見栄えがよくても不採用になる。創作的な合成で許される形状の変化を、製品説明が許すとは限らない。平均した一つの編集点ではなく、別々の合格基準が必要だ。
事実性 0.521 は正答率 52.1% ではない
インフォグラフィックの事実性は、人間の選好比較とは異なる単側の自動評価である。Google は 2.1 Thinking を 0.521、なしを 0.328、Pro を 0.265、Nano Banana 2 Thinking を 0.179 と報告する。
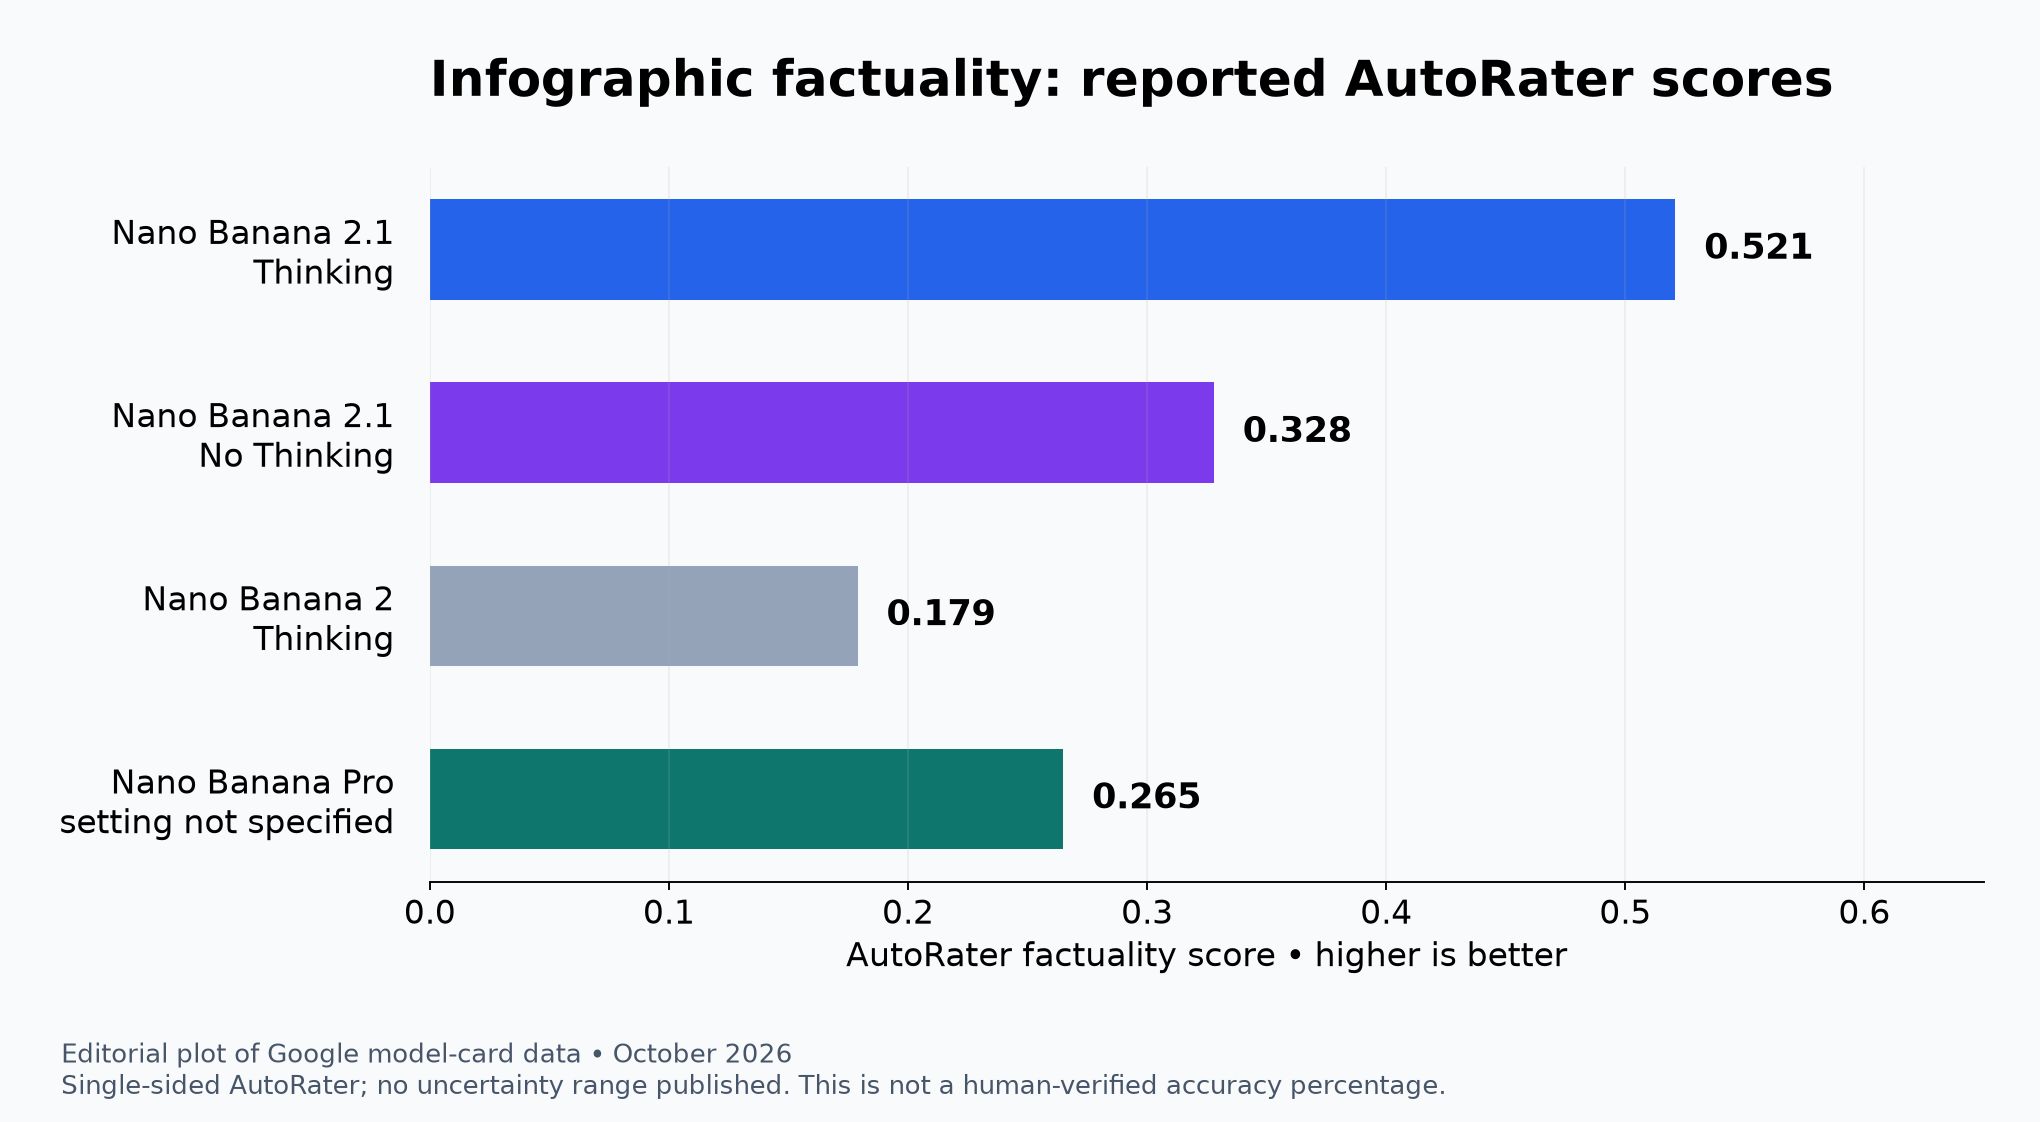
Google の自動評価データを編集部が作図したもの。これらに不確実性の範囲は公表されていない。Google の原画でも、事実が正しい画像の割合でもない。
この指標では Thinking が上位だが、方法、サンプル、不確実性の説明は、実運用の事実誤り率を計算するには足りない。文章が正しくてもプロット値が誤る図、順序が逆の年表、地域が入れ替わった地図、対象を取り違えたラベルはあり得る。公開表は自動評価がどの失敗を確実に捉えるかを示していない。
検索グラウンディングは情報を取得できても、正しく画像に転写するとは限らない。基盤モデルのカードには知識の期限が 2026 年 3 月とあり、一部領域は 2025 年 1 月まで、別の領域ではより新しい情報も含まれる。新しそうな図であっても、提供または検索した根拠と完成画像を照合する必要がある。
管理すべき単位は事実シートだ。数値、単位、日付、ラベル、引用を生成前に承認し、その後画像を確認する。追跡可能な事実と出典ブリーフは証拠と見た目を分離する助けになるが、生成画像が自動検証済みになるわけではない。医療、金融、法律、科学、時事の図表で、AutoRater の値を公開許可にはできない。
出力が安くても、合格素材が安いとは限らない
標準の有料 API 料金では画像出力は 2.1 が百万トークン当たり 30 ドル、Nano Banana 2 が 60 ドル。ただし 4K のトークン割当が異なるため、半減の意味も変わる。
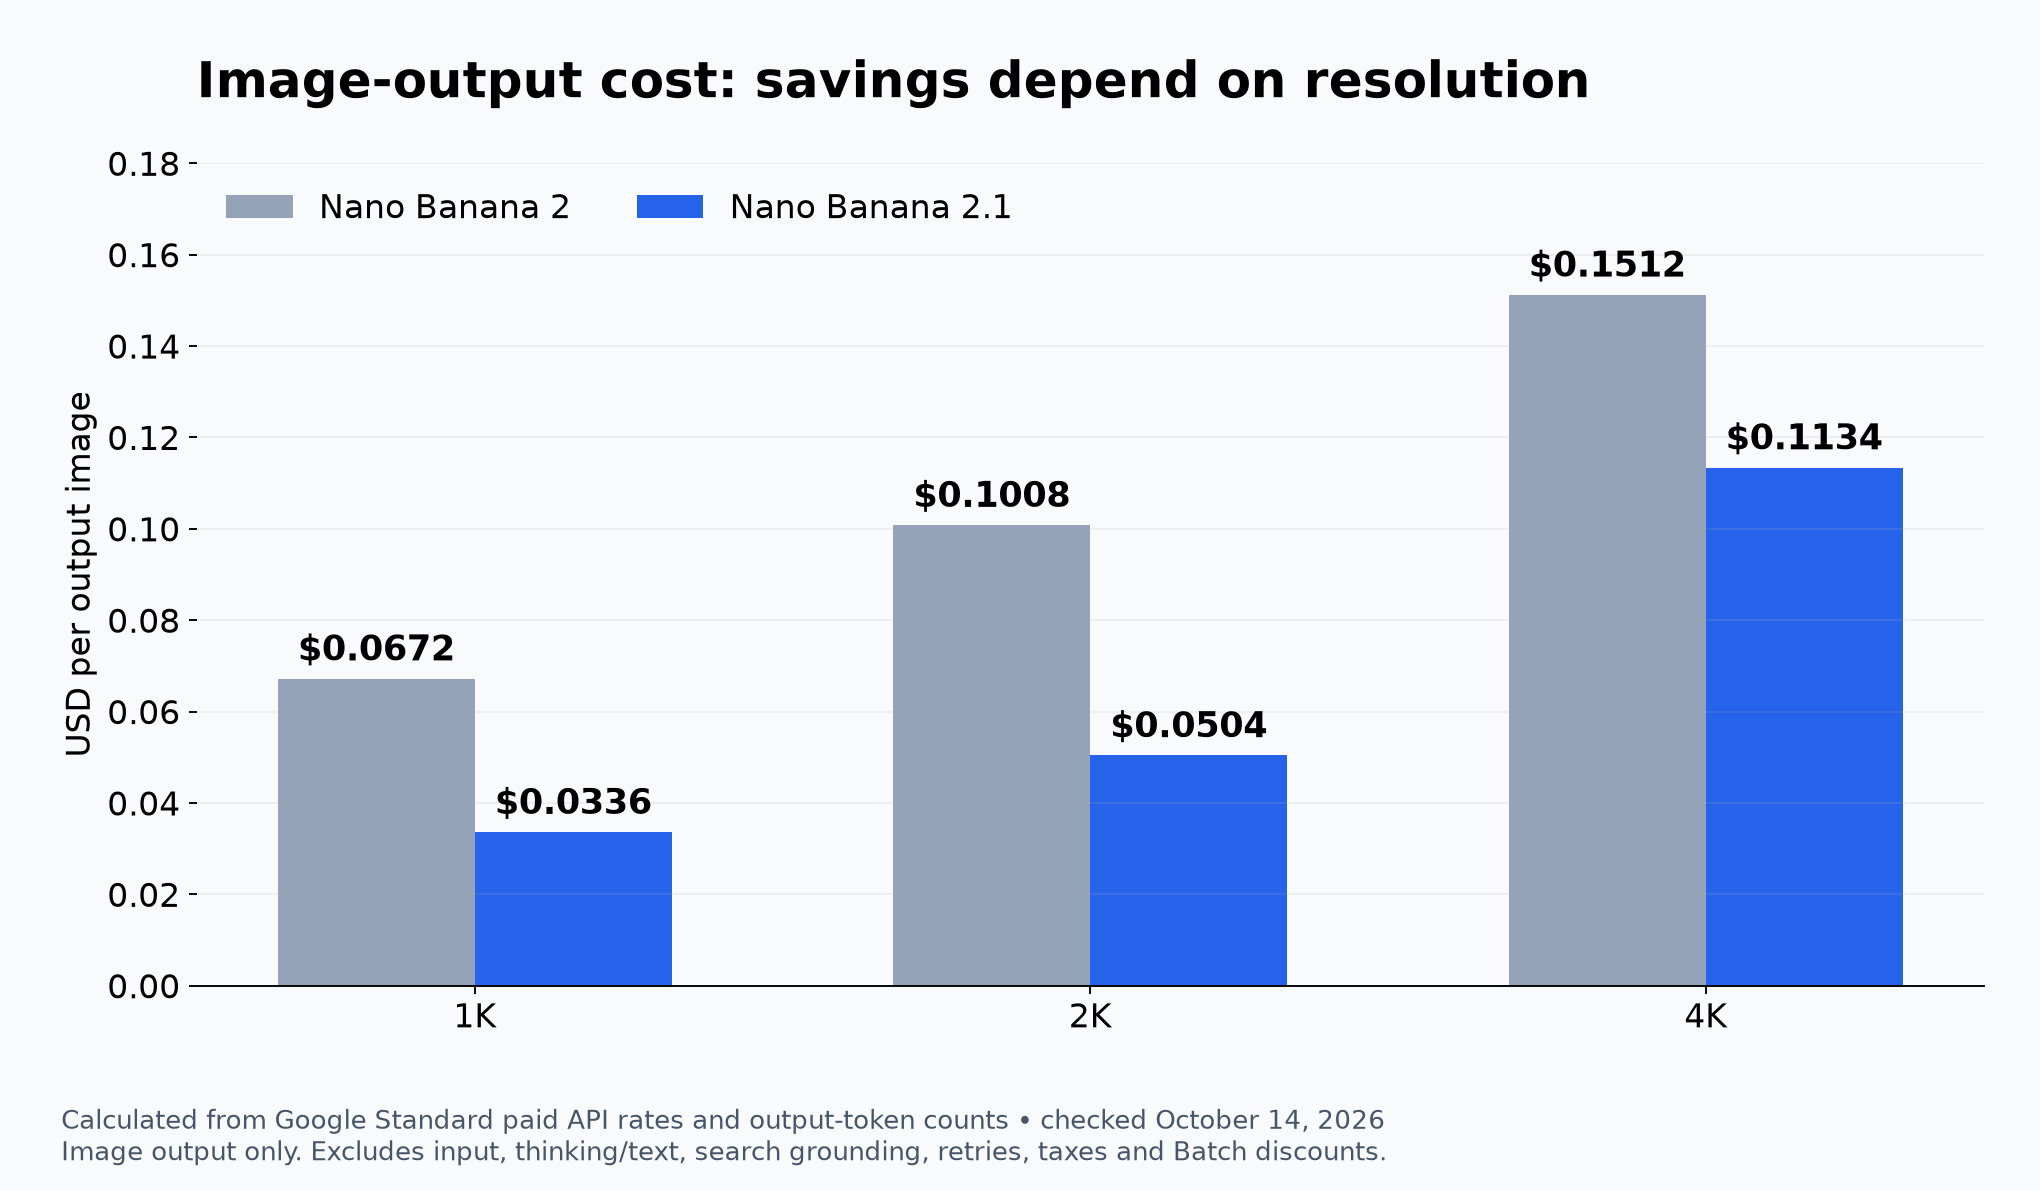
10 月 14 日時点で公表された Google の料金と割当からの編集計算。出力だけの費用で、実測した総リクエスト費用でも Google の原図でもない。
1K は双方 1,120 画像トークンで、2.1 が 0.0336 ドル、Nano Banana 2 が 0.0672 ドル。2K は 1,680 トークンで 0.0504 ドル対 0.1008 ドルとなり、いずれも出力部分は 50% 減だ。
4K は 2.1 が 3,780 トークン、Nano Banana 2 が 2,520 トークン。各料金を掛けると 0.1134 ドル対 0.1512 ドルで、削減は 25% にとどまる。トークン数が増えれば単価半減は画像価格半減ではない。
他の要素は値上がりする。2.1 の標準のテキスト・画像・動画入力は百万トークン当たり 1.50 ドル、Nano Banana 2 のテキスト・画像入力は 0.50 ドル。テキストと Thinking の出力は 7.50 ドル対 3 ドルだ。グラウンディング、参照画像、テキスト出力、推論、再試行、税、適用される Batch 割引も請求全体に影響する。
その使用量の仮定なしに、典型的なリクエストの総額は責任を持って出せない。初回の合格率向上が推論料金を補う場合も、再試行増加で出力の節約が消える場合もある。見るべきは合格素材一件当たりのコストと実測の待ち時間・タイムアウト率であり、孤立した出力トークン単価ではない。
移行には同じ課題を対にした証拠が必要
有用な試験では、現行モデルと 2.1 の各 Thinking 段階に、同じ実務のプロンプトと参照ファイルを与え、縦横比、解像度、再試行回数を揃える。これは評価の提案であって、AI Tools Radar が実施した試験ではない。Pro は実際に導入可能な場合だけ含め、評価で未指定の設定が同等だとは仮定しない。
一人・複数人物、製品編集、マスク、参照合成、文字の多いレイアウト、事実図表を分ける。厳密な文字は転記して比較し、マスクは許可領域の内外を確認し、製品は保護対象を確認する。盲検の選好判断は補助にはなるが、ロゴや数字を変えてはいけない場合の厳密な検証は置き換えられない。
異なるリスクを一つの平均に潰さず、対になった結果と不確実性を残す。運用記録には端から端までの待ち時間、タイムアウト、再試行、トークン消費、合格画像一件の費用を含める。シャドー運用で初めて、評価上の利点が実際の修正回数を減らすかが分かる。
移行を急がせる「10 月 29 日廃止」という期限には根拠がない。非推奨情報の参照先では Gemini 3.1 Flash Image は非推奨とされるものの、停止日は発表されていない。もちろん無期限提供の約束でもない。
2.1 を優先して試す理由が強いのは、インフォグラフィックのレイアウト、複数人物の継続性、参照合成、低い画像出力料金だ。Thinking は複数人物と事実性で注目に値する一方、結果が重なる作業では簡単な構成にも余地がある。小さい文字、事実、厳密な同一性、製品領域の保存が必須なら、新エンドポイントが条件を満たすまで外部検証と代替手段を残す。公表された首位は比較を始める理由であり、比較そのものの代わりではない。