
Nano Banana 2.1 给图像生产团队带来两项不同的承诺:在 Google 的对比中表现更好,以及生成图像 token 的收费更低。但其中任何一项,都不能单独证明一份可发布素材更便宜。真正的问题是,这些测得的优势能否满足实际任务对身份、事实、受保护产品细节和完整重试成本的要求。
本文是 10 月 14 日对 Google 在 10 月 6 日正式推出版本的后续分析,并非介绍当天的新发布。最强的信号来自信息图偏好、多角色一致性及部分编辑任务。最容易误读的地方,则是把偏好分数当准确率、认为所有任务都同样受益于 Thinking,或把所有请求都称为半价。
实际端点的限制比模型卡更窄
API 更新记录列出的稳定模型代码是 gemini-nano-banana-2.1。Google 将它定义为 Gemini 3.1 Flash Image,也就是 Nano Banana 2 的 Flash 级更新,而非新的 Pro 模型。模型卡说明它基于 Gemini 3.6 Flash,输入文本和图像,输出图像和文本。
部署细节与模型血统同样重要。端点文档规定默认输出 1K,最高支持 4K;Thinking 有 minimal、medium、high 三档,默认 medium。它支持搜索增强(grounding),但不支持函数调用、代码执行和结构化输出。需要这些功能的应用,必须在图像模型之外安排编排和检查。
容量还存在未解释的差异。模型卡描述最高 100 万上下文 token 和 64K 文本输出,Gemini API 页面却列出 131,072 输入和 32,768 输出 token。来源文档没有解释两者关系。部署应按实际调用端点的已公布上限做预算,不能默认为更大的架构级数字都已开放。
多图融合最多接受 14 张参考图,其中包括最多四个角色和十个物体。这是输入上限,不是对十四张参考图或四个独立身份都能准确保留的保证。
模型卡还列出小字或长文字模糊破碎、身份漂移、左右混淆、3D 推理和事实知识不完善,以及偶发缓慢和超时。蒙版残墨与姿势延续则是另一些编辑风险。这些已承认的限制需要明确失败标准和备用方案;参考图或上下文容量更大,并不会消除它们。
生成优势是偏好证据,不是正确率
Google 的生成结果采用人类偏好 Elo,而不是统计“正确图片所占比例”。公布的 ± 范围有参考价值,但没有说明置信水平;样本数、提示词、分辨率、重试额度、具体 Thinking 设置及是否同等算力,也没有披露。
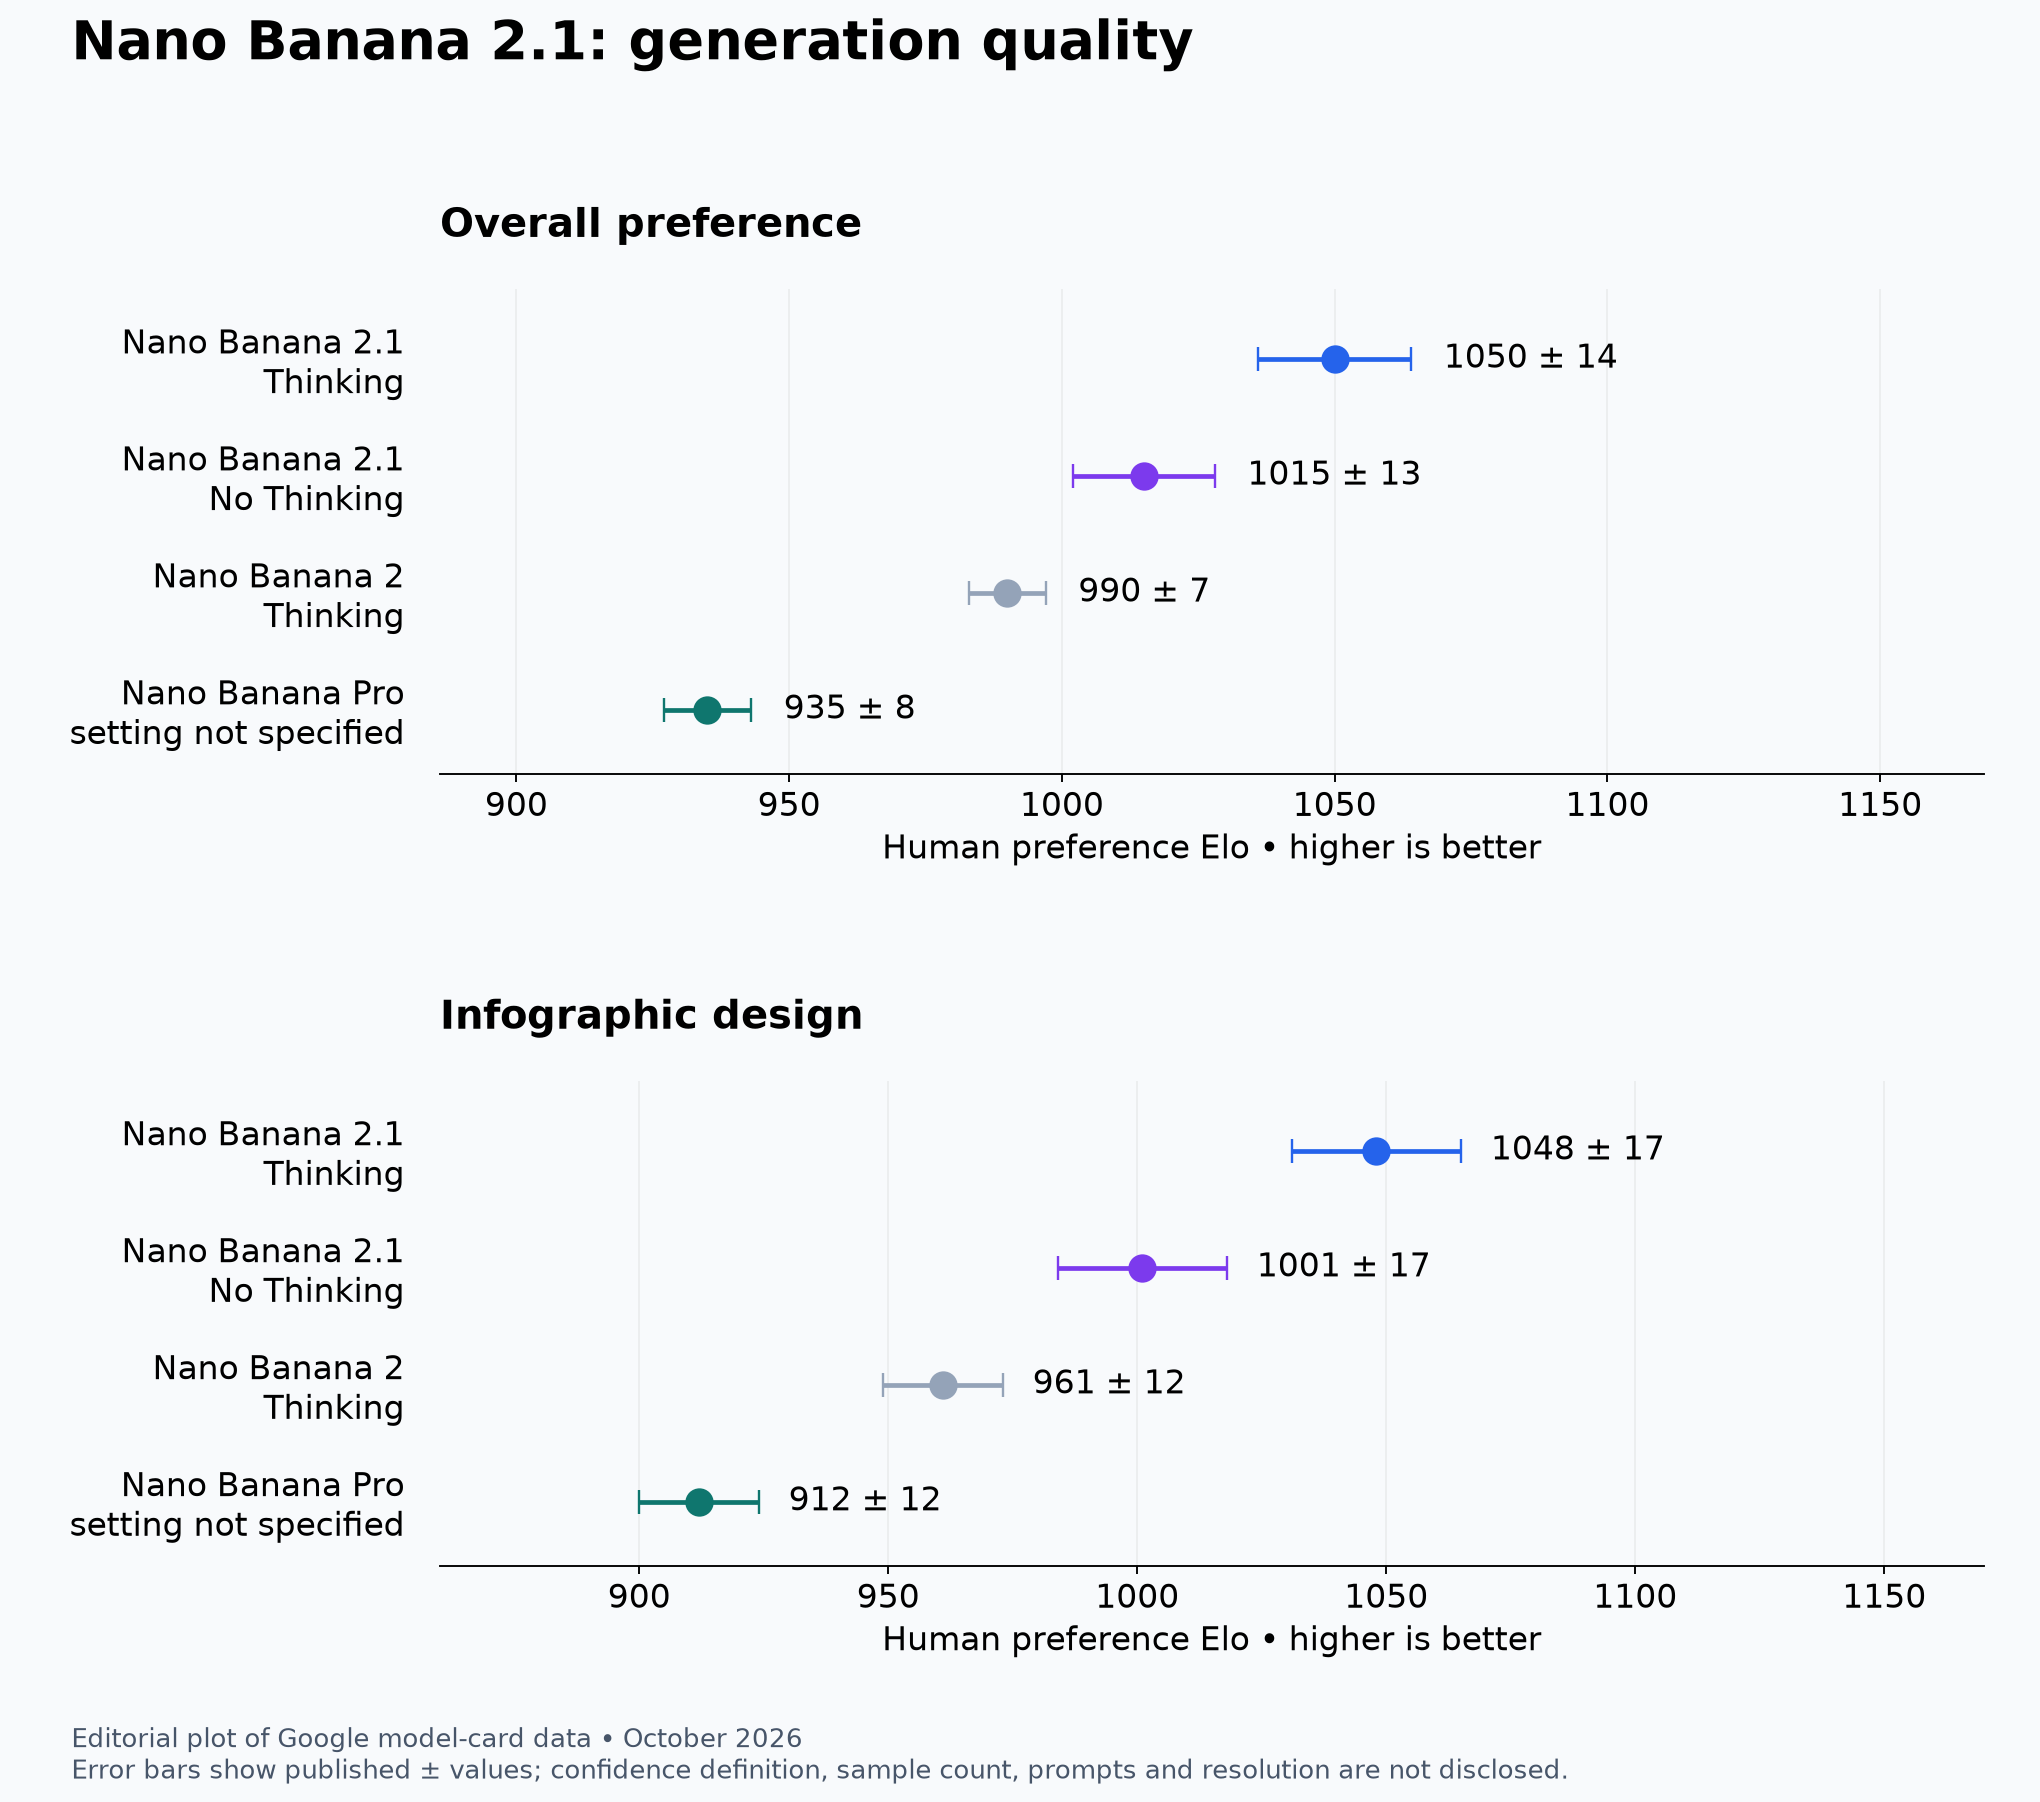
这是根据 Google 2026 年 10 月模型卡数据制作的编辑图表,不是 Google 原始图片。误差线复现已公布范围;其置信定义和生产准确率均未得到确立。
整体生成中,2.1 Thinking 为 1050 ±14,不开 Thinking 为 1015 ±13,Nano Banana 2 Thinking 为 990 ±7,Pro 为 935 ±8。按同样顺序,信息图设计分别是 1048 ±17、1001 ±17、961 ±12 和 912 ±12。即使考虑显示范围,2.1 两种模式的信息图结果仍高于 Nano Banana 2。
Thinking 的整体区间是 1036–1064,与不开 Thinking 的 1002–1028 不重叠;信息图设计的两个区间则在 1031 处相接。前者区分更明显,但两者都不能证明每个提示词上都有同样收益。评测只标“Thinking”,不能等同于 API 的 high 档,因为具体评测配置没有公开。
这一区别决定了不能直接走捷径:偏好领先不代表重试更少、延迟更低或图表标签正确。这里没有 Google 的基准延迟数据。创意团队有理由测试 2.1,尤其是排版和构图,却没有依据编造普适的提速或投资回报结论。
多角色场景改变 Thinking 的价值
单个反复出现的角色,与需要维持多个身份的场景,是不同工作负载。一致性测试将这种差别直接显示出来。
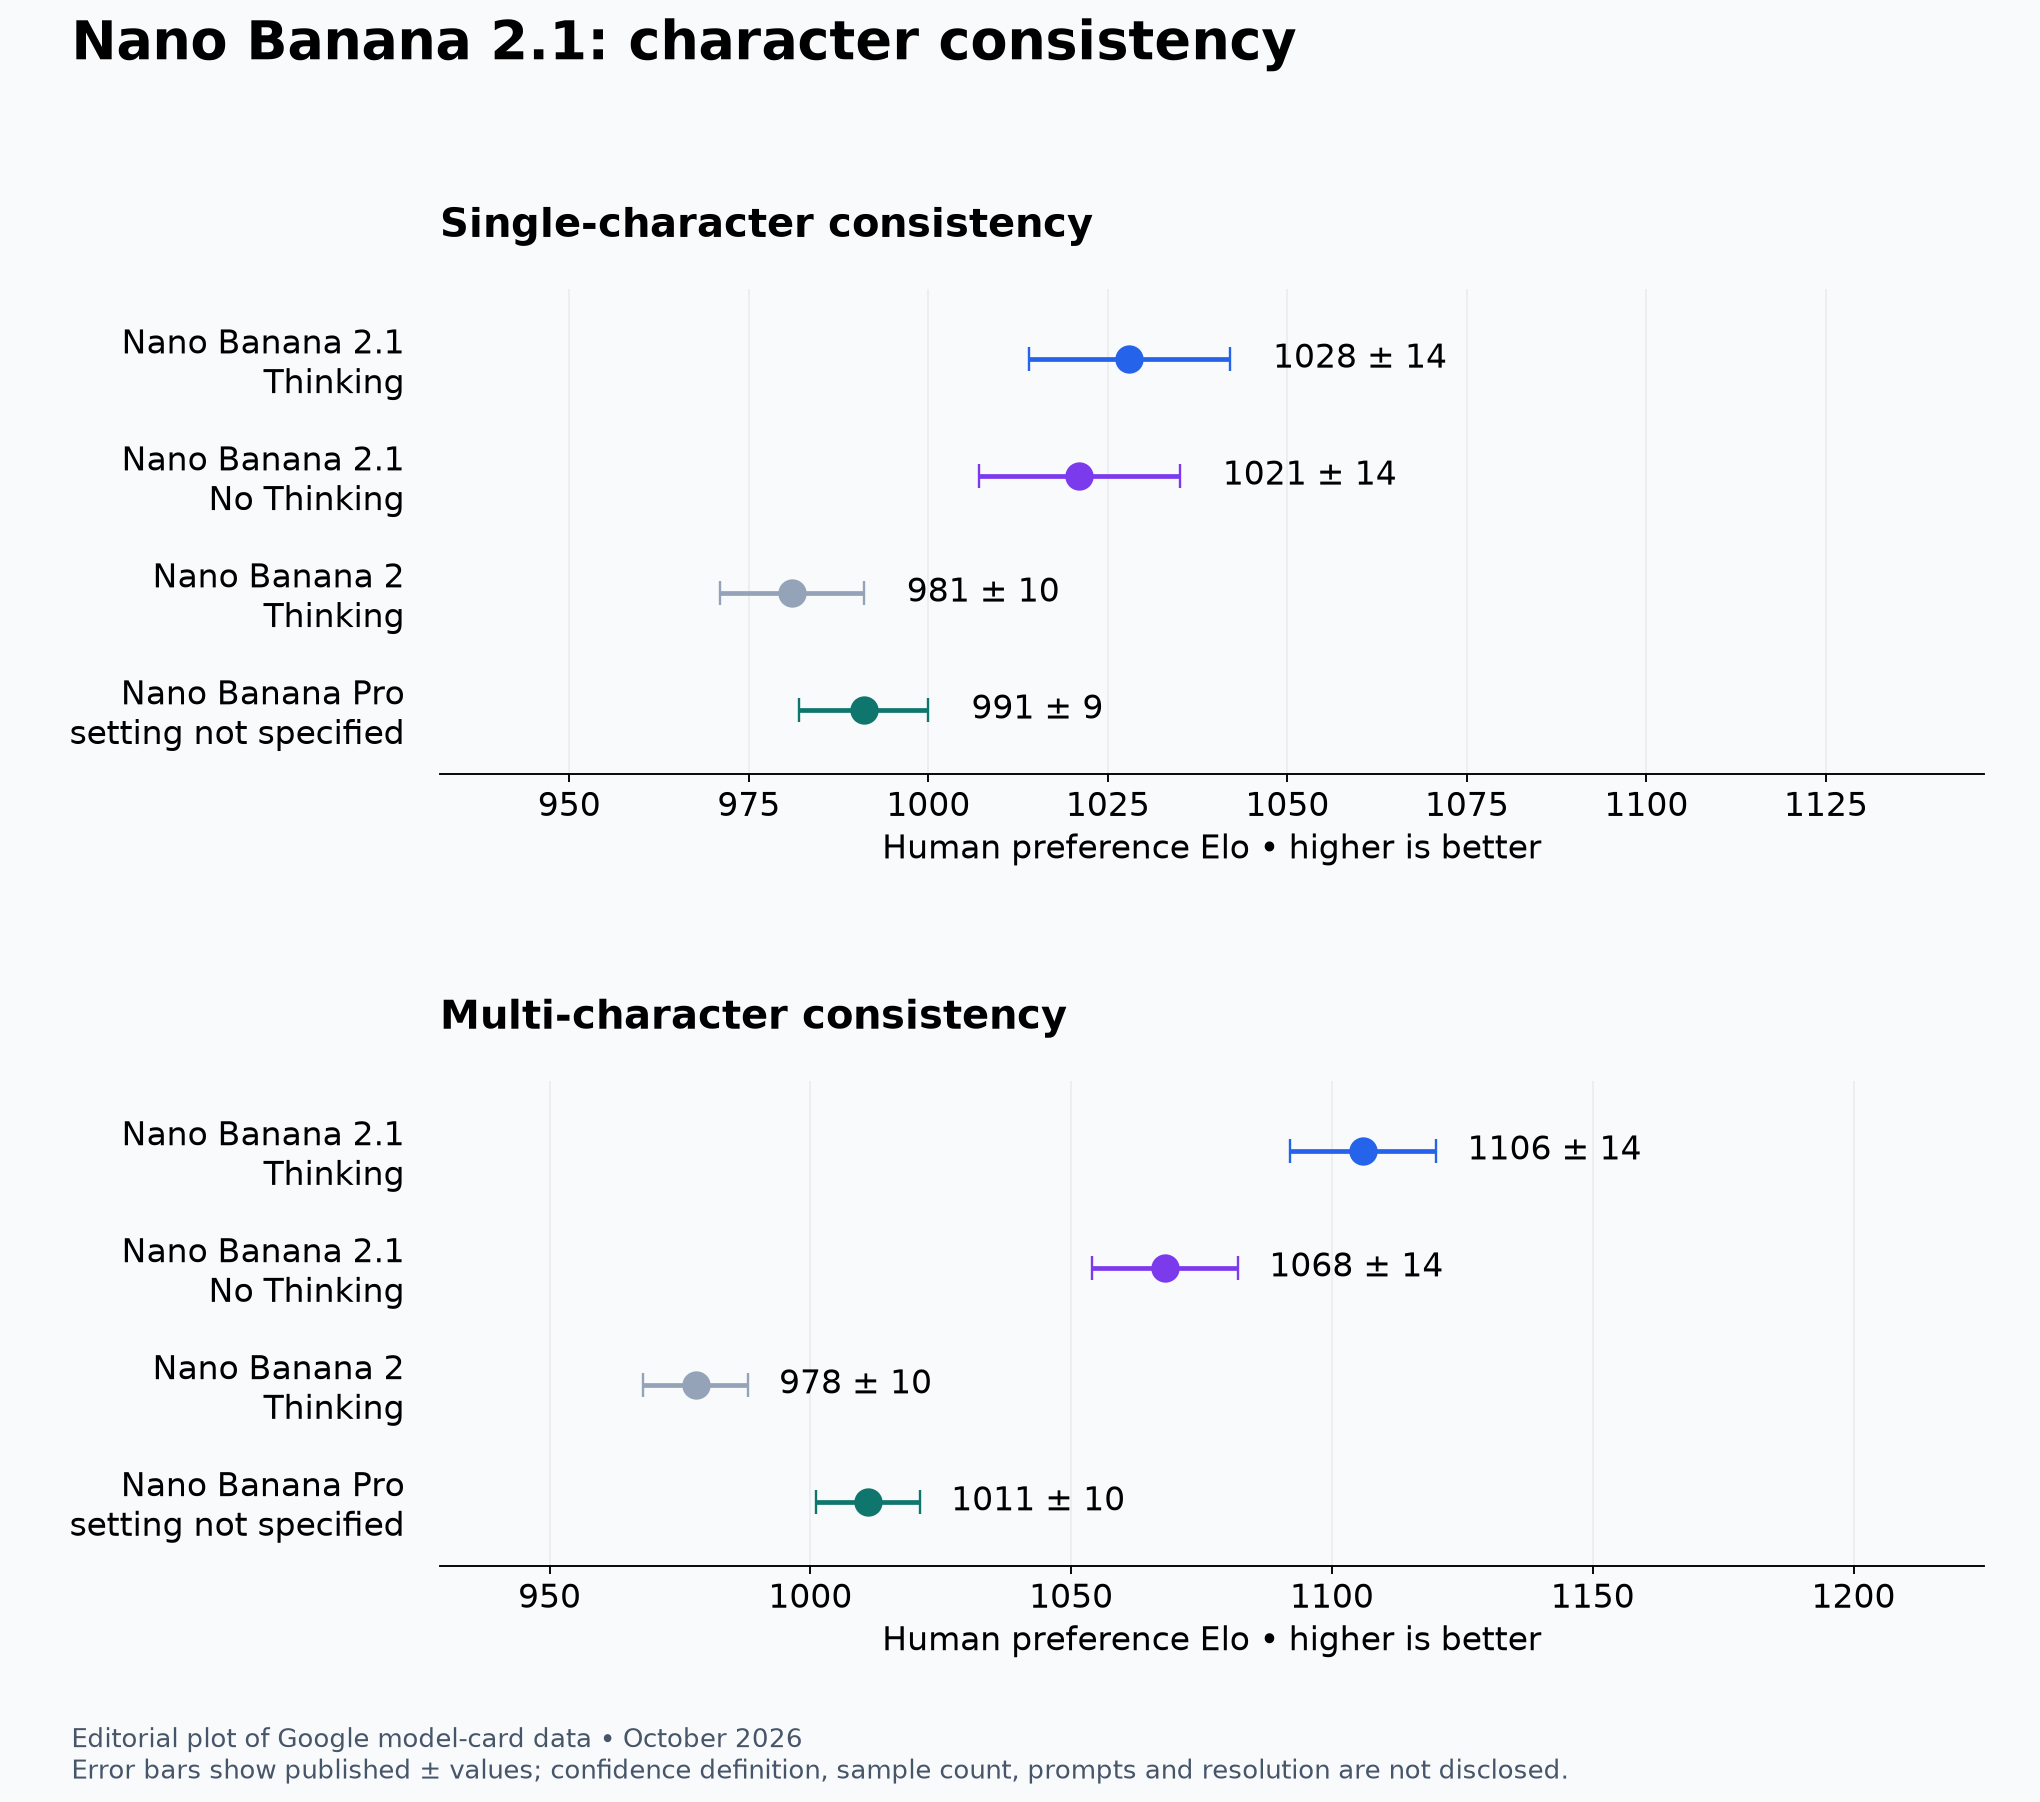
编辑图表采用同一份 Google 模型卡数据。显示的是未说明置信定义的公布范围;图片并非 Google 原始插图。
单角色结果中,2.1 Thinking 是 1028 ±14,不开 Thinking 是 1021 ±14,Nano Banana 2 Thinking 为 981 ±10,Pro 为 991 ±9。2.1 两个区间明显重叠,七分的中心值差异不足以说明每次单角色请求都必须启用推理。
多角色的分离更大:Thinking 为 1106 ±14,不开为 1068 ±14,Pro 为 1011 ±10,Nano Banana 2 Thinking 为 978 ±10。2.1 两个范围不重叠,因此需要同时维持多个身份及关系时,Thinking 更值得优先测试;但这仍不证明任何参考图组合下都能可靠保留四个人物。
好看的合照也可能把甲的衣服分给乙,或漏掉一个人。基准没有逐项报告脸部漂移、比例改变、服装转移、人物重复和相对身高错误。生产审校必须逐人检查,尤其面对裁切、矛盾、光照不一或外观相似的参考图时。单一审美投票可能掩盖足以让素材作废的身份错误。
编辑强弱取决于什么不能被改动
编辑结果同样不能归结为“Thinking 全面获胜”。蒙版编辑、产品保真和多参考图融合,保护的是不同内容。
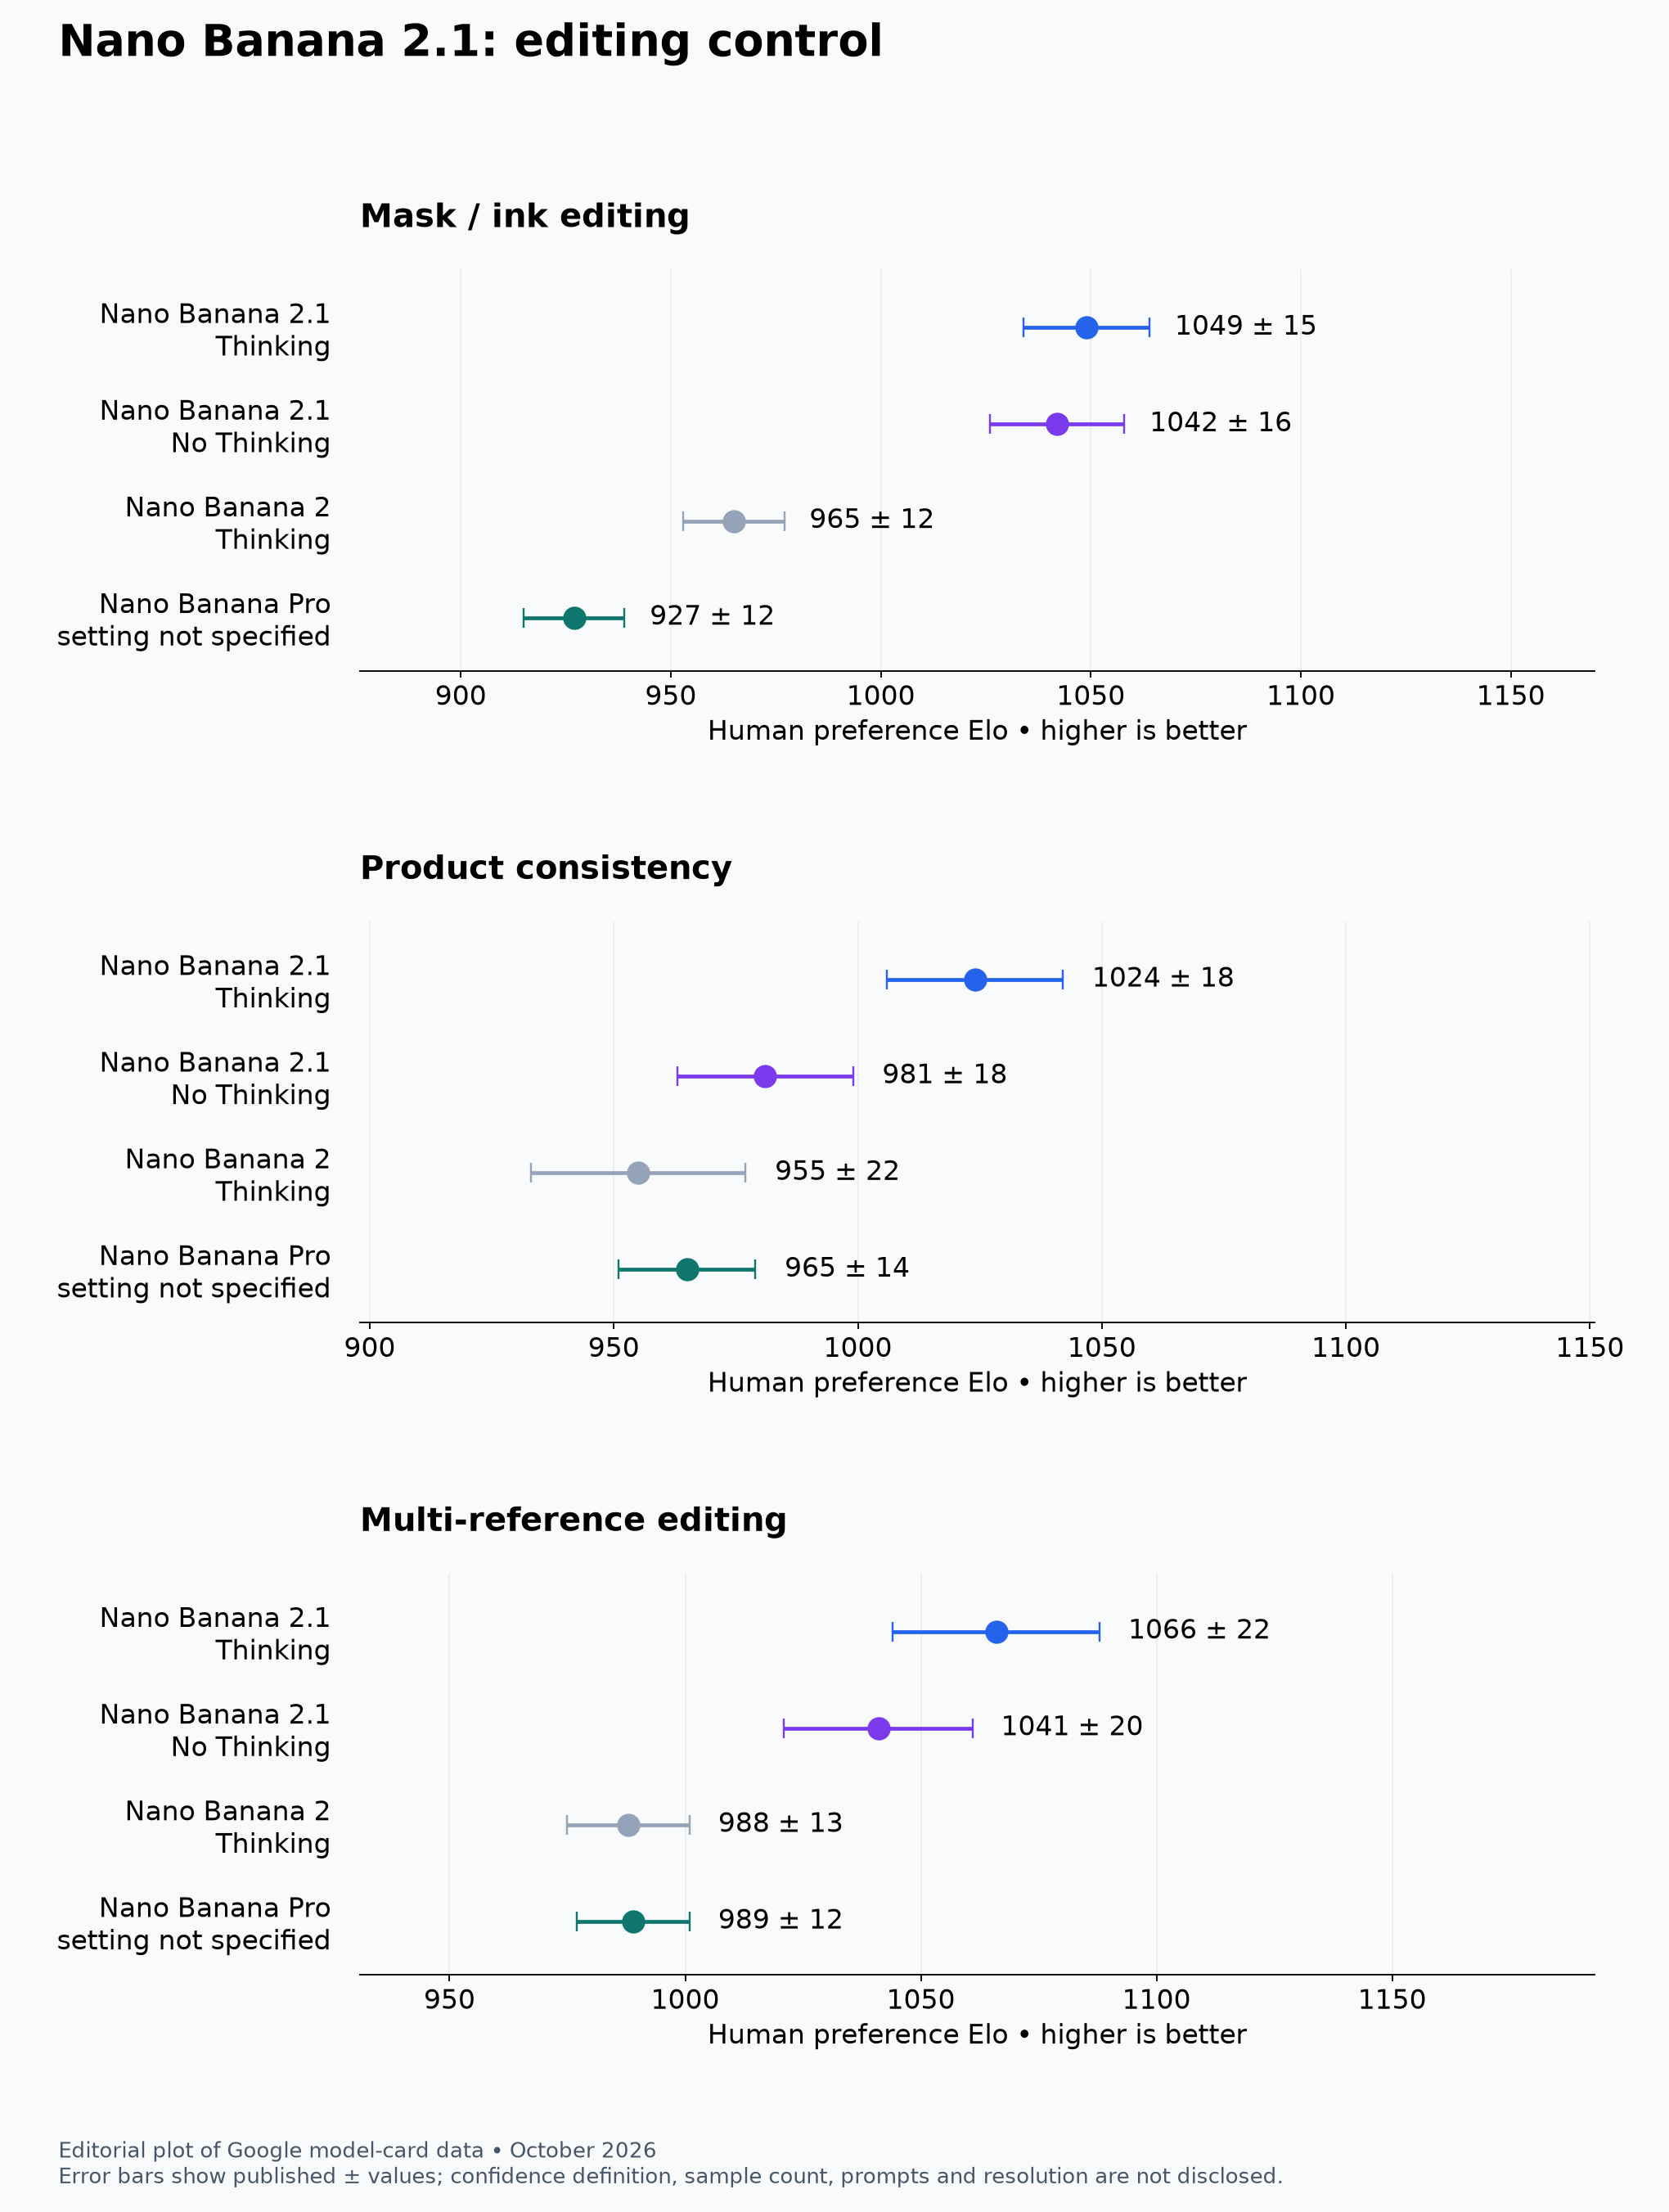
此编辑图表源于 Google 模型卡,并非 Google 原作。偏好 Elo 和公布的 ± 范围,不能测量精确指令遵循或蒙版外像素是否保持不变。
蒙版或涂画编辑中,2.1 Thinking 为 1049 ±15,不开为 1042 ±16,区间大幅重叠。两者都超过 Nano Banana 2 Thinking 的 965 ±12 和 Pro 的 927 ±12。这支持同时测试两种 2.1 模式,而不是把七分中心值差异当成已证实的推理收益。
产品一致性则不同:Thinking 为 1024 ±18,不开为 981 ±18,Nano Banana 2 Thinking 为 955 ±22,Pro 为 965 ±14。不开 Thinking 的区间与两种旧模型都重叠。证据支持 Thinking 是这组比较中最强配置,却不支持每种 2.1 配置都能显著改善产品保真。
多参考图编辑中,2.1 Thinking 为 1066 ±22,不开为 1041 ±20;Nano Banana 2 Thinking 和 Pro 分别为 988 ±13、989 ±12。2.1 整体更强,但它自己的两个范围仍重叠,不能将中心值 25 分之差变成无条件建议。
Google 承认蒙版指令可能只部分遵循、涂画墨迹残留、原有姿势意外延续。因此更受偏好的编辑也可能不满足保留要求。电商素材只要接口、标志、数量、材质或包装文字改变,就可能整张作废;创意合成能容忍的几何变化,产品文档未必能接受。这些应分别验收,而不是平均成一个编辑分数。
0.521 的事实性分数不是 52.1% 正确
信息图事实性采用另一种方法:单侧自动评分器,而不是生成比较中的人类偏好。Google 报告 2.1 Thinking 为 0.521,不开为 0.328,Pro 为 0.265,Nano Banana 2 Thinking 为 0.179。
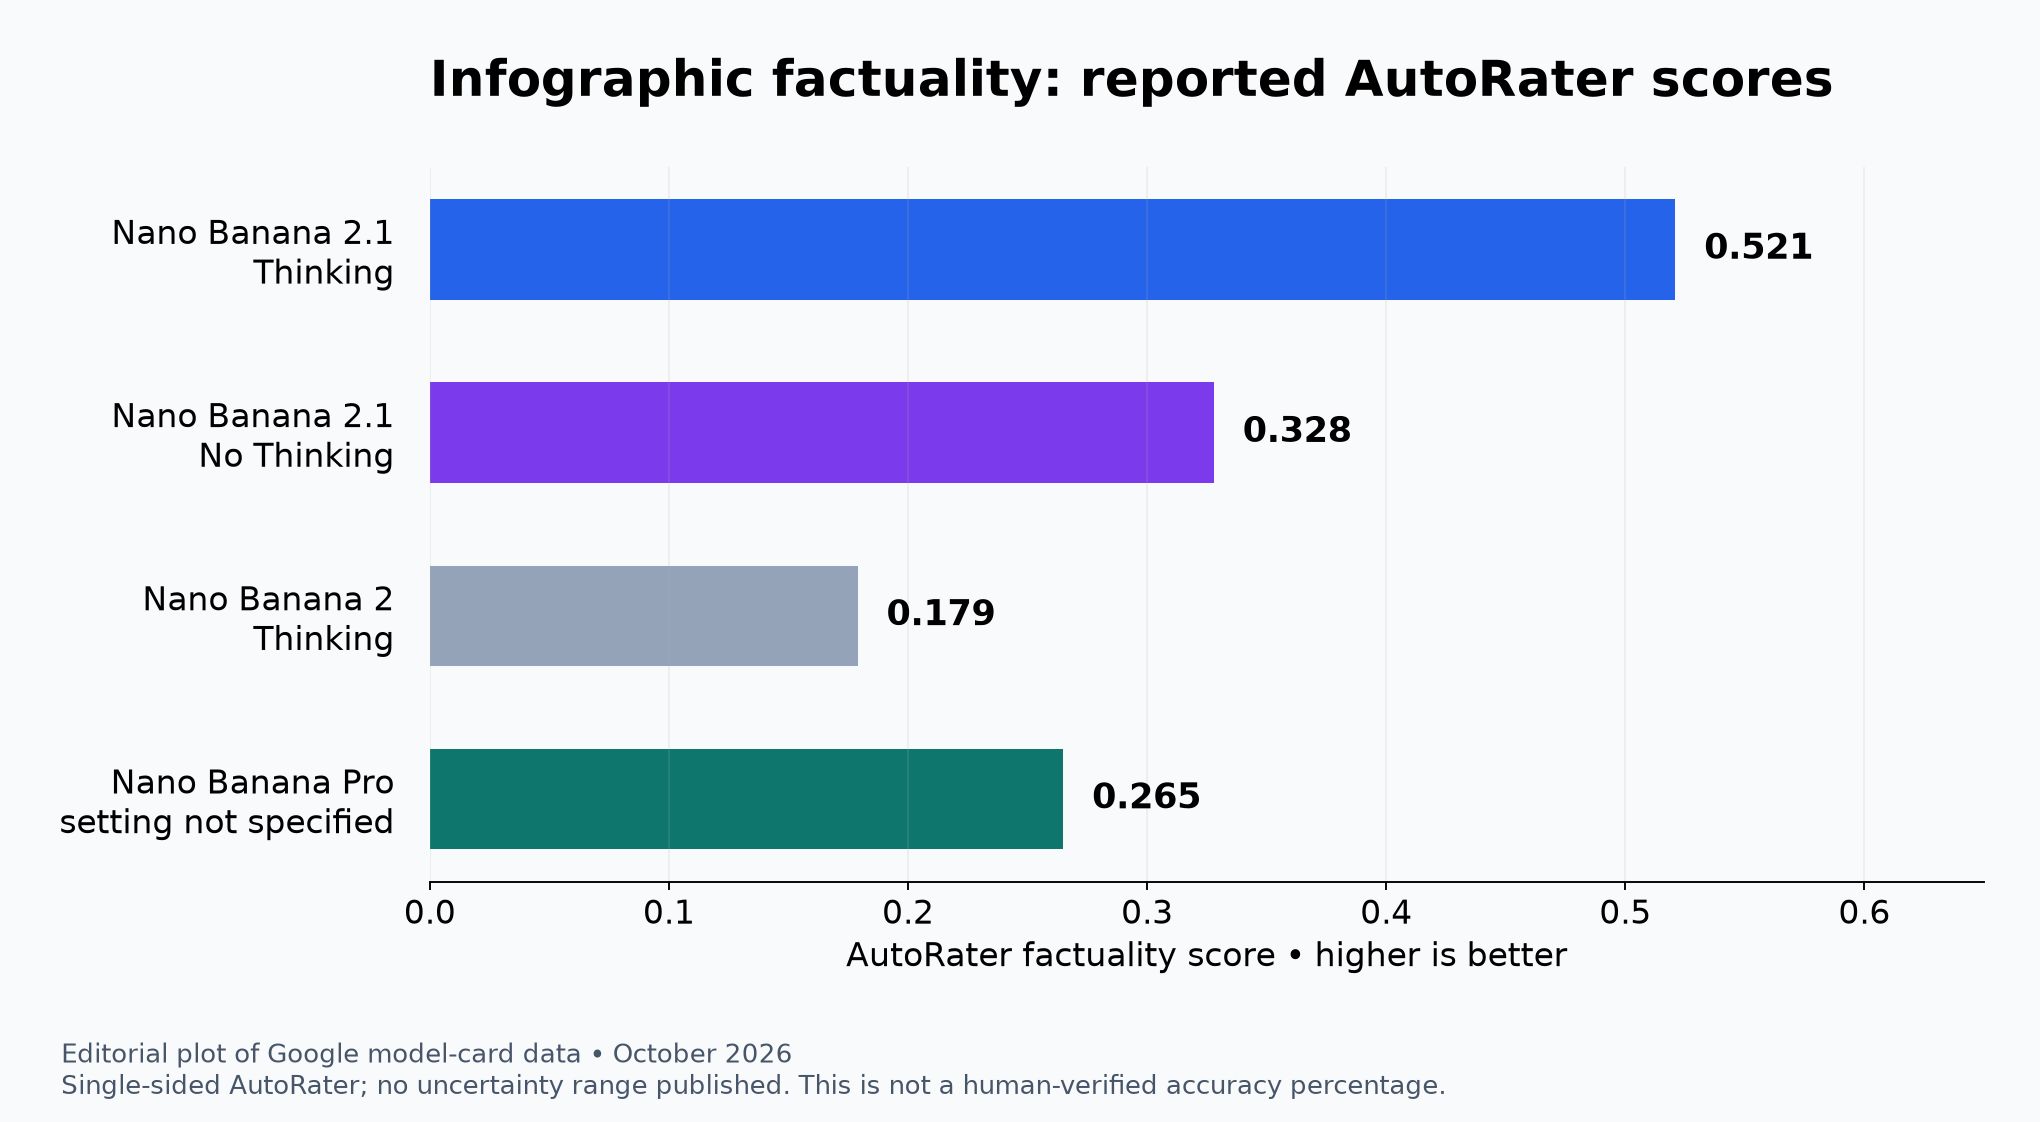
这是按 Google 自动评分数据制作的编辑图表。这些数值没有公布不确定性范围;既不是 Google 原图,也不是事实正确的信息图比例。
Thinking 在这一指标上领先,但模型卡的方法、样本和不确定性信息不足以推导生产错误率。图表可能文字正确却画错数值,时间线可能颠倒事件,地图可能互换区域或把标签指向错误对象。公开表格不能证明自动评分器能可靠识别其中哪些错误。
搜索增强(grounding)能检索信息,却不保证忠实地转写为图像。底层模型卡列出 2026 年 3 月知识截止时间,部分领域可能停留在 2025 年 1 月,另一些领域则纳入更晚信息。看起来很新的图表,仍需提供或检索事实依据,并把最终图像逐项与之核对。
实际可控的单元是一份事实表:在生成前批准数值、单位、日期、标签和引用,再检查图片。可追溯的事实与来源简报有助于将证据与视觉呈现分离,但不能让生成图自动得到验证。医疗、金融、法律、科学及新闻图表,不能把 AutoRater 分数当成发布许可。
图像输出便宜,不代表合格素材便宜
标准付费 API 价格将 2.1 的图像输出定为每百万 token 30 美元,Nano Banana 2 为 60 美元。但 4K 的 token 分配不同,改变了“减半”的含义。
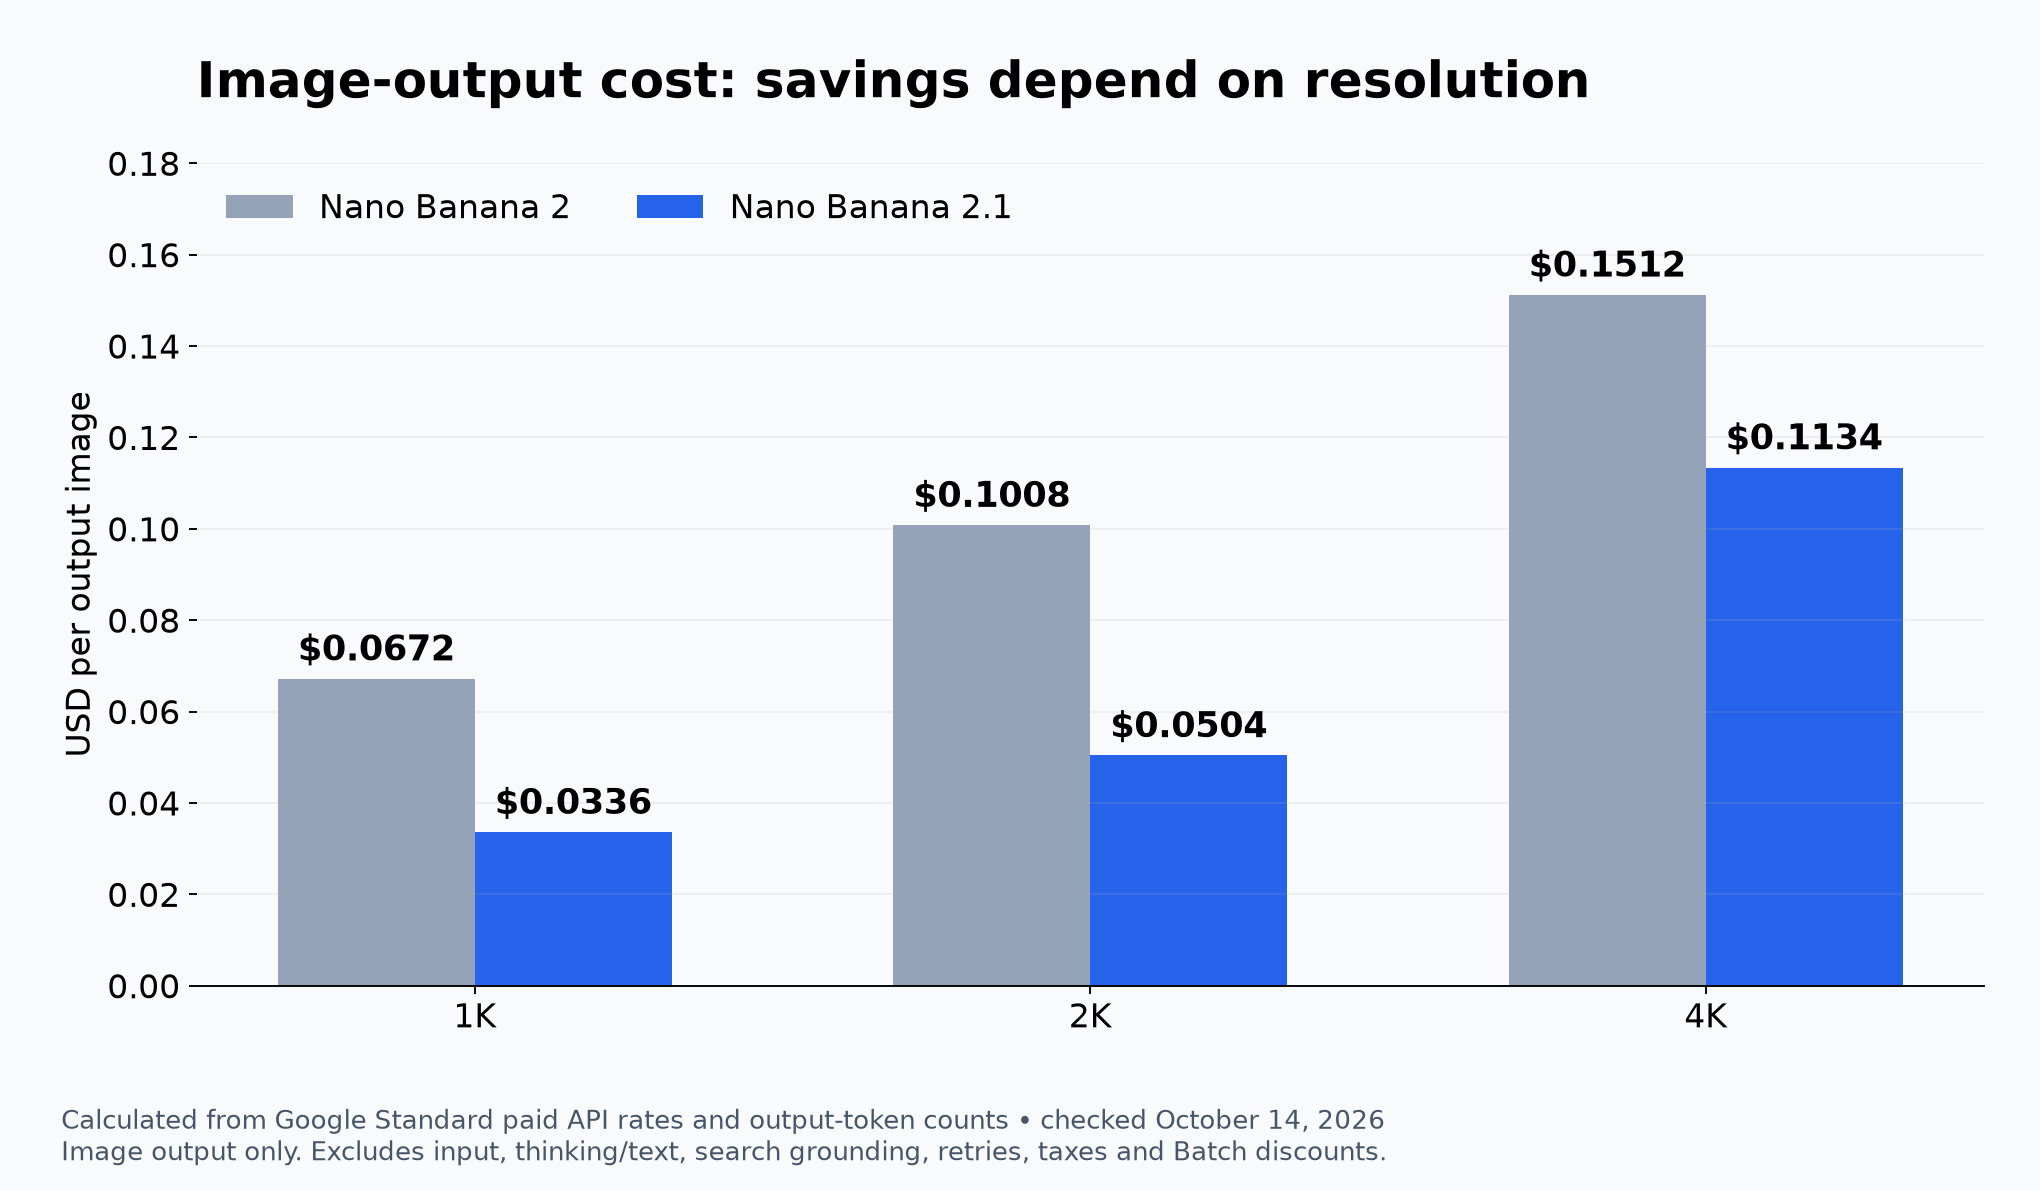
编辑计算采用截至 10 月 14 日公布的 Google 价格与 token 配额。这是仅图像输出的费用,不是实测总请求成本;图表并非 Google 原图。
1K 两者都用 1,120 个图像 token,2.1 为 0.0336 美元,Nano Banana 2 为 0.0672 美元。2K 的 1,680 个 token 分别为 0.0504、0.1008 美元,都是输出部分下降 50%。
4K 下,2.1 列出 3,780 个 token,Nano Banana 2 为 2,520。按各自单价相乘,分别是 0.1134 和 0.1512 美元,只下降 25%,不是 50%。token 数量增加时,单价减半不会让整张图片费用减半。
其他收费反而上升:2.1 标准文本、图像或视频输入为每百万 token 1.50 美元,Nano Banana 2 文本或图像输入为 0.50 美元。文本和 Thinking 输出分别为 7.50、3 美元。搜索增强(grounding)、参考图、文本输出、推理、重试、税费及可能的 Batch 折扣,都会影响完整账单。
没有对上述用量的假设,就不能负责任地给出“典型请求”总价。更高的一次验收率可能抵消推理费用,更多重试也可能抹去输出节省。决策指标应是每份验收合格素材的成本,结合实测延迟和超时率,而不是孤立的输出 token 单价。
迁移需要成对比较的证据
合理的测试应在当前模型与 2.1 各 Thinking 档位间,使用同样的真实提示词和参考文件,保持宽高比、分辨率和重试额度一致。这是建议的评估方案,并非 AI Tools Radar 已做过的测试。只有 Pro 确实可部署时才纳入比较;其基准未说明的设置不能被假定等效。
应将单角色、多角色、产品编辑、蒙版、参考图合成、文字密集版式和事实图表分开。精确文字可转录比对;蒙版需同时检查许可区域内外;产品任务需检查受保护特征。盲测偏好可以补充这些测试,却不能替代标志和数字必须不变时的精确核验。
保留成对结果和不确定性,不要将不同风险压成一个均值。运行记录应包含端到端延迟、超时、重试、token 消耗和每份合格图像成本。影子运行阶段才能显示,基准优势是否真的减少实际流程中的返工。
没有来源证据支持“10 月 29 日退役”这一迫使匆忙迁移的期限。弃用信息参考将 Gemini 3.1 Flash Image 列为弃用,但未宣布关闭日期;这同样不等于承诺无限期可用。
2.1 最值得先试的是信息图排版、多角色延续、参考图融合和较低的图像输出收费。Thinking 在多角色和事实性任务中值得优先评估;结果重叠的项目则给较简单配置留有空间。小字、事实、精确身份或不变产品区域若是硬性要求,应保留外部验证和备用模型,直到新端点真正满足要求。公布的领先只是开展比较的理由,不是比较本身的替代品。