
Nano Banana 2.1 propone ai team di produzione visiva due vantaggi distinti: risultati migliori nei confronti di Google e tariffe inferiori per i token delle immagini generate. Nessuno dei due dimostra, da solo, che un contenuto pubblicabile costi meno. La domanda è se i miglioramenti misurati reggano ai vincoli reali di identità, correttezza dei fatti, dettagli protetti del prodotto e costo complessivo dei tentativi.
Questa analisi del 14 ottobre segue la disponibilità generale del 6 ottobre, non un nuovo lancio nello stesso giorno. I segnali più forti sono la preferenza per le infografiche, la coerenza di più personaggi e alcune modifiche. L’interpretazione più debole sarebbe trasformare la preferenza in accuratezza, supporre che Thinking aiuti ogni attività allo stesso modo o definire qualsiasi richiesta «a metà prezzo».
L’endpoint effettivo ha limiti più stretti della scheda
Il registro API identifica il modello stabile come gemini-nano-banana-2.1. Google lo descrive come aggiornamento Flash di Gemini 3.1 Flash Image, noto anche come Nano Banana 2, non come nuovo Pro. La scheda del modello lo colloca su Gemini 3.6 Flash: accetta testo e immagini e restituisce immagini e testo.
I dettagli implementativi contano quanto la famiglia del modello. La documentazione dell’endpoint indica output predefinito 1K, fino a 4K. Thinking offre minimal, medium e high, con medium predefinito. È supportato il grounding tramite ricerca, ma non chiamate di funzione, esecuzione di codice o output strutturati. Le applicazioni devono gestire queste orchestrazioni e verifiche fuori dal modello visivo.
Resta una differenza di capacità non spiegata. La scheda parla di un milione di token di contesto e 64K di output testuale, mentre Gemini API riporta 131.072 token in ingresso e 32.768 in uscita. Le fonti non ne chiariscono il rapporto. Un’implementazione deve seguire i limiti documentati dell’endpoint chiamato, senza assumere disponibili i valori architetturali superiori.
La fusione accetta fino a 14 immagini di riferimento, comprese al massimo quattro figure e dieci oggetti. Sono limiti di ingresso, non garanzie di conservare fedelmente quattordici riferimenti o quattro identità indipendenti.
La scheda cita inoltre testo piccolo o lungo sfocato o corrotto, deriva d’identità, confusione fra destra e sinistra, ragionamento 3D e conoscenza fattuale imperfetti, oltre a lentezza e timeout occasionali. Residui delle maschere e pose persistenti aggiungono rischi di modifica. Questi limiti riconosciuti richiedono criteri di fallimento e alternative: più riferimenti o contesto non li eliminano.
La generazione misura preferenza, non correttezza
Google confronta preferenze umane con Elo, non la quota di immagini corrette. Gli intervalli ± pubblicati aiutano a leggere i risultati, ma il livello di confidenza non è definito. Non sono noti neppure numerosità, prompt, risoluzioni, budget di nuovi tentativi, configurazione precisa di Thinking o condizioni di calcolo equivalenti.
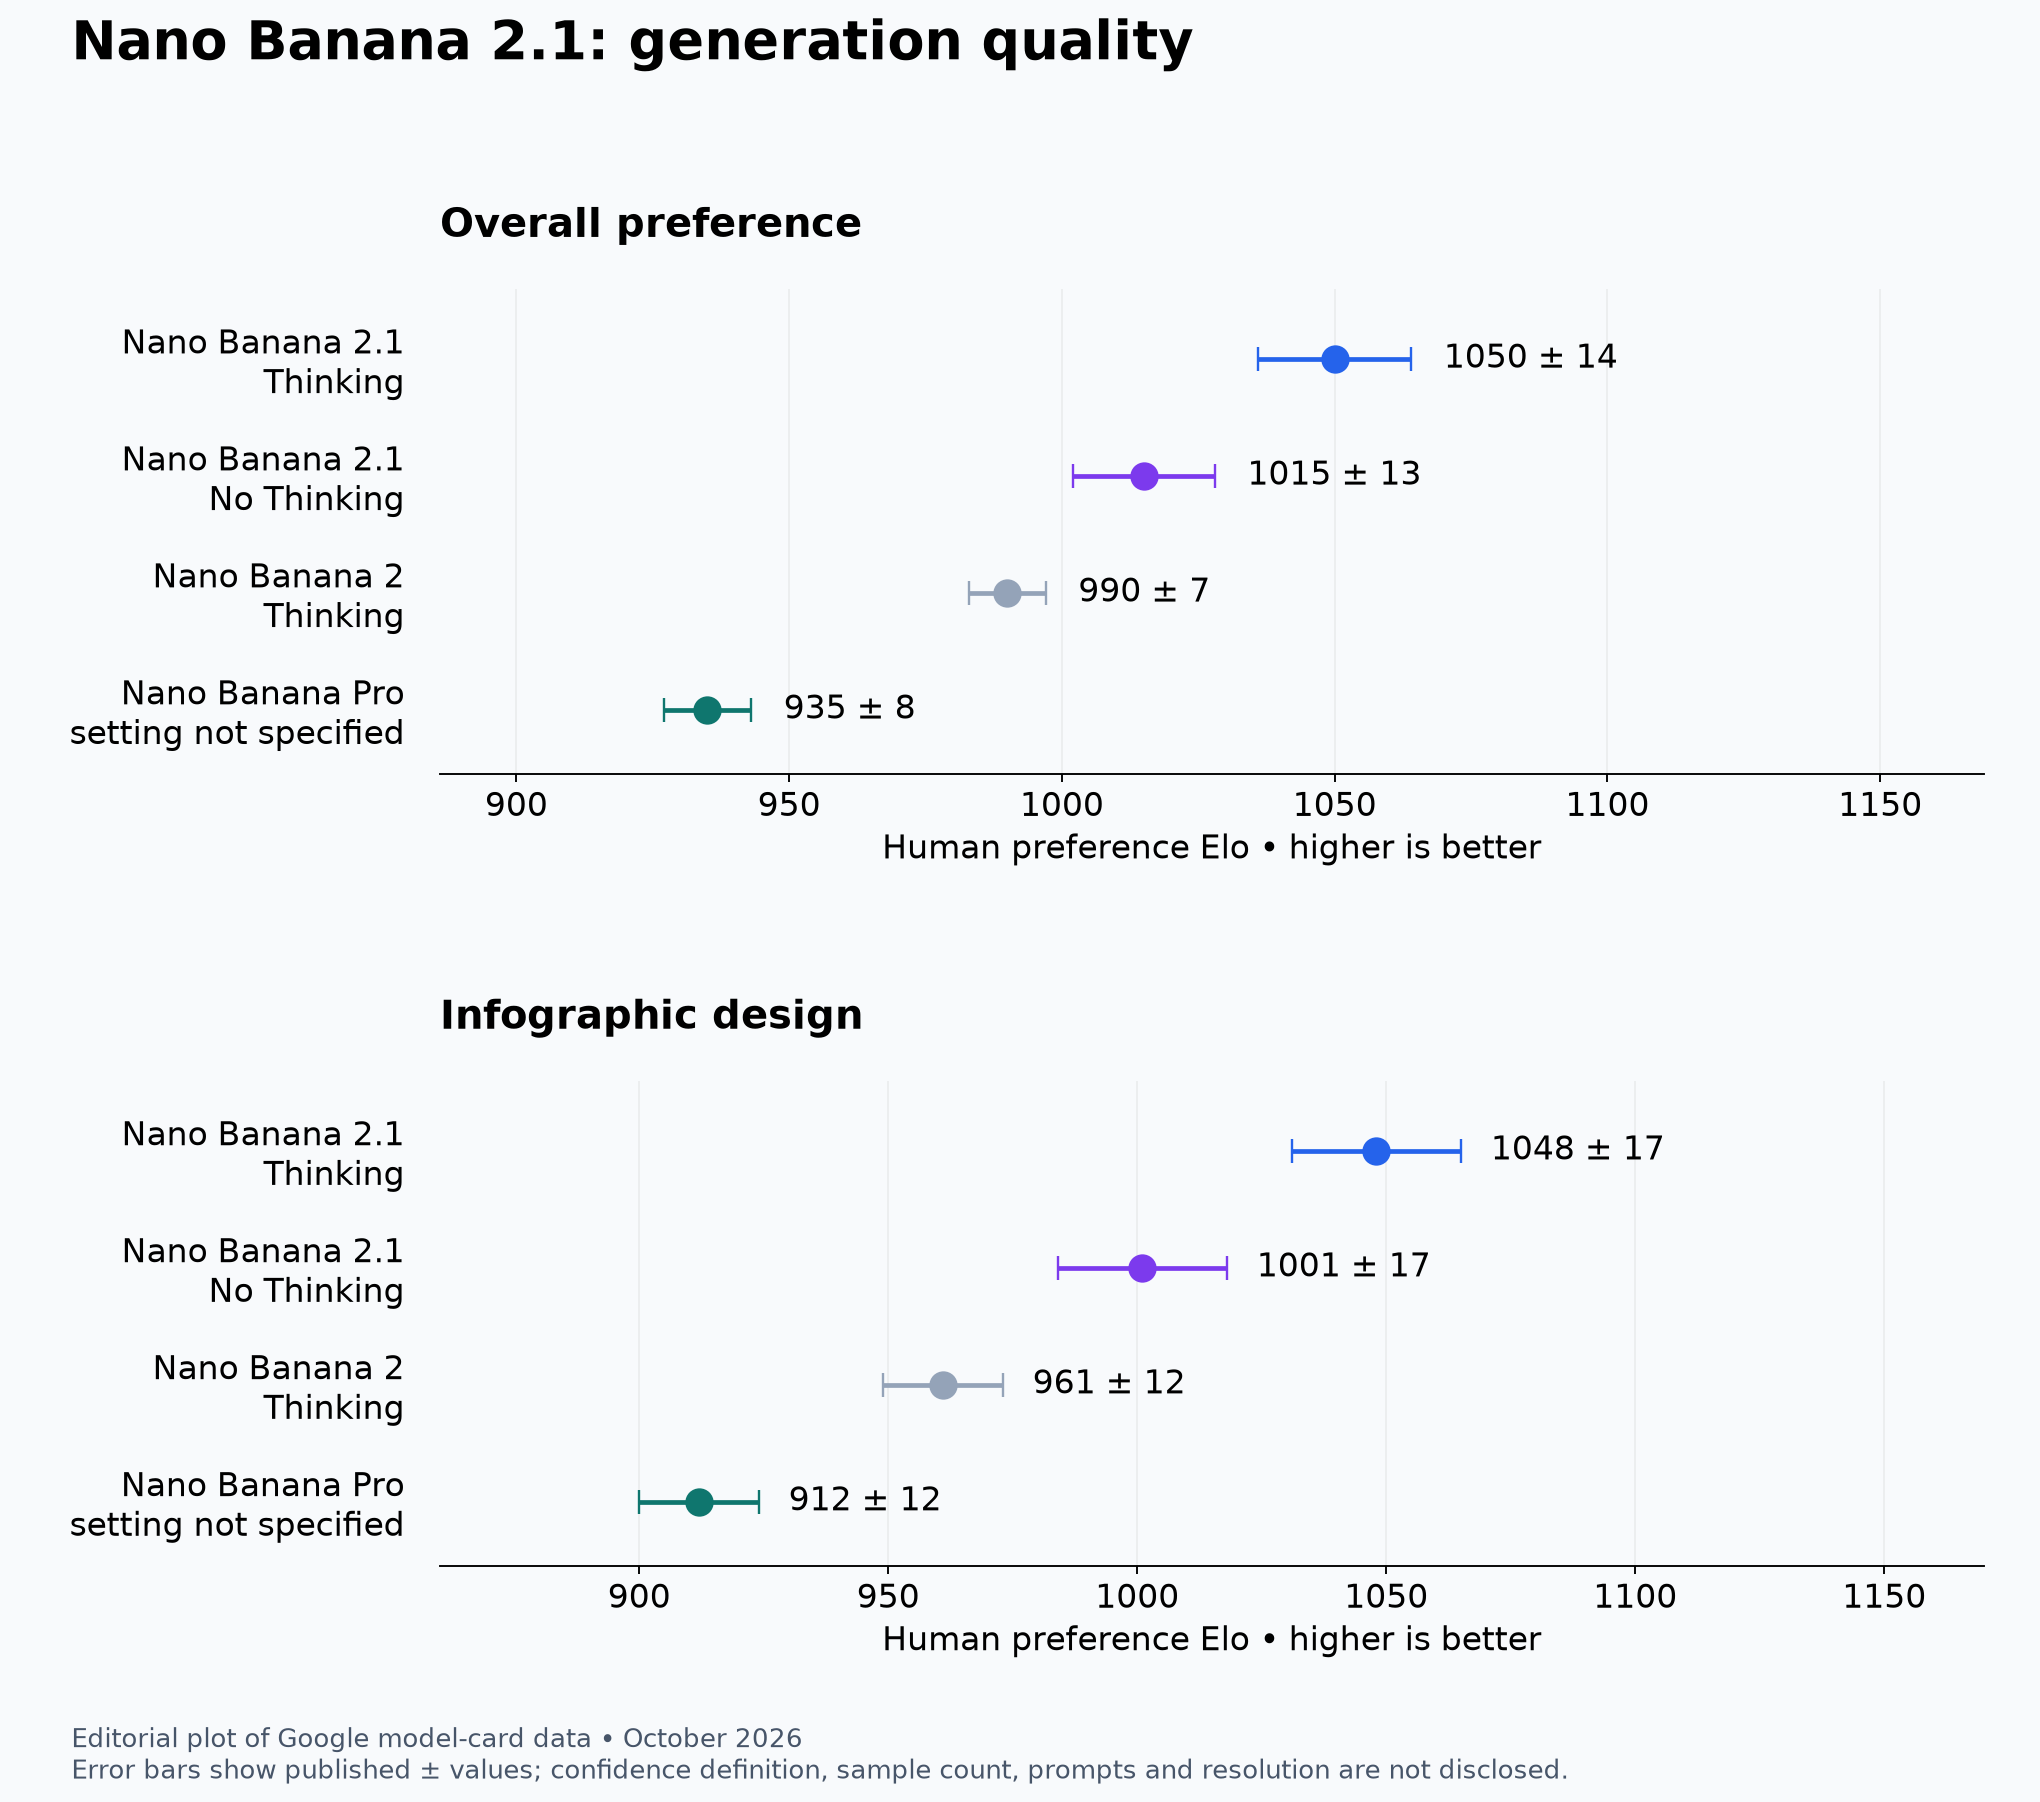
Grafico editoriale dei dati della scheda Google di ottobre 2026, non immagine originale di Google. Le barre riproducono gli intervalli dichiarati, senza stabilirne la confidenza né un’accuratezza operativa.
Nella generazione generale, 2.1 Thinking ottiene 1050 ±14, senza Thinking 1015 ±13, Nano Banana 2 Thinking 990 ±7 e Pro 935 ±8. Per le infografiche, nello stesso ordine: 1048 ±17, 1001 ±17, 961 ±12 e 912 ±12. Anche considerando gli intervalli mostrati, entrambe le modalità 2.1 superano Nano Banana 2 nelle infografiche.
L’intervallo generale con Thinking, 1036–1064, non si sovrappone a 1002–1028 senza. Per le infografiche si toccano a 1031. La prima separazione è più netta, ma nessuna dimostra un beneficio della stessa entità per ogni prompt. L’etichetta generica «Thinking» non coincide necessariamente con high dell’API: la configurazione valutata non è pubblica.
Non segue una scorciatoia operativa. Una preferenza superiore non prova meno tentativi, minore latenza o etichette corrette. Google qui non pubblica latenza di benchmark. I team creativi hanno motivo di provare 2.1, soprattutto per composizione e impaginazione, ma non di inventare accelerazioni o ritorni universali.
Più personaggi cambiano il valore di Thinking
Un personaggio ricorrente e una scena con diverse identità sono carichi differenti. I test di coerenza rendono visibile questa distinzione.
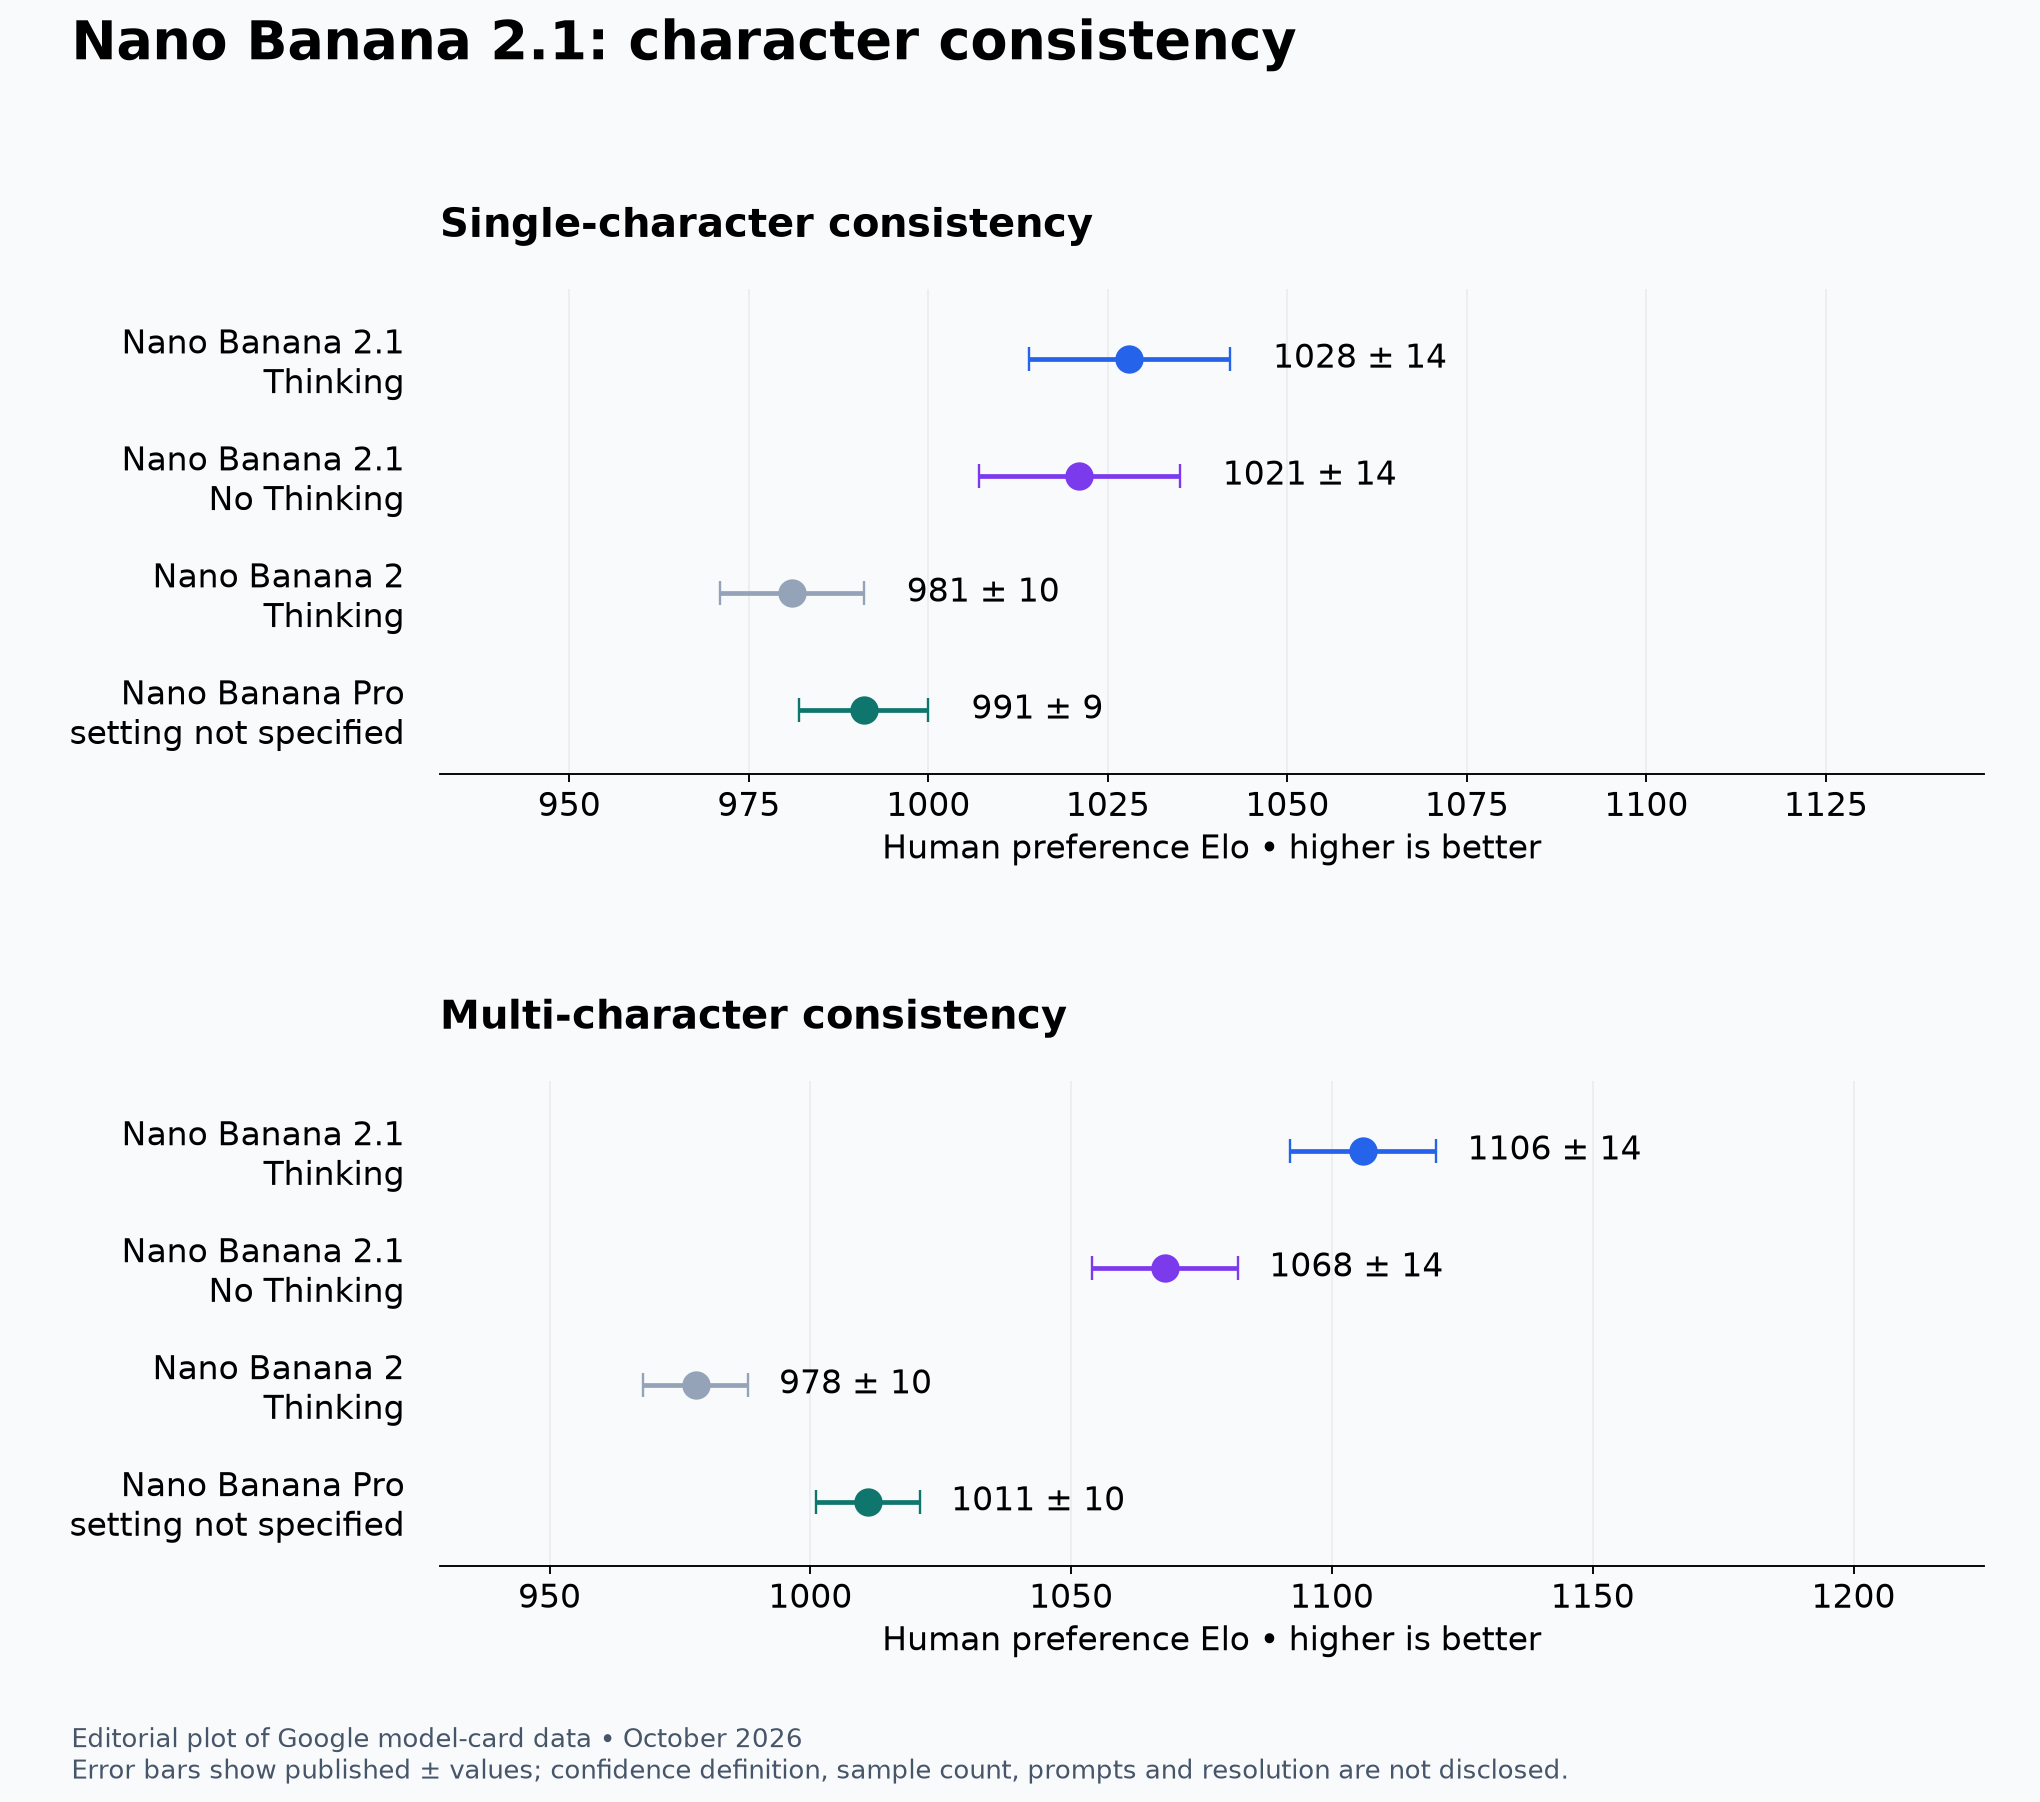
Rappresentazione editoriale dello stesso dataset Google. Gli intervalli non hanno una definizione di confidenza dichiarata; l’illustrazione non è un originale Google.
Con un personaggio, 2.1 Thinking raggiunge 1028 ±14 e senza Thinking 1021 ±14; Nano Banana 2 Thinking è a 981 ±10, Pro a 991 ±9. Gli intervalli 2.1 si sovrappongono ampiamente. Sette punti tra valori centrali non bastano per imporre ragionamento a ogni richiesta con un solo soggetto.
Con più personaggi la separazione cresce: 1106 ±14 con Thinking, 1068 ±14 senza, 1011 ±10 per Pro e 978 ±10 per Nano Banana 2 Thinking. Gli intervalli 2.1 non si sovrappongono. Thinking diventa più promettente per mantenere identità e relazioni, ma non è provata l’affidabilità di quattro personaggi con qualsiasi combinazione di riferimenti.
Una bella immagine di gruppo può scambiare gli abiti o omettere qualcuno. Il benchmark non dettaglia deriva del volto, proporzioni cambiate, trasferimento di vestiti, duplicati o errori nell’altezza relativa. La verifica deve valutare ciascun soggetto, soprattutto con riferimenti tagliati, contraddittori, illuminati diversamente o simili tra loro. Un voto estetico complessivo può nascondere un difetto d’identità che rende inutilizzabile il contenuto.
La modifica dipende da ciò che deve rimanere intatto
Nemmeno l’editing si riassume in «Thinking vince». Maschere, fedeltà del prodotto e combinazione di riferimenti proteggono elementi diversi.
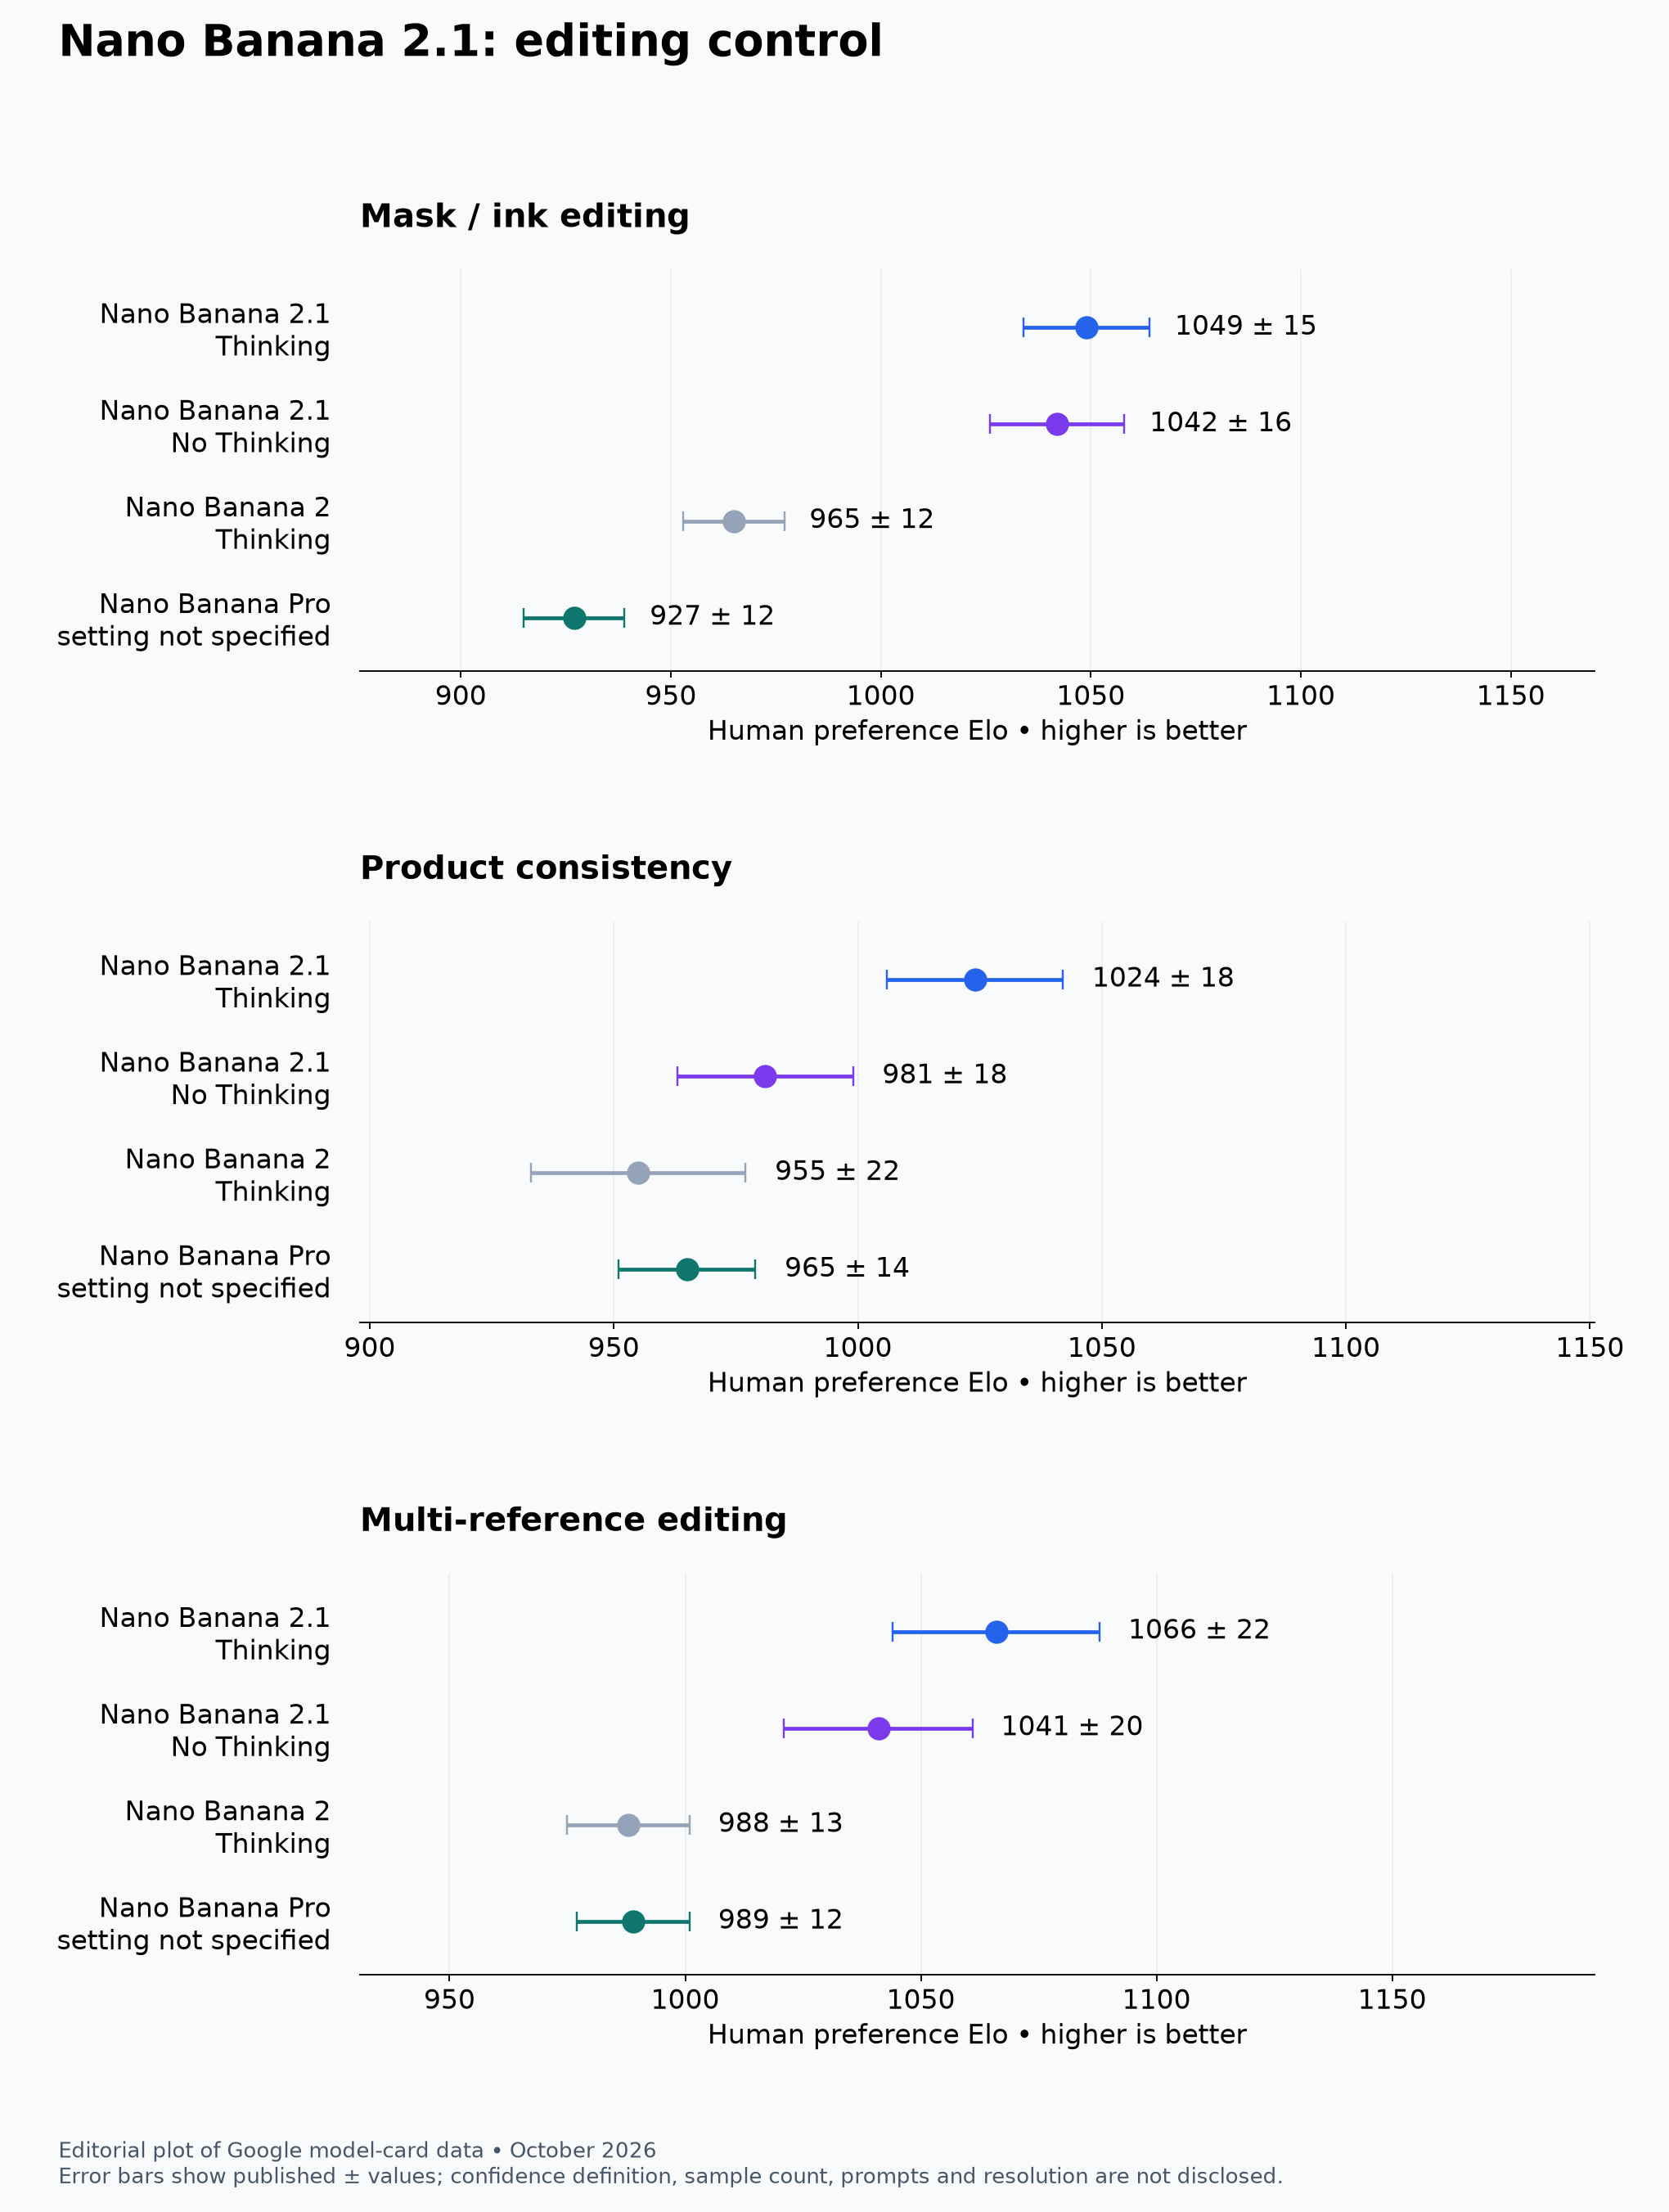
Grafico editoriale derivato dalla scheda Google, non un suo originale. Elo e intervalli ± non misurano rispetto esatto delle istruzioni o pixel invariati fuori dalla maschera.
Con maschere o tratti, 2.1 Thinking segna 1049 ±15 e senza Thinking 1042 ±16, con ampia sovrapposizione. Entrambi superano Nano Banana 2 Thinking a 965 ±12 e Pro a 927 ±12. La prova giustifica test di entrambe le modalità 2.1, non un vantaggio certo del ragionamento ricavato da sette punti centrali.
Nella coerenza del prodotto, Thinking è a 1024 ±18, senza a 981 ±18, Nano Banana 2 Thinking a 955 ±22 e Pro a 965 ±14. L’intervallo senza Thinking si incrocia con entrambi i modelli precedenti. Thinking è la configurazione più forte del confronto, ma non si può affermare che ogni modalità 2.1 migliori chiaramente la fedeltà.
Nell’editing multiriferimento, 2.1 Thinking è a 1066 ±22 e senza a 1041 ±20, contro 988 ±13 e 989 ±12 di Nano Banana 2 Thinking e Pro. 2.1 è più forte, ma i suoi due intervalli si sovrappongono: i 25 punti centrali non fondano una raccomandazione incondizionata.
Google ammette istruzioni delle maschere seguite solo in parte, residui dei tratti e mantenimento inatteso della posa originale. Una modifica preferita può fallire la conservazione richiesta. Nell’ecommerce, cambiare una porta, un logo, una quantità, un materiale o una scritta può invalidare un’immagine attraente. Un montaggio creativo ammette geometrie che la documentazione di prodotto non tollera. Sono criteri separati, non dettagli da mediare in un unico punteggio.
Una factualità di 0,521 non equivale al 52,1% corretto
La factualità delle infografiche usa un’altra misura: un valutatore automatico unilaterale, non le preferenze umane della generazione. Google riporta 0,521 per 2.1 Thinking, 0,328 senza, 0,265 per Pro e 0,179 per Nano Banana 2 Thinking.
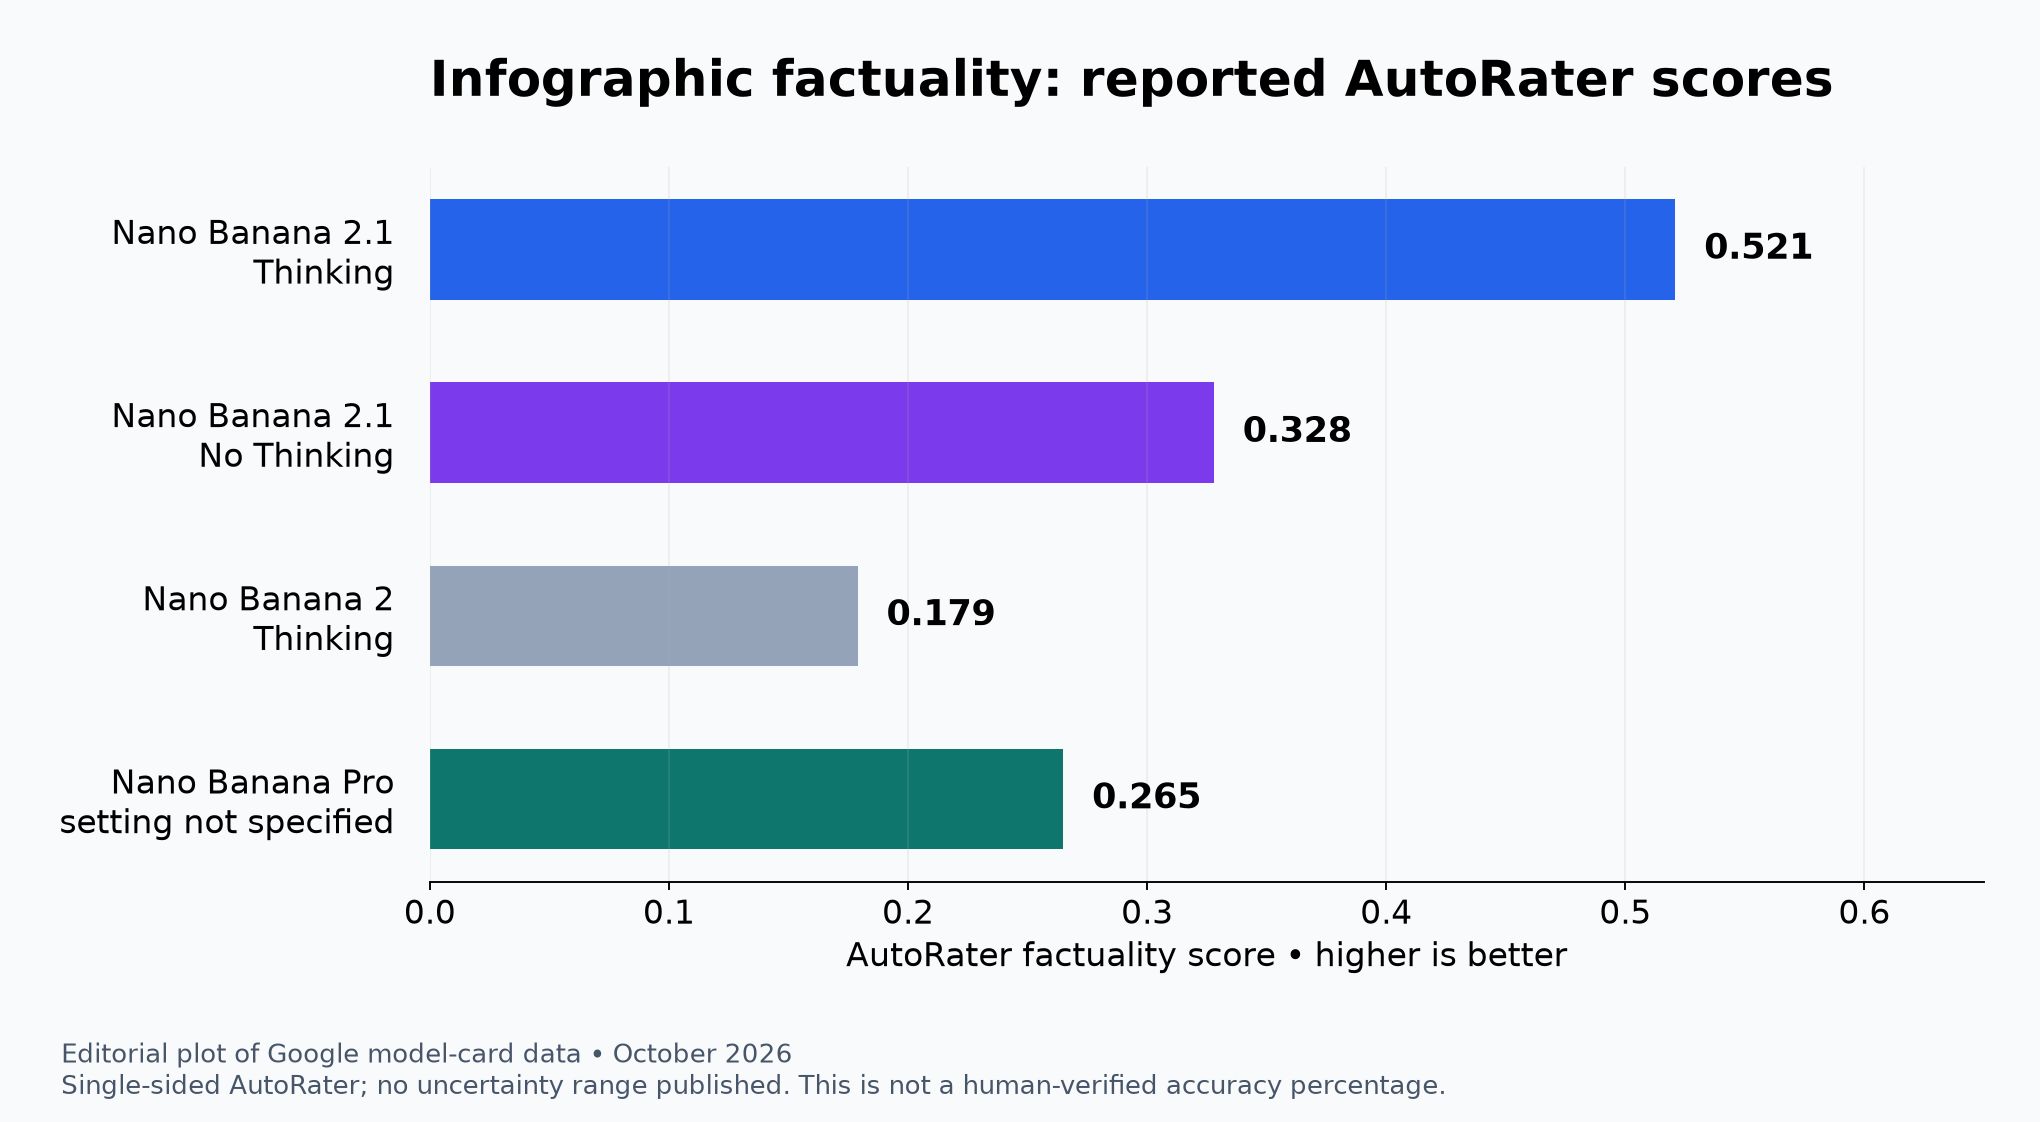
Grafico editoriale dei dati automatici Google. Non vengono pubblicati intervalli d’incertezza. Non è un originale Google né la percentuale di infografiche fattualmente corrette.
Thinking guida l’indicatore, ma metodo, campioni e incertezza descritti non bastano a calcolare un tasso d’errore operativo. Un grafico può avere prosa corretta e valori tracciati male, una cronologia invertire eventi, una mappa scambiare regioni o un’etichetta indicare l’oggetto errato. La tabella non stabilisce quali difetti il valutatore rilevi affidabilmente.
Il grounding può recuperare informazioni senza garantire una trascrizione visiva fedele. La scheda di base indica marzo 2026 come limite delle conoscenze, con alcuni domini forse fermi a gennaio 2025 e altri arricchiti da informazioni più recenti. Anche un grafico apparentemente attuale richiede fatti forniti o recuperati e confronto con l’immagine finale.
L’unità controllabile è una scheda fattuale: valori, unità, date, etichette e citazioni approvati prima della generazione e poi verificati nel risultato. Fatti tracciabili e dossier delle fonti aiutano a separare evidenza e presentazione, ma non rendono l’immagine auto-verificante. In medicina, finanza, diritto, scienza e attualità, AutoRater non può autorizzare la pubblicazione.
Output economico non significa contenuto accettato economico
I prezzi standard dell’API a pagamento fissano l’output immagine a 30 dollari per milione di token per 2.1, contro 60 per Nano Banana 2. Le diverse assegnazioni a 4K cambiano quell’apparente dimezzamento.
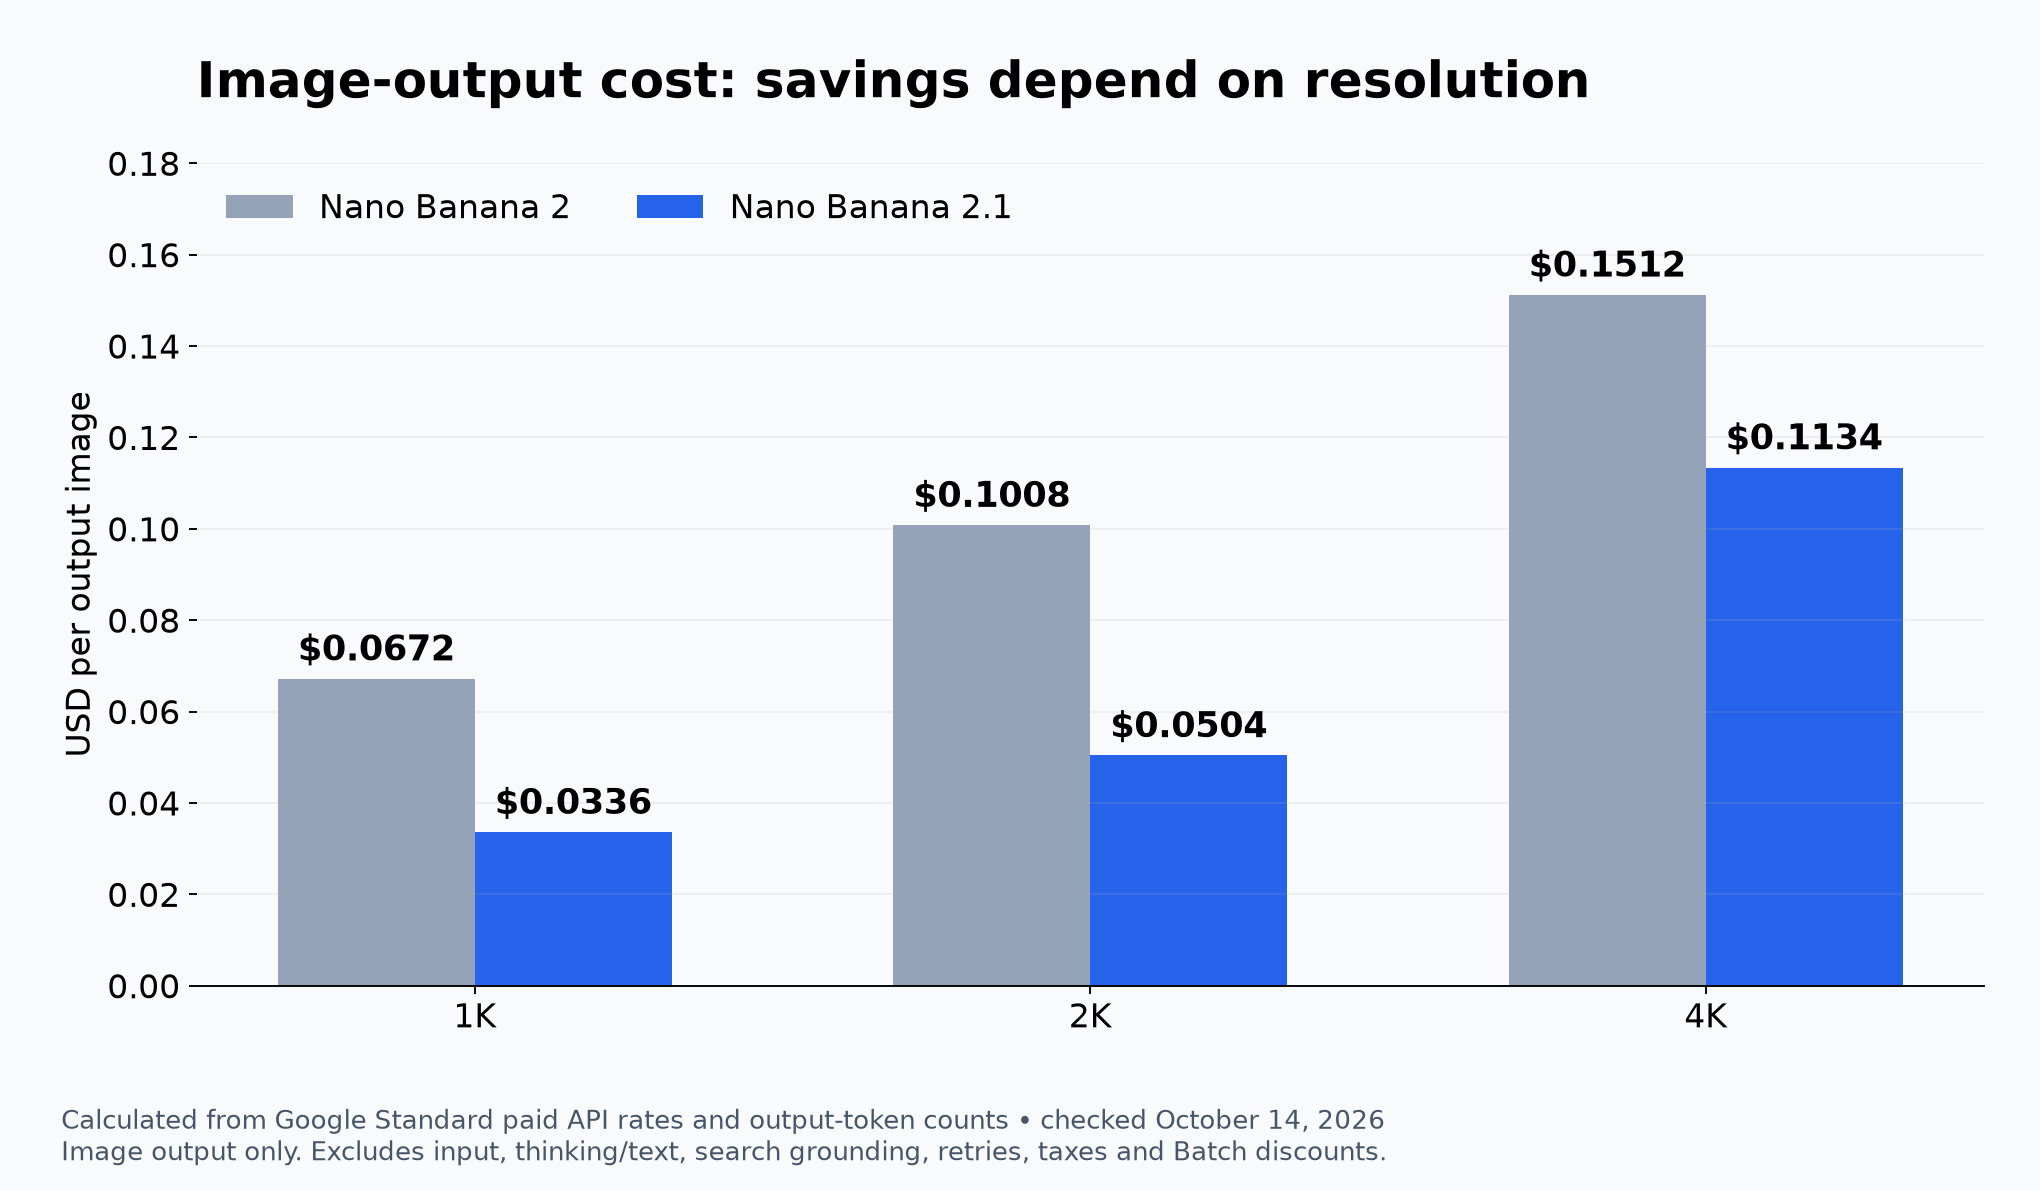
Calcolo editoriale con tariffe e assegnazioni Google pubblicate entro il 14 ottobre. Non sono costi totali misurati né un grafico originale Google.
A 1K entrambi impiegano 1120 token immagine: 0,0336 dollari per 2.1 contro 0,0672 per Nano Banana 2. A 2K, 1680 token costano rispettivamente 0,0504 e 0,1008 dollari. In entrambi i casi l’output scende del 50%.
A 4K, 2.1 indica 3780 token e Nano Banana 2 2520. Applicando le rispettive tariffe si ottengono 0,1134 contro 0,1512 dollari: risparmio del 25%, non del 50%. Se aumenta la quantità di token, dimezzarne il prezzo unitario non dimezza il prezzo dell’immagine.
Altre componenti aumentano. L’input standard testo, immagine o video di 2.1 costa 1,50 dollari per milione di token, contro 0,50 per testo o immagine in Nano Banana 2. L’output testo e Thinking è a 7,50 contro 3 dollari. Grounding, riferimenti, testo, ragionamento, tentativi, imposte ed eventuali sconti Batch incidono sul totale.
Senza ipotesi sulle quantità, un totale «tipico» non è difendibile. Una migliore accettazione al primo tentativo può compensare il ragionamento; più tentativi possono assorbire il risparmio. La metrica è il costo per contenuto accettato, insieme a latenza e timeout misurati, non una tariffa d’output isolata.
La migrazione richiede confronti appaiati
Un test utile darebbe gli stessi prompt reali e file di riferimento al modello attuale e ai livelli Thinking disponibili di 2.1, mantenendo proporzioni, risoluzione e budget dei tentativi. È una proposta di valutazione, non un test effettuato da AI Tools Radar. Pro va incluso solo se realmente distribuibile; non si possono assumere equivalenti impostazioni non specificate nel benchmark.
Occorre separare uno o più personaggi, prodotto, maschere, composizioni, layout ricchi di testo e grafici fattuali. Il testo esatto si può trascrivere e confrontare; le maschere richiedono controllo dentro e fuori l’area consentita; i prodotti, delle caratteristiche protette. Preferenze in cieco integrano i test, ma non sostituiscono l’esattezza dove loghi e numeri devono restare intatti.
Conservare esiti appaiati e incertezza evita di appiattire rischi diversi in una media. Le registrazioni operative devono includere latenza completa, timeout, tentativi, token e costo per immagine accettata. Una fase parallela alla produzione mostra se il vantaggio del benchmark riduce davvero le revisioni.
Non esiste nelle fonti una chiusura il 29 ottobre che imponga una migrazione precipitosa. Il riferimento sulla dismissione elenca Gemini 3.1 Flash Image come deprecato ma senza data di spegnimento annunciata. Non è nemmeno una promessa di disponibilità illimitata.
I casi iniziali più solidi sono impaginazione di infografiche, più personaggi ricorrenti, composizione di riferimenti e output meno costoso. Thinking merita attenzione per molte identità e factualità; i risultati sovrapposti lasciano altrove spazio a configurazioni semplici. Se caratteri piccoli, fatti, identità esatta o regioni prodotto intatte sono obbligatori, servono verifica esterna e alternativa finché l’endpoint non soddisfa i requisiti. Il primato pubblicato motiva il confronto, non lo sostituisce.