
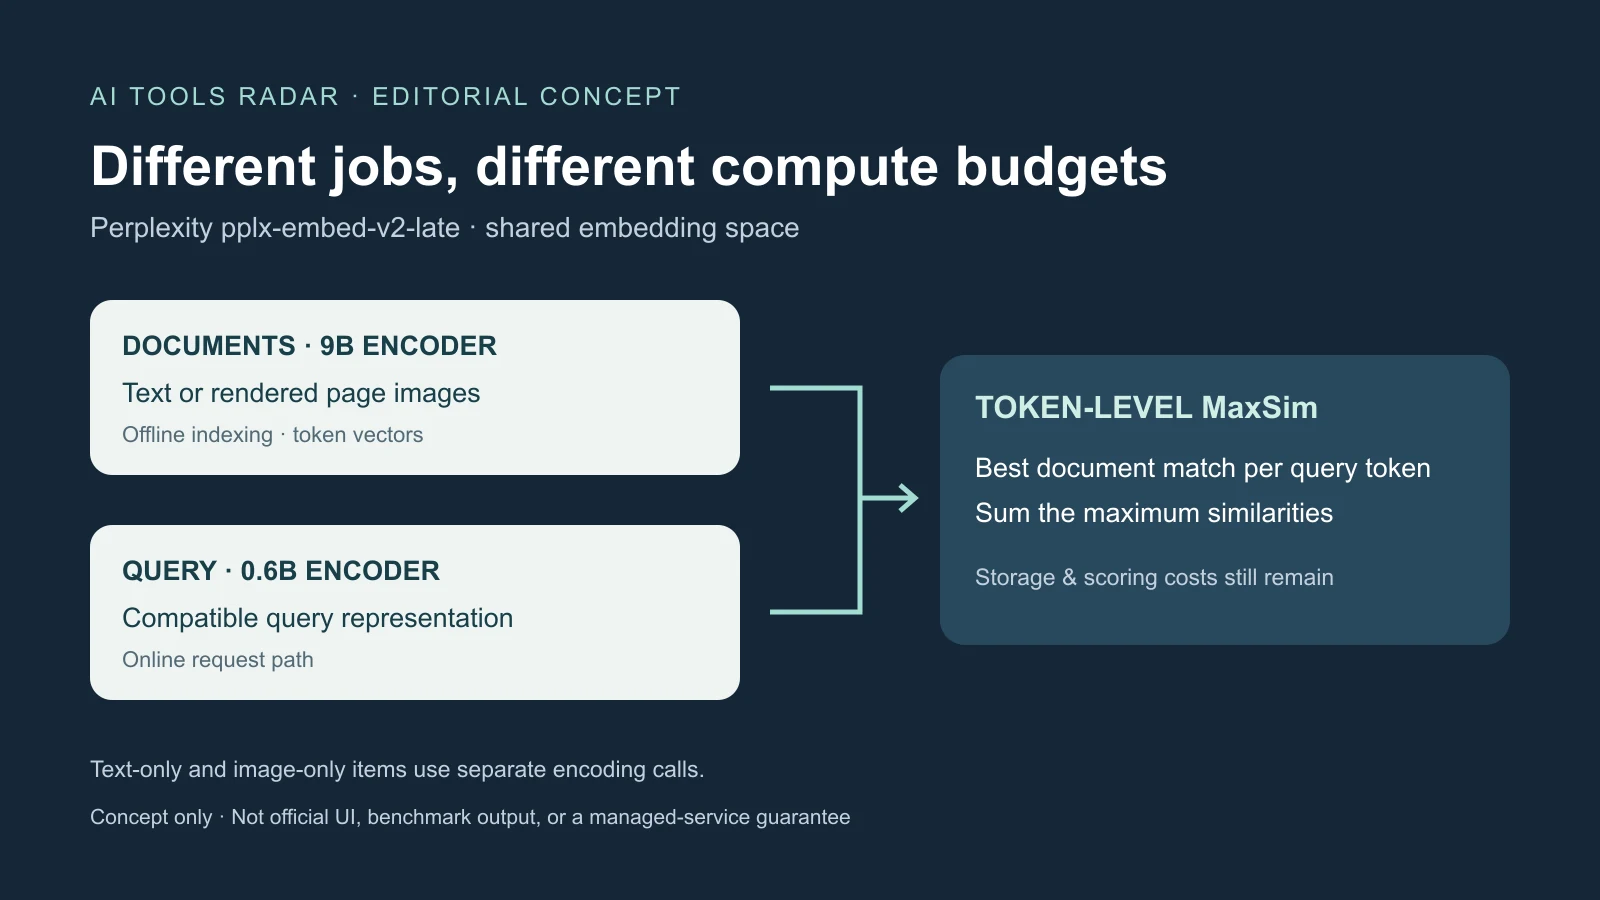
Perplexitys zwei MIT-lizenzierte pplx-embed-v2-late-Checkpoints schlagen eine neue Arbeitsteilung für multimodale Suche vor. Ein 9B-Encoder kann einen reicheren Dokumentindex erstellen, während ein kompatibler 0,6B-Encoder Live-Abfragen verarbeitet. Der gemeinsame Raum, nicht nur weniger Parameter, ermöglicht diese Asymmetrie.
Beide codieren Text, Bilder und gerenderte Dokumentseiten. Dokumentarbeit lässt sich offline bündeln und über viele Suchen amortisieren; Abfragecodierung wiederholt sich im latenzkritischen Anfragepfad. Unterschiedliche Budgets sind die praktische Hypothese, kein Versprechen niedriger Gesamtkosten.
Tokenvektoren bewahren Details statt einer einzigen Zusammenfassung
Dichte Suche weist Abfrage und Dokument oder Abschnitt meist je einen Vektor zu und erlaubt effiziente Nachbarsuche. Chunking hilft bei Länge, kann aber Tabelle und Beschriftung oder Klausel und Einschränkung trennen. Cross-Encoder vergleichen ein Paar gemeinsam genauer, laufen jedoch für jedes Paar neu und eignen sich meist für kurze Kandidatenlisten.
Late Interaction codiert Dokumente vorab und behält Tokenrepräsentationen. Jedes Token erhält 128 Dimensionen. MaxSim sucht für jedes Abfragetoken die größte Ähnlichkeit zu einem Dokumenttoken und summiert diese Maxima. Gesetz, Frist und Ausnahme können so unterschiedliche Belege derselben Seite treffen.
Die Qwen3.5-Familie nutzt bidirektionale Aufmerksamkeit und Destillation aus einem internen 18B-ColBERT-Lehrer. Das kleine Modell wurde vollständig feinabgestimmt; bei 9B wurden die letzten acht Transformer-Schichten voll angepasst, übrige Schichten und Vision-Encoder mit LoRA.
Der kleine Checkpoint hat etwa 594 Millionen Gesamtparameter und laut Anbieter 340 Millionen aktive: ungefähr 240 Millionen bei Text, 340 Millionen bei Bildern. Der Qwen3.5-0.8B-Textturm wurde von 24 auf zwölf Schichten gekürzt; weitere 254 Millionen entfallen auf die Token-Einbettungstabelle. „0,6B“ bezeichnet deshalb nicht denselben aktiven Rechenaufwand für jeden Input.
0,6B-Abfragen können dank gemeinsamem Raum 9B-codierte Dokumente durchsuchen, ohne allein für einen Wechsel des Abfrageencoders neu zu indexieren. Vorgeschlagen sind auch lokale kleine Encoder mit einem Cloud-9B-Index. Das sind Optionen, keine automatischen Datenschutz- oder Managed-Service-Garantien.
OCR-freie Suche braucht weiterhin eine Aufnahmepipeline
Die Anwendung rendert PDF-Seiten zu Bildern, bevor der Vision-Encoder sie verarbeitet; sie übergibt keine unvorbereitete PDF-Datei direkt. Visuelle Repräsentationen können Tabellenpositionen, Diagrammbeziehungen und Layout bewahren sowie bestimmte Scan- oder Schrifterkennungsfehler vermeiden.
Sie liefern nicht automatisch Textstellen für Zitate, Hervorhebung, Wortsuche, Compliance oder nachgelagerte Sprachmodelle. Nativer Text oder OCR kann visuelle Suche ergänzen: erst die aussichtsreiche Seite finden, dann exakte Belege gewinnen. Rendering, Normalisierung, Fehlerbehandlung, Metadaten, Revisionen und Löschung bleiben Anwendungsarbeit.
Perplexity nennt 186 Millionen Abfrage-Dokument-Paare aus 594 Datensätzen und 46 Sprachen. Ursprünglich waren 88,3% Text-Text, 8,3% Text-Bild und 3,4% Text-visuelles-Dokument; finale Samplinggewichte lagen bei 56,5%, 30,9% und 12,6%. Fotosuche ist nicht Belegsuche in einer dichten Berichtsseite, weshalb die Mischung zählt.
Text-only- und Image-only-Einträge benötigen getrennte Codierungsaufrufe; gemischter Text-Bild-Input in einem Eintrag wird nicht unterstützt. „Multimodal“ hebt diese Aufnahmegrenze nicht auf.
Asymmetrische Gewinne gelten für bestimmte Vergleiche
Über 72 domänenspezifische Aufgaben meldet Perplexity im Mittel 1,6 Prozentpunkte mehr für 0,6B-Abfragen mit 9B-Dokumenten als für beidseitig 0,6B, bei unverändertem Abfrageencoder. ViDoRe-v3-Bilder erreichten 63,5% nDCG@10 gegenüber 62,3%, also 1,2 Punkte Unterschied.
Beidseitig 9B blieb mit 81,3% Domänenmittel am stärksten. Laut Unternehmen gewinnt die Asymmetrie ungefähr die Hälfte der Textqualitätslücke zurück, ohne größere Abfragecodierung. Das begründet Tests eines großen Indexers, nicht die Gleichsetzung des kleinen Encoders mit allen 9B-Ergebnissen.
Öffentliche ViDoRe-v3-Bildwerte waren 65,2% für 9B und 62,3% für 0,6B, Markdown entsprechend 64,7% und 61,2%. Der Anbieter sieht 0,6B bei Bildern innerhalb 1,2 Punkten von Nemotron ColEmbed V2 8B und vergleicht Qwen3-VL-Embedding, EVIE und TopK Embed.
128 Dimensionen pro Token stehen 2048 bei EVIE-4.5B und 4096 bei größeren EVIE- und Nemotron-Modellen gegenüber. Das verkleinert einzelne Tokenvektoren, nicht zwingend den gesamten Index. Tokenzahl, Präzision, Kompression, Metadaten, Indexstruktur und Kandidatenerzeugung zählen ebenfalls; vollständige Speicherrechnungen repräsentativer Korpora fehlen.
Antwortbenchmarks messen mehr als Einbettungen
Auf BrowseComp+ meldet 9B 64,0% Antwortgenauigkeit, 4,9 Punkte vor dem nächsten ColBERT und 8,7 vor dem nächsten dichten Modell. 830 schwierige Anfragen und rund 100.000 kuratierte Webdokumente mit menschlich geprüften Belegen bilden einen reproduzierbaren festen Korpus, nicht das veränderliche Live-Web.
Der Wert kombiniert Retrieval mit GPT-OSS-120B bei hohem Denkaufwand; ein anderes Modell beurteilt Antworten gegen Referenzen. Er misst ein Agent-Retriever-System, keinen isolierten Embeddingwert. 0,6B soll alle Modelle außerhalb der Familie übertreffen, doch nicht alle Einzelwerte waren als durchsuchbarer Text verfügbar; der Gesamtbericht wurde für später im Jahr angekündigt.
Bei MADQA mit Gemini 3.5 Flash lauten Antwortwerte 92,4% für 9B und 90,1% für 0,6B. Das Originalpaper beschreibt 2250 von Menschen verfasste Fragen zu 800 Dokumenten; diese Evaluation nutzt 500 Fragen über mehr als 18.000 Seiten und verlangt Korpusbelege statt Allgemeinwissen.
9B lag 3,5 Punkte vor Standard-Mixedbread-Retrieval mit demselben Agenten. Mixedbread Agentic Search erreichte 93,4%, laut Perplexity innerhalb seines Konfidenzintervalls, enthält aber einen Unteragenten für mehrere Suchen je äußerem Aufruf. Ein Gesamtdienst ist kein gleichwertiger Komponentenvergleich.
Die MADQA-Autoren weisen darauf hin, dass menschennah genaue Systeme andere Fragen lösen und schlechte Strategie durch wiederholte Suchen ausgleichen können. Besseres Retrieval garantiert weder Planung noch Synthese. Antwortgenauigkeit, Belegseiten-Recall, Suchqualität, Latenz und Werkzeugaufrufe brauchen eigene Maße.
Der private PPLX-Q2I nutzt Produktionslogs: 10.000 Abfragen gegen 100.000 Bilder. Beide Modelle sollen Qwen3-VL-Embedding-8B um über neun Punkte schlagen; 9B liege rund zwei hinter Gemini Embedding 2. Außenstehende können diesen privaten Test noch nicht reproduzieren; die Werte bleiben Firmenangaben.
Kleine Abfragen beseitigen weder Bewertung noch Speicher
Dichte Suche speichert einen Vektor pro Dokument oder Chunk; Late Interaction viele Tokenvektoren. MaxSim kostet mehr als ein inneres Produkt je Kandidat. Effiziente Bereitstellung braucht passende Indexierung, Pruning oder Stufen; längere Dokumente belasten auch bei 128 Dimensionen.
Abfragecodierung, Kandidatenerzeugung, MaxSim und nachgelagertes Reranking oder Generieren sollten getrennt gemessen werden. Ein kleiner Encoder kann dennoch teure Vergleiche über Millionen Vektoren auslösen. Häufige Änderungen verlangen dauernde GPU-Indexkapazität, Neucodierung und Löschprozesse.
Dichte Suche bleibt für riesige Sammlungen, lexikalische Suche für exakte Namen und Kennungen, Cross-Encoder für begrenzte Kandidaten sinnvoll. Eine hybride technische Wissensbasis kann visuelle Indizes auf layoutabhängige Seiten begrenzen und Text für exakte Suche, Zitate und Belege erhalten. Unberechtigte Inhalte müssen vor Übergabe an den Agenten herausgefiltert werden; kompatible lokale und Cloud-Vektoren sind keine Zugriffskontrolle.
Edge-Eignung hängt von Speicher, Beschleunigung, Quantisierung und Batterie ab. Der kleine Checkpoint nutzt F32-Tensoren; geringere Präzision braucht Rankingtests. Gefordert sind Sentence Transformers 6.0+ und Transformers 5.4+; PyLate setzt Abfrage- und Dokumentmarker laut Warnung an anderer Stelle.
Native Sentence-Transformers-Module vermeiden eigenen Python-Code, bauen aber weder Index noch Dienst. In der genannten Modellkarte bot kein Inferenzanbieter den kleinen Checkpoint an. Schrittweise geplante APIs für Late-, dichte und kontextuelle Embeddings sind kein laufender Managed-Endpunkt und erlauben keine Preisableitung aus älteren Einvektordiensten.
Offene Gewichte machen die Hypothese prüfbar, nicht entschieden
MIT erlaubt breite Nutzung und Änderung, ersetzt aber keine Prüfung von Abhängigkeiten, Trainingsdaten und sensiblen Dokumenten. Gewichte und Implementierungshinweise veröffentlichen weder ganzen Trainingskorpus noch internen 18B-Lehrer. Perplexitys behaupteter Ausschluss benchmarknaher Daten braucht den angekündigten Bericht zur Prüfung von Kontamination, Einstellungen und Unsicherheit.
Unabhängige Tests sollten beide symmetrischen und die asymmetrische Variante mit rechtlichen, finanziellen, technischen und gescannten Dokumenten prüfen, einschließlich Dubletten, Versionen, Rechte, ähnlicher Layouts, Handschrift und schwieriger Negativbeispiele. Gleiche Gesamtbudgets verhindern, dass bessere OCR, zusätzliche Suchrunden oder Reranking als Embeddinggewinn erscheinen.
Entscheidend sind unabhängige Qualitätsreproduktion, vollständige Hardware-, Latenz-, Kompressions- und Speicherwerte sowie echte Produktunterstützung für Mischgrößen. Aufnahmeleistung, Indexgröße, Beleg-Recall, Antworten und Fehler gehören zusammen. Die Hypothese ist klar: Offline-Dokumente und Online-Abfragen brauchen nicht dasselbe Rechenbudget. Ob sie nach allen Betriebskosten einfachere Suche schlägt, bleibt empirisch.
Quellen und weiterführende Informationen
0,6B-Modellkarte · Technische Erklärung · Weiterführend: technische Wissenssuche · BrowseComp+-Design · MADQA-Paper · Veröffentlichungsankündigung